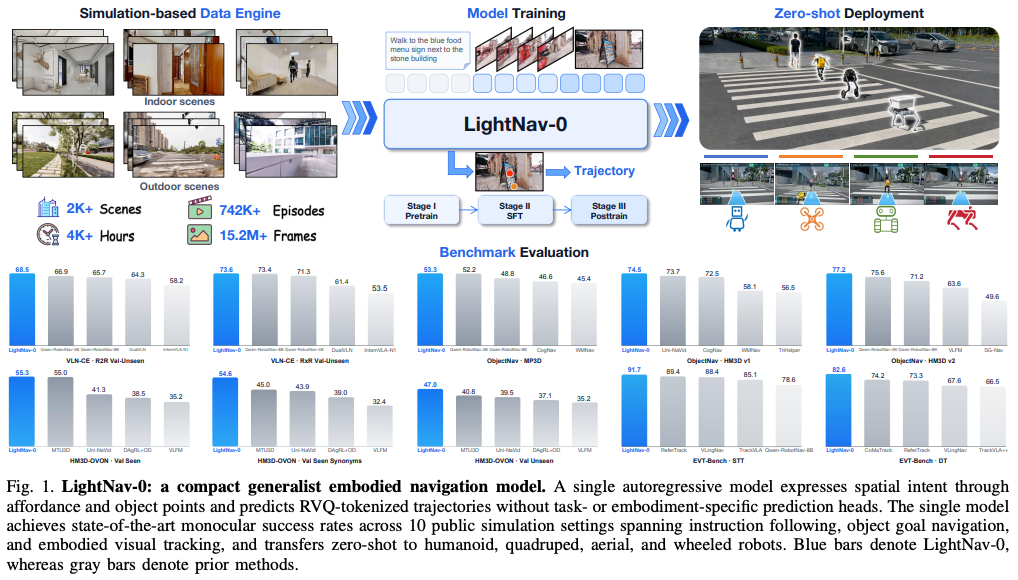
안녕하세요. 이번에 리뷰로 가져온 논문은 LightNav-0: Eliciting VLM Spatial Intelligence for Generalist Embodied Navigation이라는 논문입니다. 해당 논문은 기존에 사전학습된 VLM의 spatial reasoning 능력을 실제 로봇의 내비게이션 행동으로 연결해서, 하나의 모델로 다양한 내비게이션 태스크를 수행할 수 있도록 하는 Generalist Embodied Navigation 모델을 제안한 논문라고 보시면 좋을 것 같습니다. 특히나 핵심은 별도의 task-specific action head 없이 Qwen3-VL-4B를 기반으로 Instruction Following, Object Navigation, Visual Tracking까지 하나의 모델로 수행할 수 있도록 설계했다는 점입니다.
자세한 내용은 아래 리뷰에서 다루도록 하겠습니다.
Introduction
Embodied Navigation은 로봇이 주변 환경을 관측하면서 주어진 목표에 도달하기 위해 적절한 행동을 결정하는 기술입니다. 근데 여기서 말하는 목표는 다양하게 입력으로 주어질 수 있는데, 예를 들어서 “복도를 따라 이동해서 왼쪽 방으로 들어가라”처럼 자연어 지시를 입력으로 넣어서 로봇이 그것을 따라가게끔 할 수도 있고, “의자”,”의자를 찾아.” 처럼 특정 객체를 탐색해야 할 수도 있습니다. 혹은 움직이는 사람을 계속 따라가는 Visual Tracking도 하나의 내바게이션 태스크로 볼 수 있습니다.
이러한 문제들은 모두 시각 정보를 기반으로 로봇의 움직임을 결정한다는 공통점이 있지만 기존 연구에서는 대부분 각각의 태스크를 별도의 문제로 다뤄왔습니다. 예를 들어서 Object Navigation에서는 semantic map이나 frontier exploration을 활용하는 경우가 많고, Vision-Language Navigation에서는 언어 지시를 이해하기 위한 별도의 플래닝 모듈을 추가적으로 사용하는 경우가 있습니다. 그리고 Visual Tracking은 움직이는 타깃의 위치를 계속 추정하면서 상대적인 거리를 유지해야 하기 때문에 또 다른 형태의 policy를 사용합니다. 근데 이런 방식들은 각 태스크에서 좋은 성능을 보일 수 있지만, 새로운 태스크로 확장하려면 별도의 모델이나 모듈을 해당 태스크에 맞게 추가적으로 설계해야 하는 문제가 있습니다.
근데 최근 VLM들은 이미 고수준의 visual understanding과 spatial reasoning 능력을 가지고 있습니다. 이미지에서 특정 객체가 어디 있는지 찾거나, 물체 사이의 상대적인 위치 관계를 이해하고, 어느 공간으로 이동할 수 있을지 판단하는 능력도 어느 정도 학습되어 있습니다.
그래서 저자들은 여기서 이미 VLM이 가지고 있는 이런 spatial intelligence를 별도의 복잡한 내비게시연 모듈 없이 직접 로봇의 행동으로 연결할 수 있지 않을까하고 그냥 VLM 하나만으로 별도의 모듈없이 generalist embodied naviagtion 모델을 만들고자 합니다. 물론 VLM이 이미지에서 이동할 수 있는 공간을 찾는 것과 실제 로봇이 움직일 trajectory를 예측하는 것은 서로 다른 문제이긴 합니다. 왜냐면 전자는 이미지 공간에서의 시각적 판단이고, 후자는 실제 로봇기준에서 정의된 메트릭한 공간에서 로봇이 실행할 수 있는 행동을 예측해야하는 문제입니다. 그래서 저자들은 내비게이션에 필요한 이 두가지을 연결하기 위해 Dual-Channel Pointing을 제안하고 별도의 플래닝 모듈이 없는대신 VLM의 discrete한 토큰을 continous한 action으로 표현하기 위한 RVQ 기반 Action Tokenizer를 제안합니다.
정리하면 LightNav-0는 사전학습된 VLM의 공간 이해 능력을 최대한 활용하면서, 다양한 내비게이션 태스크를 하나의 모델로 통합하고자 하는 연구라고 보시면 좋을 것 같습니다.
LightNav-0
LightNav-0는 Qwen3-VL-4B-Instruct를 백본으로 사용합니다. 모델의 입력은 현재 RGB observation, 과거 observation history, 그리고 language instruction입니다. 그리고 모델은 매 step마다 두 개의 pointing 토큰을 먼저 예측하고, 이후 세 개의 RVQ action 토큰을 생성합니다. 이 action 토큰을 디코딩하면 최종적으로 10개의 미래 waypoints로 구성된 trajectory를 얻을 수 있습니다. 기존 VLM이 text 토큰을 autoregressive하게 생성하는 것처럼 LightNav-0는 공간적인 목표 위치와 로봇의 trajectory를 토큰으로 생성하는 방식이라고 보시면 좋을 것 같습니다.
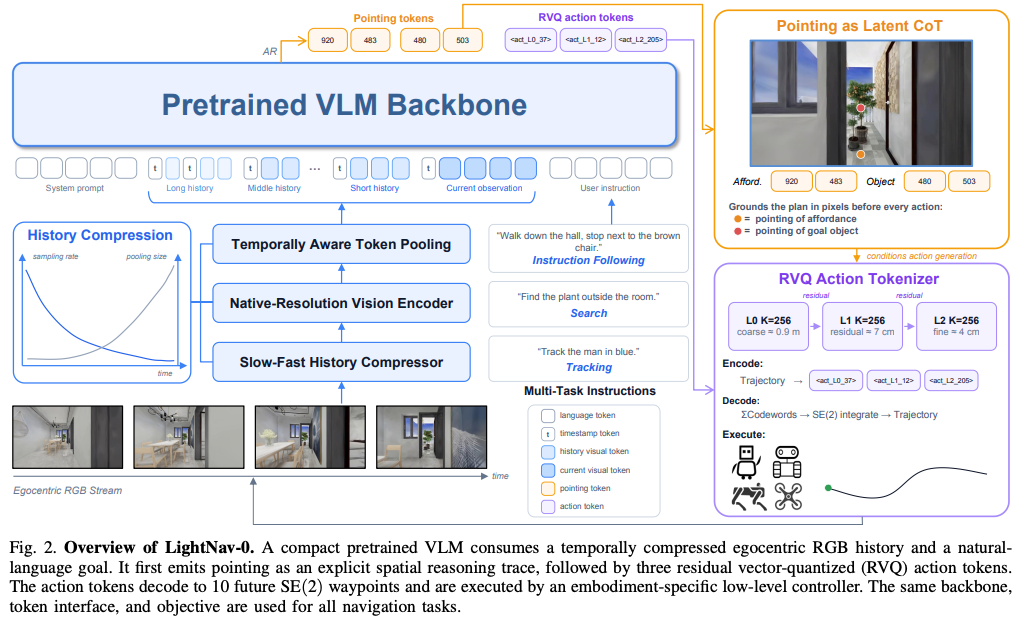
위 그림이 LightNav-0의 전체적인 파이프라인입니다. 여기서 핵심적인 부분은 세 가지인데 먼저 첫 번째는 Dual-Channel Pointing입니다.
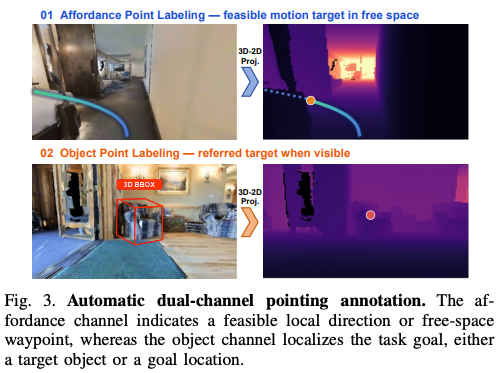
저자들은 로봇이 움직이기 전에 어디로 이동할 수 있는지와 어떤 객체를 목표로 하는지를 구분해서 예측하도록 설계합니다. 여기서 Affordance Point는 현재 2D이미지 상에서 로봇이 이동할 수 있는 free-space 영역이나 적절한 이동 위치를 그냥 2D 이미지 위에서 포인팅한 결과라고 보시면 좋을 것 같습니다. Object Point도 비슷한데 여기서는 적절한 이동 위치가 아니라 목표 객체 또는 주어진 골 위치가 2D 이미지의 어디에 있는지를 포인팅한 결과입니다.예를 들어서 로봇에게 “의자로 가라”라는 instruction이 주어졌다고 치면 이때 Object Point는 의자의 위치를 가리키고, Affordance Point는 의자까지 이동하기 위해 통과할 수 있는 공간을 가리키는 식입니다. 이 둘을 분리한 이유는 목표 객체가 보인다고 해서 반드시 그 방향으로 직진할 수 있는 것은 아니기 때문입니다. 중간에 장애물이 있을 수도 있고, 우회해야 하는 상황도 발생할 수 있습니다. 그리고 이 두 point는 이미지 좌표계를 일정한 grid로 나눈 뒤 각각 하나의 discrete 토큰으로 표현됩니다. 목표 객체가 보이지 않거나 제자리 회전, 정지처럼 유효한 이미지 좌표가 없는 경우에는 별도의 예약된 토큰을 사용하고 매 스텝에서 예측할 때 먼저 affordance point 토큰을 먼저 예측하고 그 토큰을 조건으로 autoregressive하게 object 토큰을 예측하는 식으로 동작합니다. 그리고 저자들은 이러한 과정을 Pointing as Latent Spatial Reasoning이라고 표현합니다. 일반적인 CoT처럼 뭔가 현재 앞에 장애물이 있으니 왼쪽으로 이동해야겠다라는 긴 문장을 생성하는 것이 아니라 이미지 위의 point를 예측하는 것 자체가 공간적인 reasoning 과정이 되는 것이라고 주장합니다. 그리고 이후 생성되는 action 토큰 또한 앞에서 예측한 pointing token을 조건으로 사용하게 됩니다. 그래서 단순히 바로 trajectory를 예측하는 것보다, 먼저 어디를 목표로 하고 어디로 이동할 수 있는지를 명시적으로 판단한 다음 행동을 결정하도록 유도하는 것이 저자들이 주장하는 VLM의 spatial intelligence을 바로 직접 로봇의 행동으로 연결할 수 있는 징검다리라고 보시면 좋을 것 같습니다.
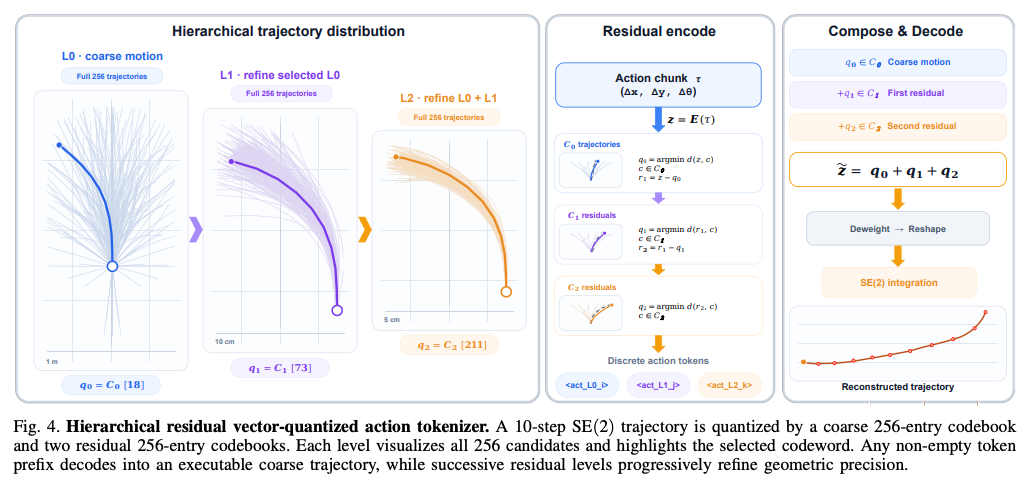
두 번째는 Residual Vector-Quantized Action Tokenizer입니다. 앞에서 설명한 pointing은 이미지 공간에서의 위치를 표현하는 것이고, 실제 로봇을 움직이기 위해서는 실제 로봇 기준 공간에서의 앞으로 움직여야할trajectory가 필요합니다. 기존 VLA나 내바게이션 모델에서는 이를 해결하기 위해 별도의 continuous action head를 사용하거나, diffusion 또는 flow matching 기반으로 trajectory를 예측하는 경우가 많습니다. 근데 LightNav-0에서는 이런 별도의 모듈을 추가하지 않고, trajectory 자체를 discrete token으로 변환해서 기존 language model의 구조 그대로 사용합니다. 여기서 사용하는 방법이 RVQ(Residual Vector Quantization)입니다. 위 그림을 보면 RVQ는 총 3개의 level로 구성되어 있고, 각 level은 256개의 codeword를 가지고 있습니다. 먼저 첫 번째 level에서는 전체적인 trajectory의 대략적인 형태를 예측합니다. 이후 두 번째와 세 번째 level에서는 앞에서 예측한 trajectory의 residual error를 점진적으로 보정하는 방식입니다. 예를 들어 첫 번째 토큰이 대략적으로 왼쪽으로 회전하는 trajectory를 나타낸다면, 다음 토큰들은 회전 각도나 이동 거리를 조금씩 보정해서 더 정확한 trajectory를 복원한다고 보시면 됩니다. 이렇게 하면 10개의 future waypoint를 단 3개의 action token으로 표현할 수 있습니다. 그리고 각 level에 256개씩 codeword가 존재하기 때문에 총 256³개의 조합을 표현할 수 있습니다. 실제로 저자들은 RVQ를 이용한 trajectory reconstruction error가 평균 0.72 cm로, 비교한 single-level quantization 방식의 2.48 cm보다 낮았다고 보고합니다. 물론 이 값은 action tokenizer 자체의 재구성 오차이지 실제 내비게이션의 위치 오차를 의미하는 것은 아니긴합니다. 중요한 건 이렇게 action을 토큰 형태로 표현하면 별도의 trajectory prediction head 없이 기존 VLM의 autoregressive 구조를 그대로 활용할 수 있다는 점입니다.
그리고 마지막 세 번째는 Temporally Aware Visual History Compression입니다. 내비게이션에서는 현재 observation뿐 아니라 과거에 어떤 공간을 지나왔는지도 중요합니다. 근데 모든 과거 프레임을 그대로 VLM에 입력하면 시간이 지날수록 visual 토큰의 수가 계속 증가하게 됩니다. 그래서 저자들은 최근 프레임은 높은 sampling rate와 spatial resolution을 유지하고, 오래된 프레임일수록 적게 sampling하고 더 강하게 pooling하는 방식을 사용합니다. 현재 주변 환경은 자세하게 관측하되 오래전에 지나온 공간은 압축된 형태로 유지하는 것입니다. 이렇게 하면 제한된 visual 토큰 budget 안에서 최근의 세부적인 정보와 장기적인 history를 함께 활용할 수 있습니다.
LightNav-0의 전체적인 동작을 정리하면, Visual History와 Instruction을 입력받아 Pointing으로 공간적인 의도를 먼저 표현하고, 이를 조건으로 RVQ token을 생성해서 실제 이동 trajectory를 예측하는 방식으로 이해하시면 좋을 것 같습니다.
Training & Dataset
이제 저자들이 해당 모델을 어떻게 학습했는지 설명드리도록 하겠습니다. Generalist 내비게이션 모델을 만들기 위해서는 단순히 하나의 내비게이션 데이터셋으로 학습하는 것만으로는 부족합니다. 서두에서 잠깐 언급드린 것처럼 Instruction Following, Object Navigation, Visual Tracking은 목표의 형태와 로봇이 수행해야 하는 행동이 서로 다르기 때문입니다. 그래서 저자들은 다양한 태스크의 데이터를 싹다 긁어모으고 여기서도 저자들 내부적으로 데이터 합성을 통해서 데이터를 늘려서 대규모 데이터 셋을 구축을 합니다. 전체 내비게이션 데이터는 2,000개 이상의 scene과 4,000시간 이상의 embodied navigation trajectory로 구성되어 있다고 합니다.
여기에는 R2R, RxR 같은 Instruction Following 데이터부터 HM3D, MP3D 기반 Object Navigation 데이터, EVT-Bench 기반 Visual Tracking 데이터까지 포함됩니다.
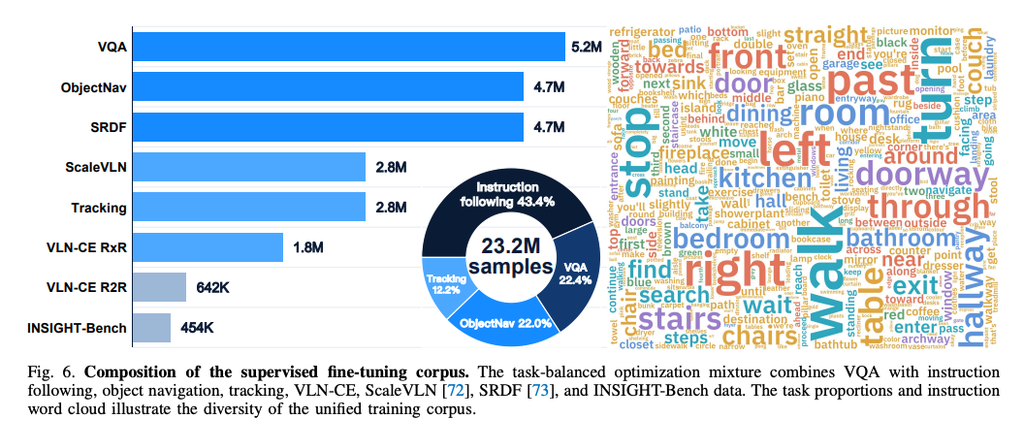
위 그림은 SFT에 사용된 데이터의 구성입니다. 저자들은 내비게이션 데이터만 학습시키는 것이 아니라 VQA와 spatial reasoning 데이터도 함께 사용합니다.이렇게 하는 이유는 내비게이션에만 집중해서 학습할 경우 기존 VLM이 가지고 있던 visual grounding이나 일반적인 spatial reasoning 능력이 약해질 수 있기 때문입니다. 그리고 서로 다른 데이터셋을 사용하더라도 최종 supervision은 동일하게 두 개의 pointing token과 세 개의 RVQ action token으로 구성합니다. 이 부분이 다양한 태스크를 하나의 모델로 학습할 수 있도록 만드는 핵심이라고 보시면 좋을 것 같습니다.
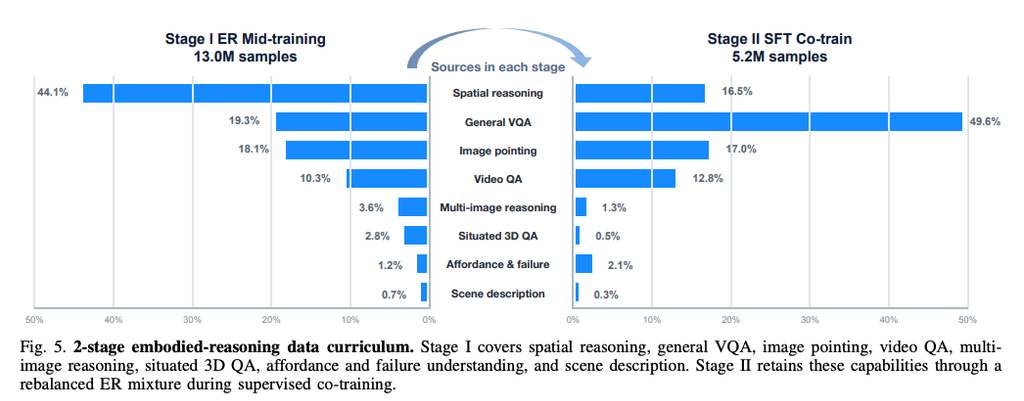
학습 과정은 크게 3단계로 구성됩니다. 먼저 Stage 1은 Embodied Reasoning Mid-training입니다. 이 단계에서는 아직 내비게이션 action을 학습하지 않고, 기존 VLM의 spatial reasoning 능력을 강화하는 데 집중합니다. 이미지에서 특정 객체를 pointing하거나, 물체 사이의 상대적인 위치를 판단하고, 이동 가능한 공간을 이해하는 등의 데이터를 활용합니다. 이렇게 학습된 checkpoint가 LightNav-ER입니다.
다음 Stage 2는 Supervised Fine-tuning입니다.앞에서 학습한 spatial reasoning 능력을 실제 navigation trajectory 예측으로 연결하는 단계입니다. 다양한 내비게이션 데이터와 reasoning 데이터를 함께 학습시키면사 DAgger를 이용해서 모델이 직접 방문한 상태에서의 expert supervision도 추가합니다. 일반적인 imitation learning에서는 expert가 방문한 상태만 학습하기 때문에 실제 모델이 잘못된 행동을 했을 때 만나는 observation에 취약할 수 있습니다. DAgger는 이런 train-test state distribution 차이를 줄이기 위한 방법이라고 보시면 됩니다.
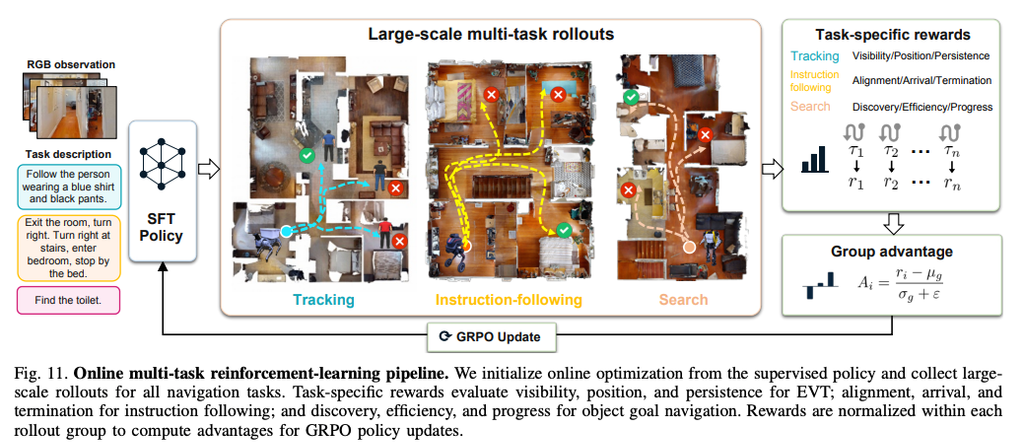
마지막 Stage 3은 Online Reinforcement Learning입니다. SFT만으로는 즉 여기서는 imitation learning이라고 볼 수 있는데 각 시점에서 expert action을 잘 모방하도록 학습할 수 있지만, 실제로 목표까지 롤아웃했을 때 안정적으로 도착하는지는 별도의 문제입니다. 그래서 저자들은 시뮬레이터에서 모델이 직접 롤아웃을 수행하게 하고, 태스크별로 reward를 계산해서 GRPO 기반 reinforcement learning을 진행합니다. 위 그림을 보면 Tracking에서는 target을 지속적으로 따라가는지, Instruction Following에서는 지시된 경로를 잘 따르면서 도착했는지, Object Navigation에서는 목표 객체를 얼마나 효율적으로 찾았는지를 기준으로 reward를 계산합니다.
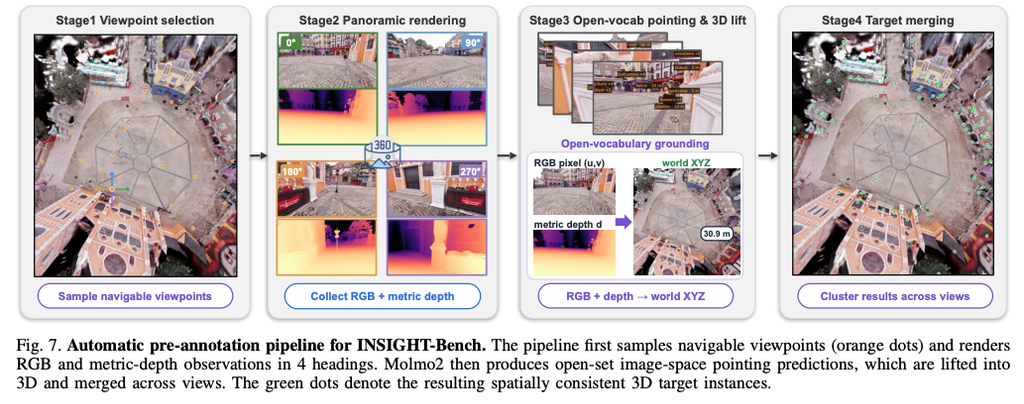
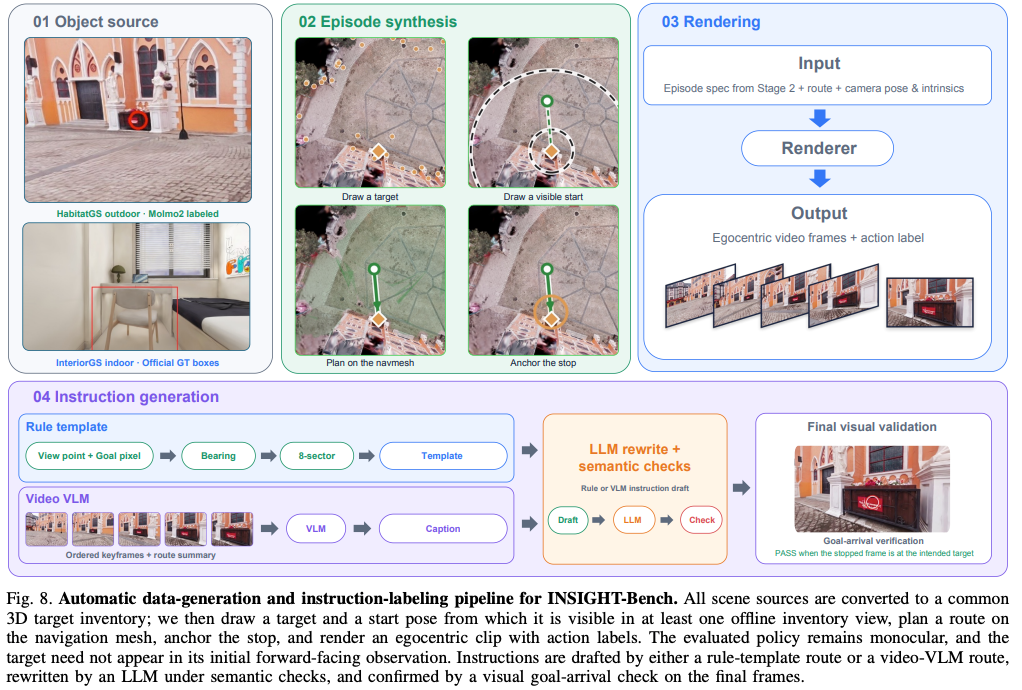
그리고 추가적으로 저자들은 INSIGHT-Bench라는 내비게이션 벤치마크도 위 그림과 같은 흐름으로 구축합니다. 이 데이터셋은 기존의 mesh 기반 실내 환경뿐 아니라 3D Gaussian Splatting 기반 환경까지 활용해서 다양한 scene과 instruction을 생성한 데이터셋입니다. 학습용으로 1,683개 scene과 53,090개 episode를 구성했고, 평가용으로는 210개 scene과 1,097개 episode를 제공한다고 합니다.
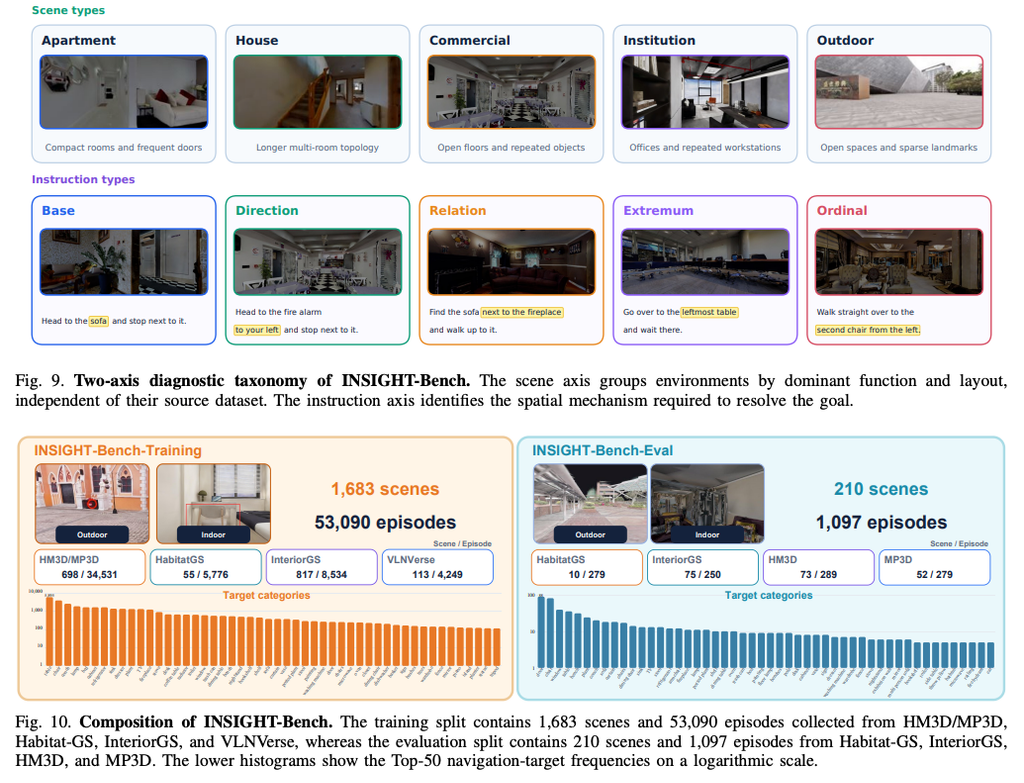
단순히 “의자를 찾아라” 같은 instruction만 있는 것이 아니라, “왼쪽에 있는 의자”, “벽난로 옆 소파”, “가장 왼쪽 테이블”처럼 공간적 관계를 이해해야 하는 instruction도 포함하여 각각 시나리오별 분리를 해놓음으로써 나중에 결과를 좀더 세세하게 분석하기에 용이하다고 합니다. 그래서 모델이 단순히 객체를 인식해서 이동하는 것인지, 아니면 실제로 instruction에 포함된 spatial relation까지 이해하고 있는지를 좀 더 구체적으로 평가할 수 있도록 구성했다고 보시면 좋을 것 같습니다.
Experiments
이제 저자들은 LightNav-0의 성능을 다양한 벤치마크에서 평가합니다.
전체적으로는 먼저 VLM의 spatial reasoning 능력이 얼마나 개선됐는지 확인하고, 이후 Instruction Following, Object Navigation, Visual Tracking에서 실제 내비게이션 성능을 비교합니다. 서로 다른 태스크별로 fine-tuning을 수행한 것이 아니라, 하나의 LightNav-0 체크포인트로그대로 사용해서 평가를 진행합니다.
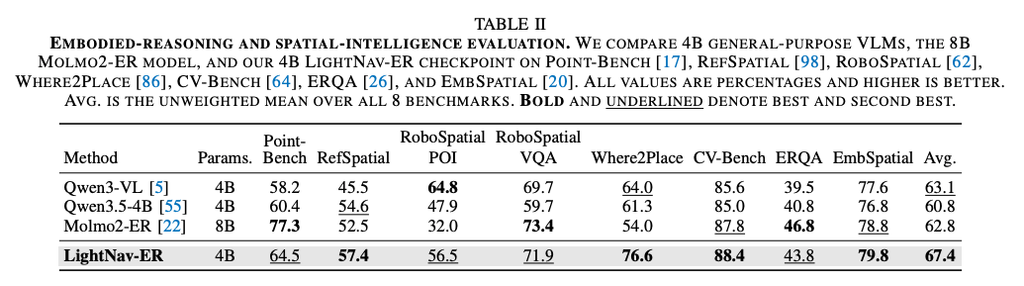
먼저 Embodied Reasoning 성능부터 말씀드리면 위 테이블은 LightNav-ER와 기존 VLM들의 spatial reasoning 성능을 비교한 결과입니다. 총 8개의 벤치마크에서 평가했을 때 LightNav-ER는 평균 점수는 타 모델에 비해 가장 좋은 성능을 보입니다. 특히나 RefSpatial이나 Where2Place처럼 물체의 공간적 관계를 이해하거나 적절한 위치를 예측해야 하는 벤치마크에서 성능 향상이 크게 나타나는 것을 확인할 수 있습니다. 물론 모든 개별 벤치마크에서 가장 높은 성능을 보인 것은 아니지만, 전체 평균에서는 가장 좋은 결과를 보입니다.
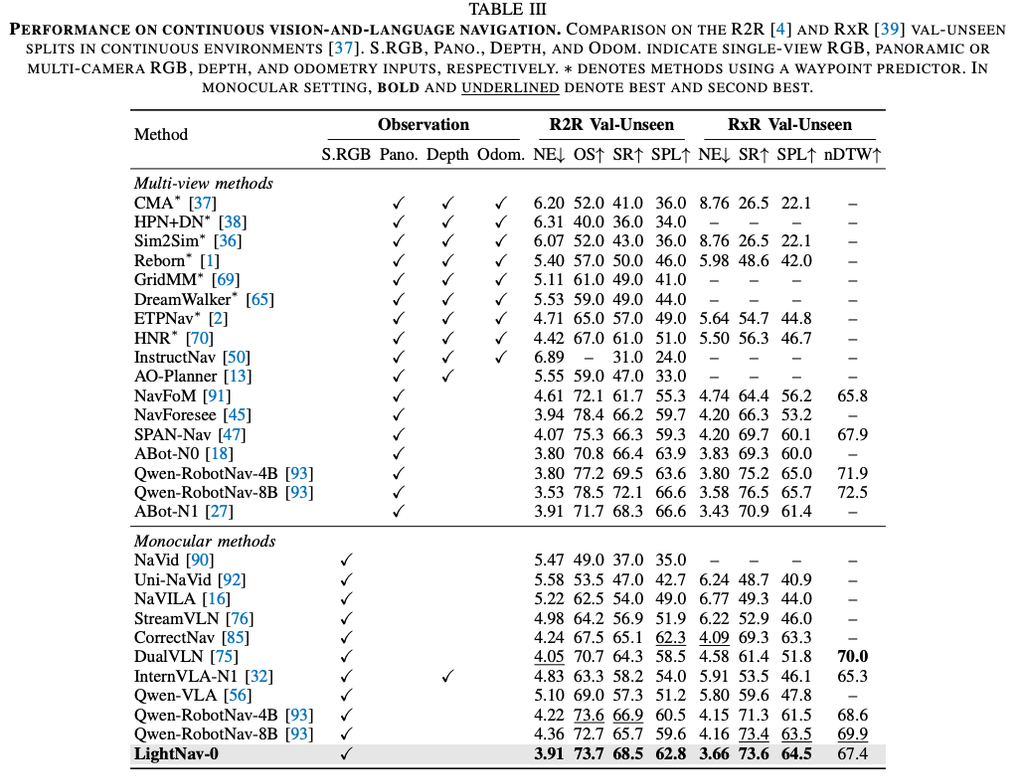
다음은 실제 Navigation 성능입니다. 먼저 Instruction Following에서는 R2R과 RxR 벤치마크를 사용합니다. LightNav-0는 R2R, RxR두 결과 모두 monocular 세팅에서 비교한 기존 방법들보다 높은 성공률을 보입니다.특히 기존 Qwen-RobotNav-4B나 Uni-NaVid 같은 모델과 비교했을 때, 별도의 panoramic observation이나 depth 없이도 좋은 성능을 보여줍니다. 근데 모든 모든 방법론을 통틀어 가장 높은 성능을 보이는 것은 아니고Panoramic observation을 사용하는 일부 방법들은 당연할 수 있지만 여전히 더 높은 SR을 기록하긴 합니다.
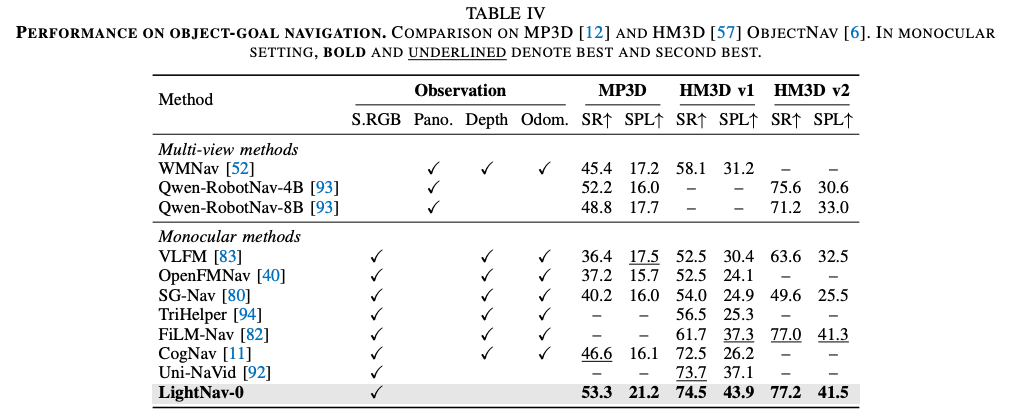
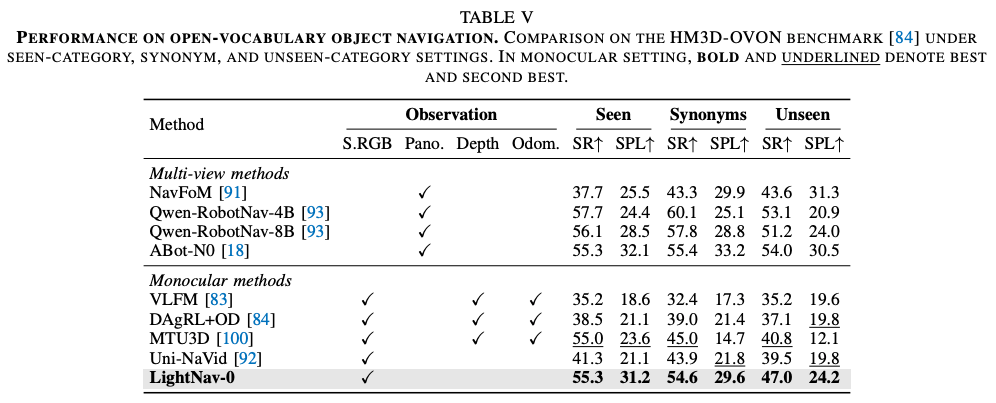
Object Navigation에서도 비슷한 경향을 보이는데 MP3D, HM3D v2벤치마크에서 monocular 방식 중 가장 좋은 결과를 보입니다. 그리고 Open-Vocabulary Object Navigation 결과를 보면, 여기서 잠깐 해당 태스크에 대해서 간단하게 설명드리면 일반적인 ObjectNav에서는 사전에 정해진 객체 카테고리를 목표로 사용하지만, Open-Vocabulary 환경에서는 학습 중에 보지 못한 새로운 카테거리나 다른 표현으로 주어진 객체도 찾아야 하는 태스크 정도로 이해하시면 좋을 것 같습니다. 예를 들어서 아예 처음보는 카테고리를 찾는 다던가 혹은 sofa 로 학습 되었던 객체를 couch로 바꿨을 때도 잘 찾아야한다거나 이런걸 평가하는 벤치마크로 이해하시면 좋을 것 같습니다. 그래서 다시 돌아와서 LightNav-0는 HM3D-OVON의 unseen category에서 비교한 기존 monocular 방법들중에서 가장 좋은 성능을 보입니다. 결국 기존 VLM이 가지고 있는 open-vocabulary visual understanding 능력을 내비게이션에도 어느 정도 활용하고 있다는 점을 보여주는 것 같습니다.
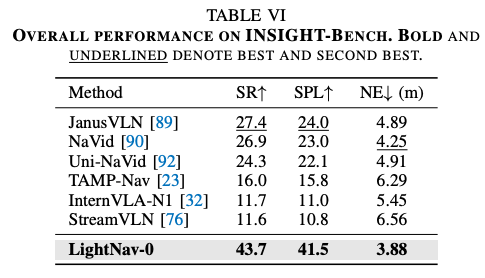
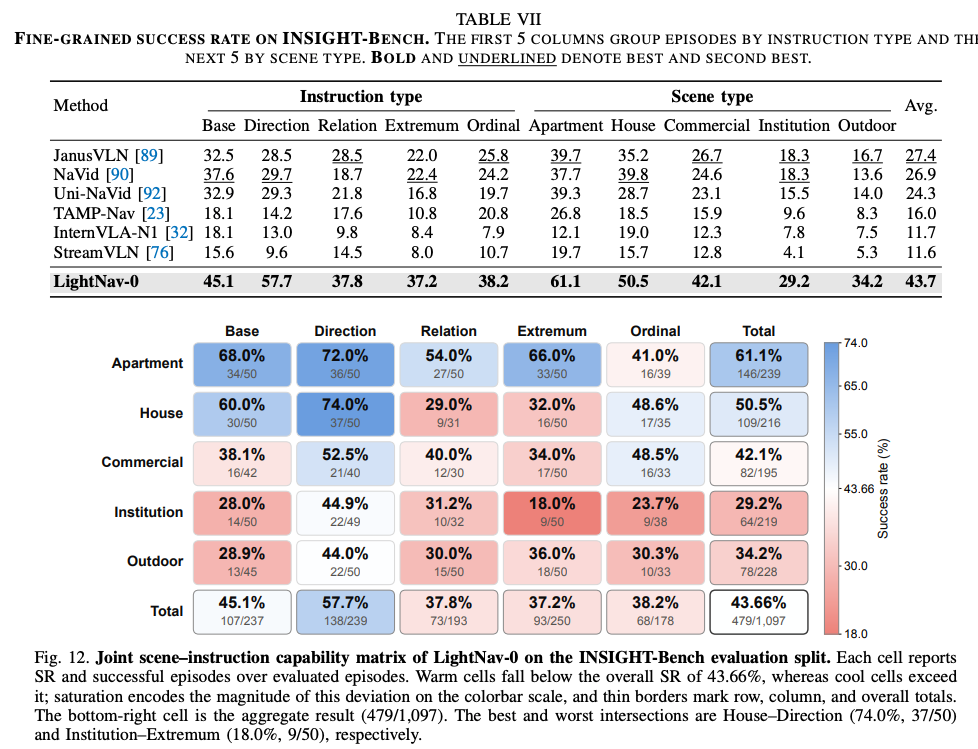
그리고 저자들이 제안한 INSIGHT-Bench에서도 성능을 평가합니다. 세부 결과를 보면 방향을 이해해야 하는 Direction instruction에서는 좋은 성능을 보였지만, 여러 객체 중 특정 조건을 만족하는 객체를 선택해야 하는 Extremum(극값의 이해 능력, 예를 들어서 중복된 의자가 나열되어있을 때 가장 왼쪽에 위치한 의자에 대한 이해 능력)에서는 성능이 낮아집니다. 그리고 여기에 공간 구조가 복잡하고 반복적인 객체가 많이 등장하는 Institution 환경(예를 들어 오피스 환경)이면 더 낮은 성능을 보입니다. 그래서 전체적인 성능은 기존 방법보다 높다고 볼 수는 있어도, 여러 유사한 객체 사이에서 정확한 타깃을 구분하거나 복잡한 공간적 관계를 이해하는 문제는 여전히 어려운 것으로 보입니다.
다음은 Visual Tracking 결과입니다.
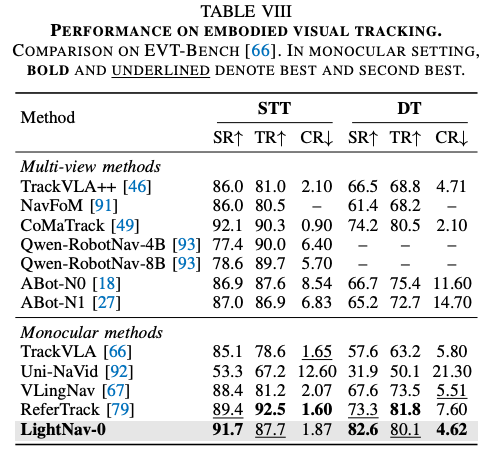
Visual Tracking에서는 STT(Single-Target Tracking)와 DT(Distracted Tracking) 두 가지 환경을 평가합니다.STT는 하나의 target을 지속적으로 따라가는 상황이고, DT는 비슷한 객체나 사람이 여러 명 등장하는 상황에서 처음 지정된 타깃 인스턴스를 놓치지 않고 따라가야 하는 좀 더 어려운 문제입니다. 결과를 보면 Tracking Rate나 Collision Rate까지 모두 가장 좋은 것은 아니고, 일부 지표에서는 기존 tracking 전용 방법들이 더 높은 성능을 보입니다. 그래도 하나의 모델이 Instruction Following이나 Object Navigation뿐 아니라 움직이는 타깃을 추적하는 태스크에서도 높은 성공률을 보인다는 점은 의미 있는 결과인 것 같습니다. 그래도 이런 visual tracking만을 위해 설계된 방법론을 제외하면 가장 좋은 결과를 보이긴 합니다.
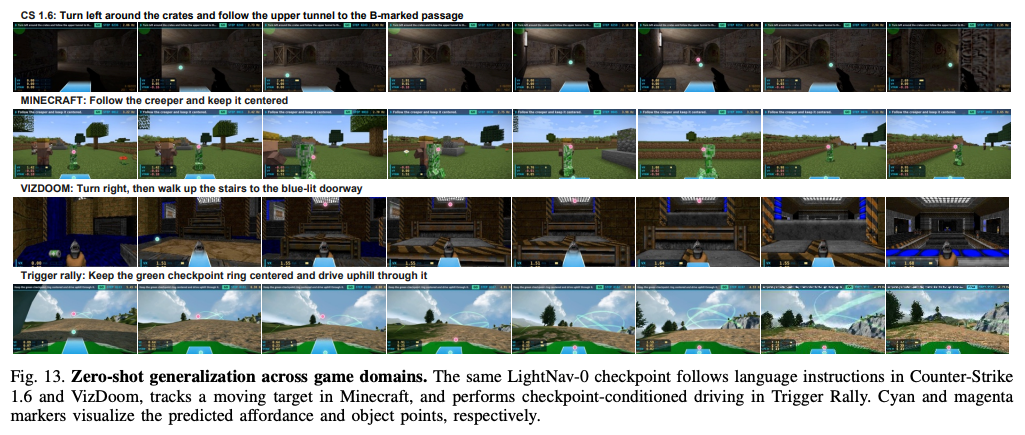
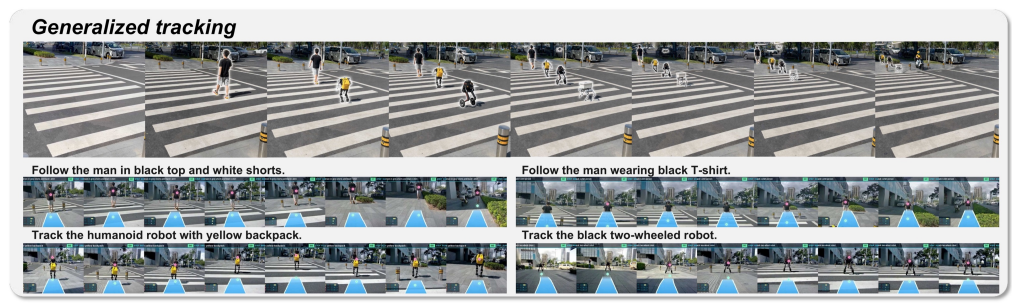
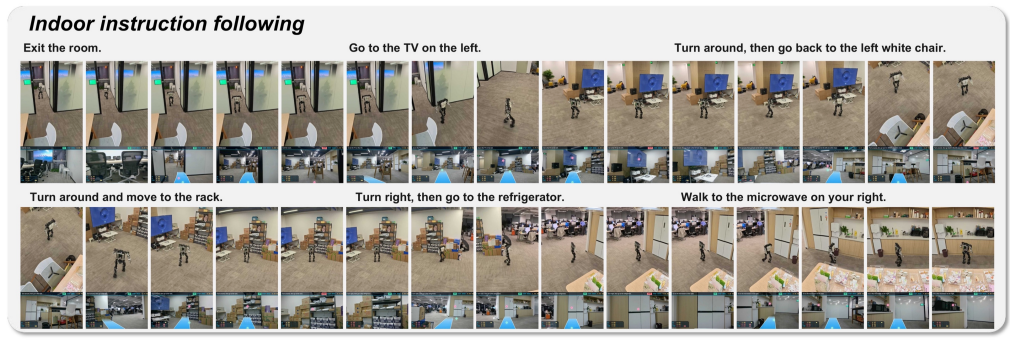
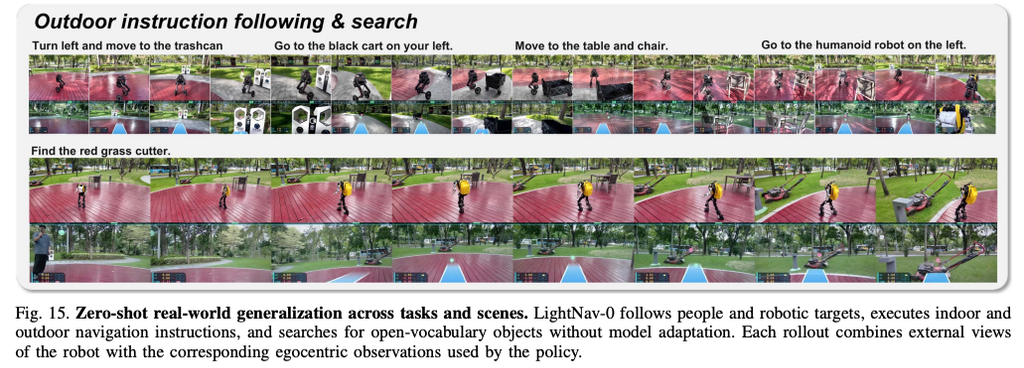
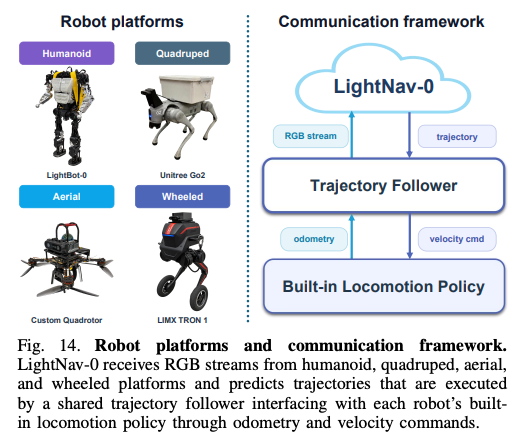
마지막으로 저자들은 시뮬레이션뿐 아니라 실제 로봇에서도 zero-shot deployment를 진행합니다. 위 그림을 보면 Humanoid, Quadruped, Wheeled Robot, Aerial Robot처럼 서로 다른 플랫폼에 동일한 LightNav-0 체크포인트를 적용합니다. 실제 환경에서 사람을 따라가거나, 특정 객체를 찾고, 자연어 instruction을 수행하는 모습도 실제 프로젝트 페이지 가면 데모로 확인할 수 있습니다. 근데 여기서 LightNav-0의 high-level policy는 RGB observation으로 trajectory를 예측하지만, 실제 로봇에서 이를 실행하는 low-level trajectory follower는 odometry와 각 로봇의 locomotion controller를 활용하는 식으로 구성되어있습니다. 그리고 실세계 결과는 정량적인 성공률 비교보다는 다양한 플랫폼에서 모델이 동작할 수 있다는 것을 보여주는 정성적인 데모로 보여줍니다.
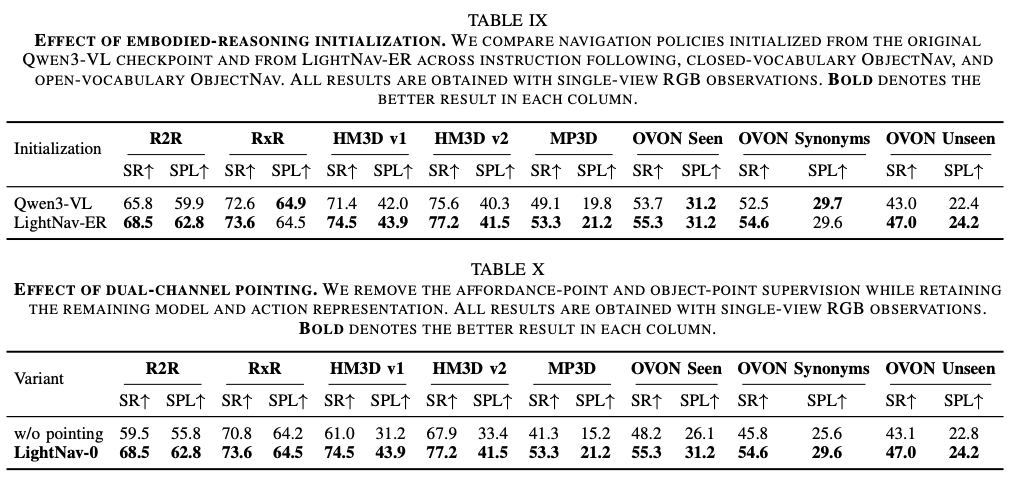
위는 ablation 결과 입니다. 먼저 기존 Qwen3-VL에서 바로 내비게이션을 학습하는 것과 LightNav-ER에서 시작하는 것을 비교합니다. LightNav-ER를 사용했을 때 8개 내비게이션 벤치마크 평균을 봤을 때 성능이 늘어난 것을 보실 수 있습니다. 일부 만을 봤을 때에는 성능이 떨어진 부분은 있지만 엄청 크게 떨어지지 않은 것으로 보입니다. 결과적으로 내비게이션 action을 학습하기 전에 VLM의 spatial reasoning 능력을 강화하는 과정이 실제 내비게이션 성능 향상에도 도움이 된다는 것을 보여주는 결과 인것 같습니다.
그리고 Dual-Channel Pointing관련 ablation 결과를 보시면 Pointing supervision을 제거했을 때 평균적으로 각 벤치마크의 SR 을 보면 8퍼 이상 늘어나는 결과를 보입니다. 이 결과를 보면 LightNav-0의 성능 향상이 단순히 학습 데이터를 많이 사용했기 때문만은 아니고, 실제 trajectory를 생성하기 전에 공간적인 목표를 명시적으로 표현하도록 만든 것이 중요한 역할을 했다라고 볼 수 있을 것 같습니다.
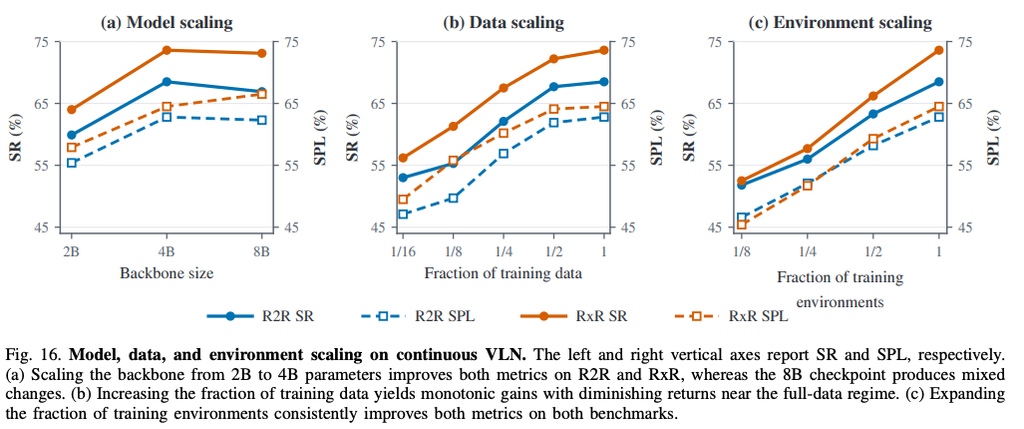
그리고 추가적으로 저자들은 모델 사이즈, 데이터 사이즈, 환경 다양성에 대한 스케일링 실험도 진행합니다. 일단 모델 크기를 2B에서 4B로 증가시킬 때는 성능이 좋아졌지만, 8B로 늘렸을 때는 반드시 성능이 개선되지는 않았습니다. 그리고 데이터만 늘린다고 해서 성능 향상 폭이 선형적으로 증가하지는 않았지만 반대로 학습에 사용하는 scene의 다양성을 늘렸을 때는 전반적으로 일관된 성능 향상을 보입니다. 그래서 단순히 더 큰 VLM을 사용하는 것보다, 다양한 환경과 태스크를 경험하도록 학습시키는 것이 generalist 내비게이션 성능에 더 중요한 요소가 될 수 있다는 점을 보여주는 것 같습니다.
Conclusion
뭔가 기존 VLM 기반 내비게이션 연구들을 보면 언어적인 reasoning을 추가하거나, 별도의 action expert 모듈을 통해 trajectory를 생성하는 경우가 많습니다. 근데 LightNav-0는 로봇이 어디로 이동해야 하는지를 이미지 위의 point로 먼저 표현하도록 하면서, 복잡한 언어적 reasoning 없이도 공간적인 의도 즉 행동을 유도할 수 있는 affordamce를 action 생성에 반영할 수 있도록 설계했습니다. 그리고 ablation에서도 pointing을 제거했을 때 성능이 상당히 떨어지는 것을 보면, 단순히 시각 정보를 입력받아서 바로 action을 예측하는 것보다 중간에 명시적인 spatial representation을 두는 것이 실제 내비게이션에서도 중요한 역할을 할 수 있겠다는 생각이 들었습니다. 근데 아직 실험 결과들만을 봤을 때 실제 로봇 환경에서는 다양한 플랫폼에 대한 정량적인 평가는 없는 것은 아쉽긴 합니다. 논문에서 향후에는 빠른 local control과 느린 semantic reasoning을 분리하는 dual-system 구조를 고려하고 있다고 합니다. 암튼 이번 논문을 보면서 느낀 건 내비게이션 태스크 뿐만이 아니라 여러 태스크들이 공통적으로 사용할 수 있는 무언가를 찾아서 이를 기반으로 학습 가이드로 줄 수 있다면, 기존처럼 태스크마다 별도의 모델을 설계해야 하는 문제도 어느 정도 줄일 수 있지 않을까라는 생각이 듭니다.
이만 리뷰 마치도록 하겠습니다. 감사합니다.