안녕하세요, 오늘 소개할 논문은 ECCV 2024 논문으로 long-term “dense” anticipation을 다루고 있습니다. long term action anticipation(LTA) 논문작업을 하면서 최신 관련 연구가 개수도 적고 뻔하다는 느낌을 받아서 action anticipation의 다른 sub task인 dense anticipation 연구를 보게 되었는데, LTA 연구들을 보면서 제가 가졌던 의문점들과 연결된 부분이 많아 한 번 소개해드리고자 가져왔습니다. 시작에 앞서 한 줄 summary 말씀드리자면, 과거의 불확실성과 action sequence의 일관성을 고려하기 위해 diffuison을 통해 action label sequence를 ‘생성’했다는 연구입니다.
Long-Term Dense Anticipation
성준님이나 제 LTA 연구 리뷰 글을 보셨다면 아시겠지만, LTA는 과거 시점에 해당하는 1인칭 비디오를 입력받아 사용자가 이후 어떤 action들을 수행할지를 (동사,명사) 쌍 형태의 action sequence(text)로 예측하는 task입니다. Dense anticipation은 여기에서 더 나아가서 미래의 action sequence와 각 action의 duration 지속시간까지 예측합니다. 다만 LTA에서는 action을 예측할 때 동사 따로, 명사 따로 예측하도록 구성되는 경우가 많았는데, dense anticipation에서는 task의 난이도 때문인지 모르겠으나(?) 동사, 명사를 따로 예측하지 않고 (동사,명사) 쌍이라는 하나의 action을 하나의 class로 취급합니다. 좀 더 디테일하게는 미래에 이어질 N개의 프레임에 대해 각각의 프레임이 어떤 action을 나타낼지를 예측합니다. 때문에 예측 가능한 action의 다양성이 제한될 거 같긴 한데, task 자체를 깊게 들여다보진 않아서 잘 모르겠네요. 제가 소개할 본 연구에서는 정확히는 “Stochastic” dense anticipation을 제시하는데, 해당 설명은 Intro에서 이어가도록 하겠습니다.
Intro
Long-term action anticipation 연구는 많은 real world application에 중요한 부분을 담당하기 때문에 많은 주목을 받고 연구되어 왔습니다. 하지만 저자들은 지금까지의 연구가 너무 deterministic하게 진행되어왔다는 점을 지적합니다. 하나의 관찰 observation을 봤을 때 단 하나의 미래 예측만을 평가했다는 것인데, 미래를 예측한다는 것은 본질적으로 불확실성을 지니기 때문에 하나의 과거 정보에서 여러 가지 가능한 미래가 나타날 수 있다는 점을 강조합니다. 따라서 저자들은 이러한 uncertainty를 고려하여 여러 개의 prediction을 생성하는 stochastic한 방법론이 필요하다고 주장합니다.
stochastic 기반 방법론들이 없던 건 아니었으나, 기존 연구들은 observation, 즉 과거 비디오(프레임)에 대한 action label이 주어진 상태로 미래를 예측했다고 합니다. 과거 프레임에 대한 GT action이나 Action Recognition Model로 인식된 action을 모델에 먹여 미래를 예측하도록 했다는 것이죠. 하지만 이런 방식으로는 과거에 대한 불확실성을 설명할 수 없다고 주장합니다. 예를 들어, occlusion이나 어중간한 조도 환경 때문에 특정 object를 오렌지라고도, 빵이라고도 인식할 수 있는 상황에서 각각 무엇이라고 인식했느냐에 따라 가능한 future action이 달라질 수 있다는 것입니다. (아래 그림 Predicted Samples 참고)
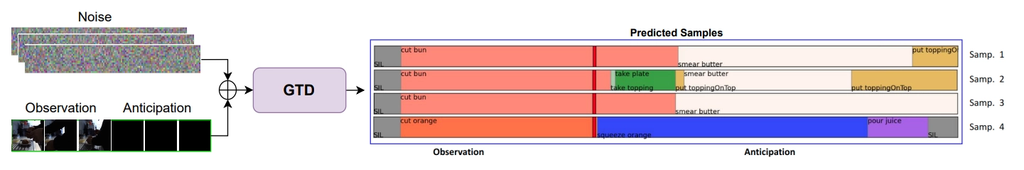
결국 저자들은 stochastic action anticipation이라는 task에서 미래에 대한 불확실성 뿐만 아니라 과거에 대한 불확실성도 고려해야 한다고 주장합니다. 이어서 과거, 미래의 불확실성을 모델링하는 Gated Temporal Diffusion (GTD)모델을 제안합니다. diffusion 자체가 여러 예측을 생성한다는 점에서 내재적인 불확실성을 고려하긴 하지만, GTD는 하나의 diffusion 과정에서 과거와 미래의 행동을 동시에 예측하여, 두 구간의 불확실성을 명시적으로 함께 모델링합니다. 이를 위해 fig1의 그림(왼쪽 부분) 처럼 joint sequence representation을 이용합니다. observation은 샘플링된 프레임을 인코딩하여 visual representation으로 뽑고, 미래에 해당하는 representation은 zero padding으로 만들어서 과거 시퀀스에 이어붙입니다. 이후 이 전체 representation sequence를 과거와 미래의 action variable(noisy)에 대한 프레임별 condition으로 사용하며, 학습 과정에서 해당 조건이 주어졌을 때의 행동 변수들의 결합확률을 학습합니다. 여기서 action variable은 과거 및 미래 프레임 각각에 해당하는 action을 원핫인코딩화한 뒤 action label sequence로 만들고, 여기에 노이즈를 추가하여 pure한 gaussian의 형태로 만든 것입니다. 즉 과거+미래 전체의 action label sequence를 noisy하게 만들었다, noisy action vector로 만들었다 이렇게 보시면 되겠습니다.
이렇게 과거와 미래를 하나의 represenation으로 묶으면 단일 diffusion 과정으로 모델링할 수 있지만, 미래 쪽을 heuristic하게 zero padding으로 세팅했기 때문에 정보의 차이, 특성의 차이가 존재합니다. 이러한 차이를 고려하여 저자들은 Gated Anticipation Network(GTAN)이라는 Generator를 제안합니다. GTAN은 과거 프레임과 미래 프레임을 구분하여 처리하고, 두 구간 사이의 정보 흐름을 데이터로부터 학습하여 조절하도록 합니다.
GTD와 GTAN은 BREakfast, Assembly101, 50salads라는 dense anticipation 벤치마크에서 SOTA를 달성했으며, stochastic anticipation을 포커싱했음에도 deterministic setting에서도 SOTA를 달성했다고 합니다.
Contributions
- stochastic long-term anticipation에 첫 diffusion 모델이 GTD를 제안하여 과거와 미래 action을 공동으로 모델링함.
- GTAN generator를 통해 과거와 미래 프레임 사이 정보의 흐름을 조절함.
- stochastic과 deterministic setting 모두에서 SOTA를 달성함.
Methods
Diffusion models
diffusion을 해당 task에 처음으로 적용했다 보니 일반적이니 diffuison model의 학습/추론 과정 설명이 포함되어 있었습니다. 사실 논문리뷰이다 보니 스킵해도 되긴하지만, 개인적으로도 아직 이해되지 않는 부분이 있고 diffusion을 처음 접하시는 분들도 계실 테니 간단하게 정리하고 넘어가겠습니다. 해당 설명이 괜찮다 하시는 분들은 2. Gated Temporal Diffuision 파트부터 읽으시면 될 듯 합니다.
diffusion은 정답에 노이즈를 섞고, 이를 복원하는 모델을 학습한 뒤, 추론에서는 pure한 가우시안 노이즈에서 새로운 샘플을 생성한다는 기본 토대를 가집니다.
1. Forward pass
정답에 노이즈를 추가하는 과정입니다. 원본 데이터를 Y_0, noisy data를 Y_t, t는 timestep이라고 할 때 노이즈 추가는 noise schedule에 따라 단계별로 아래 수식과 같이 진행됩니다.
\beta_t는 timestep마다 정해진 noise schedule에 따라 달라지는 노이즈 비율이며, 이에 따라 이전 step 데이터의 일정 비율에 가우시안 노이즈의 일정 비율을 더해주며 진행됩니다. 이러한 과정을 t번 반복했을 때 원본 데이터와 최종 noisy 데이터의 관계를 표현하면
마지막 단계의 noisy data Y_t는 pure한 가우시안 노이즈가 됩니다.
2. Train
학습할 때는 Y_t를 만들고 Generator G_\theta는 이 Y_t와 현재 단계 t를 받아 원본을 추정합니다.
\hat Y_{0,t}는 timestep t에서 원본을 추정한 값으로, epoch마다 매번 다른 t를 뽑기 때문에 학습 전체에 걸쳐 다양한 step에서 원본을 복원하도록 학습딥니다. 그렇게 뽑힌 해당 t에서 원본을 바로 추정하여 실제 원본과의 차이를 loss로 사용해서 학습됩니다.
3. Inference
pure gaussain noise Y_T에서 시작하여 모델이 원본 \hat Y_{0,T}을 추정하면 그 추정치를 이용해 다음 상태 Y_{t-1}를 만드는 과정을 반복합니다.
\hat Y_{0,t}=G_\theta(Y_t,t)
위와 같이 현재 timestep, 그리고 현재 상태 Y_t를 입력받아 원본을 추정하는데, 이때 처음에는 입력에 노이즈가 많기 때문에 원본 추정이 부정확할 가능성이 높습니다. 이때 forward 과정에서 식(2)를 통해 원본 데이터에서 noisy data를 만들었으니, 이것을 역으로 이용해 노이즈를 추정할 수 있습니다.
\hat\epsilon_t=\frac{Y_t-\sqrt{\gamma_t}\hat Y_{0,t}}{\sqrt{1-\gamma_t}}
즉 현재 입력에서 추정한 원본 \hat Y_{0,t}를 빼서 남아있는 노이즈를 계산한 것입니다. 이후 원본 추정값과 노이즈 추정값을 가지고 다음 timestep의 비율로 다시 섞어 평균을 계산합니다.
\hat\mu_t=\sqrt{\gamma_{t-1}}\hat Y_{0,t}+\sqrt{1-\gamma_{t-1}-\tilde\beta_t}\hat\epsilon_t
\tilde\beta_t=\frac{1-\gamma_{t-1}}{1-\gamma_t}\beta_t
DDPM(Denoising Diffusion Probablistic Models)에서는 이 평균 주변에서 다음 상태 Y_{t-1}를 샘플링합니다.
Y_{t-1}=\hat\mu_t+\sqrt{\tilde\beta_t}z,\qquad z\sim\mathcal N(0,I)
이를 통해 다음 상태 Y_{t-1}는 이전보다 원본 성분의 비중이 커지고, 결국 스텝마다 노이즈가 덜한 상태를 만들어 모델이 다시 추정하도록 만들어 점차 노이즈를 제거해나가는 꼴이 됩니다. 이를 반복하여 마지막 단계의 원본 추정값 \hat Y_{0,1}을 최종 샘플로 사용합니다.
다만 본 논문에서는 DDPM 대신 DDIM(~~Implicit Models)을 사용합니다. \tilde\beta_t를 0으로 설정하여 DDPM 업데이트에서 랜덤하게 추가하는 term이 사라집니다.
Y_{t-1}=\sqrt{\gamma_{t-1}}\hat Y_{0,t}+\sqrt{1-\gamma_{t-1}}\hat\epsilon_t
즉 초기 노이즈 Y_T가 같으면 이후 생성 과정도 동일해지며, 대신 다른 초기 노이즈를 뽑으면 다른 샘플이 나오므로 여러 미래를 생성하는데 사용될 수 있습니다. 저자들은 학습 때보다 적은 denoising step으로 추론할 경우 DDIM이 DDPM보다 좋은 성능을 보였다는 선행 연구 결과를 바탕으로 DDIM을 사용했습니다. 이상 배보다 배꼽이 큰(?) 디퓨전 설명 마치겠습니다.
Gated Temporal Diffusion for Anticipation
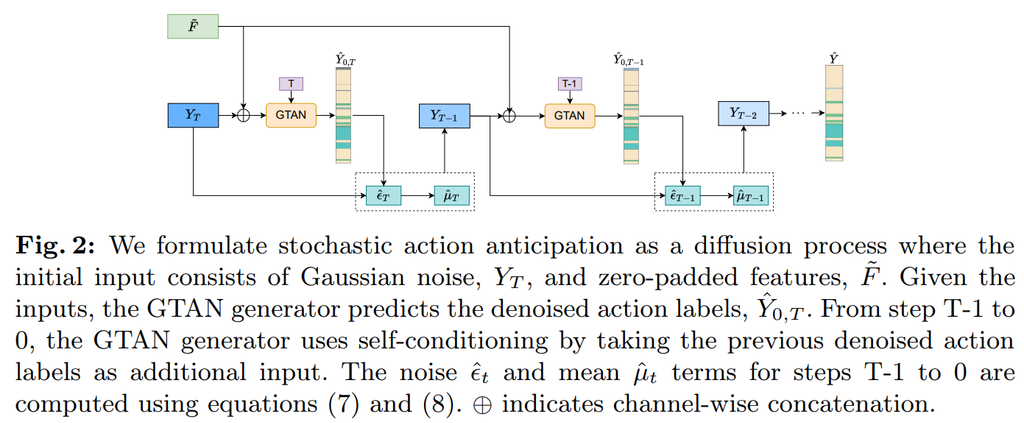
diffusion을 action anticipation에 적용하기 위해 아래와 같은 구성을 적용합니다.
- Input
- observation의 visual feature와 미래 구간의 zero padding feature를 이어붙인 representation sequence
- 학습에서는 관측 구간과 미래 구간의 GT action label을 one-hot 벡터로 표현하고, 시간 순으로 이어붙여 원본 action sequence를 구성. 이후 timestep t에 해당하는 noise를 추가하여 noisy action sequence를 만듭니다. 추론에서는 GT action label 없이 순수 Gaussian noise에서 시작.
- 최종 입력 : representation sequence, noisy action sequence, 그리고 이전 denoising 단계의 원본 action sequence 추정값을 채널 축으로 concat하여 구성합니다. 즉 각 시점의 벡터에는 visual feature, noisy action vector, 이전 단계의 원본 추정값이 이어붙여집니다. 이전 추정값을 추가 입력으로 사용하는 방식을 self-conditioning이라고 정의하며, 추론의 첫 단계에서는 해당 값을 0으로 설정합니다
이후 GTAN generator는 위 입력과 별도로 embedding된 timestep t를 받아 원본 action sequence를 추정합니다. 이때 복원 대상은 미래 구간뿐 아니라 관측 구간까지 포함하는 전체 action sequence입니다.
추론 과정에서는 원본 추정값을 이용해 현재 상태의 노이즈를 추정하고, 원본 추정값과 노이즈 추정값으로 다음 상태 Y_{t-1}를 계산합니다. 본 논문에서는 DDIM을 사용하므로, 이 업데이트 과정에서 추가적인 랜덤 노이즈를 넣지 않고 다음 상태를 결정적으로 계산합니다.
다음 단계에서는 현재 noisy action sequence Y_{t-1}, 이전 단계에서 추정한 원본 action sequence \hat Y_{0,t}, 그리고 동일한 representation sequence를 GTAN에 입력합니다. GTAN이 원본을 다시 추정하면 이를 이용해 다음 상태 Y_{t-2}를 계산하며, 이러한 과정을 반복합니다.
최종적으로 얻은 원본 action sequence 추정값에 클래스 축으로 argmax를 적용하여 각 시점의 action label 예측값을 구합니다. 초기 Gaussian noise를 다르게 샘플링하면 동일한 관측 영상에서도 서로 다른 action sequence를 생성할 수 있으며, 이를 통해 관측 구간과 미래 구간의 불확실성을 함께 모델링합니다.
Gated Anticipation Generator (GTAN)
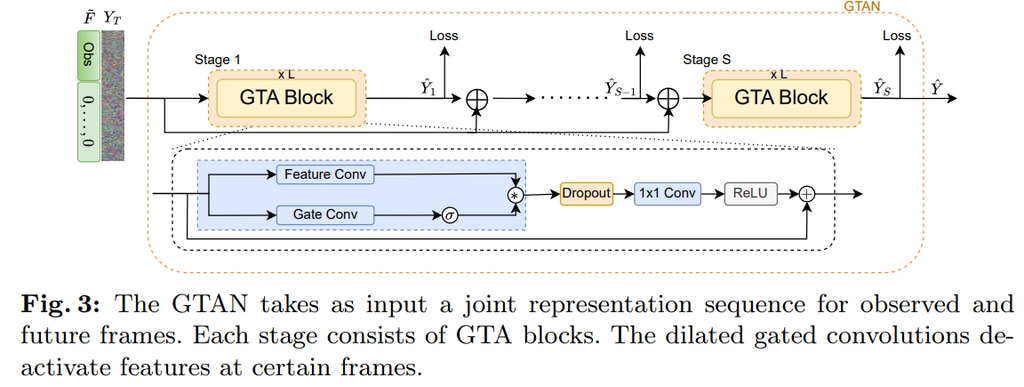
GTAN은 여러 stage로 구성되며, 각 stage는 여러 GTA block을 거쳐 원본 action sequence를 추정합니다. 입력은 visual feature, noisy action vector, 그리고 self-conditioning을 위한 이전 단계의 원본 추정값으로 구성됩니다. 각 GTA block에서는 입력을 feature conv와 gate conv에 각각 전달하며, 두 연산 모두 시간 축의 dilated convolution을 사용합니다. 각 stage에서 block이 깊어질수록 dilation rate를 두 배씩 증가시켜, 시간적으로 멀리 떨어진 시점까지 참고할 수 있도록 receptive field를 넓힙니다. Gate는 관측 구간과 미래 구간을 동일하게 처리하는 대신, 두 구간 사이의 정보 혼합 정도를 데이터로부터 학습하여 조절합니다. 구체적으로 gate conv 출력에 sigmoid를 적용하여 0~1 사이의 gate 값을 얻고, 이를 feature conv 출력과 원소별로 곱해 정보의 통과 정도를 조절합니다. 이후 dropout, 1×1 conv, ReLU를 거친 결과에 입력을 더하는 residual connection을 적용합니다. 이러한 GTA block을 거쳐 각 stage에서 clean action vector를 추정하며, 추론의 마지막 denoising 단계에서 마지막 stage의 출력을 최종 원본 action sequence 추정값으로 사용합니다.
Loss
학습 과정에서는 앞서 설명한 것처럼 임의의 timestep t를 뽑고, GT action sequence에 해당 단계의 noise를 추가하여 noisy action sequence를 만듭니다. GTAN은 이를 입력받아 clean action vector를 추정하며, 추정값과 실제 GT 사이의 L2 reconstruction loss를 이용해 학습됩니다.
다만 GTAN은 여러 stage로 구성되고 각 stage에서 원본 action sequence를 추정하므로, 마지막 stage의 출력만 사용하는 것이 아니라 모든 stage의 추정값에 loss를 적용하여 합산합니다.
여기서 S는 GTAN의 전체 stage 수이며, \hat Y_{s,0,t}는 diffusion timestep t에서 s번째 stage가 추정한 원본 action sequence입니다. 이때 loss는 미래 구간뿐 아니라 관측 구간에도 함께 적용됩니다. 즉 관측 구간의 action을 복원하는 것과 미래 action을 예측하는 것을 하나의 reconstruction loss로 학습하는 구성입니다.
추가로 저자들은 stochastic anticipation뿐 아니라 deterministic anticipation에서도 GTAN의 성능을 평가했습니다. 이 설정에서는 diffusion 과정을 사용하지 않고, 미래 구간이 zero padding된 visual feature sequence만 입력하여 action sequence를 바로 예측합니다. 학습에는 L2 reconstruction loss 대신 cross-entropy loss를 사용하며, 마찬가지로 모든 stage와 관측·미래 구간의 모든 시점에 loss를 적용합니다.
L_{\mathrm{determ}}=-\sum_{s=1}^{S}\sum_{n=1}^{N}\sum_{c=1}^{C}Y_c^n\log\hat Y_{s,c}^n
여기서 Y_c^n는 시점 n의 GT 원핫벡터에서 클래스 c에 해당하는 값이며, \hat Y_{s,c}^n는 s번째 stage가 예측한 해당 클래스의 확률입니다. 학습은 관측 구간과 미래 구간에 함께 수행하지만, 평가에는 미래 구간의 예측값만 사용합니다.
Experiments
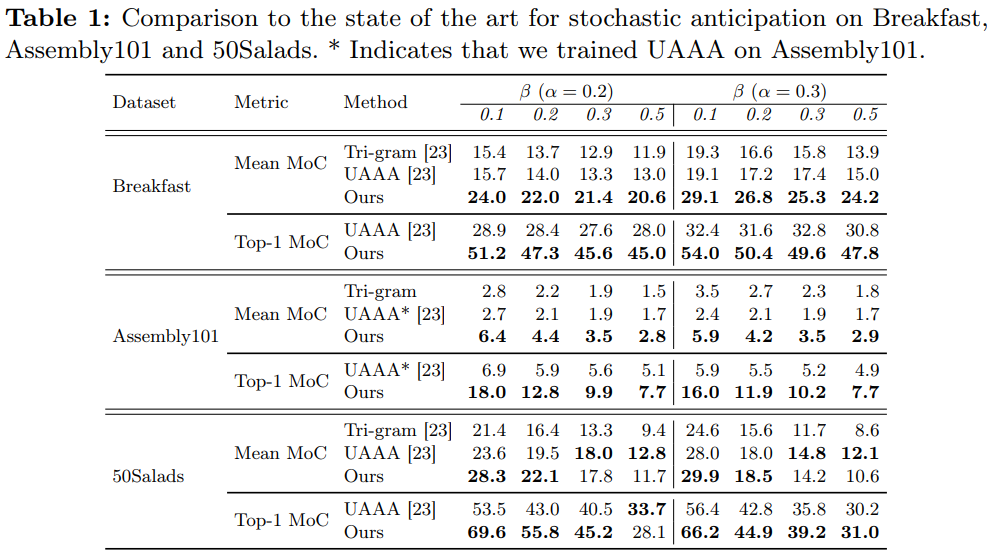
Table 1은 세 데이터셋에서 평가한 stochastic anticipation 성능 테이블입니다. \alpha는 전체 비디오에서 관측하는 구간의 비율이고, \beta는 전체 비디오에서 미래 예측 구간이 차지하는 비율입니다. 예를 들어 100초 영상에서 \alpha=0.2,\ \beta=0.3이면 처음 20초를 관측하고, 그 직후의 30초, 즉 20~50초 구간의 action을 예측합니다. 여기서 \beta는 남은 영상이 아니라 전체 영상 길이를 기준으로 합니다. 실험에서는 \alpha\in{0.2,0.3}, \beta\in{0.1,0.2,0.3,0.5}를 사용합니다.
평가 지표인 MoC(Mean over Classes)는 각 action class의 프레임 단위 정답률을 구한 뒤, 클래스별로 동일한 비중을 두고 평균한 값입니다. 즉 특정 클래스의 GT 프레임 중 해당 클래스로 정확하게 예측한 비율을 계산합니다. 전체 프레임의 정답률을 바로 계산하는 것과 달리, 영상에서 오래 등장하는 행동에 평가가 치우치는 것을 줄일 수 있습니다. 값이 높을수록 좋은 성능을 의미합니다.
본 실험에서는 동일한 관측 영상에 대해 서로 다른 초기 노이즈로 25개의 미래 action sequence를 생성하고, Mean MoC와 Top-1 MoC를 리포팅합니다. Mean MoC는 생성한 25개 예측의 MoC를 평균한 값으로, 생성 결과가 평균적으로 얼마나 정확한지 보여줍니다. 반면 Top-1 MoC는 25개 중 GT에 대해 가장 높은 MoC를 얻은 예측의 점수입니다. 비교군이 많지는 않지만 기존 연구들 대비 큰 성능 개선 폭을 보여주었습니다. 물론 50 salads에서는 모든 세팅에서 우세하진 않았습니다.
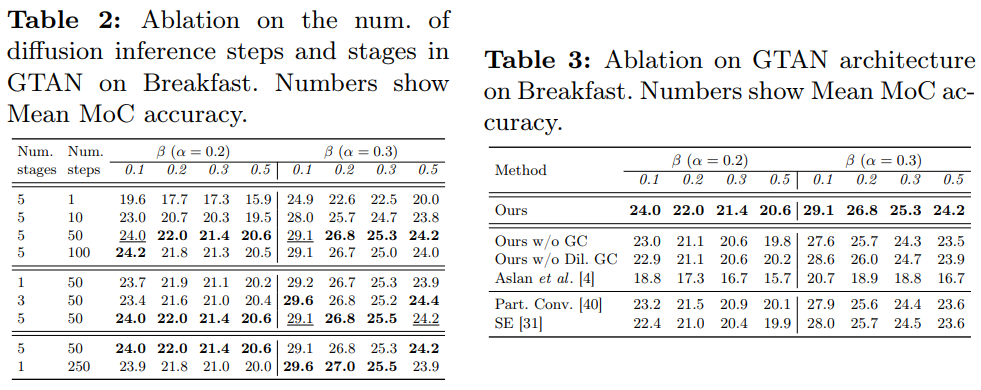
Table 2는 denoising steps와 GTAN stages 수에 따른 ablation 실험입니다. Denoising step을 10에서 50으로 늘리면 성능이 개선되지만, 100까지 늘려도 추가적인 이득은 크지 않았습니다. 단일 stage도 250 step을 사용하면 5 stage의 성능에 근접합니다. 저자들은 이후 실험에서 5 stage와 50 step을 사용했습니다.
Table 3는 gate 구조에 대한 ablation입니다. gate를 제거하거나 gate conv의 dilation을 제거하면 성능이 감소했으며, 또한 수동 mask를 사용하는 partial convolution과 채널별 가중치를 조절하는 SE보다 제안 구조가 우수했습니다. 저자들은 이를 데이터로부터 학습하는 temporal gating의 중요성을 보여주는 결과로 해석합니다.
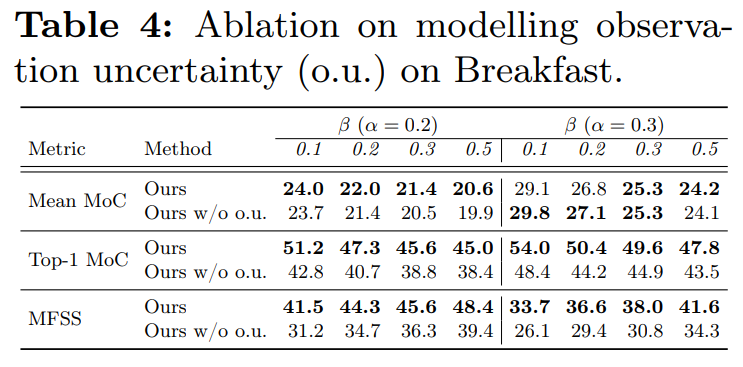
저자들은 관측 구간의 불확실성을 함께 모델링하는 효과를 확인하기 위해, 기존 모델과 이를 제거한 모델을 비교했습니다. 비교 모델(w/o o.u.)은 MS-TCN으로 관측 구간의 action label을 먼저 예측하고, 이 라벨을 visual feature 대신 조건으로 사용합니다. 또한 loss를 미래 구간에만 적용합니다. 즉 미래 action을 하나의 인식 결과로 고정하여, 서로 다른 과거 해석에서 발생하는 미래의 차이를 모델링하지 않는 구성입니다.
다양성을 평가하기 위해 MFSS(Mean Framewise Sample Similarity)라는 지표도 사용했는데, 예측 시퀀스 두 개가 같은 시점에서 서로 다른 라벨을 출력한 비율에 기반합니다. 생성한 25개 시퀀스의 모든 쌍에 대해 이 비율을 계산하고, 영상별 결과를 평균합니다. 따라서 값이 높을수록 예측들이 서로 다릅니다. 다만 다양성을 측정하는 지표이므로, 높다고 정확하거나 타당한 예측이라는 뜻은 아닙니다.
결과적으로 관측 불확실성을 제거해도 Mean MoC는 대체로 비슷했지만, Top-1 MoC와 MFSS는 모든 설정에서 감소했습니다. 예를 들어 \alpha=0.2,\ \beta=0.1에서 Mean MoC는 24.0→23.7로 변화가 작지만, Top-1 MoC는 51.2→42.8, MFSS는 41.5→31.2로 감소합니다. 저자들은 이를 관측 불확실성 모델링이 다양한 미래 후보 생성과, 그중 실제 미래에 가까운 후보를 포함하는 데 기여하는 결과로 해석합니다.
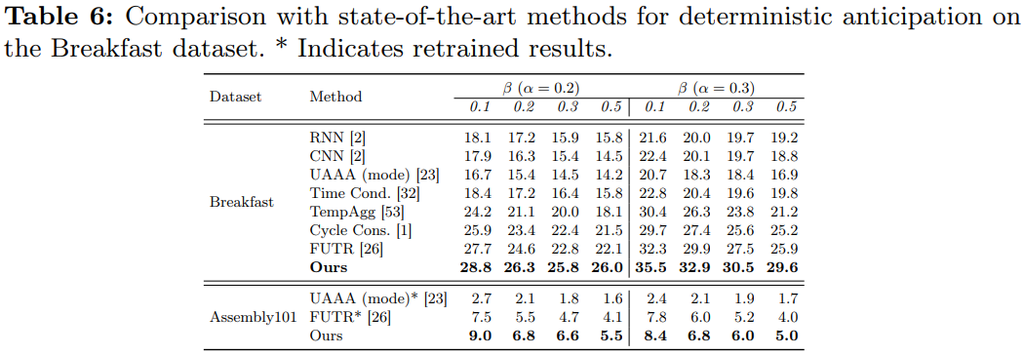
마지막으로 Table 6는 diffusion 없이 GTAN만 사용하여 deterministic setting에서 평가한 결과입니다. 본 setting에서도 SOTA 성능을 기록했습니다.
Conclusion
저자들은 본 연구의 limitation을 계산 효율성이라고 언급하며 마무리합니다. 예를 들어, 평균 미래 예측 구간이 1.15분인 Breakfast 데이터셋에서 하나의 예측을 생성하는 데 평균 3.8초가 소요되니, mid-term anticipation 쪽에선 괜찮지만 추론 시간을 추가로 줄일 필요가 있다고 언급합니다. 다만 본 task의 후속 연구들을 봤을 때는 dilated convolution의 한계를 지적하며 ‘긴 시간 거리의 정보를 효과적으로 aggregate 하는 방법’에 포커싱을 두고 연구되고 있었습니다.
제가 이 논문을 소개해드린 이유는 불확실성 uncertainty에 다루고 방법론이나 평가에 있어 이 점을 충분히 고려했다고 생각되기 때문이었습니다. 기존 LTA task에서는 visual 정보를 처리하거나 과거 비디오에 드러난 action을 잘 인식해서 transformer나 LLM이 future action sequence를 잘 예측하도록 할 거냐가 메인이며 평가 지표 역시 결국 GT와의 차이를 의미하는 Edit Distance를 사용했기 때문에, 이 uncertainty를 고려한 method나 평가 방식이 등장해야 되지 않을까라는 생각을 가지고 있었습니다. 그런데 옆동네 task인 dense prediction에서 uncertainty를 이미 다뤘음에도 지금까지의 LTA에선 왜 깊게 다루지 않았을까 생각이 들긴 하네요. 여튼 diffusion을 통한 uncertainty modeling과 과거의 불확실성까지 고려한 과거,미래 동시 예측은 LTA만 보던 저에게는 굉장히 신선하게 다가왔던 것 같습니다. 아마 action anticipation이 아니더라도 긴 시퀀스 형태의 output을 요구하는 task에서 잘 써먹을 수 있을 만한 method가 아닐까 싶네요. 이상 리뷰 마치겠습니다 감사합니다!