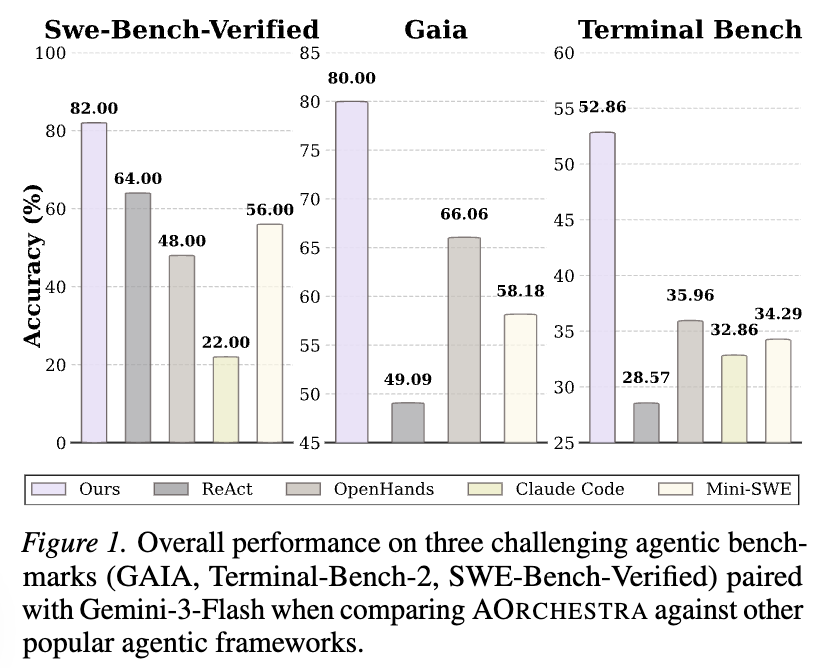
본 논문은 언어 에이전트의 동적 설계에 관한 것입니다. 현존하는 에이전틱 디자인은 설계에 있어 sub agent의 규칙등이 미리 설계되는 등 추상화 관점에서 동적인 설계 능력은 완벽하지 못합니다. 본 연구는 통일된 framework-agnostic agent 추상화 방법으로 에이전틱 시스템인 Aorchestra를 제시합니다. 해당 디자인을 통해 도전적인 벤치마크(GAIA, SWE-Bench, Terminal Bench)에서 Gemini-3-Flash와 결합하여 SOTA 대비 16.28%의 성능 향상을 달성했습니다.
@필요성:
집단지성은 인간이 복잡한 문제를 해결할 때 사용하는 전략입니다. 논문의 예시는 아니지만 법원이나 국회에서 다양한 입장을 고려하여 더욱 안전한 답변을 도출해낼때 사용되고는 합니다. 멀티 에이전트 협업은 이러한 인간의 소통 전략을 모방하기 위한 시도 중 하나입니다. 우리는 멀티 에이전트 협업 전략을 통해 단일 에이전트가 접근하지 못하는 방식으로 더욱 복잡한 문제를 해결할 수 있기를 원하며, 이것이 본 연구주제의 필요성 입니다.
@포지셔닝(멀티 에이전트 협업):
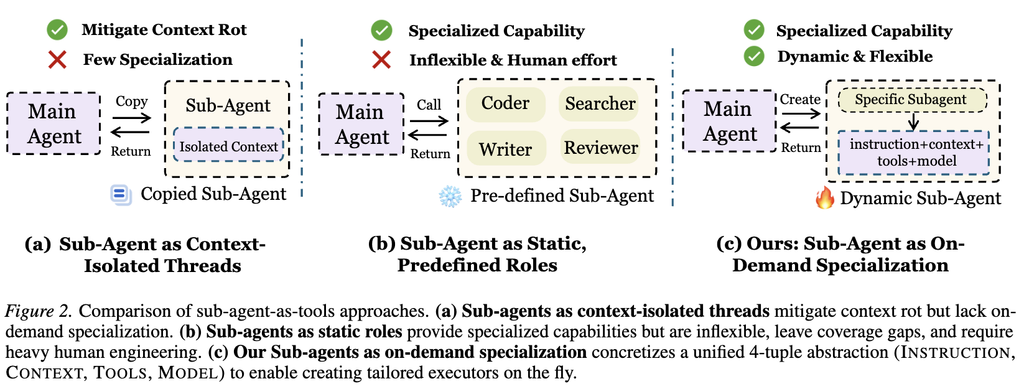
멀티 에이전트 협업 연구는 테스크를 쪼개어 해결한다는 장점이 있지만, 그로인해 여러 에이전트가 어떤 정보를 주고받거나 우선시할지 결정하는데 있어 조정 오버헤드가 발생하거나 context 관리에 실패하곤 합니다. 따라서 최근에는 하나의 주 에이전트(orchestrator)가 보조 에이전트를 도구처럼 호출하는 sub-agent-as-tools 페러다임이 일반적으로 받아들여지고 있습니다.
소통에 있어서 제약된 패턴을 한정하거나, sub-agent의 규칙을 미리 설정하여 한정된 tool을 활용하여 자유도가 떨어집니다. 최근 연구의 접근법은 Figure2를 통해 확인할 수 있습니다. 먼저 Figure2 (a)의 맥락 고립형 에이전트(Sub-agents as context-isolation threads) 방식은 LLM이 처리 가능한 토큰의 용량에 제약이 있다는 한계를 극복하기 위해 특정 에이전트가 불필요한 정보 없이 특정 테스크 수행에 필요한 정보만을 전달받는 구조로 에이전트간의 완벽한 격리를 지향합니다. 그러나 이러한 접근 방식은 정보의 의미나 유용성을 고려하지 않고 제약된 정보만을 공유하기 때문에 문제 해결에 성능에 한계를 두는 방식입니다. 다음으로 Figure2 (b)의 정적 역할(sub-agents as static, predecined roles)의 경우 특정 업무를 위해 전문적으로 설계된 에이전트를 sub-agent로 활용하는 방법으로 시스템 동작 환경이 변화한다면 대응력이 떨어지는 고착화된 구조입니다.
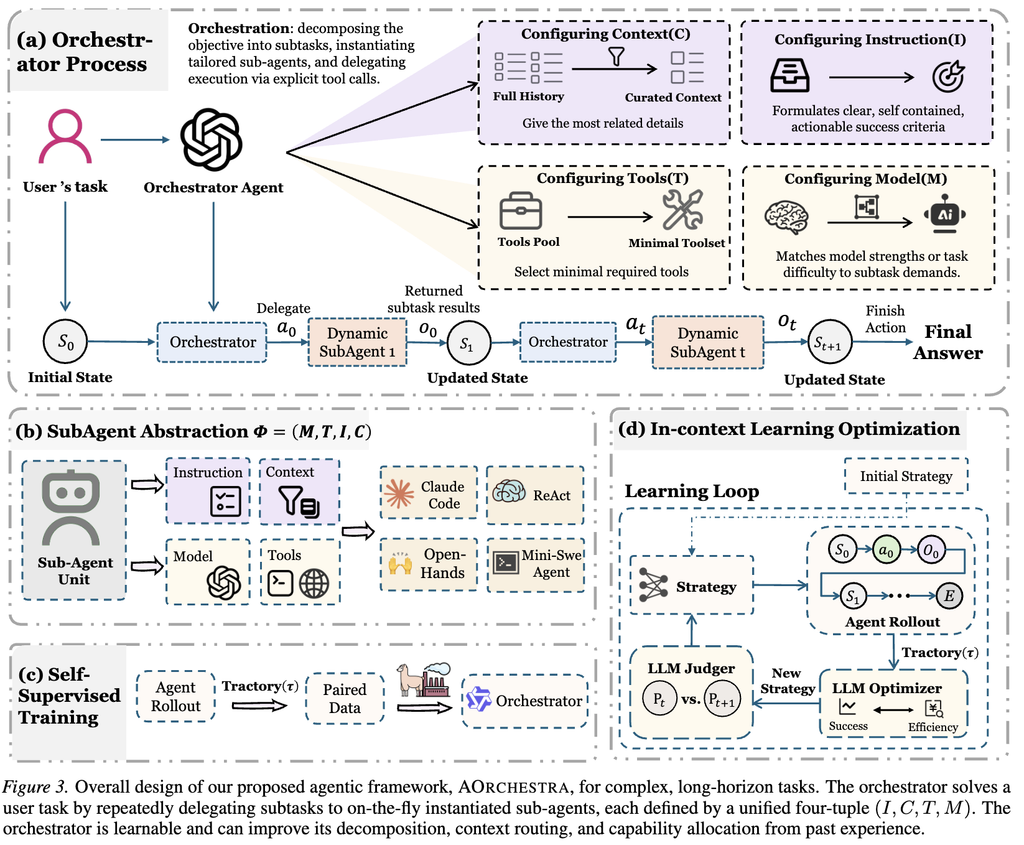
한편 제안하는 방식은 Figure2 (c)의 온디멘드 구조로 하위 에이전트의 역할이 동적이며 정보량을 고려하여 문제해결에 맥락도 함께 전달하는 협업 구조를 설계하였습니다. 저자들은 sub-agent 설계에 있어 유동적이고 추상적인 설계를 해야한다고 주장하여 설계를 제시하였고, 이를 위해 INSTRUCTION, CONTEXT, TOOLS, MODEL이라는 4-튜플 구조로 에이전트를 설계합니다. 또한 해당 인터페이스를 활용하여 테스크를 하위 테스크로 나누고, 하위 테스크 수행을 위한 agent를 즉석으로 설계하는 Orchestrator를 도입합니다.
@문제 정의:
본 연구는 orchestrator-centric agent system 설계 방법을 소개하며, 문제를 subtask로 나누고 subtask를 위한 agent를 설계하는 orchestrator 에이전트를 제안합니다.
orchestrator는 전체 task 달성이라는 목표(G)에 도달하기 위해 궤적(τ)을 설계합니다. 궤적은 t시점의 상황(s_t), t 시점에 수행한 행동(a_t), t시점에 수행한 행동의 결과/관측(o_t)의 주기 순환 구조로 이루어집니다.
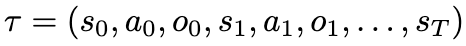
본 연구는 sub-agent-as-tools 관점에서 멀티 에이전트 시스템을 제안하고 있습니다. 특히 핵심이 되는 orchestrator의 action space는 일반적인 에이전트 설계의 action space(A_env)에 위임과 테스크 종료 동작을 더한 action space(A_orch)로 정의됩니다. 한편 A_env 내부의 동작(ex, 터미널 실행, 웹 브라우저 등)은 orchestrator가 직접 수행하는 것이 아니라, sub agent를 설계하여 탐색하는것이 바람직하나, 일반적으로는 A_orch가 A_env를 포함하는 구조입니다.
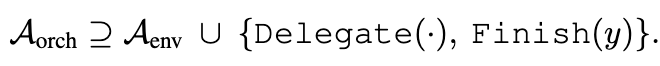
최종적으로 제안하는 디자인인 Aorchestrator 의 구현에 있어, orchestrator의 파라미터/정책(π)의 설계식은 아래와 같으며, 목적 수행 확률은 높이고(Success(G)) 동시에 궤적 수행에 소모되는 토큰 수를 최소화하여 효율성을 높이는(-Cost(τ)) 최적의 정책 π을 찾는것을 문제로 합니다.
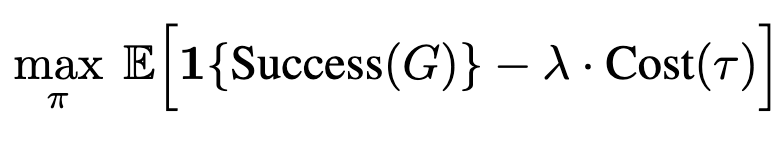
@방법론:
- Aorchestra 컨셉 디테일
- 통일된 four-tuple 구조 기반 에이전트 추상화
- orchestrator의 action space
- Orchestrator 에이전트 학습방법
- 지도학습
- in-context learning
[Aorchestra]
제안 연구는 agent의 추상화를 위해 정의를 위한 핵심 요소 4가지(I, C, T, M)를 정의하여 설계에 활용하였습니다. 이 핵심요소 4가지는 아래와 같습니다. 이때 I, C는 작업기업에 속하며 T,M은 능력이라는 축으로 분류할 수 있습니다.
- I(INSTRUCTION): 현재의 목표와 성공 기준을 명확히 하는 작업 지침
- C(CONTEXT): 에이전트가 작업 지침 수행을 위해 알아야하는 작업의 맥락
- T(TOOLS): 에이전트의 행동 공간
- M(MODEL): 환경과 상호작용할 모델
본 논문에서는 문제 정의에 소개된 기존의 sub-agent-as-tools의 일반적 구조와 다르게, orchestrator가 접근 가능한 action space를 일반 에이전트의 역할과 완전하게 분리하여 오직 위임과 테스크 종료만 가능하게 합니다.
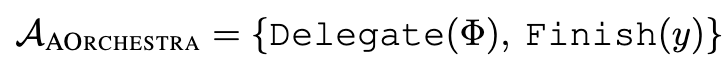
Delegate는 4-튜플(Φ)를 정의하여 sub-agent를 설계하고 실행시키는 동작이며, Finish는 task가 충분히 수행되었다고 판단할 때 최종 답변인 y를 출력하고 실행을 종료하는 동작입니다. sub-agent실행 방법은 Φ=(I, C, T, M)을 활용하여 모델 M을 활용하여 tool set을 T(≈rule, 규칙)로 제한하고, 테스크 수행에 필요한 작업기업(I, C)을 제공하여 수행하게 합니다. 이후 orchestrator는 실행 결과(o)와 간단한 결과요약, 생성되거나 수정된 결과물(파일/레퍼런스 등), 에러메세지나 로그를 출력으로 전달 받습니다. orchestrator는 이 관측 결과와 상황(s: history, 중간 결과 등)을 기반으로 다음 action을 선택하게 됩니다.
[Learnable Orchestroator]
orchestrator 설계의 핵심은 현재의 상황(s)에서 수행가능한 action space 기준으로 최적의 action을 선택할 수 있는 정책(π)를 찾는것입니다. 본 논문에서는 orchestrator의 설계를 위해 supervised fine-tuning과 iterative in-context learning이라는 두가지 방법을 제시합니다.
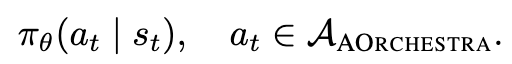
[supervised fine-tuning]
먼저 저자들은 orchestrator 설계를 위해 *TaskCraft와 같은 에이전트 sub-task 생성 프레임워크에 Gemini-3-Flash를 결합하여 생성한 약 2,000개의 궤적(τ={s*, a*})을 사용하여 orchestrator(θ)를 full-parameter fine-tuning으로 학습했습니다. 이때 학습 데이터 생성시에도 action space는 위임과 종료로 제약을 두었습니다.
*TaskCraft: Automated Generation of Agentic Tasks
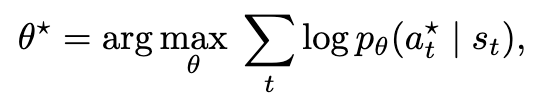
[iterative in-context learning]
다음으로는 모델 파라미터 업데이트 없이 orchestrator의 instruction을 최적화하는 방법으로 프롬프트를 반복적으로 최적화하는 방식을 적용했습니다. optimization model을 통해 k(k>=1)번째 까지의I_(k)와 그 결과(perf-성공 여부, cost-토큰 활용 수)를 통해 I_(k+1)를 개선하는 것으로 논문에서는 한번의 궤적 수행에 대해 5번씩 반복하여 최적화 과정을 수행했다고 합니다.
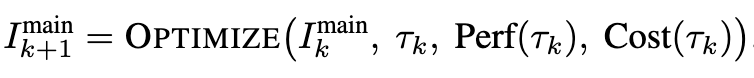
@실험:
[벤치마크]
Aorchestra는 서로 다른 유형의 장기·다단계 agentic task를 포함하는 세 가지 벤치마크에서 평가되었습니다.
GAIA는 웹 검색, 문서 처리, 정보 통합, multimodal reasoning 등 다양한 도구 사용 능력을 요구하는 general-purpose agent benchmark입니다. 단순한 지식 질의가 아니라 여러 단계의 정보 수집과 추론을 수행해야 하므로, subtask decomposition과 context 관리 능력을 평가하기에 적합합니다.
Terminal-Bench 2.0은 Linux terminal 환경에서 실제 shell 명령을 수행하며 task를 해결하는 benchmark입니다. Agent는 파일 탐색, 패키지 설치, 프로그램 실행, 오류 수정 등 다양한 terminal operation을 수행해야 합니다. 이 benchmark는 sub-agent의 tool 선택과 장기적인 실행·복구 능력을 평가합니다.
SWE-Bench-Verified는 실제 오픈소스 GitHub repository에서 발생한 issue를 해결하는 software engineering benchmark입니다. Agent는 오류가 발생한 코드를 분석하고, 적절한 patch를 작성한 뒤, 테스트를 통과시켜야 합니다. 따라서 코드 이해, 수정, 검증으로 이어지는 복합적인 agent workflow를 평가할 수 있습니다.
[벤치마크 실험]
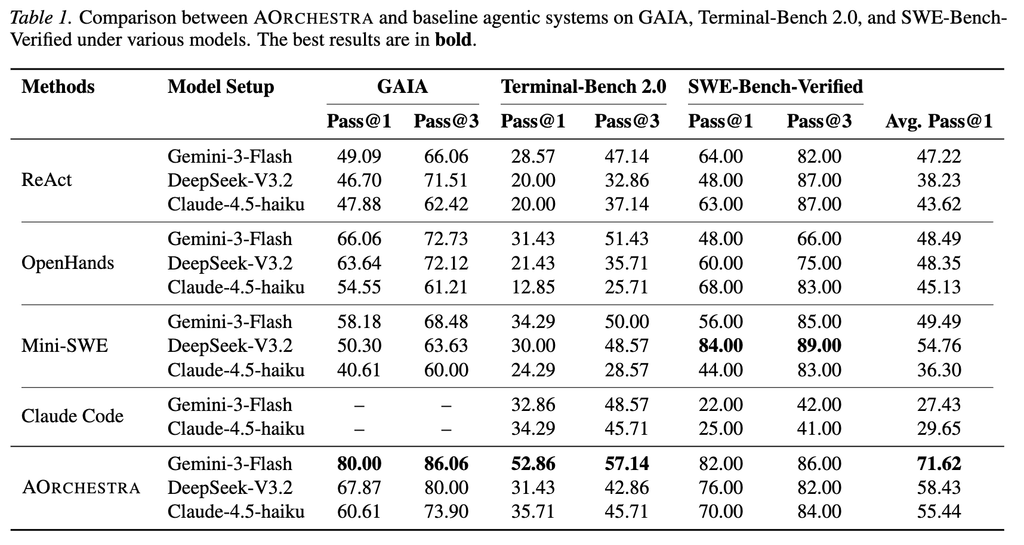
세 benchmark에서 AOrchestra는 비교 대상 framework보다 전반적으로 높은 성능을 보였습니다. Aorchestra는 orachstrator 모델로 Gemini-3-Flash를 활용하였으며, model setup의 모델은 sub-agent에 활용되었으며 실험 결과 모든 환경에서 대체로 높은 성능을 보임을 알 수 있습니다.
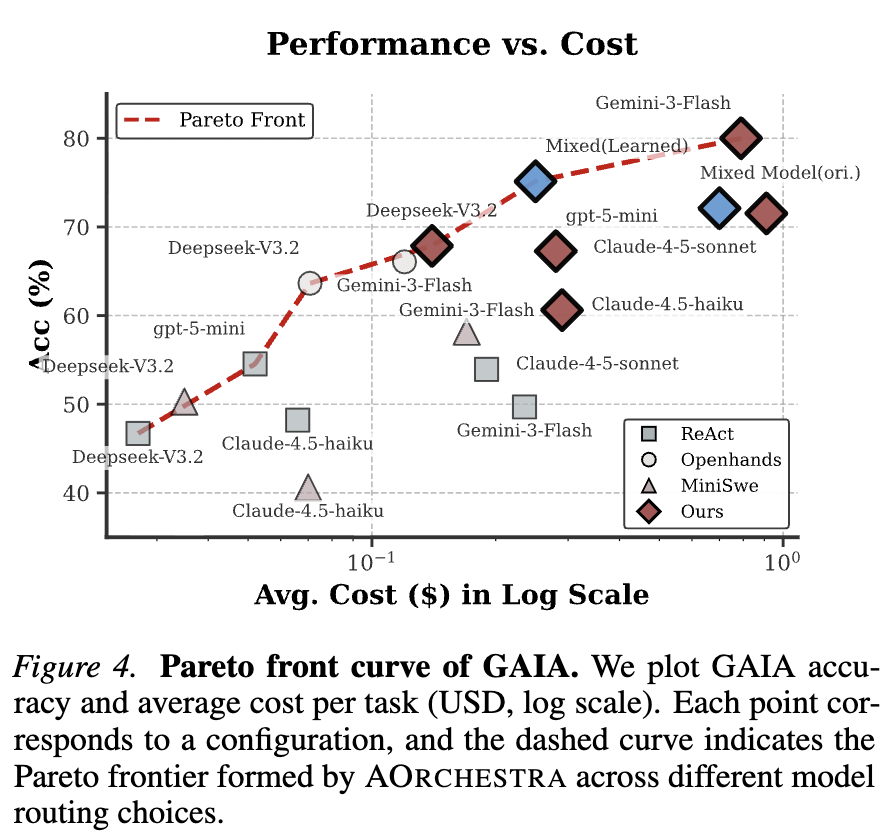
또한 비교 방법론 대비 token 효율성과 정확도의 trade-off 벨런스를 잘 맞추었음을 확인할 수 있습니다. (Pareto Front에 따라 그려진 점선 부근에 위치할수록 비용 대비 성능이 최적화 되었다고 판단) 즉, 기존 프레임워크 대비 높은 정확도를 기록하면서도 최적화된 경로를 유지하고 있다고 볼 수 있습니다.


