안녕하세요. 이번에는 Coconut이라고 불리는 논문을 읽어보았습니다. COLM 이라는 학회에 붙어서 어색해보일 수 있는데, 24년도에 생긴 꽤나 높은수준의 학회인 것 같습니다. 애초에 논문도 Meta 논문이긴 합니다.
최근에 Latent Reasoning, 특히 언어 토큰을 직접 생성하지 않고 hidden space에서 reasoning을 수행하는 연구들을 살펴보고 있는데, 그중에서도 Coconut은 이후 latent reasoning 계열 연구에서 상당히 자주 언급되는 초기 연구로 파악했습니다. 제가 우선 11월에 KRoC에 논문을 제출하고 이후 findings가 있다면 학회나 저널로 확장시키기에 괜찮은 주제로 생각되어서 읽게되었고 지금은 latent reasoning이 Visual latent reasoning까지도 확장되어있습니다.
기존 LLM의 reasoning이라고 하면 가장 먼저 떠오르는 것이 Chain-of-Thought(CoT)입니다. 문제를 한 번에 풀기보다는 reasoning 과정을 자연어 token sequence로 풀어내는 방식인데 해당 논문은 LLM 이 Reasoning을 꼭 실제 language space에서 해야할지에 대한 의문을 던졌다고 생각하면 됩니다.
그럼 리뷰 시작하겠습니다.
Abstract
기존 LLM은 복잡한 문제를 해결할 때 reasoning 과정을 자연어 token으로 생성하는 Chain-of Thought(CoT)를 주로 사용합니다.
하지만 저자들은 자연어 token마다 필요한 reasoning complexity가 크게 다름에도 불구하고, 현재 LLM은 각 token prediction에 거의 동일한 computation을 사용한다는 점을 문제로 지적합니다. 많은 token은 문장의 통일성(문장구조를 유지한다는 뜻입니다)을 유지하기 위한 역할을 하는 반면, 일부 critical token에서는 복잡한 planning이 필요하기 때문입니다.
이를 해결하기 위해 저자들은 Coconut, Chain of Continuous Thought를 제안합니다.
Coconut은 LLM의 마지막 hidden state를 reasoning state인 continuous thought로 사용하고, 이를 word token으로 decoding하지 않은 채 다음 step의 input embedding으로 직접 다시 입력합니다.
이를 통해 reasoning 과정이 language space에 제한되지 않고 continuous latent space에서 진행될 수 있습니다.
저자들은 이러한 latent reasoning 과정에서 하나의 continuous thought이 여러 reasoning step을 동시에 표현할 수 있음을 알아냈다고 합니다. 이 말은 기존의 CoT는 하나의 reasoning path를 즉시 선택해야하는데, 여러 후보를 유지한 뒤 점진적으로 잘못된 경로를 제거하는 BFS(Breadth-Frist Search) 방식이 가능하다는 뜻입니다.
실험에서는 search와 planning이 중요한 logical reasoning task에서 Coconut이 CoT보다 높은 성능을 보였으며, inference 시 생성되는 token 수도 줄어 accuracy와 efficiency 사이에서 더 좋은 trade-off를 보였다고합니다.
Introduction
앞서 말했듯이 LLM은 대규모 language pretraining을 통해 높은 reasoning 능력을 보여왔으며, 대표적인 reasoning 방식으로 Chain-of-Thought(CoT)가 널리 사용되고 있습니다.
하지만 저자들은 next-token prediction 기반의 현재 LLM 구조가 reasoning 과정을 반드시 word token sequence로 표현하도록 제한한다는 점을 지적합니다.
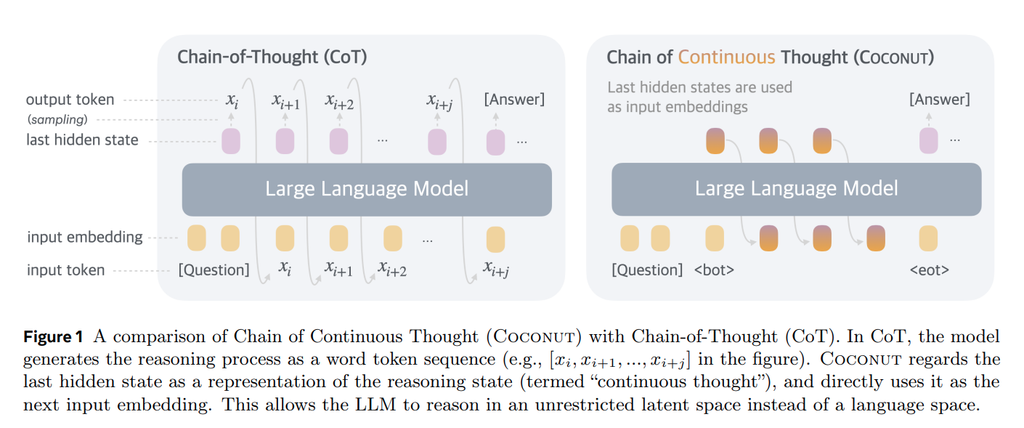
즉 모델 내부에서 reasoning이 이루어지더라도, 각 reasoning step은 language model head를 거쳐 vocabulary상의 discrete token으로 변환되어야 하고, 다시 embedding으로 변환된 뒤 다음 step에 입력됩니다.
저자들은 이러한 language-based reasoning이 반드시 최적일 필요는 없다고 주장합니다. 특히 기존 연구에서는 human language system이 reasoning 자체보다는 communication에 더 특화되어 있을 가능성이 보고되어 왔습니다. (이는 제 이전논문에서 사용하는 개념인 Mental imagery와 비슷합니다.)
또한 CoT에서는 reasoning chain의 모든 token이 동일한 수준의 중요도를 가지지 않습니다. 일부 token은 reasoning에 핵심적인 planning을 필요로 하는 반면, 많은 token은 textual coherence(문장구조)를 유지하기 위해 생성됩니다.
기존 연구에서는 reasoning chain을 더 짧게 만들거나 특정 token을 생성하기 전에 추가 computation을 수행하는 방식으로 이러한 문제를 완화하려 했지만, 여전히 reasoning 과정이 language space 내부에서 수행된다는 한계가 있습니다.
이에 저자들은 reasoning 과정 자체를 latent space로 옮기는 Coconut을 제안합니다.
Coconut에서는 reasoning step 동안 LM head와 token embedding을 거치지 않고, LLM의 마지막 hidden state를 continuous thought로 사용하여 다음 step의 input embedding으로 직접 전달합니다.
즉 기존 CoT가
hidden state → word token → embedding → next hidden state
의 과정을 반복한다면, Coconut은
hidden state → next hidden state
형태로 reasoning을 이어갑니다.
이 구조는 continuous thought가 fully differentiable(미분가능)하기 때문에 end-to-end optimization이 가능하다는 장점도 가집니다.
다만 pretrained LLM은 원래 자신의 hidden state를 다음 input embedding으로 사용하도록 학습되지 않았기 때문에, 저자들은 language reasoning chain을 활용한 multi-stage training strategy를 사용한다고 합니다. 학습 초기에는 기존 CoT를 활용하고, 이후 reasoning 과정의 language token을 점진적으로 continuous thought로 대체하면서 latent reasoning을 학습합니다.
저자들은 이 과정에서 Coconut이 기존 CoT와 다른 reasoning pattern을 형성한다고 하는데, CoT는 매 step에서 하나의 discrete token을 선택하기 때문에 특정 reasoning path에 순차적으로 commit하게 됩니다. 반면 저자의 방법은 하나의 latent representation 안에 여러가지의 reasoning state를 동시에 표현할 수 있습니다. 이로 인해 Coconut은 여러 reasoning 후보를 유지한 뒤, reasoning step이 진행되면서 잘못된 후보를 점차 제거하는 BFS-like reasoning behavior를 보입니다.
실험에서는 GSM8K를 통해 continuous thought를 여러 step 연결하는 것이 reasoning 성능 향상에 기여함을 확인하고, ProntoQA와 ProsQA에서는 Coconut과 일부 variant가 language-based CoT보다 높은 성능을 보입니다.
특히 search와 planning이 중요한 문제에서 latent reasoning의 장점이 더 크게 나타났으며, 자연어 reasoning token을 생성하지 않기 때문에 inference efficiency 측면에서도 이점을 보였다고 합니다.
3. Coconut: Chain of Continuous Thought
이제 본격적으로 Coconut의 방법론을 살펴보겠습니다.
기본적인 LLM에서는 입력 token sequence x=(x_1,\dots,x_T)가 embedding으로 변환되고 Transformer를 거쳐 hidden state가 생성됩니다.
각 시점 t에서 마지막 hidden state h_t는 LM head를 거쳐 다음 token distribution으로 변환됩니다.
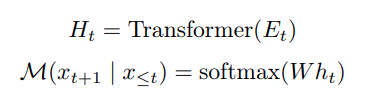
여기서 E_t는 현재까지 입력된 token embedding sequence이고, h_t는 마지막 위치의 hidden state입니다.
일반적인 LLM에서는 이 hidden state를 vocabulary space로 projection해서 다음 token을 생성하고, 다시 token embedding으로 바꿔 다음 입력으로 사용합니다.
Coconut은 이 과정에서 language mode와 latent mode를 분리합니다.
3.1 Language Mode / Latent Mode
Language mode에서는 기존 LLM과 동일하게 다음 token을 autoregressive하게 생성합니다.
반면 latent mode에서는 hidden state를 token으로 decoding하지 않고, 직전 step의 마지막 hidden state를 그대로 다음 input embedding으로 사용합니다.저자들은 이 hidden state를 continuous thought라고 부릅니다.
latent mode의 시작과 끝은 각각 <bot>과 <eot> token으로 표시합니다.
latent mode에서는 기존 token embedding 대신 이전 step에서 나온 hidden state를 차례대로 입력합니다.
E_t = [e(x_1),\dots,e(x_i),h_i,h_{i+1},\dots,h_{t-1}]이후 <eot> 이후에는 다시 일반 token embedding을 사용하면서 language mode로 돌아갑니다.
중요한 점은 latent mode 내부에서는 continuous thought를 language token으로 decoding할 필요가 없다는 것입니다.
즉 latent step에서는
\mathrm{softmax}(Wh_t)를 반드시 계산할 필요가 없고, hidden state 자체가 다음 reasoning step으로 전달됩니다.
다만 분석 목적으로는 LM head를 적용해 각 latent state가 어떤 token distribution과 대응되는지 확인할 수 있습니다.
3.2 Training Procedure
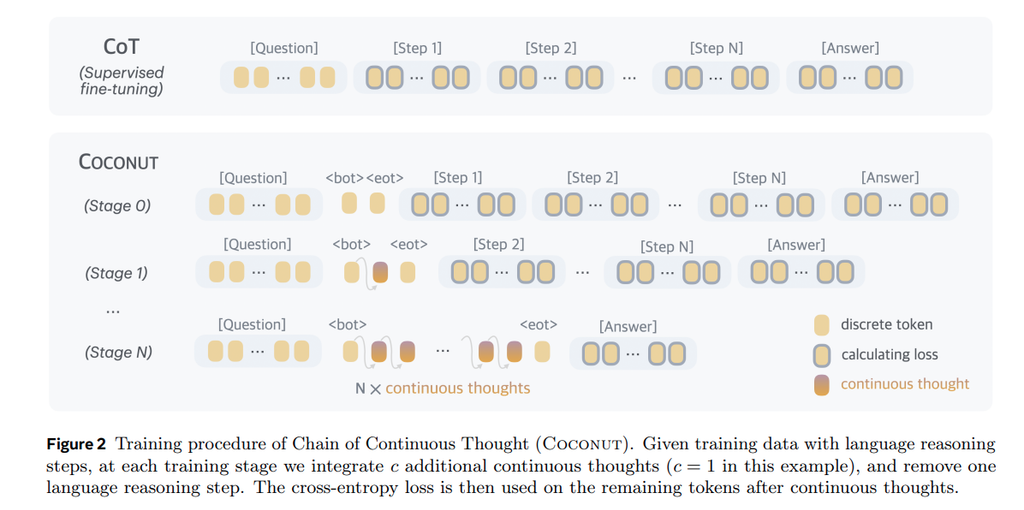
Coconut은 처음부터 latent reasoning을 직접 학습하지 않고, 기존 language CoT를 이용한 multi-stage training curriculum을 사용합니다.
초기 stage에서는 일반적인 CoT 데이터를 그대로 이용해 학습합니다. 이후 stage가 진행될수록 앞쪽의 language reasoning step을 하나씩 제거하고, 그 자리를 continuous thought로 대체합니다.
k번째 stage에서는 처음 k개의 language reasoning step을 제거하고, 대신 k \times c 개의 continuous thought를 사용합니다.
여기서 c는 하나의 language reasoning step을 몇 개의 latent thought로 대체할지를 결정하는 hyperparameter입니다. 예를 들어 c=1이면 reasoning step 하나를 continuous thought 하나로 대체하고, c=2이면 reasoning step 하나를 latent step 두 개로 대체합니다.
즉 학습이 진행될수록
language CoT → 일부 latent + 일부 language → 더 많은 latent → latent reasoning
형태로 점진적으로 전환됩니다.
stage가 바뀔 때마다 optimizer state도 reset한다고 합니다.
3.3 Training Objective
학습에는 일반적인 negative log-likelihood loss를 사용한다고 합니다.
다만 question token과 continuous thought 구간에는 loss를 적용하지 않고, latent reasoning 이후 남아 있는 language reasoning과 answer token에 대해서만 loss를 계산합니다.
여기서 중요한 점은 continuous thought가 제거된 language reasoning step 자체를 복원하도록 학습되는 것이 아니라는 것입니다.
즉 latent state가 기존 CoT 문장을 그대로 압축해서 표현하도록 강제하지는 않는다고 합니다. 대신 latent thought를 거친 이후의 reasoning token과 answer를 잘 예측하도록 학습합니다.
따라서 continuous thought는 human language reasoning을 그대로 encoding하기보다는, 이후 reasoning에 필요한 정보를 자유로운 latent representation으로 학습할 수 있습니다.
3.4 Differentiable Latent Reasoning
Coconut의 continuous thought는 hidden state 자체를 사용하기 때문에 미분이 가능합니다.
따라서 여러 latent reasoning step을 거친 이후의 loss에서 앞쪽 continuous thought까지 gradient를 전달할 수 있고, 전체 reasoning process를 end-to-end로 학습할 수 있습니다.
latent thought가 n개라면 학습 과정에서는 총 n+1번의 forward pass가 필요합니다.
각 forward pass에서 새로운 continuous thought를 하나씩 생성하고, 마지막 forward pass에서 남아 있는 text sequence에 대한 loss를 계산합니다.
KV cache를 이용하면 중복 computation은 줄일 수 있지만, latent thought를 순차적으로 생성해야 하기 때문에 여러 forward pass를 병렬화하기 어렵다는 단점이 있다고 합니다. 저자들도 이 부분을 Coconut의 training efficiency 측면에서 남아 있는 문제로 커버합니다.
3.5 Inference
Inference도 기본적으로 standard autoregressive decoding과 비슷하게 동작합니다.
질문이 입력되면 바로 뒤에 <bot>을 추가하고 latent mode로 전환합니다.
이후 일정한 수의 continuous thought를 생성한 뒤 <eot>을 기준으로 다시 language mode로 전환하고 최종 답을 생성합니다. 문제는 latent reasoning을 언제 끝낼지 결정하는 것입니다.
저자들은 두 가지 방법을 실험합니다.
- latent thought를 입력으로 하는 binary classifier를 학습해 reasoning 종료 시점을 자동으로 결정하는 방법
- latent reasoning step을 항상 고정된 길이로 사용하는 방법
두 방식의 성능이 비슷했기 때문에, 실험에서는 단순하게 고정된 수의 latent thought를 사용하는 방식을 기본 설정으로 사용합니다.
4. Results
4.2 Overall Results
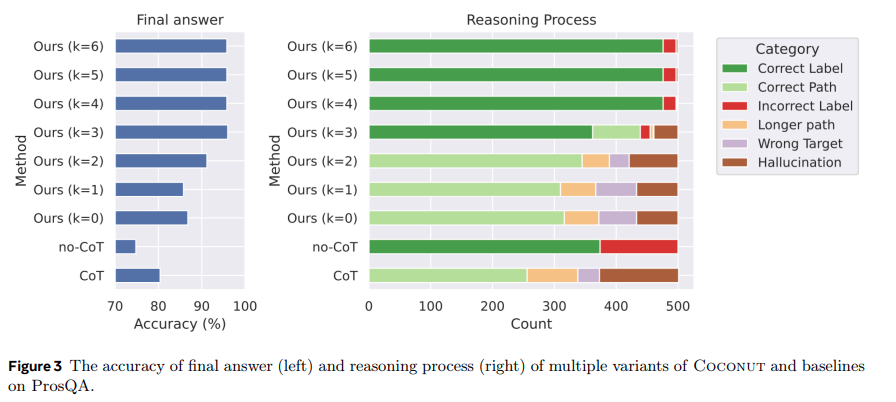
ProsQA에서 Coconut은 CoT보다 높은 reasoning accuracy를 보였으며, continuous thought의 수가 증가할수록 성능이 지속적으로 향상되는것을 보입니다.
CoT는 초반에 잘못된 reasoning path를 선택하면 존재하지 않는 edge를 생성하는 hallucination이나 잘못된 target으로 이어지는 경우가 많았다고 하고, 반면 Coconut은 latent reasoning step이 증가하면서 Correct Label과 Correct Path 비율이 증가하고, Hallucination과 Wrong Target은 감소했습니다.
즉 continuous latent space에서 reasoning하는 것이 초기에 하나의 reasoning path로 바로 결정되는 것을 줄이고, 이후 reasoning 과정에서 잘못된 후보를 수정할 수 있도록 한다는 결과라고 합니다.
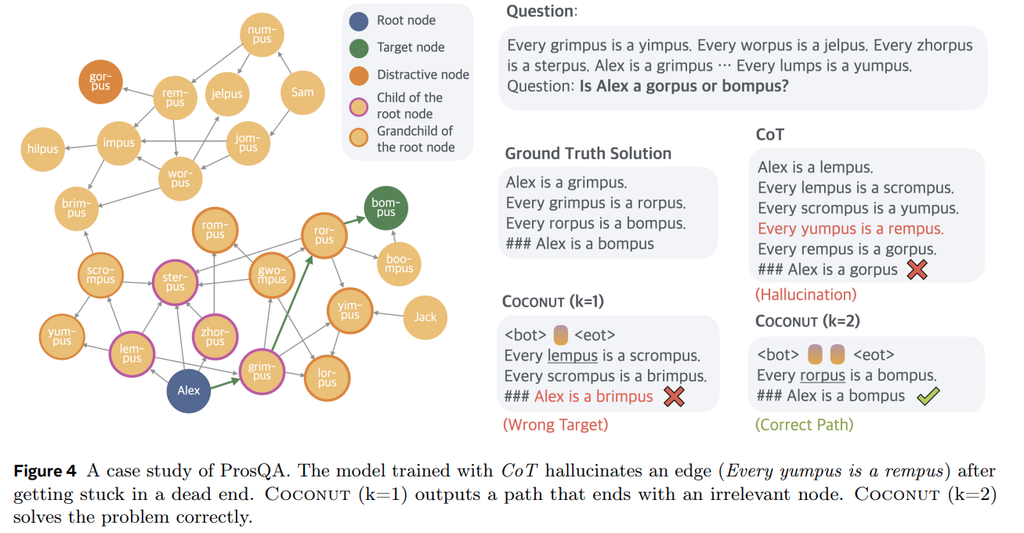
CoT는 잘못된 path에 진입한 이후 없는 edge를 hallucination하면서 실패하고, Coconut도 latent thought가 1개일 때는 잘못된 target으로 이어집니다. 반면 continuous thought를 2개 사용하면 reasoning을 추가로 진행하면서 최종적으로 올바른 path를 찾습니다.
4.3 Latent Reasoning as Tree Search
저자들은 Coconut의 latent reasoning을 분석하기 위해, 각 continuous thought 이후에 모델이 다음 reasoning step을 language로 출력하도록 probing해봅니다.
그 결과 Coconut은 매 reasoning step에서 가장 높은 확률을 가진 하나의 path만 따라가는 greedy search와 다른 동작을 보이는데,
첫 번째 latent step에서는 여러 candidate node에 probability가 분산되어 있고, 이후 latent step에서는 이전에 가장 높은 확률을 가졌던 node가 아니라 다른 branch의 node가 가장 높은 probability를 갖기도 합니다. 저자들은 이를 continuous representation이 여러 reasoning path를 동시에 유지하기 때문에 나타나는 Breadth-First Search(BFS)-like behavior로 해석합니다.
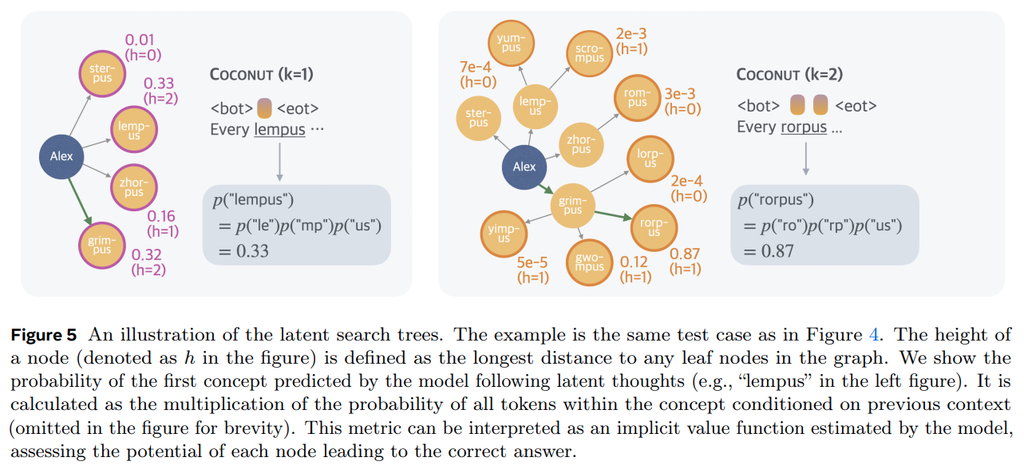
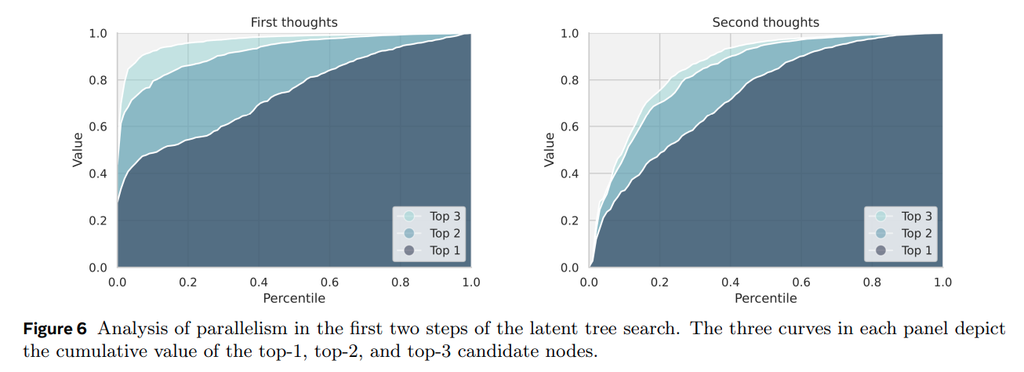
Figure 6에서도 첫 번째 latent thought에서는 top-1, top-2, top-3 candidate 사이의 probability 차이가 비교적 작아 여러 reasoning path를 동시에 탐색하는 모습을 보입니다.
반면 두 번째 latent thought에서는 이 차이가 점차 커지면서 특정 후보로 reasoning이 집중됩니다.
즉 Coconut은 초기에는 여러 path를 넓게 탐색하고, reasoning이 진행되면서 가능성이 낮은 후보를 제거하는 형태를 보입니다.
4.4 Why is Latent Space Better for Planning?
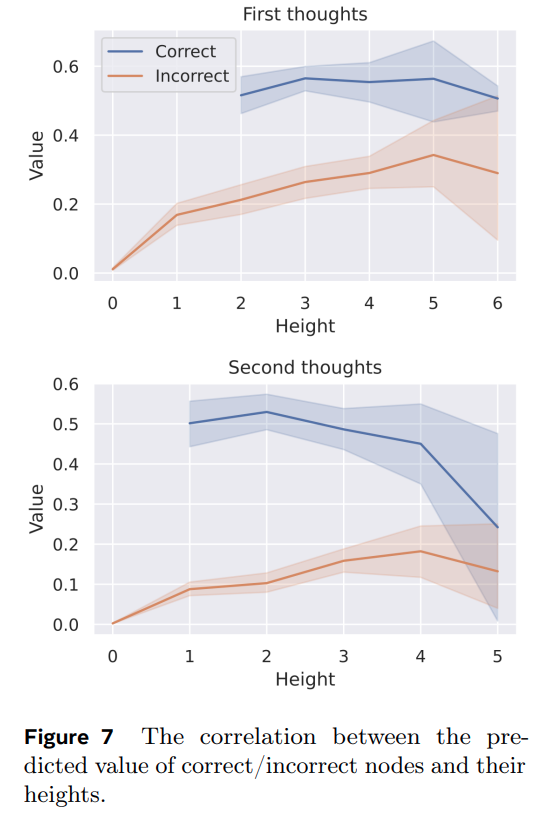
저자들은 이러한 latent reasoning이 planning에 유리한 이유를 decision을 늦출 수 있기 때문이라고 설명합니다. reasoning 초기의 node는 target까지 거리가 멀기 때문에 해당 path가 정답으로 이어질지 정확하게 평가하기 어렵습니다.
반면 reasoning이 진행되어 target에 가까워질수록 가능한 path의 수가 줄어들기 때문에 correct/incorrect path를 더 명확하게 구분할 수 있습니다.
실제로 Figure 7에서 target과 가까운 node일수록 모델이 correct node에는 높은 probability를, incorrect node에는 낮은 probability를 더 명확하게 부여하는 것을 확인할 수 있습니다.
따라서 Coconut은 초기 reasoning 단계에서 하나의 path로 바로 결정하지 않고 여러 후보를 latent representation 안에 유지한 뒤, 더 많은 evidence를 확보하면서 점진적으로 후보를 좁혀갑니다.
이러한 특성 때문에 search와 planning이 중요한 task에서 language-based greedy CoT보다 더 안정적인 reasoning을 수행할 수 있다는 것이 저자의 주장입니다.
5. Empirical Results with Coconut
저자들은 앞서 ProsQA에서 관찰한 BFS-like latent reasoning이 실제로 다양한 reasoning task에서도 효과적인지 확인하기 위해 GSM8K, ProntoQA, ProsQA에서 실험을 진행합니다.
GSM8K는 수학 reasoning, ProntoQA와 ProsQA는 logical reasoning task이며, ProsQA는 distracting branch가 더 많아 planning 난이도가 높은 데이터셋입니다.
비교 방법으로는 일반적인 CoT, reasoning chain 없이 바로 답을 생성하는 No-CoT, CoT를 점진적으로 제거해 reasoning을 내부화하는 iCoT, 그리고 추가 computation을 위해 <pause> token을 삽입하는 Pause Token을 사용합니다.
5.1 Overall Results
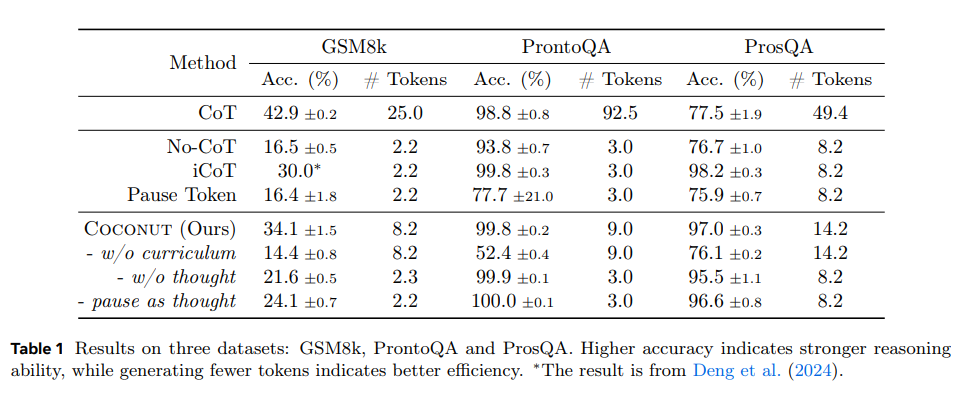
Coconut은 모든 task에서 No-CoT보다 높은 성능을 보이며, continuous thought 자체가 reasoning 성능 향상에 효과가 있음을 보여줍니다.
특히 logical reasoning에서는 성능이 장점인데, ProntoQA에서는 Coconut이 99.8%로 CoT의 98.8%를 넘었고, ProsQA에서는 97.0%로 CoT의 77.5%보다 크게 높은 성능을 보였습니다.
동시에 생성 token 수도 CoT보다 크게 줄었습니다.
반면 GSM8K에서는 Coconut이 34.1%로 CoT의 42.9%보다는 낮았지만, No-CoT의 16.5%나 iCoT의 30.0%보다는 높은 성능을 보였습니다. 특정 Task 별로 성능개선의 폭이 CoT와 다르다고 생각할 수 있겠네요.
즉 Coconut은 특히 search와 planning이 중요한 logical reasoning task에서 강한 성능을 보이고, math reasoning에서는 accuracy와 token efficiency 사이의 trade-off를 개선하는 형태를 보입니다.
5.2 More Continuous Thoughts Improve Reasoning
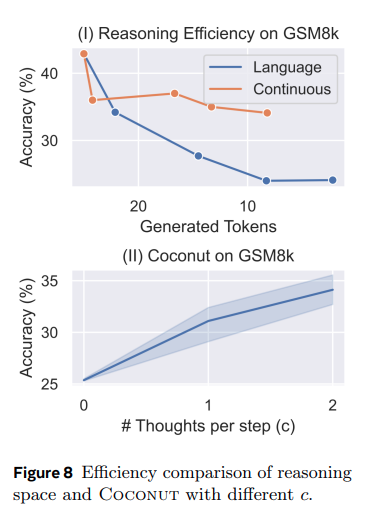
저자들은 하나의 language reasoning step을 몇 개의 continuous thought로 대체할지를 결정하는 hyperparameter c도 분석합니다.
c를 0에서 1, 2로 증가시키면서 GSM8K 성능이 지속적으로 향상되었습니다.
즉 language CoT에서 reasoning token을 더 많이 생성하면 effective computation depth가 증가하는 것처럼, Coconut에서도 continuous thought를 더 많이 연결하는 것이 reasoning capability를 증가시킬 수 있다는 결과입니다.
5.3 Continuous Thought is Efficient
Coconut의 또 다른 장점은 reasoning을 더 적은 token으로 수행할 수 있다는 점입니다.
ProntoQA와 ProsQA에서는 CoT보다 적은 token을 생성하면서 더 높은 accuracy를 달성했고, GSM8K에서도 language reasoning step을 단순히 제거하는 방식보다 continuous thought로 대체했을 때 accuracy 감소가 훨씬 작았습니다.
즉 reasoning 과정을 그냥 생략하는 것이 아니라, language reasoning step을 continuous representation으로 대체함으로써 reasoning information을 더 압축된 형태로 유지할 수 있음을 보여줍니다.
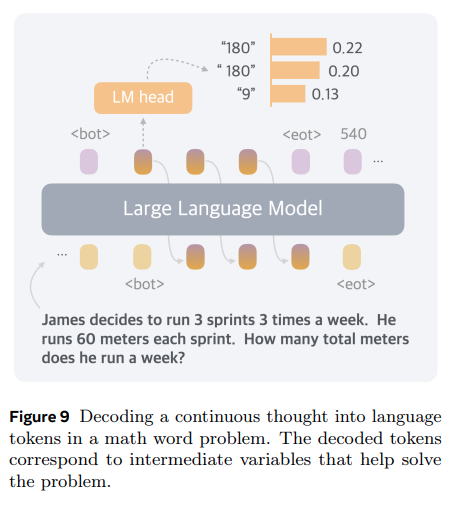
Figure 9에서는 continuous thought를 다시 language token으로 probing했을 때, 수학 문제를 해결하는 데 필요한 intermediate variable과 관련된 token이 나타나는 것도 확인할 수 있습니다.
5.4 Multi-stage Curriculum is Important
Ablation에서 가장 중요한 결과는 multi-stage training curriculum이 필수적이라는 점입니다.
처음부터 전체 reasoning을 continuous thought로 수행하도록 학습한 w/o curriculum은 GSM8K 14.4%, ProntoQA 52.4%로 크게 성능이 떨어졌습니다.
반면 language CoT를 점진적으로 continuous thought로 대체하는 Coconut은 각각 34.1%, 99.8%까지 성능이 올라갑니다.
즉 continuous latent space 자체가 있다고 해서 모델이 자동으로 효과적인 reasoning representation을 학습하는 것은 아니며, 기존 language reasoning chain을 이용해 latent reasoning으로 점진적으로 전환시키는 supervision이 중요하다는 결과입니다. 후속연구들도 이런식으로 했는지는 아직 서베이하지 못했지만, 극복한 사례가 있을 법 해서 찾아봐야겠네요.
Conclusion
본 논문에서는 continuous latent space에서 reasoning을 수행하는 새로운 paradigm인 Coconut을 제안했습니다.
Coconut은 LLM의 hidden state를 continuous thought로 사용하고, 이를 다음 reasoning step의 input으로 직접 전달함으로써 language token을 거치지 않고 latent space에서 reasoning을 수행합니다.
다만 현재 방식은 language CoT supervision과 multi-stage curriculum에 크게 의존하고 있기 때문에, 향후에는 latent reasoning을 pretraining 단계까지 확장하고 보다 일반적인 task에서도 안정적으로 학습할 수 있는 방법이 필요할 것 같네요.
감사합니다.


좋은 리뷰 감사합니다
본 연구는 latent space 에서의 표현 전달을 수행했다고 하는데, language space에 제한을 개선하여 이득을 보았다고 해주셨습니다. language space에서는 이미지 등을 디코딩하는데에서 관심영역이 아닌 부분의 정보를 삭제할 수 있기에 발생하는 차이라고 이해했는데요, 다만 각 에이전트가 테스크의 난이도에 비해 성능이 낮을경우 language space에서의 처리보다 노이즈나 잘못된 추론/임베딩이 잦을 것 같습니다.
이러한 통제할 수 없는 상황에 대해 latent space 상의 정보활용 방법이 궁금합니다.
안녕하세요 인택님. 좋은 리뷰 감사합니다.
CoT나 Latent Reasoning에 대해 굉장히 간단히 컨셉정고만 알고 있었는데, 덕분에 어느정도 흐름이 이해가 되는 것 같습니다.
질문이 있어 댓글로 남기겠습니다!
1. Language token을 생성하는 것이 decoding과정에서 token selecting을 수행하고 하나의 문장을 생성하는 것이고 이게 기존 CoT가 reasoning과정에서 하나의 path를 정한다는 말로 이해했습니다. 따라서 latent reasoning이 잠재적 경로들을 모두 함축 하고 있다고 이해하면 될까요?
2. 이어서, continuous thought 을 두개 사용했다는 것이 latent reasoning을 두번 진행했다는 것인지, hidden state를 명시적으로 두개를 사용한 것인지 궁금합니다.
3. 해당 논문에서는 Reasoning Step을 고정된 상수로 지정한 것인지, 모델이 임의로 충분하다고 판단되면 Reasoning을 마치는 것인지 궁금합니다.
4. Question token과 Continuous thought 구간에는 Loss를 적용하지 않는다면, 어떻게 reasoning을 위한 planning이 가능하도록 학습되는 것인지 명쾌히 이해가 되지 않습니다. 초기 학습 단계에 Language Reasoning을 기반으로 학습하다가 점차 Latent Reasoning 비율을 늘려주는 것이, planning을 위한 가이드를 위한 것이라고 이해해도 괜찮을까요?
감사합니다.
안녕하세요 인택님
리뷰 감사합니다. LLM 의 thinking과정을 ㅣatent에서 수행한다는게 흥미로운데 따로 CoT처럼 학습은 하지않고 latent 에서 그냥 다음스텝하고 그런건가요 ? 블랙박스같은 ㅣatent space에서 어떤식으로 분석을하고 증명을 하는지 궁금합니다.
감사합니다