안녕하세요. 이번에는 SEASON: Mitigating Temporal Hallucination in Video Large Language Models via Self-Diagnostic Contrastive Decoding 논문을 읽어보았습니다. NTU와 NVIDIA 쪽에서 2025년 12월에 올라온 논문인데요. VCD에서 시작해서 MACD까지 대조 디코딩(CD) 계열을 따라 읽어오다 보니, 어떻게 더 negative를 더 잘 만들어볼까를 고민하다가 읽어본 논문이었습니다. 그럼 리뷰 시작하겠습니다.
1. Introduction
본 논문의 시작은 이렇습니다. LLM의 환각 연구는 지금까지 대부분 이미지 쪽에 집중되어 있었다는 건데요. 존재하지 않는 물체를 말하거나 속성을 틀리는 식이고, 본 논문은 이를 spatial hallucination이라고 부릅니다.
문제는 이걸 비디오로 그대로 가져오면 부족하다는 것입니다. 비디오에는 시간 구조가 있는데, 공간적 환각을 줄여도 모델이 사건의 인과나 순서를 잘못 이해해서 시각 내용과 시간적으로 모순되는 서술을 계속 내놓는다는 거죠. 이게 temporal hallucination이고, 본 논문에서 해결하고자 하는 문제라고 할 수 있습니다.
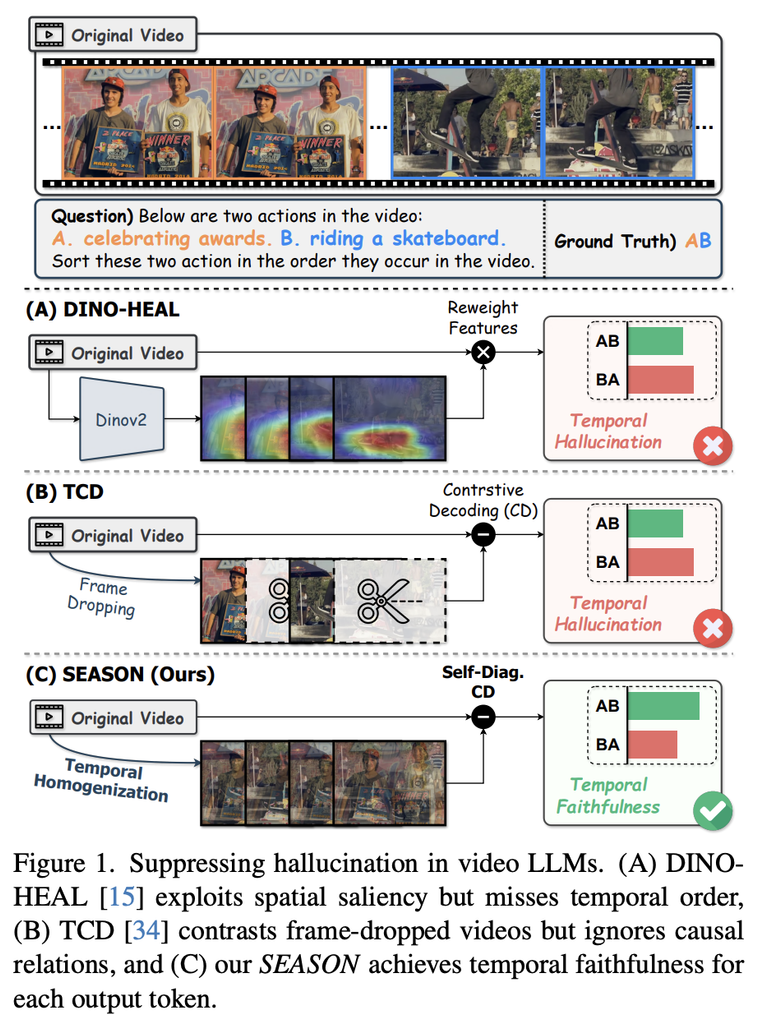
Figure 1이 기존 training-free 방법들의 한계를 정리한 그림인데요. (A) DINO-HEAL은 DINOv2의 saliency map으로 시각 feature를 재가중합니다. 한 프레임 안에서 어디가 중요한지는 짚어내지만, temporal하게 보지 못한다고 합니다. (B) TCD는 프레임을 drop한 비디오와 대조하는데 시간적 인과 관계는 다루지 못합니다. 마지막으로 (C)가 본 논문에서 제안한 SEASON이라고 보시면 되겠습니다.
위의 training-free의 대안 방법으로 training-based 방법들은 성능은 나오지만 재학습 비용과 고품질 preference 데이터가 필요하다는 점에서 확장성이 떨어집니다. 그래서 추론 시점에 어떤 모델에나 붙일 수 있는 training-free 쪽이 좀더 매력적으로 느껴지는데, 앞서 본 것처럼 기존 training-free는 시간 인과를 못 잡는다는 게 논문의 출발점입니다.
Contribution을 정리하면 다음과 같습니다.
- 출력 토큰마다 시간적,공간적 충실성을 적응적으로 강화하는 training-free 프레임워크 SEASON 제안.
- 허위 시간 상관을 증폭시키는 temporally-homogenized video를 negative로 도입해, 시간 환각에 초점이 맞춰진 분포를 CD에 적용.
- frame-attention divergence로 토큰 단위 환각 경향을 추정하고 그에 맞는 대조 페널티를 배분하는 hallucination diagnostician 설계.
2. Method
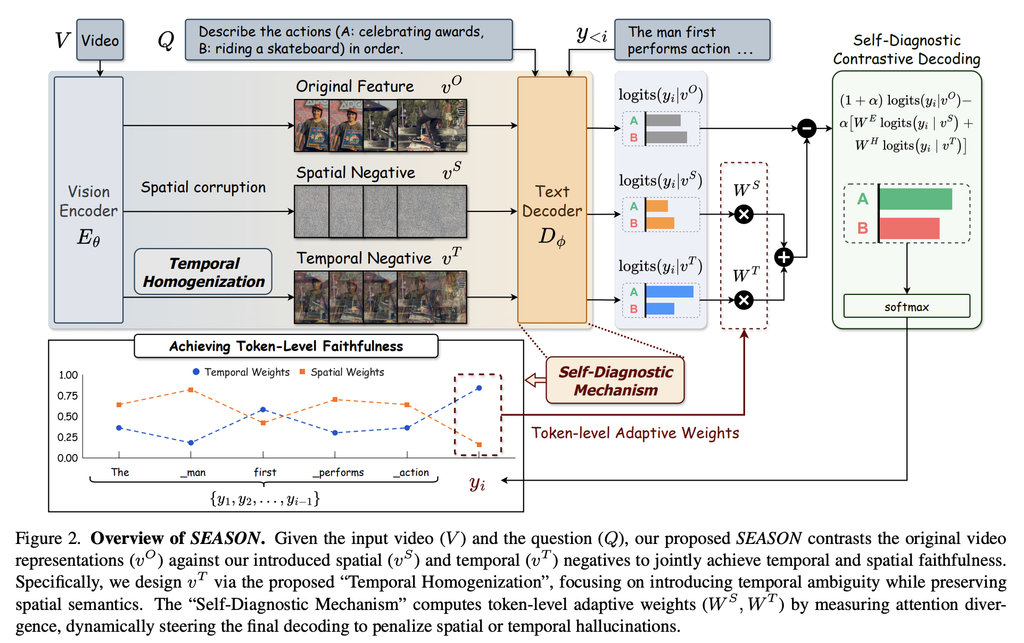
Figure 2가 전체 파이프라인입니다. 본 방법론을 정리하면 다음과 같은데요. input video V와 query Q가 주어지면 원본 representation $v^O$를 공간 negative $v^S$, 시간 negative $v^T$와 대조하는데요. $v^T$는 Temporal Homogenization으로 만들고, Self-Diagnostic Mechanism이 attention divergence를 재서 토큰 단위 가중치 $W^S$, $W^T$를 내놓아 최종 디코딩 방향을 조종합니다.
2.1 Problem Formulation
input video $V = \{f_1, f_2, \dots, f_{|V|}\}$와 텍스트 query Q에 대해, 비전 인코더 $E_\theta$와 텍스트 디코더 $D_\phi$로 구성된 VideoLLM이 response $y = \{y_1, \dots, y_N\}$을 생성합니다.
저자들은 두 종류의 환각을 이렇게 구분합니다.
- Spatial hallucination: y에 서술된 물체나 속성이 개별 프레임 $f_i$ 안에 시각적으로 존재하지 않는 경우
- Temporal hallucination: y의 서술이 비디오 V의 실제 시간 구조(사건 순서, 인과)와 모순되는 경우
2.2 Mitigating Temporal Hallucination via Temporal Homogenization
여기가 첫 번째 핵심입니다. 저자들이 가장 먼저 지적하는 점은 VCD처럼 프레임에 가우시안 노이즈를 더하면 공간과 시간이 한꺼번에 망가진다는 것인데요. 이러면 모델은 공간이 이상하다만 보고도 그 negative를 걷어내버리고, 정작 겨냥한 시간 불일치는 대조에 거의 반영되지 않습니다. 저자들은 이걸 temporally-easy negative라고 부릅니다.
그래서 필요한 건 공간 충실도는 최대한 보존하면서 시간 구조만 무너뜨린 temporally-hard negative라는 거죠. 이를 위해 프레임 feature를 layer 단위로 temporal 축으로 평균 내고, 그 전역 맥락을 각 프레임 representation에 다시 주입합니다.
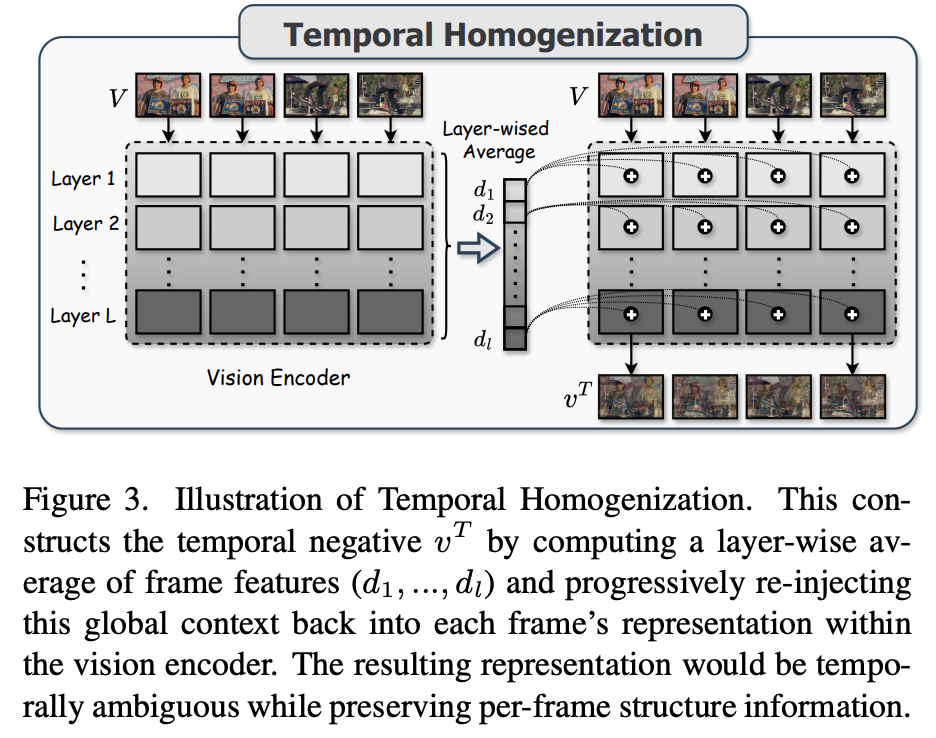
Figure 3이 그 과정인데요. temporal negative는 비전 인코더의 최종 layer 출력들로 정의됩니다.
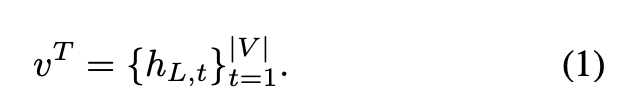
그리고 각 $h_{l,t}$는 layer마다 두 값을 섞어서 만듭니다. 하나는 그 프레임이 인코더 layer를 통과한 출력이고, 다른 하나는 같은 layer에서 구한 프레임 평균입니다. 이 둘을 $\beta$ 비율로 보간한 것이 homogenization입니다.
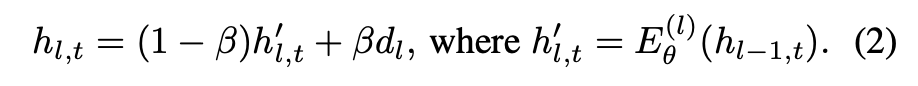
여기서 $d_l = \frac{1}{|V|}\sum_{t=1}^{|V|} h’_{l,t}$로, 원본 V를 forward pass로 한 번 통과시켜 미리 구해둔 l번째 layer의 프레임 feature 평균입니다. $\beta \in [0,1]$이 homogenization 정도를 조절하고, $h_{0,t}$는 프레임 f_t의 patch embedding입니다.
식 자체는 단순한 선형 보간인데, 개인적으로 이 설계에서 재밌게 본 부분은 $h_{l-1,t}$가 이미 이전 layer들에서 전역 맥락과 섞인 값이라는 점입니다. 그래서 layer를 타고 올라갈수록 프레임 간 차이가 누적적으로 지워지는데, 프레임 내부의 공간 구조는 각자 인코더를 통과하니까 남아 있습니다. 프레임들이 서로 구별되지 않는 비디오를 만드는 셈이죠.
이렇게 얻은 $v^T$로 대조하면 temporal CD 분포가 나옵니다.
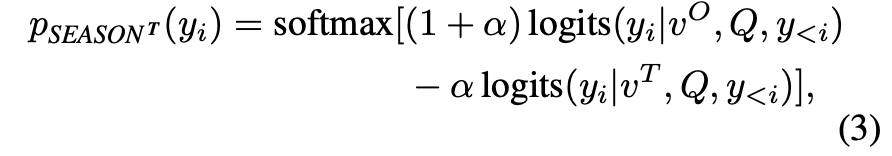
$\alpha$가 대조 강도이고 $\alpha = 0$으로 두면 일반 디코딩이라고 보시면 되겠습니다.
2.3 Achieving Token-Level Faithfulness via Self-Diagnostic Contrastive Decoding
두 번째 핵심입니다. 공간 환각까지 같이 잡으려면 negative가 두 개가 되는데, 그럼 매 토큰마다 어느 쪽으로 얼마나 페널티를 줄지가 문제가 됩니다. 참고로 여기서 쓰는 negative $v^S$는 원본 representation $v^O$에 가우시안 노이즈를 더한 것으로, 앞서 temporally-easy라고 말했던 그 방식입니다.
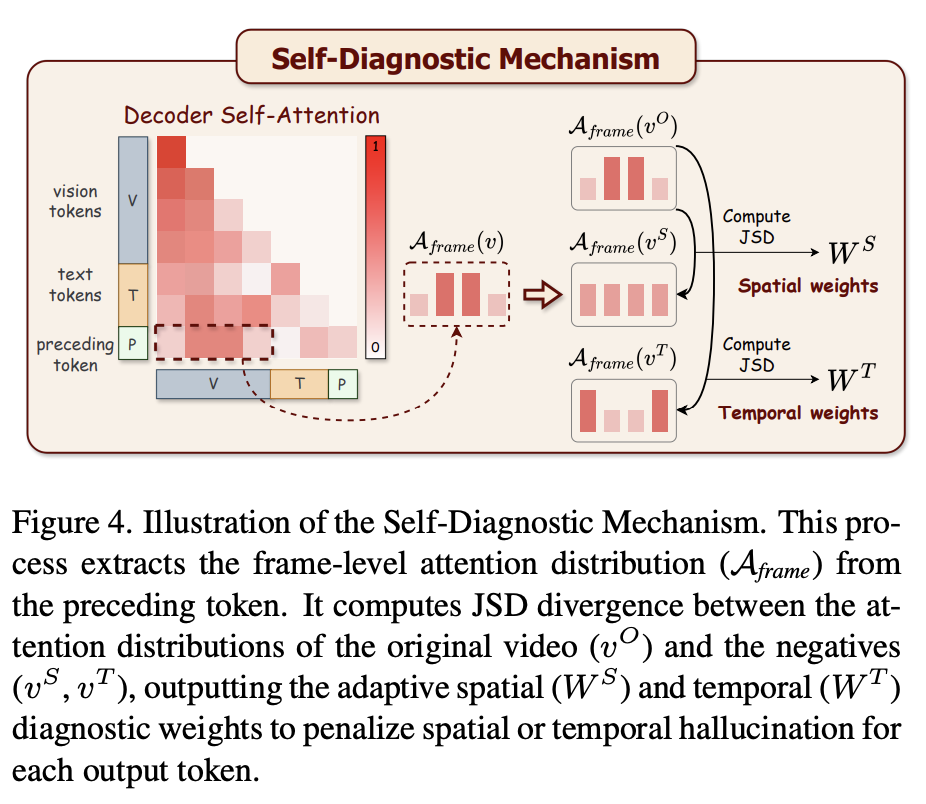
Figure 4가 진단 메커니즘인데요. 저자들이 주목한 건 토큰 생성이 앞서 나온 토큰들에 크게 의존한다는 사실입니다. 그래서 아직 만들지 않은 $y_i$ 대신 직전 토큰 $y_{i-1}$ 을 봅니다. $y_{i-1}$이 각 비디오 representation을 어떻게 보고 있는지가 곧 지금 만들 토큰이 무엇에 기대는지의 단서라는 거죠.
이를 정량화하기 위해 frame 단위로 attention 분포를 뽑습니다.
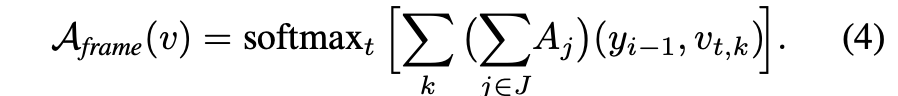
선택한 layer 집합 J의 attention을 더하고, 프레임 t 내부의 visual token k에 대해 합산한 뒤, 프레임 축으로 softmax를 취하는 구조입니다. 그리고 JSD로 이동량을 재서 가중치를 만듭니다.
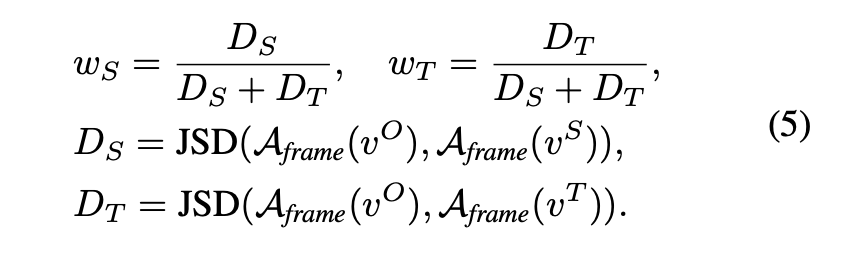
$D_T$가 크다는 건 그 토큰이 시간 단서에 민감하다는 뜻이고, 따라서 시간 negative 쪽으로 페널티를 더 주게 됩니다. 최종 디코딩은 이렇습니다.
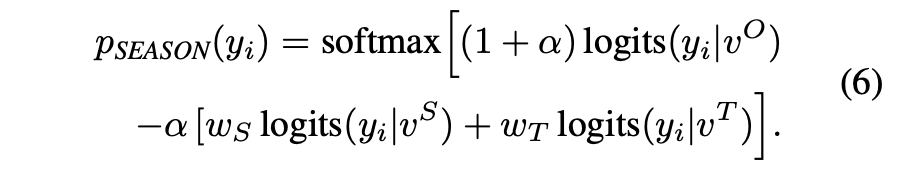
정리하면 negative 두 개를 고정 비율로 섞는 게 아니라, 토큰마다 비율을 다시 계산하는 일종의 라우팅입니다. 그리고 그 라우팅 신호를 외부 모델이 아니라 모델 자신의 attention에서 뽑는다는 점에서 self-diagnostic이라는 이름이 붙은 것이죠.
3. Experiments
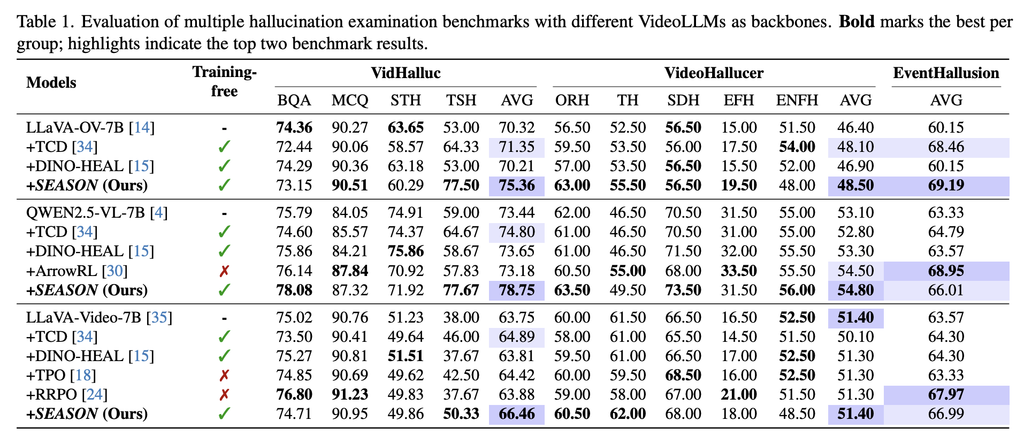
Table 1이 메인 결과입니다. 저자들의 주장은 세 백본 모두에서 training-free 중 최고이고, training-based와도 경쟁하거나 앞선다는 것인데, 성능을 보면 각 벤치마크의 AVG를 봤을 때 앞서는 모습을 볼 수 있습니다.
가장 눈에 띄게 보이는 것은 VidHalluc의 TSH subtask인데요. 시간에 초점을 둔 subtask로 베이스라인인 LLaVA-OV-7B에서 70점이던 성능이 77까지 항상되는 것을 볼 수 있습니다. 이것 외에도 성능이 많이 오른 것을 볼 수 있습니다.
대부분 성능이 올랐지만, 성능이 떨어지는 곳도 있는데요.
첫째로 VidHalluc에서 STH가 일관되게 떨어집니다. LLaVA-OV-7B에서 63.65에서 60.29으로 떨어지는 것을 볼 수 있는데, STH가 description score를 포함하는 subtask라는 점을 생각하면, 시간 negative를 강하게 대조하는 과정에서 서술 자체가 보수적으로 변하면서 손해를 보는 게 아닌가 싶습니다. 아쉬운 점은 이 점에 대해서 저자들이 따로 언급하지는 않는다는 것… 입니다.
이것 외에도, EventHallusion에서는 training-based에 밀리는 모습을 볼 수 있어서 VidHalluc에서 보여준 성능 향상이 모든 환각 벤치마크로 일반화되지는 않는다고 말할 수 있을 것 같습니다.
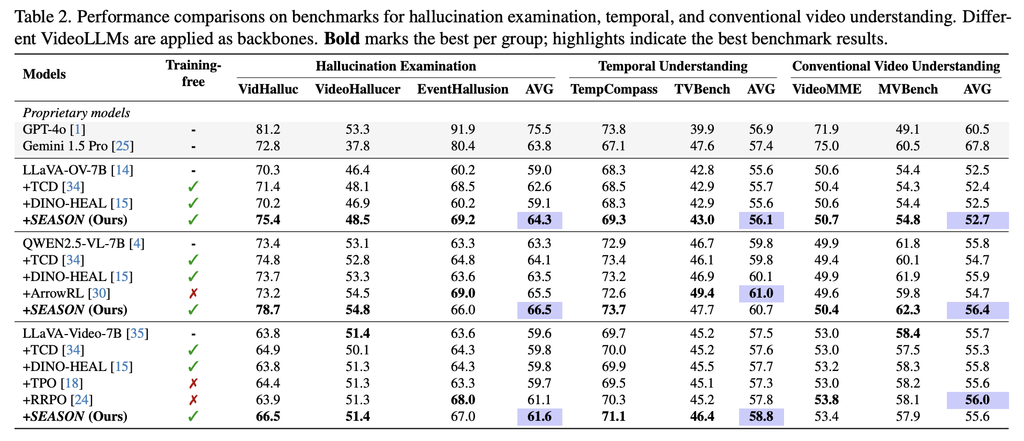
Table 2는 일반 video understanding이 손상되지는 않았는가를 본 것인데요. temporal understaning을 보는 벤치마크들에서는 성능이 오르고, conventional video understanding에서는 성능이 유지되는 수준입니다. 이를 통해서 환각을 제거하기 위해서 맞는 토큰까지 과하게 억제하지 않았다고 볼 수 있을 것 같습니다.
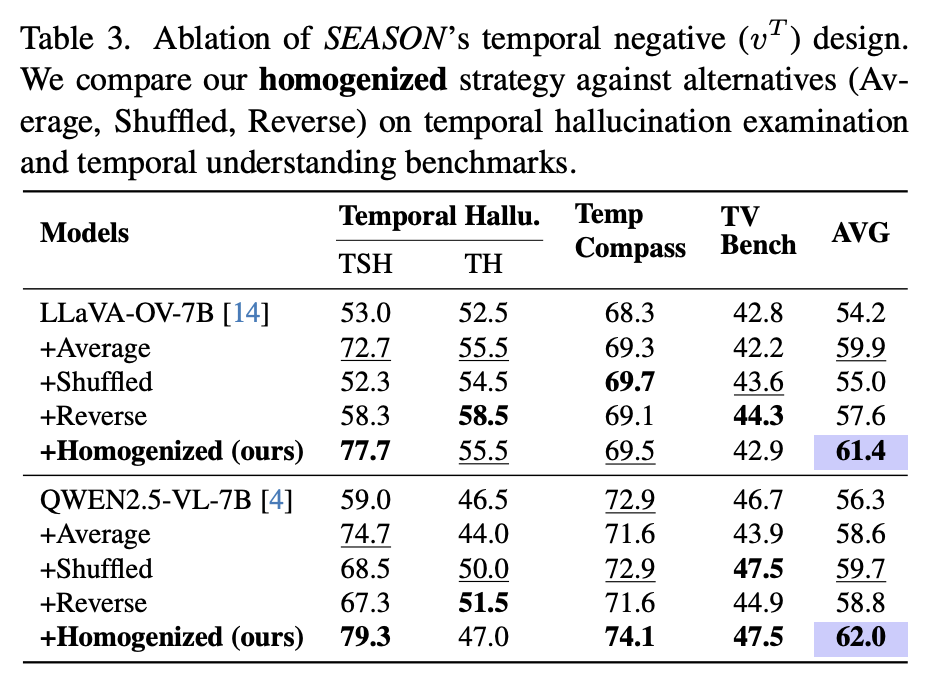
Table 3이 본 논문에서의 ablation입니다. 시간 negative를 어떻게 만들 것인지를 Average, Shuffled, Reverse와 비교한 것인데요. Homogenized가 두 백본 모두에서 평균 최고입니다
프레임을 섞거나 뒤집는 건 여전히 유효한 시간 구조를 가진 다른 비디오라서 대조 신호가 약하고, homogenized는 시간 구조 자체를 없애버리니까 대조가 선명해진다고 해석할 수 있을 것 같습니다.
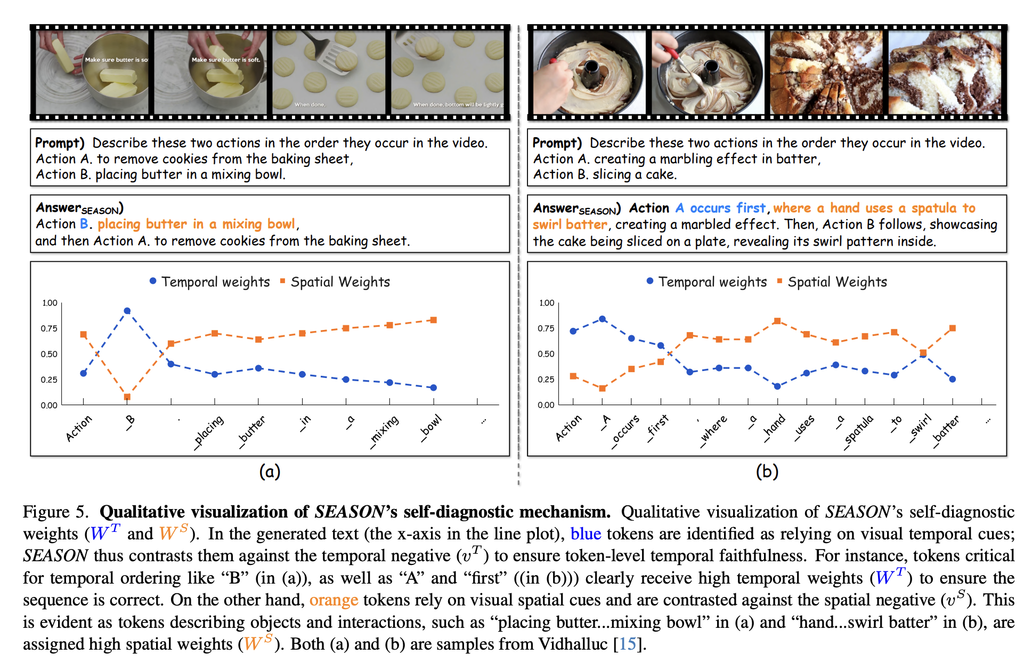
Figure 5가 diagnostic weight를 토큰별로 시각화한 것인데요. 모델이 “A occurs first” 같은 시간 관련 표현을 생성할 때 시간 가중치 $w_T$(파란색)가 높게 잡히는 걸 볼 수 있습니다. 진단 메커니즘이 의도대로 동작한다는 걸 직관적으로 보여주는 그림이라고 볼 수 있습니다.
지금까지 SEASON 논문 리뷰를 마쳐봤습니다. VCD에서 MACD로 이어지던 흐름이 negative를 더 잘 만들자였다면, 이 논문은 거기에 negative를 여러 개 두고 토큰마다 골라 쓰자를 말한 논문이라고 볼 수 있겠습니다. 지금까지 읽어주셔서 감사합니다.


