안녕하세요. 이번에 리뷰로 가져온 논문은 ABot-N0: Technical Report on the VLA Foundation Model for Versatile Embodied Navigation입니다.
일단 이 논문이 해결하려는 문제를 간단하게 말하면, 지금까지 Point-Goal, Object-Goal, Instruction-Goal, Person-Following처럼 서로 다른 문제로 따로 연구해왔던 내비게이션 태스크들을 하나의 VLA 모델로 전부 수행해보자는 연구라고 보시면 좋을 것 같습니다. 예를 들어 좌표 기반으로 찾아가게끔 하거나, 소파를 찾아가라고 하거나 복도를 지나서 오른쪽 방으로 들어가라 혹은 특정 사람을 계속 따라가라고 할 수도 있습니다. 기존에는 이런 문제마다 사용하는 데이터나 모델 구조가 꽤 달랐는데, ABot-N0는 이걸 하나의 모델과 공통된 latent representation으로 처리합니다. 논문에서는 이걸 Grand Unification이라고 표현하고 실제로 이 Point-Goal, Object-Goal, Instruction-Following, POI-Goal, Person-Following의 5개 태스크를 하나의 모델에서 다룹니다.
그리고 이걸 학습하려면 각각 태스크를 위한 데이터도 필요한데 저자들은 7802개의 3D 씬에서 약 16.9M 개의 trajectory 샘플 그리고 별도로 5M 개의 reasoning 샘플을 구축해서 학습합니다. 그리고 최종적으로는 ABot-N0를 별도의 저자들이 따로 설계한 시스템인 Agentic Planner, Map-as-Memory, local controller와 연결해서 실제 Unitree Go2에도 배포합니다.
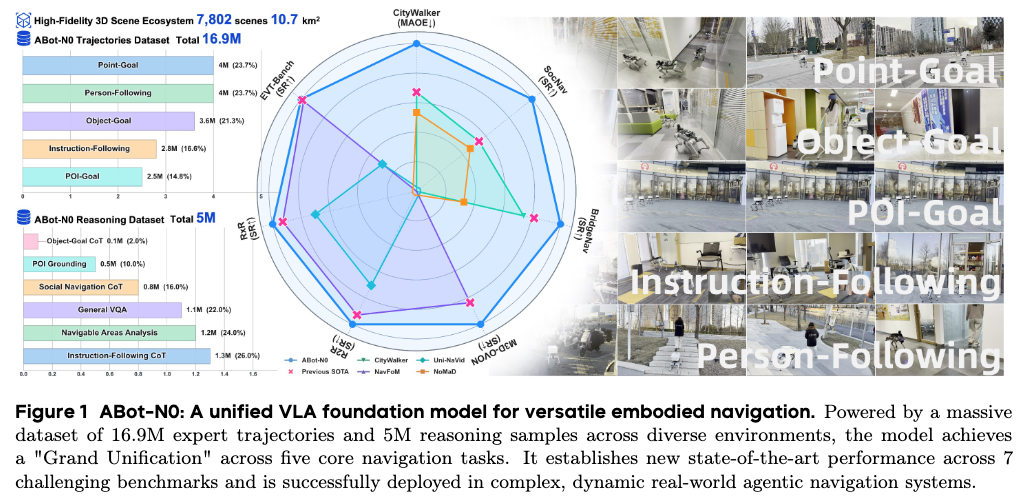
위 그림은 ABot-N0가 다루는 5개 내비게이션 태스크와 데이터 규모, 전체적인 성능을 한 번에 보여주는 그림이라고 보시면 좋을 것 같습니다.
Introduction
내비게이션 연구를 보다 보면 PointNav, ObjectNav, Instruction Goal Nav 등 뭔가 서로 굉장히 다른 분야처럼 나뉘어 있는 경우가 많습니다.
Point-Goal에서는 보통 로봇 기준으로 전환된 목표 상대 좌표가 들어오고, Object-Goal에서는 chair 같은 semantic goal이 들어옵니다. instruction Nav같은 경우에는 목적지 까지 가기위한 좀 상세한 자연어 instruction이 들어오고, 사람을 따라가는 문제에서는 현재 영상에서 특정 사람을 계속 트래킹해야 합니다.
결국 모두 현재 주변을 보고 어디로 이동할지를 결정하는 문제인데도 입력 goal의 형태도 다르고, 사용하는 데이터셋도 다르고, 학습 방법도 조금씩 다르게 접근되어왔습니다.
저자들은 이런 구조에서는 각각의 태스크에서 학습한 이런 모델들이 당연히 다른 태스크에 활용하기 어렵다고 지적합니다. 그래서 ABot-N0에서는 goal이 어떤 형태로 주어지더라도 이를 하나의 latent space로 바꾸고, 최종적으로는 모두 동일하게 로봇이 앞으로 이동해야 할 trajectory를 생성하도록 만듭니다.
논문에서 다루는 태스크를 간단하게 아래처럼 이해하시면 좋을 것 같습니다.
Point-Goal –입력–> 상대 좌표 (x, y)–액션–> 주어진 좌표까지 이동
Object-Goal –입력–> Object Category / Text –액션–> 환경을 탐색하여 목표 물체를 찾아 접근
Instruction-Following –입력–> 자연어 Instruction –액션–> 언어로 설명된 경로를 따라 이동
POI-Goal –입력–> POI 이름 —액션–> 상점이나 건물의 실제 입구까지 이동
Person-Following –입력–> 사람에 대한 Description–액션–> 목표 사람을 구분하고 지속적으로 추종
근데 이제 여기서 POI(Point of Interest)-Goal 같은 경우는 살짝 처음 보는느낌이실 수 있는데 이거는 해당 논문을 작성한 랩에서 새롭게 제안한 태스크인데 이전에 제가 리뷰했던(https://server.rcv.sejong.ac.kr/2026/03/30/arxiv-2026bridging-the-indoor-outdoor-gap-vision-centric-instruction-guided-embodied-navigation/) 여기서 새롭게 제안한 태스크입니다. 대충보면 obect nav랑 헷갈리실 수 있는데 해당 태스크는 단순히 간판이나 건물을 보는 게 아니라 해당 정보를 토대로 실제로 그 POI의 입구까지 정확하게 들어가는 last meter 내비게이션 문제라고 보시면 좋을 것 같습니다.
이제 저자들이 어떻게 데이터셋을 구축하고 어떤식으로 학습을 진행했는지 설명드리도록 하겠습니다.
Method
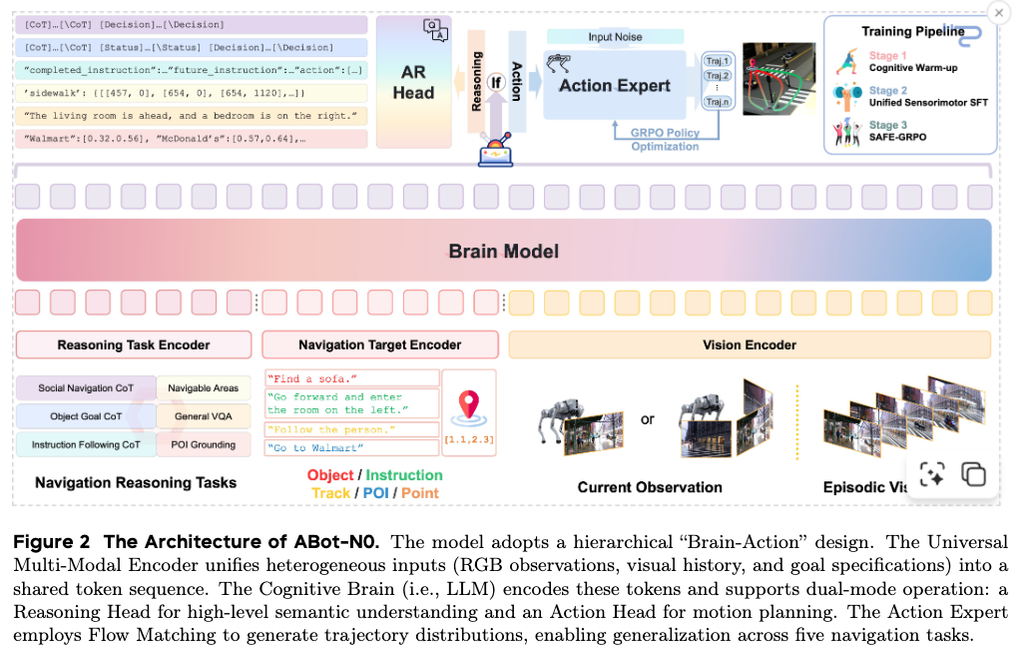
위가 ABot-N0의 전체 구조입니다. 크게 보면 구조는 생각보다 단순하고, 저자들은 이를 Brain-Action 아키텍쳐라고 부릅니다.
먼저 이미지와 goal을 입력받아서 하나의 토큰 시퀀스로 만드는 Universal Multi-Modal Encoder(Navigatio Target Encoder)가 있고, 이 정보를 바탕으로 환경과 목표를 이해하는 Cognitive Brain(Brain Model), 그리고 실제 로봇이 이동할 traj를 생성하는 Action Expert가 있습니다. Cognitive Brain은 Qwen3-4B를 기반으로 하고, Action Expert는 Flow Matching을 이용해서 미래 traj를 생성합니다.
Universal Multi-Modal Encoder
ABot-N0는 로봇마다 카메라 구성이 다를 수 있다는 것을 고려해서 single front observation만 사용할 수 있고, left/front/right의 3개 카메라를 이용한 panoramic observation도 받을 수 있도록 구성되어 있습니다. 그리고 현재 프레임만 보는 게 아니라 과거 프레임들도 같이 입력합니다.
Object-Goal, Instruction, POI-Goal, Person-Following은 결국 모두 텍스트로 표현되는 goal 이기 때문에 그냥 LLM tokenizer를 이용해서 text 토큰으로 넣습니다.
근데 Point-Goal은 (x, y)라는 수치적인 좌표가 들어오기 때문에 같은 텍스트로 처리하긴 좀 애매합니다. 그래서 해당 좌표만을 따로 인코딩할 수 있는 별도 인코더를 설계해서 LLM의 임베딩 차원과 동일한 토큰으로 바꿔줍니다.즉, goal이 문장이든 좌표든 최종적으로 Brain 입장에서는 그냥 동일 공간위에서 표현된 토큰 시퀀스가 되는 구조로 만들게끔합니다.
Cognitive Brain
llm은 Qwen3-4B를 사용합니다. 그리고 여기서 헷갈리실 수 있는 부분이 로봇이 매 스텝마다 긴 Chain-of-Thought를 생성한 다음 순차적으로 행동하는 구조는 아닙니다.
논문에서는 Reasoning 헤드와 Action 헤드를 태스크에 따라 선택되는 별도의 브랜치로 구성합니다. 즉 reasoning을 위한 태스크가 들어오면 reasoning 결과만을 출력하고, 실제 내비게이션 태스크에서는 Brain의 latent representation을 Action Expert로 전달해서 곧바로 traj를 생성하는 식으로 동작합니다.
그래서 결국 Reasoning 학습의 목적은 추론 시 매번 긴 CoT를 생성하게 만드는 것이라기보다는, Brain이 주행가능 영역, object나 공간 관계정보, 사회적 규범 같은 정보를 이해할 수 있는 그런 사전 prior를 미리 학습하게 하는 것에 가깝다고 이해하시면 좋을 것 같습니다.
Action Expert
그리고 실제 로봇의 움직임을 만드는 부분이 Action Expert입니다. ABot-N0는 매번 미래의 5개 waypoint를 예측합니다. 각 waypoint는 단순한 (x, y) 위치만 있는 게 아니라 W=\{(x_1,y_1,\theta_1),\ldots,(x_5,y_5,\theta_5)\} 형태로 위치와 yaw까지 같이 예측하고 Flow Matching기반으로 설계되었습니다.
Data Engine
ABot-N0는 총 7802개의 3D scene, 약 10.7 km²에 해당하는 공간을 사용하고, 이 환경들 위에서 주행가능한 내비게이션 그래프를 구축해서 데이터를 생성했다고 합니다. Indoor에는 집뿐만 아니라 office, mall, station 등이 포함되고, outdoor에는 park, 교차로, 그리고 동적 보행자와 차량이 존재하는 SocCity(socialnav에서 제안된 데이터셋)까지 포함됩니다.
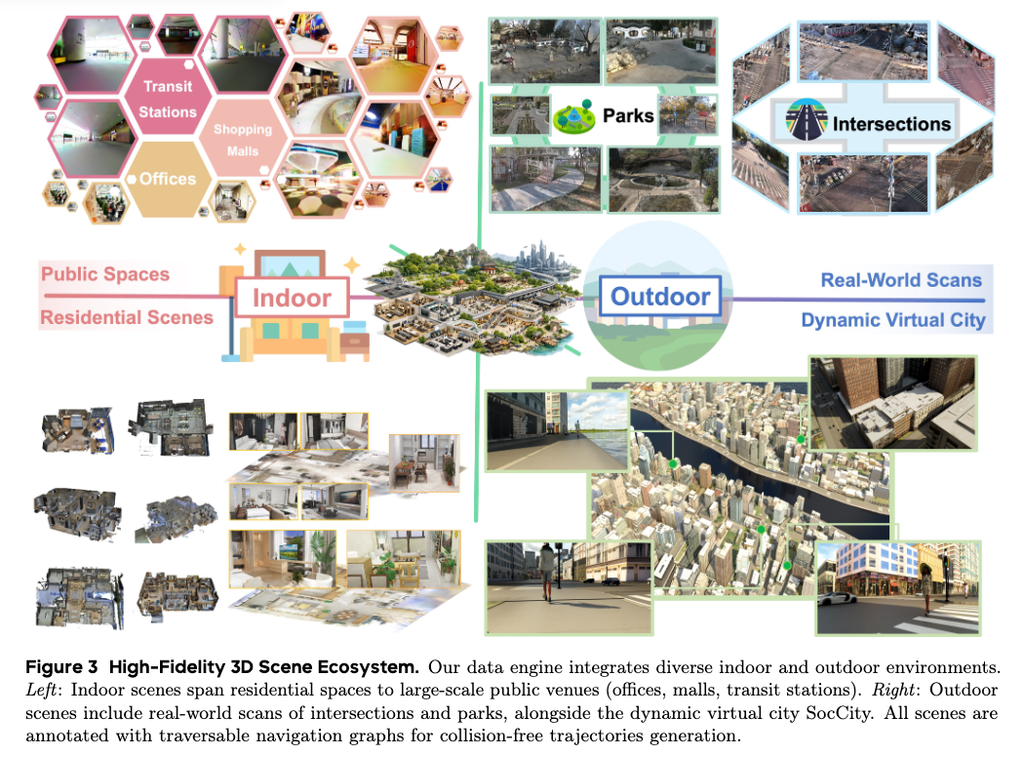
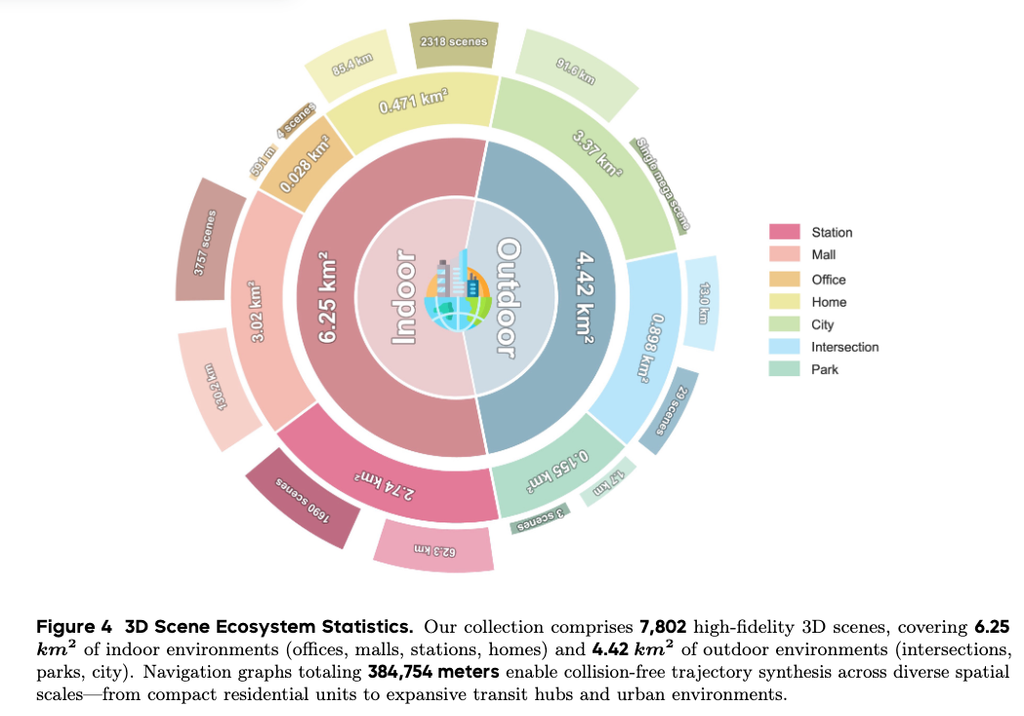
위는 Indoor / Outdoor 3D 환경의 종류를 보여주는 그림이라고 보시면 좋을 것 같습니다.
그리고 여기서 두 종류의 데이터를 만듭니다.
하나는 어떻게 움직여야 하는지를 학습하기 위한 Trajectory 데이터셋이고, 다른 하나는 환경을 어떻게 이해해야 하는지를 학습하기 위한 Reasoning 데이터셋입니다.
Trajectory Dataset
Trajectory 데이터 셋은 총 약 16.9M 샘플입니다.
2M 정도는 인터넷의 1인칭 보행 영상에서 가져옵니다. 영상으로부터 π³를 이용해 3D 구조와 카메라 궤적를 복원하고, MoGe를 사용해서 metric 스케일을 맞춘 다음 그 카메라 궤적을 내비게이션 traj로 변환합니다.
그리고 1.7M 정도는 앞에서 구축한 3D 환경에서 내비세이션 그래프를 따라(정확히 이 그래프의 형태가 어떻게 이루어져있는지는 자세하게 나와있지 않아서 모르겠으나, 개인적인 추측을 하자면 3D 환경위에서 주행 가능한 semantic 영역의 집합이지 않을까 생각합니다.) 최적의 traj를 생성하며, 추가적으로 좀더 리얼 환경에서 발생할 수 잇는 그런 상황에 강인하기 위해 기존 path에서 벗어난 위치나 collision에 가까운 상태에서 시작하는 recovery trajectory도 포함합니다.
마지막으로 SCAND, HuRoN, RECON, CityWalker 같은 실제 robot 데이터셋에서 약 340K trajectory를 가져옵니다.
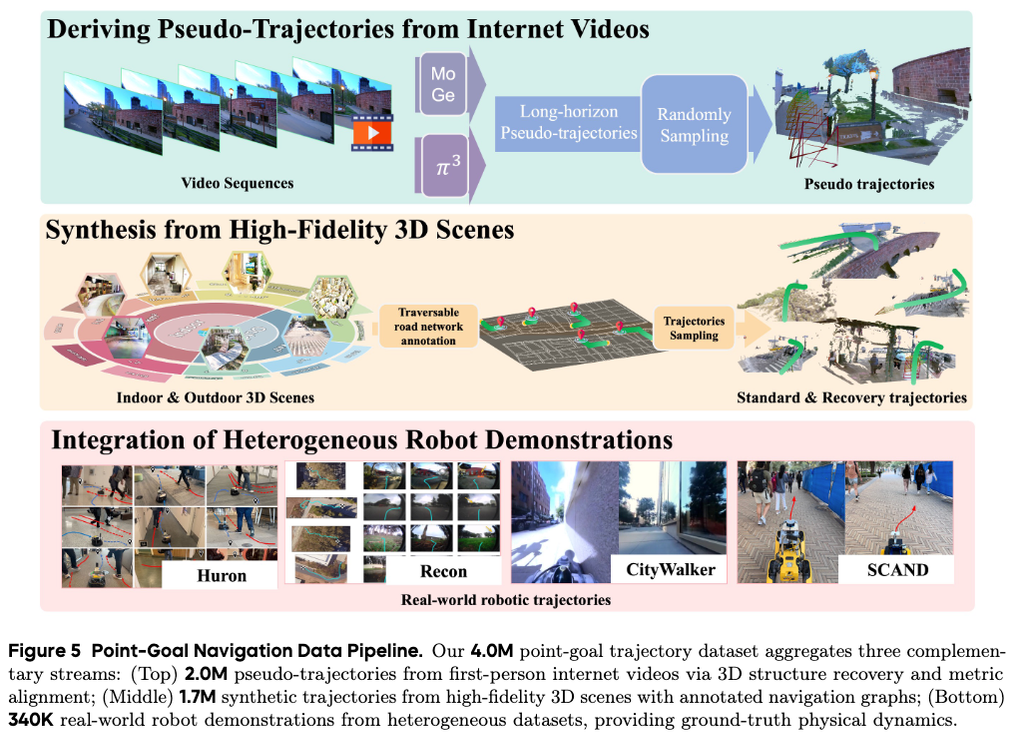
위들 각각 여기서 처음 제안한 데이터 엔진은 아니고 해당 랩실에서 지금까지 꽤 관련 연구를 진행하고 있는데 각각에서 설계한 데이터 엔진들을 여기 ABOT-N0에서 대통합하고 있는 것으로 이해하시면 좋을것 같습니다.
나머지 태스크도 비슷한 식으로 대규모로 구성하는데 여기서는 그래도 단순히 여러 벤치마크 데이터셋을 합친 것뿐만 아니라 각 태스크에서 기존 데이터가 부족하다고 판단되는 상황을 의도적으로 만들어서 데이터 분포를 확장도 진행합니다.
Instruction-Following에는 VLN-CE R2R/RxR뿐만 아니라 door traversal, 사람을 찾아가는 instruction, 앞으로 3m 가고 왼쪽으로 돌아라같은 short-horizon instruction을 별도로 생성합니다.
Object-Goal에는 HM3D와 OVON뿐 아니라 InteriorGS의 약 700개 object 카테고리를 활용하고, 목표 물체가 실제로 camera FoV에 등장하는 시점을 기준으로 짧은 trajectory를 별도로 만드는 방식도 사용합니다.
Person-Following에서는 사람과 1.2m, 1.5m, 2m를 유지하면서 추적하는 데이터를 만들고, 일반적인 single target뿐 아니라 비슷하게 생긴 사람이 등장하거나 target이 occlusion되는 상황도 만듭니다. 최종적으로 person-following 데이터만 약 4M 샘플입니다.
5M Reasoning Dataset
그 다음이 약 5M개의 Reasoning 데이터입니다.
여기에는 단순한 VQA만 들어있는 게 아니라 실제 내비게이션에 필요한 reasoning을 구체적으로 분리합니다.
예를 들어 이미지에서 어디가 물리적으로 걸어갈 수 있는지뿐 아니라 sidewalk, crosswalk처럼 사회적으로 이동 가능한 영역을 polygon 형태로 예측하는 데이터가 1.2M개 있고 또 신호등이나 보행자가 있는 장면에서 왜 멈추거나 양보해야 하는지를 설명하는 Social Navigation CoT가 0.8M개 정도 있습니다. 그리고 Instruction-Following에서는 긴 instruction을 sub-instruction으로 나누고 여기까지 왔으면 첫 번째 instruction이 끝났다 같은 milestone을 만들어 현재 instruction 진행사항을 이해하게 합니다. Object-Goal에서는 목표가 보이는지, 어느 방향에 있는지, 어떻게 접근할지를 reasoning하게 합니다.
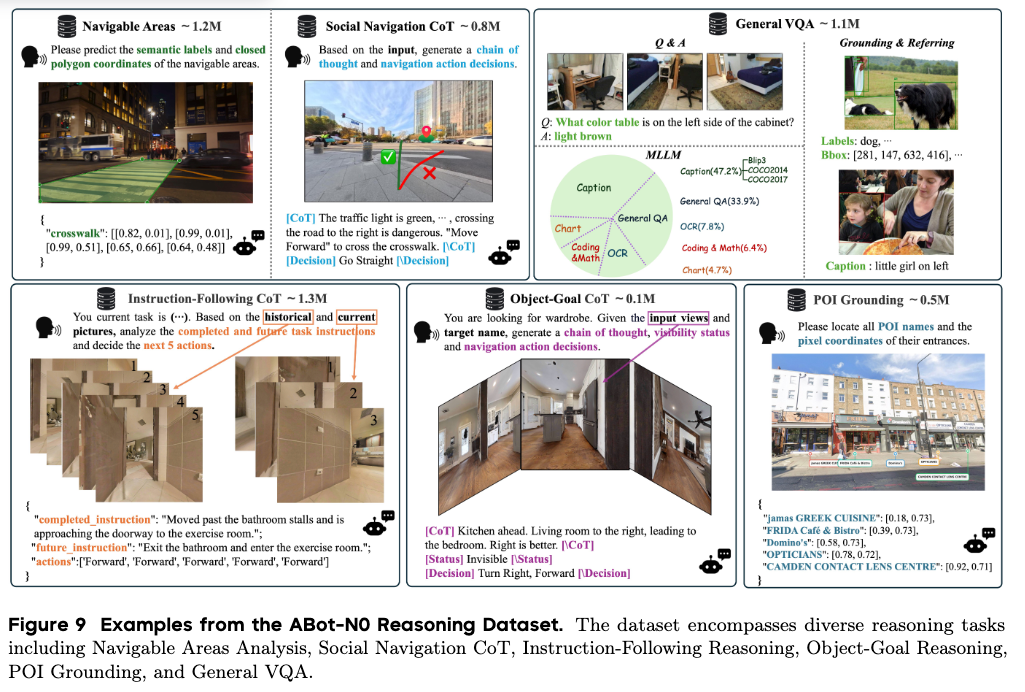
Reasoning 데이터 셋의 종류가 위 그림에 거의 다 들어있습니다. 그래도 이 reasoning 데이터셋의 구축이유는 모델이 Traj만 가지고 학습하면 결국 이 장면에서는 이 traj 가 정답이다 정도만을 배우게 될텐데 별도의 reasoning supervision을 통해 왜 여기가 traversable한지, 왜 횡단보도를 이용해야 하는지, 현재 instruction의 어느 부분까지 수행했는지 등을 Brain에 먼저 학습시킵니다. 그리고 실제 action 예측에 있어서는 그 representation을 활용하게 됩니다.
Training
학습은 총 3단계이고 첫 번째가 Cognitive Warm-up입니다. 이 단계에서는 Action Expert를 건드리지 않고 5M Reasoning 데이터셋으로 Brain을 먼저 학습시킵니다. 이미지 인코더랑 llm 토크나이저 도 freeze하고 LLM 쪽만 fine-tuning합니다.
두 번째 단계는 Unified Sensorimotor SFT입니다. 여기서 5개 태스크의 trajectory 데이터를 전부 섞어서 학습합니다. 근데 여기서 첫 단계에서 학습한 reasoning 능력이 사라지지 않도록 약 20% 정도의 reasoning 데이터를 다시 추가해서 같이 학습합니다.
그리고 AR Head의 text prediction loss와 Action Expert의 Conditional Flow Matching loss를 동시에 최적화합니다.
그리고 마지막 세 번째가 SAFE-GRPO입니다.
모방 학습만으로는 사람이 걸어간 경로를 외우는 것은 가능하지만, 명시적으로 이렇게 움직여야하는 과정 자체는 모델이 모른다고 합니다. 그래서 SocCity의 semantic occupancy annotation을 이용해서 sidewalk처럼 사회적 규범을 지키는 영역으로 이동하면 reward를 주고, 차도나, 아니면 보행자 쪽아예 부딪히는 traj가 들어가면 penalty를 주는 RL post-training을 수행합니다.
이때 Brain은 freeze하고 Action Expert만 추가로 학습합니다.
정리하면 Reasoning을 먼저 학습 –> 5개 navigation task를 통합해서 IL –> social 룰에 대해서 RL로 이어지는 3단계 학습으로 이해하면 될 것 같습니다.
Experiments
실험은 앞에서 이야기한 5개의 navigation task를 각각 기존 벤치마크에서 평가합니다.
Point-Goal
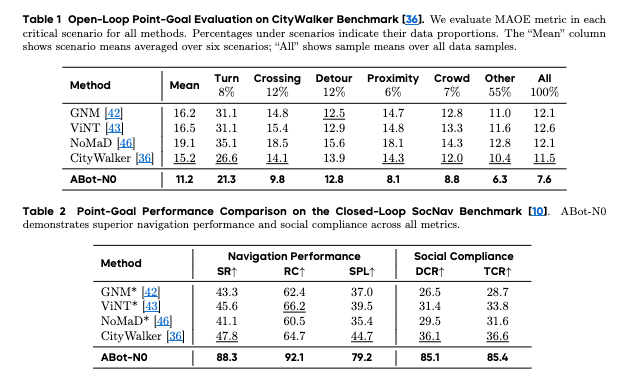
Point-Goal은 CityWalker의 open-loop 벤치카므와 SocNav의 closed-loop 벤치마크에서 평가합니다. CityWalker에서는 예측한 traj의 방향 오차를 평가하는 MAOE가 모든 지표에서 압도적으로 좋은 성능을 보입니다. SocNav closed-loop 결과같은 경유는 ABot-N0가 SR,RC,SPL 뿐만 아니라 socially traversable 영역을 얼마나 잘 지키는지를 나타내는 DCR/TCR도 각각 압도적인 결과를 보입니다. 물론 이 성능 향상이 Brain-Action 구조 때문이기 보다는 앞서 모달리티 대 통합 데이터의 영향이 큰 거 같습니다.
Instruction-Following
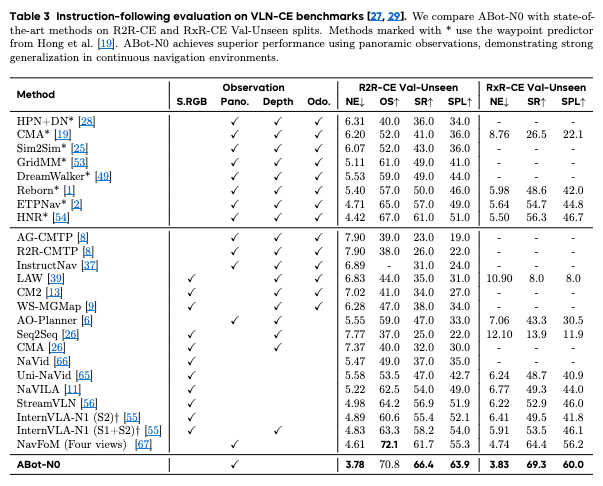
VLN-CE R2R과 RxR에서는 ABot-N0가 panoramic RGB(앞 왼 오 관측영상 사용)만으로 꽤 높은 성능을 보입니다. 물론 입력 모달리티의 공정성을 기준으로 판단하면 사실 S.RGB만 사용하는 방법론들과 같이 비교하면 안될 거 같긴한데 그래도 여러개의 모달리티를 사용하거나 혹은 NavFoM과 같은 근데 요친구는 4개의 뷰를 사용해서 어떻게 보면 ABOT n0보다는 유리한 세팅이지만 이들보다 성능이 좋은걸 보여주는 결과 입니다.
Object-Goal
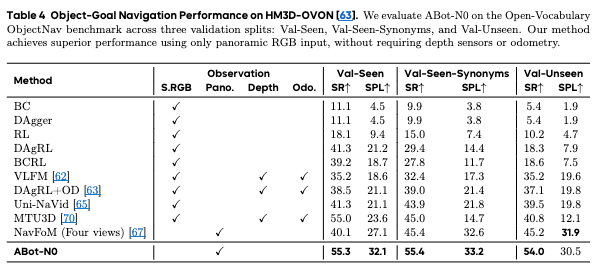
Object-Goal에서는 HM3D-OVON을 사용합니다. 여기도 마찬가지로 depth나 odometry를 사용하는 방법론 같은 경우는 실시간 mapping을 하고 다양한 파운데이션 모델을 기반으로 그 위에서 navigation하는 방법론인데 이들의 방법론보다 좋은 성능을 보입니다.
POI-Goal
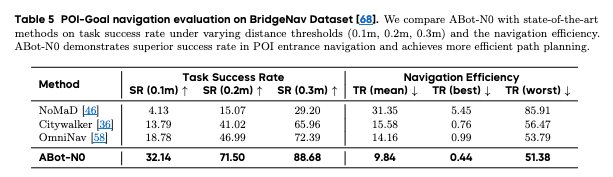
POI-Goal은 BridgeNav에서 평가합니다. POI를 찾았다고 끝나는 게 아니라 실제 입구 중심으로부터 0.1m, 0.2m, 0.3m 안까지 얼마나 정확하게 접근하는지를 평가합니다. 결과적으로 좋은 성능을 보이며 Action Expert가 단순히 coarse한 수준의 semantic 내비게이션만 하는 것이 아니라 실제 입구까지 finegrained하게까지 내비게이션을 할 수 있음을 보입니다.
Person-Following
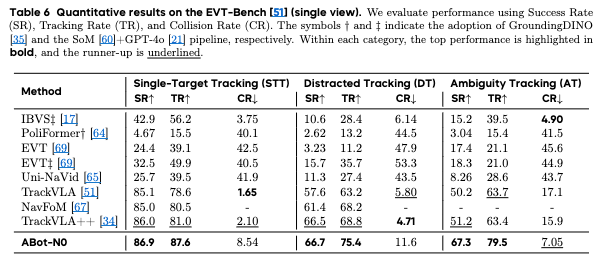
Person-Following에서는 EVT-Bench의 Single-Target, Distracted Tracking, Ambiguity Tracking 세 상황을 평가합니다.특히 target이 가려졌다가 다시 나타나는 Ambiguity Tracking에서 ABot-N0는 기존 방법보다 큰 성능 차이를 보입니다.
근데 Tracking 성능은 굉장히 높지만 Collision Rate는 오히려 높은 경향을 보입니다. 이에 대한 저자들의 언급은 따로 없긴 합니다. 근데 사실 Tracking에 최적화된 모델들(IBVS 포함)과 비교했을 때의 결과이지 기존 Uni-Navid 위로의 베이스라인들과 비교했을 때에는 그래도 나쁘지 않은 결과인 것 같습니다.
Agentic Navigation System
여기까지가 ABot-N0라는 VLA model 자체에 대한 내용이고, 논문 후반부부터는 이를 실제 복잡한 navigation 시스템 안에서 어떻게 사용하는지를 설명합니다.
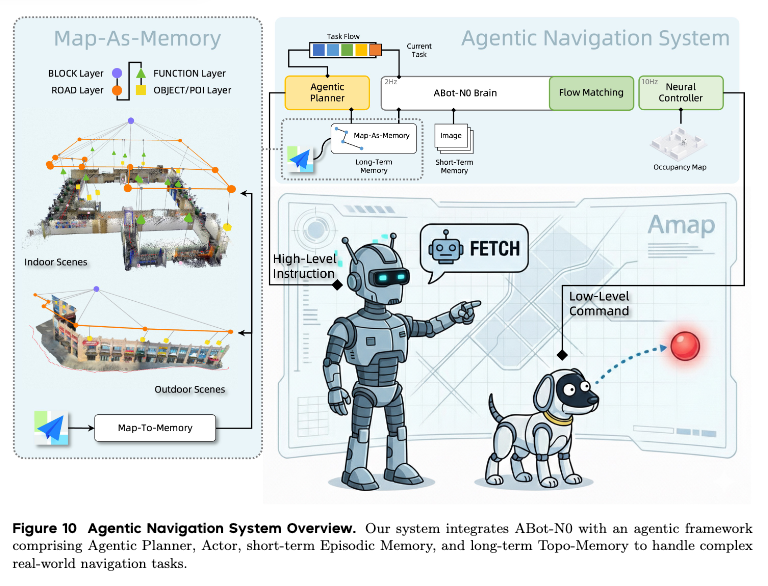
위는 Agentic Planner, ABot-N0, Episodic Memory, Topo-Memory의 관계를 보여주는 전체 시스템 그림입니다. 실제 사용자가 로봇한테 주는 명령은 벤치마크처럼 항상 깔끔하지 않기 때문에 예를 들어 근처 카페에 가서 음료를 사고 앉을 자리도 찾아줘. 같은 명령을 하나의 Object-Goal로 해결하기는 어렵습니다.
그래서 Agentic Planner가 전체 명령을 여러 개의 하위 내비게이션 태스크로 분해합니다. ABot-N0에서는 이를 크게 Approaching –> Reaching –> Interaction의 흐름으로 분해합니다.
장거리 이동은 Point-Goal로 처리하고, 목표 근처에 도착하면 Object-Goal이나 POI-Goal로 정밀하게 목표를 찾고, 마지막으로 Instruction-Following이나 Person-Following 같은 interaction을 수행합니다.
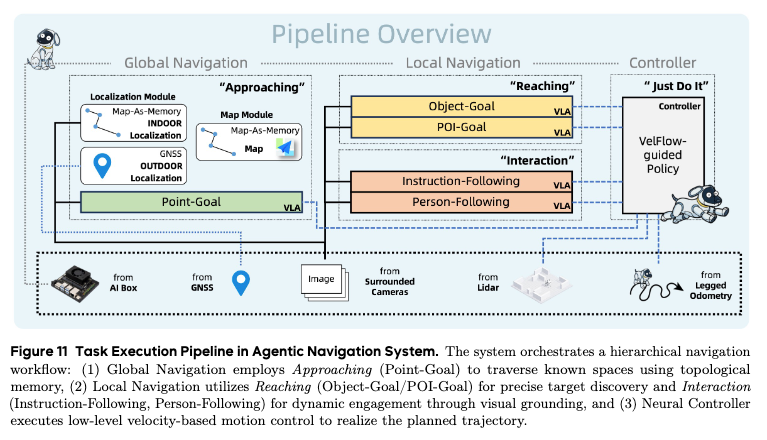
위는 Point-Goal –> Object/POI-Goal–> Interaction으로 이어지는 coarse-to-fine 구조를 보여주는 그림입니다.
Map as Memory
이 시스템에는 Topo-Memory라는 장기 memory도 있습니다. 논문에 자세한 구축과정에 대한 설명은 없지만 단순히 별도 occupancy map과 같은 형태로 메모리에 저장하는 게 아니라 환경을 계층적인 topology로 관리한다고 합니다. 총 4개의 레이어가 있는데 Block layer에서는 방이나 이웃 건물 정도의 큰 영역을 관리하고, Road layer에서는 문이나 복도 같은 연결 관계를 관리합니다. 그 아래 Function layer에는 부엌이나 엘리베이터 같은 의미론적인 공간을 저장하고, Object/POI layer에는 특정 object나 POI를 저장합니다. 어떤 기준으로 설계했는지는 모르겠으나 논문만 읽었을때에는 너무 추상적으로 와닿아서 코드를 봐야이해할 수 있을 것 같습니다.
암튼 근데 저 메모리의 역할 자체는 예를들어 oven을 찾아줘라고 했는데 과거 memory에 kitchen 위치를 알고 있다면 처음부터 Object-Goal로 건물 전체를 탐색하지 않고 먼저 kitchen까지 Point-Goal로 빠르게 이동하고, 그 이후에 local Object-Goal로 oven을 찾습니다. (coarse-to-fine 내비게이션)
그리고 ABOT n0라는 planning 모듈 자체는 별도의 odom이나 depth 정보는 필요하지 않는데 이런 navigation application 관점에서 접근했을 때 전체 시스템 관점에서 봤을 때에는 depth와 odom 정보를 활용하는 것 같습니다. 사실 인도어 상황에서 point goal nav를 수행하기 위해서는 자기 위치는 어디인지 골 위치는 어디인지를 알아야하는데 이를 알기 위해선 결국 인도어에 대한 map 정보가 있어야합니다. 그 관점에서 저자들은 별도의 구축된 맵위에서 LiDAR나 odom정보를 통해 실시간으로 localization을 수행하거나 지도가 없다면 해당 정보를 기반으로 실시간으로 지도를 구축하는 방식을 사용하는 것 같습니다. 사실 이렇게 LiDAR나 odom정보를 내비게이션 시스템에서 활용할 수 있다라는 것 자체만 봤을 때 이런 topo memory가 필요한가 라는 생각이 듭니다. 그리고 실제 저자들이 제안한 topo memory 어떻게 활용되는지 해당 부분에 대해서는 저자들이 깊게 다루고 있지 않아서 저는 그냥 맵을 사용하는구나로 이해하고 넘어갔습니다.
Self-Reflection
앞선 각 sub-task가 끝나면 VLM 기반 Self-Reflector가 정말 목표를 달성했는지를 다시 판단합니다.
실패했다고 판단하면 그 이유를 자연어 feedback으로 agentic Planner(경로 계획X)에게 전달하고, Planner가 다시 task 분해를 합니다.
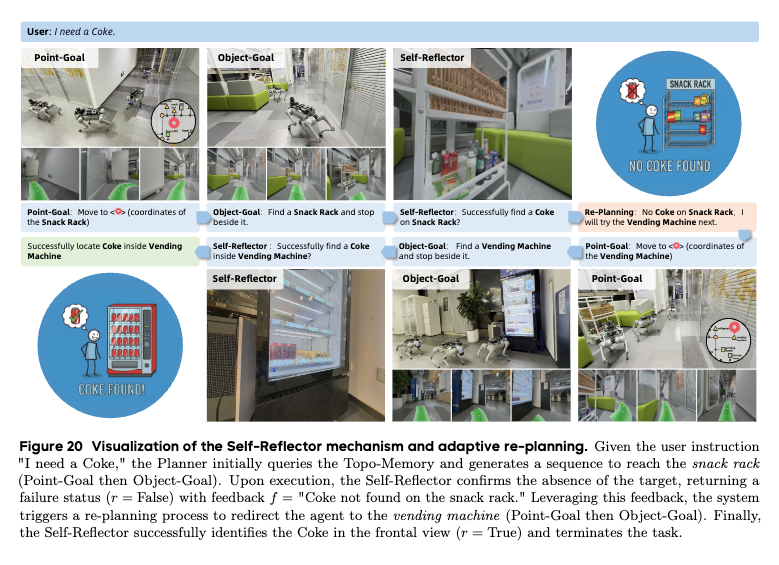
이 Figure 20이 이 컨셉을 잘 보여준다고 생각하는데 사용자가 Coke가 필요하다고 명령하면 처음에는 memory를 보고 snack rack으로 이동합니다(point goal , object goal). 그런데 도착해서 보니깐 Coke가 없습니다.
그러면 Self-Reflector가 실패를 판단하고 snack rack에는 Coke가 없다라는 feedback을 주고, Planner가 이번에는 vending machine을 찾아가는 새로운 계획을 만듭니다. 최종적으로 vending machine에서 Coke를 발견하면 task가 종료됩니다.
이런 구조를 보면 ABot-N0 단독 모델로 모든 문제를 한 번에 해결하려고 하기보다는, 작은 navigation 태스크들을 잘 수행하는 모델을 만들고 그 위에서 Agent가 상황에 따라 잘 조합하는 느낌입니다.
Real-World Deployment
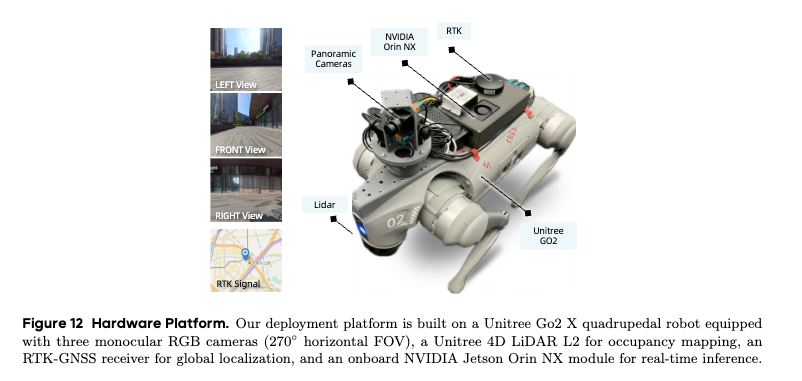
실제 로봇은 Unitree Go2 를 사용합니다. 카메라는 left/front/right의 RGB camera 3개를 사용해서 약 270°의 horizontal FoV를 구성합니다. 근데 앞서 말했듯이 실제 전체 시스템에서는 RGB만 사용하는 것이 아니아Unitree 4D LiDAR L2를 이용해서 local occupancy map을 만들고, global localization에는 RTK-GNSS를 사용합니다. 그리고 robot odometry까지 이용해서 BEV occupancy map을 지속적으로 업데이트합니다. 사실상 slam하는거랑 다름이 없는 것 같습니다. 그리고 또 다른 별도의 모듈로 obstacle avoidance와 실제 velocity control은 LiDAR occupancy map을 사용하는 별도의 Neural Controller가 담당합니다.
ABot-N0는 약 2Hz로 high-level waypoint를 생성하고, Neural Controller는 10Hz 이상으로 동작하면서 waypoint와 occupancy map을 받아 (v_x, v_y, v_{yaw}) 형태의 velocity command를 생성합니다.
그래서 이것도 VLA가 직접 motor command까지 끝까지 생성하는 완전한 end-to-end 구조라고 보기보다는,
VLA = local trajectory planner
Neural Controller = high-frequency collision avoidance + trajectory tracking
으로 역할을 분리한 계층형 시스템이라고 보는 게 더 정확할 것 같습니다.
암튼 벤치마크 평가는 이런 내비게이션 시스템위에서 평가한것이 아니라 Abot n0라고 하는 플래너를 평가한거기 때문에 구분하셔서 보셨으면 좋겠습니다. 근데 이제 또 여기서 드실 수 있는 의문점은 closed-loop 벤치마크 평가시 occupancy map을 필요로 하는 neural controller는 사용할 수 없을텐데 이경우 controller는 어떤걸 썼을 지인데 이 부분에 대한 저자들의 언급은 따로 없었습니다.. 가장 기본적인 controller를 모든 방법론과 통일해서 사용하지 않았을까 싶습니다.
그리고 실제 deployment할 때 Cloud와 임베디드 보드를 나눠서 사용합니다.
Agentic Planner는 RTX 4090이 있는 cloud 서버에서 실행하고, 실제 ABot-N0와 Neural Controller는 Jetson Orin NX에서 실행합니다. 애초에 보드위에서 돌아가는것 뿐만아니라 AGX보다 저 스펙인 NX에서 돌아간다니 의외였습니다. 저자들은 이런 엣지 deployment를 위해 이미지 인코더도 비교적 작은 SigLIP-B/16으로 구성하고, visual token을 merge size 4로 압축했다고 합니다.
이렇게 해서 Orin NX에서 VLA를 약 2Hz로 실행하고, 논문에서는 원래 모델 대비 성능 감소가 약 3% 정도라고 합니다. (controller 는 10hz로 실행)
Conclusion
이 논문의 결과만 보면 결국 데이터를 2천만 개 가까이 모아서 Qwen3-4B를 크게 학습한 거 아닌가라는 생각이 들 수도 있습니다. 개인적으로 어느 정도는 맞다고 생각합니다. 데이터의 힘이 엄청 중요하다고 느꼈던 것 같습니다.
그리고 ABot-N0 아케텍쳐에서 완전히 새로운 뭔가가 등장해서 기존 내비게이션의 문제를 해결했다기보다는, 기존에 각각 따로 발전해오던 요소들을 큰 스케일에서 하나의 학습 문제로 정리한 연구에 가까운거 같습니다. Brain은 lllm, action generation은 flow matching, visual history는 context로 넣고, 실제 로봇에서는 LiDAR local controller와 topological map(?)까지 사용합니다. 각각의 구성요소만 보면 이미 존재하던 아이디어들이긴 합니다. 근데 데이터의 힘을 떠나서 해당 논문이 보인건 그래도 이런 서로 다른 요소들이 서로에게 방해되는 요소가 아니라 결국 이 요소들을 어떤 인터페이스로 연결하면 PointNav부터 ObjectNav, insrutionNav, Person-Following까지 하나의 policy가 공유될 수 있고 결과적으로 모든 태스크에서 성능이 더 좋아진다라는 것을 검증한게 핵심인것 같습니다.
그리고 해당 논문 마지막 섹션에서 느낀건 실제 로봇 단계로 넘어가면 VLA의 역할도 모든 것을 해결하는 내비게이션 전체 시스템 관점에서 완전한 E2E 내비게이션 보다는 환경과 goal을 이해해서 좋은 local trajectory를 만들어주는 내비게이션 파운데이션 모델 정도로 두고, global memory나 localization, high-frequency obstacle avoidance controller는 별도 시스템과 결합하는 형태가 지금 당장은 현실적인 구조이지 않나 싶습니다.
이만 리뷰 마치도록 하겠습니다. 감사합니다.


안녕하세요. 귀여운 강아지 로봇이 있어 재밌게 읽었습니다.
네비게이션 연구의 deployment 부분을 보면서 해당 시스템의 각 요소요소를 구성하는 모듈도 중요하지만 이러한 모듈을 하나로 묶어 pipeline으로 만들어 실행하는 것도 매우 중요하구나 라는 생각이 들게 만드는데요. 특히나 agent를 잘 사용해서 어느 모듈이 언제 호출이 되고 이러한 부분도 중요하구나 라는 생각도 들었습니다. Figure 11에서 Task excution pipeline in agentic navigation system에서 궁금한 점이 있는데, ”
장거리 이동은 Point-Goal로 처리하고, 목표 근처에 도착하면 Object-Goal이나 POI-Goal로 정밀하게 목표를 찾고, 마지막으로 Instruction-Following이나 Person-Following 같은 interaction을 수행” 이라고 했을 때, 언제 장거리 이동이라 판단하고, 언제 목표 근처에 도착했음을 판단해서 sub-agent를 구성하는 걸까요? 각 모듈을 언제 호출하고 사용하는지도 해당 파이프라인의 동작에서 중요한 부분이라 생각되어 질문드립니다.
감사합니다.