안녕하세요. 이번에 리뷰로 가져온 논문은 M2DGR: A Multi-sensor and Multi-scenario SLAM Dataset for Ground Robots라는 논문입니다. 일단 해당 논문은 새로운 SLAM 알고리즘이나 학습 모델을 제안하는 논문은 아니고 실제 지상 이동 로봇 환경에서 SLAM 알고리즘을 평가하기 위한 대규모 멀티센서 데이터셋을 제안한 논문이라고 보시면 좋을 것 같습니다.
자세한 내용은 아래 리뷰에서 다루도록 하겠습니다.
Introduction
SLAM(Simultaneous Localization and Mapping)은 로봇이 주변 환경의 map을 생성하면서 동시에 자기 위치를 추정하는 기술입니다. 예를 들어서 실내 배송 로봇이 처음 들어간 건물에서 돌아다닌다고 생각해보면, 로봇은 자신이 어느 위치에 있는지 알아야 하고 동시에 주변 공간이 어떻게 생겼는지도 알아야 합니다. 그래서 물류환경이나, 로봇 청소, 음식 서빙과 같은 모바일 로봇의 어플리케이션 관점에서 SLAM은 사실상 핵심 기술로 많이 쓰입니다. 근데 여기서 저자들이 지적하는 문제는 SLAM 연구 자체는 상당히 오래됐고 많은 발전이 있었는데 실제 로봇을 움직여보면 여전히 특정 환경에서 쉽게 실패한다는 점입니다. RGB만을 사용하는 Visual SLAM의 경우에는 주변 텍스쳐 정보가 거의 없거나 조명이 매우 어두워지면 특징들을 제대로 추출하지 못할 수 있습니다. 반대로 LiDAR 기반 SLAM은 조명에는 영향을 거의 받지 않지만 긴 복도나 넓게 열린 공간처럼 어떤 기하학적인 특징이 부족한 환경에서는 문제가 생길 수 있습니다. 그리고 이건 좀 더 특이한 사례이긴 한데 로봇이 엘리베이터를 타는 상황도 있습니다. 로봇 기준으로 보면 엘리베이터 내부의 벽이나 물체들은 거의 움직이지 않는데, 실제로는 로봇 전체가 위나 아래 층으로 이동하게 됩니다. 이런 상황에서는 visual이나 LiDAR 정보만 가지고는 수직 움직임을 알아차리기 어려워서 일반적으로 엘레베이터 환경에 대한 SLAM은 풀기 어려운 문제로 다뤄집니다. 근데 이런 문제들이 단순히 SLAM 알고리즘의 성능이 부족해서 나타나는 문제일 수 있지만, 저자들은 이런 문제를 제대로 평가할 수 있는 벤치마크 자체도 부족하다라고 주장합니다. 그리고 기존 공개된 데이터 같은 경우는 즉 SLAM을 평가할 수 있는 데이터들은 대부분 KITTI와 같은 경우는 자율주행 차량에서 수집한 데이터입니다. 그래서 실제 모바일 로봇 관점에서는 이러한 자율주행 차량과 움직이는 방식이나 마주치는 환경 자체가 많이 다릅니다.
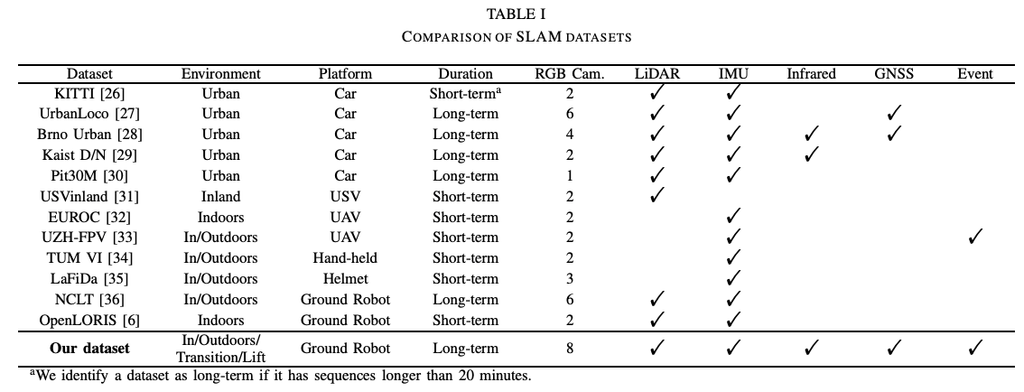
위 표를 보면 기존 데이터셋 중에서도 RGB + LiDAR + IMU를 같이 제공하는 경우는 있지만, 여기에 열화상, GNSS, 이벤트 카메라까지 같이 제공하면서 실내/실외/transition/elevator 환경을 모두 포함하는 경우는 많지 않습니다. 특히 저자들은 당시 공개된 SLAM 데이터셋 중에서 indoor, 열화상 데이터를 포함하는 데이터셋이 거의 없었다는 점을 지적합니다. 기존 Brno Urban이나 KAIST Day/Night 데이터셋도 열화상 카메라가 포함되어 있지만 자동차 기반 outdoor 데이터셋입니다.
그래서 저자들이 해결하고자 하는 문제를 정리하면기존 SLAM 알고리즘들이 실제 이런 로봇 환경에서 얼마나 잘 동작하는지를 보고 싶은데, 이를 평가할 수 있는 충분히 다양한 환경과 센서 모달리티를 가진 벤치마크가 없었다이고, 그래서 여기서 저자들은 이런 다양한 환경과 센서 모달리티를 가진 벤치마크를 제시합니다.
M2DGR Dataset
먼저 저자들은 데이터를 수집하기 위한 ground robot platform을 구성합니다.
로봇은 크게 3개의 층으로 구성되어 있고, 하단에는 파워 공급 배터리랑 컴퓨터가 들어가고 중간과 상단에 여러 센서들을 배치합니다. LiDAR는 많은 데이터를 전송해야 하기 때문에 이더넷으로 연결하고, 나머지 센서들은들은 USB 3.0을 이용하며, 데이터는 NVMe SSD가 장착된 laptop에 기록해서 데이터를 수집할 수 있도록 세팅했다고 합니다.
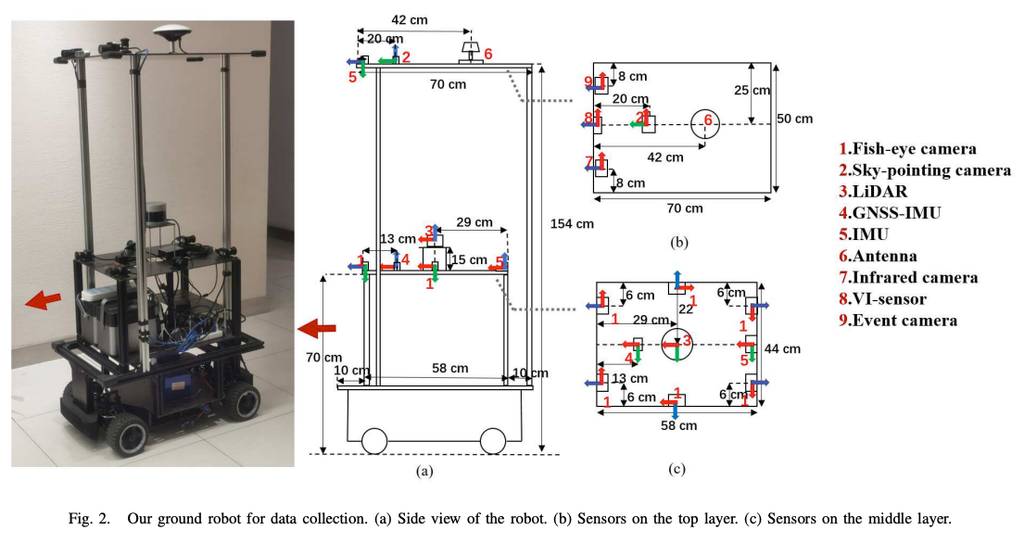
위 그림이 Ground robot platform 구성도 입니다.
sensor 구성 같은 경우는 먼저 주변의 RGB 정보를 얻기 위해 총 6개의 fisheye camera를 사용합니다. 전방 stereo pair, 후방 stereo pair 그리고 좌우 방향을 보는 camera를 배치해서 로봇 주변을 약 360°로 관측할 수 있도록 구성했다고 합니다. 그리고 이외에도 32채널짜리 LiDAR, 열화상 카메라, 이벤트 카메라, Visual inertial 센서(realsense), IMU, GNSS, fisheye camera, RTK/INS를 함께 장착해서 센서 구성을 했다고 합니다.
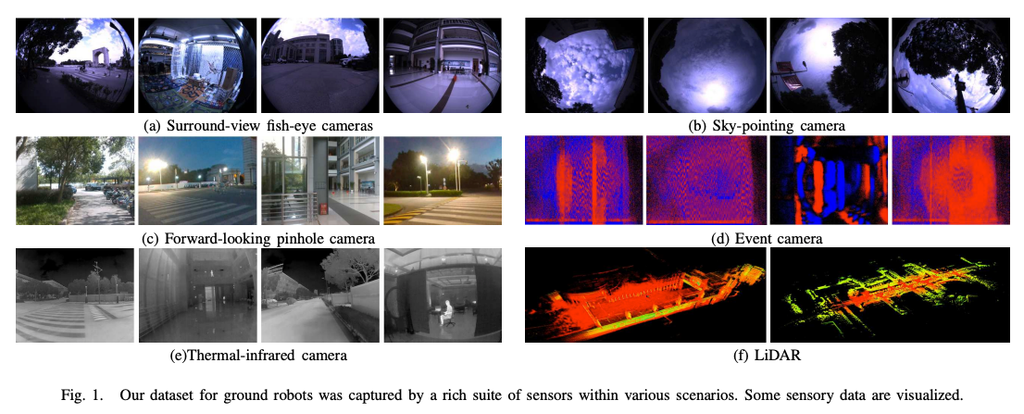
위는 센서 데이터 시각화 예시입니다.
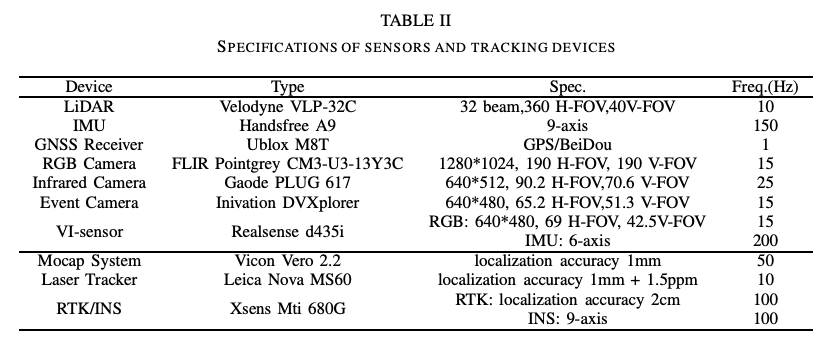
위는 좀더 구체적인 센서 스펙이니 참고하면 좋으실것 같습니다. 그리고 뒤에서 설명할 GT 급 trajectory를 얻기 위해 Vicon motion capture, Leica laser tracker, Xsens RTK/INS 도 함께 사용합니다.
그리고 센서들간 시간 동기화를 맞추는데, 저자들은 모든 센서를를 하드웨어 트리거로 하나로 연결해서 동기화를 맞춘게 아니라 소프트웨어적으로 동일한 시스템 타임스탬프를 사용해서 동기화를 맞췄다고 합니다. 특히 여러 fisheye camera와 sky camera는 API를 이용해 동일한 순간에 캡쳐하도록 동기화하고, 저자들이 측정했을 때 커메라 사이의 synchronization error는 10 ms 이하였다고 합니다.
이제 실제 데이터를 어떤 환경에서 수집되었고 어떻게 구성되었는지에 대해서 설명드리면 이 M2DGR이라는 데이터셋은 총 36개의 sequence로 구성되어 있습니다.
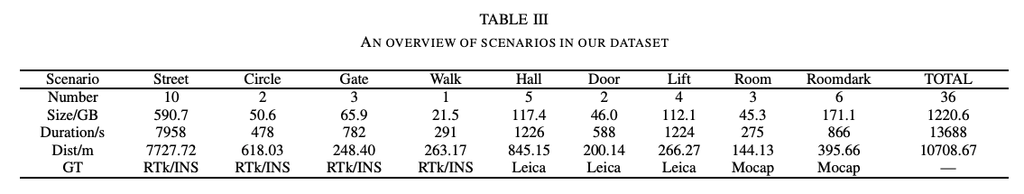
데이터 셋은 위처럼 street 부터 해가지고 다양한 장소 별로 구성됩니다.총 데이터 크기는 위 테이블 기준으로 약 1.22TB, 전체 trajectory 길이는 약 10.7 km, 총 recording time은 약 3.8 시간 분량이라고 합니다.
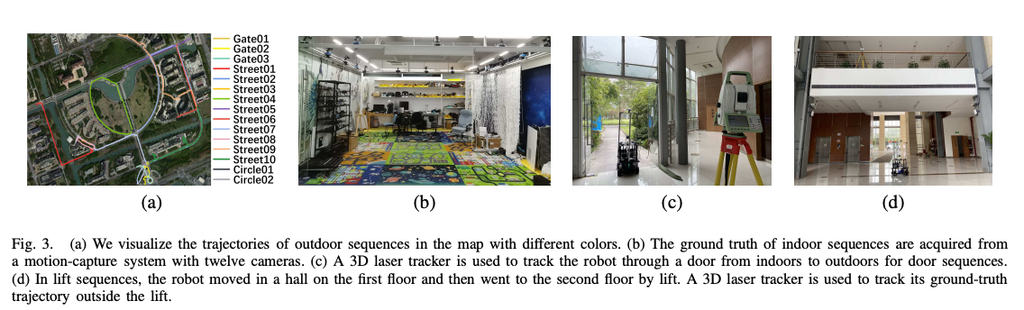
Outdoor 시퀀스는 대학교 캠퍼스에서 수집했고, 위성 가시성이 충분히 좋은 환경에서는 RTK/INS를 이용해서 GT를 얻었다고 합니다. 그리고 단순 직선 trajectory만 있는 게 아니라 Circle01, Circle02처럼 동일한 루트를 반복적으로 도는 시퀀스도 넣어서 visual SLAM의 loop closure 성능도 평가할 수 있도록 구성합니다.
Indoor 환경에서는 12대의 high-speed tracking camera로 구성된 Vicon motion capture system을 사용해서 정밀한 trajectory GT를 얻었다고 합니다.
그리고 Roomdark 시퀀스 같은 경우는 방의 불을 완전히 꺼놓은 상태에서 로봇을 이동시키면서 데이터를 수집한 데이터 입니다.
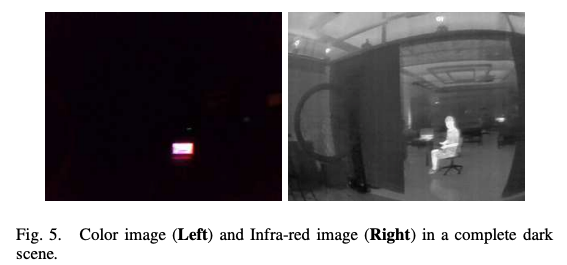
왼쪽 RGB는 거의 대부분의 장면이 검게 보이고 작은 밝은 물체 정도만 확인할 수 있는데, 오른쪽 thermal에서는 사람과 주변 구조가 잘 보입니다. 뒤의 젠치마크 결과에서도 이런 차이가 Visual SLAM 성능에 실제로 영향을 줍니다.
또 Door 시퀀스에서는 로봇이 실외를 이동하다가 건물 안으로 들어갔다가 다시 밖으로 나오는 trajectory를 기록합니다.이 환경이 중요한 이유는 이런 환경에서 GNSS 신뢰도가 순간적으로 크게 달라지기 때문입니다. 밖에서는 위성 신호를 안정적으로 받을 수 있지만, 건물 안으로 들어가는 순간 GNSS가 사실상 사용 불가능해집니다.
그래서 단순 indoor 또는 outdoor만 평가하는 게 아니라, 서로 다른 localization 모달리티가 바뀌어야 하는 이런 변화하는 상황까지 데이터셋에 포함했다고 보시면 좋을 것 같습니다.
그리고 어려운 시나리오가 Lift 시퀀스인데 로봇이 1층 hall을 이동하다가 엘베에 탑승하고, 엘베를 타고 다른 층으로 이동한 뒤 다시 밖으로 나오는 시나리오 입니다. 이게 SLAM 관점에서는 풀기 어려운 문제로 잘 알려져있는데 엘베 안에 로봇과 주변 환경이 같이 올라가고 있기 때문에 RGB나 LiDAR로 주변을 보면 실질적으로 환경은 거의 움직이지 않는 것처럼 보일 수 있기 때문에 사실상 odometry를 추정하는게 어렵습니다. 그래도 저자들은 이러한 상황을 평가 해볼 수 있도록 레이저 트래커 기반으로 엘베 밖에서 GT를 추정해서 기록했다고 합니다.
Experiments
이제 저자들은 M2DGR 위에서 실제로 기존 SLAM 알고리즘들을 모아서 평가를 진행합니다. 그리고 저자들은 전체 36개 시퀀스 중 특징적인 7개 시퀀스를 골라서 평가합니다.
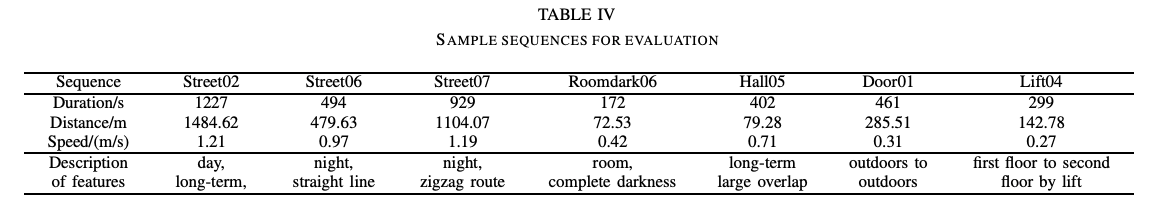
Street02는 long-term outdoor, Street06은 야간, Street07은 야간에서 지그재그와 급격한 변화, Roomdark06은 엄청 어두운 상황, Hall05는 반복적인 루프 클로저가 많이 발생하는 상황, Door01은 outdoor-to-indoor 변환, Lift04는 엘레베이터를 이용한 floor 변환입니다.
Visual SLAM 쪽에서는 ORB-SLAM3, CubemapSLAM,Multicol-SLAM, VINS-Mono를 평가했고, ORB-SLAM3은 동일한 알고리즘에 입력 카메라만 바꿔서 ORB3-Pinhole/Fisheye/Thermal 세 가지 형태로 평가합니다. LiDAR 계열에서는 A-LOAM, LeGO-LOAM,LINS, LIO-SAM 을 사용하고, GNSS localization 비교를 위해 RTKLIB도 사용해서 평가했다고 합니다. 그리고 EVO라는 이런 SLAM/VIO/VO에서 추정한 trajectory를 GT와 비교해서 오차를 계산하고 시각화하는 오픈소스 평가 툴킷을 활용하여 평가를 진행합니다. 평가 지표는 ATE로 SLAM이 추정한 전체 trajectory가 GT trajectory와 얼마나 떨어져 있는지 보는 지표라고 보시면 좋을 것 같습니다.
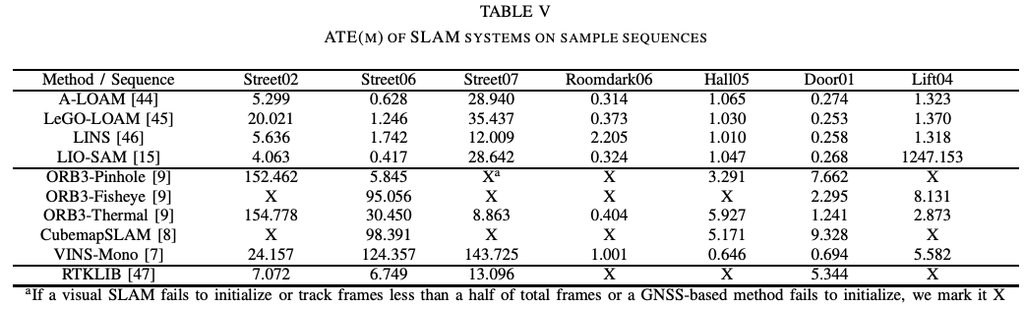
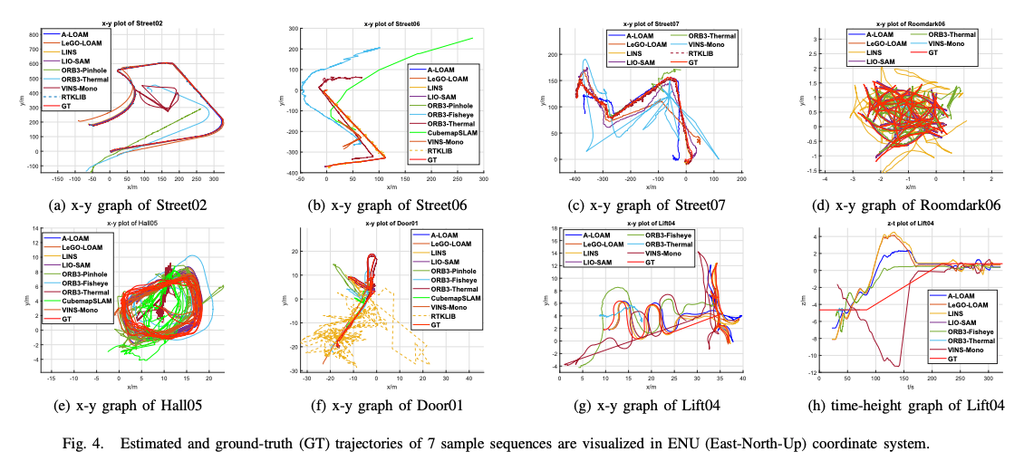
위 표랑 그림이 해당 논문의 메인 결과라고 보시면 좋을 것 같습니다.전체적으로 보면 LiDAR 기반 방식이 visual 방식보다 안정적인 경우가 많지만, 중요한 건 어떤 하나의 SLAM도 모든 시퀀스에서 안정적으로 동작하지는 않았다는 점을 저자들은 주장합니다.
일단 저조도 환경인 Roomdark06과 Street07은 일반 RGB pinhole이나 fisheye camera를 사용한 ORB-SLAM3은 제대로 동작하지 못하는 결과를 보입니다. ORB-SLAM3 내부에서 이런 조명 변화에 대응하기 위한 HE(histogram equalization)을 사용하고 있음에도 너무 어두운 환경에서는 충분한 특징점를 얻지 못한다고 합니다. 그리고 일부 feature가 검출되더라도 대부분 멀리 있는 가로등과 같이 특정 밝은 객체에 몰리면서 pose estimation error가 커지게된다고 저자들은 분석합니다. 근데 같은 ORB-SLAM3에 thermal 이미지를 넣었을 경우에는 좀더 안정적인 결과를 보입니다. 그렇다고 저자들이 thermal이 RGB보다 항상 좋다고 주장하지는 않습니다. RGB에서는 색상이나 텍스텨가 잘 보이는 물체가 thermal에서는 거의 균등하게 보일 수 있습니다. 논문에서는 컬러풀한 커튼 같은 물체를 예로 드는데, RGB에서는 많은 비쥬얼 피쳐가 존재하지만 thermal에서는 거의 텍스쳐 없이 일관되게 나타날 수 있다고 설명합니다. 그래서 이 결과를 Thermal이 RGB를 대체할 수 있다라고 보는 것보다는 RGB가 약해지는 환경에서 thermal이 보완해주는 센서 역할을 할 수 있다정도로 해석하는게 더 맞을 것 같습니다.
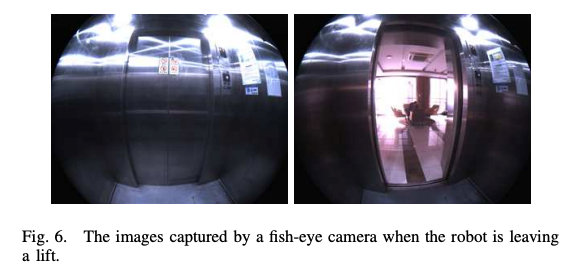
엘리베이터에 들어가게 되면 Visual SLAM이나 LiDAR SLAM 관점에서는 로봇이 거의 정지해 있는 것처럼 보입니다. 이 떄 IMU와 같이 로봇 자체의 선형 가속도와 각속도를 측정할 수 있는 센서로 이런 실제 수직 이동을 알아차릴 수 있긴 하지만 순간적인 움직임이나 방향은 잘 추정할 수 있어도 이걸 오랫동안 누적해야하는 경우에는 IMU 특성상 한계가 있습니다. 그래서 실험에서 테스트한 알고리즘 중 전체 Lift04 trajectory를 제대로 tracking하거나 완성된 map을 만든 방법은 없었다고 합니다. 실제로 그림 (h)를 보시면 z 축에서 방법론들의 예측 궤적들과 GT간차이가 명확히 두드러지는 것을 확인할 수 있습니다. 특히 LIO-SAM은 엘레베이터에 진입한 이후 IMU 의 적분값(?)과 LiDAR odometry 사이의 불일치 때문에 이걸로 발생한 매우 큰 드리프트 때문에 성능이 박살난다고 합니다. 여기서 저자들은 서비스 로봇관점에서는 건물 내 여러 층을 이동하는 상황이 충분히 발생할 수 있기 때문에, 저자들도 이 문제를 실제 ground robot localization에서 해결해야 할 중요한 문제라고 이야기합니다.
Door01에서는 로봇이 실외에서 실내로 이동하는 경우인데 이때 실외에서는 위성 신호가 좋기 때문에 GNSS localization이 잘 되지만, 건물 입구에 가까워지면서 신호 품리가 급격하게 떨어집니다. 그리고 RTKLIB 결과만 수치적으로 보면 ATE가 아주 이상해 보이지 않을 수도 있지만, 실제 (f) trajectory를 보면 indoor 구간에서는 이미 localization이 실패한 것을 확인할 수 있습니다.
Street07은 야간 환경에서 단순히 직선으로 이동하는 시퀀스가 아니라 지그재그, 급회전, 급 정거, 급 가속/감속 등이 들어있는 상황이라고 보시면 좋을 것 같습니다. 이 시퀀스에서는 visual SLAM뿐 아니라 LiDAR SLAM도 상당히 큰 error를 보입니다.(c)를 보시면 visual slam은 tracking 자체가 실패하고, LiDAR method들도 ATE가 크게 증가합니다. 이 결과를 보면 SLAM에서 단순히 sensor 모달리티만 다양하게 사용하는 것뿐 아니라, 로봇의 움직임 자체가 갑자기 변했을 때 motion 추정을 얼마나 안정적으로 유지할 수 있는지도 중요한 문제라고 볼 수 있습니다.
그리고 M2DGR에는 서라운드뷰 fisheye camera가 많이 들어가 있기 때문에 multi-camera SLAM도 평가합니다. 일반적으로 카메라를 여러 개 사용하면 FOV가 넓어지고, 한쪽 카메라에서 피쳐가 부족하더라도 다른 방향 카메라에서 피쳐를 얻을 수 있기 때문에 좀더 slam하는데 유리할 것으로 기대할 수 있습니다.근데 Multicol-SLAM을 세 개의 fisheye camera에 적용했을 때는 거의 모든 시퀀스에서 tracking을 못하는 결과를 보입니다. 저자들은 너무 왜곡이 심한 fisheye 이미지에서 직접 피쳐포인트 뽑아내고 매칭을 수행하기 때문에 false 매칭이 많이 발생했을 가능성을 원인으로 이야기합니다. 그래서 센서의 수보다도 왜곡을을 어떻게 처리하고 여러 카메라 사이의 정보를 어떻게 안정적으로 퓨전하는지도 중요한 문제인 것 같습니다.
암튼 정리하면 저조도 환경, 급격한 변화, 엘레베이터, Indoor-outdoor transition 같은 특정 상황에서는 LiDAR나 Visual 어느 한쪽도 완전히 안정적인 결과를 보이지 못하는 모습을 보여줍니다. 그래서 기존 벤치마크에서 높은 성능을 보이는 쏘타 SLAM이라도, 실제 서비스 로봇이 마주칠 수 있는 조금 특이한 환경으로 가져가면 쉽게 무너질 수 있다는 점을 보여주는 것 같습니다.
Conclusion
정리하면 해당 방법론은 기존 SLAM 알고리즘들이 실제 ground robot 환경에서 얼마나 쉽게 실패할 수 있는지를 보여주기 위해, ground robot에 특화된 환경과 다양한 sensor를 한 데이터셋 안에 모아놓은 벤치마크 논문이고 특히 해당 데이터 셋이 단순히 센서를 많이 장착해서 수집했다기 보다는, 데이터 수집 시나리오를 실제 mobile robot의 관점에서 구성했다는게 핵심인 것 같습니다. 일반적인 실내/실외 trajectory뿐 아니라 실제 마주할 법한 어려운 상황을 넣고 실제 SOTA SLAM을 돌려봤더니, 어떤 하나의 방법도 모든 상황을 안정적으로 처리하지 못했습니다. 그래서 개인적으로 느낀 건 결국 강인한 로봇 localization을 만들기 위해서는 단순히 RGB SLAM을 더 잘 만들거나 LiDAR SLAM을 더 잘 만드는 문제만 있는 것은 아닌 것 같다라는 생각이 들었습니다. 환경에 따라 어떤 센서는 갑자기 신뢰할 수 없게 될 수 있고, 반대로 평소에는 상대적으로 덜 중요했던 센서가 특정 상황에서는 결정적인 역할을 할 수도 있습니다. 그래서 결국 이런 실제 환경에서 강인한 내비게이션 시스템을 만들기 위해서는 각 모달리티가 잘하는 상황과 못하는 상황을 이해하고, 서로 다른 모달리티가 가진 상호보완할 수 있는 정보들을 어떻게 잘 연결할 것인가도 풀어야할 중요한 문제이지 않을까 라는 생각이 듭니다.
이만 리뷰 마치도록 하겠습니다. 감사합니다.