Introduction
로봇이 이미지를 받아서 주행하는 측면에서 현재 학습 기반 방법론(NoMAD, ViNT)가 충돌없이 잘 주행하는 편입니다. 하지만 진짜 어려운 부분들은 모델이 전부 갈수 있을거 같은 후보를 냈을때 고르는 것(저자는 이를 trajectory scoring이라고 부릅니다)입니다. 기존의 궤적의 점수를 내는 함수는 궤적이 imitation과 얼마나 유사한지, 충돌하는지, 부드러운지 등으로 결정됩니다. 그렇기에 사회적 규범이나 지형 경계를 인식하는 semantic한 부분이 부족합니다.
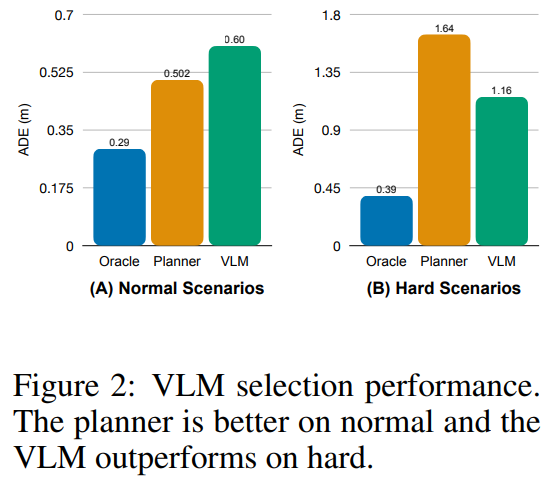
저자들은 이 “scoring gap”을 real-world 2000시간 데이터셋에서 측정해봤습니다. 플래너(궤적을 만들어내는 모델)가 생성하고 1순위로 뽑은 경로들은 ADE가 1.64m였지만, 후보 중에 정답과 가장 가까운 ADE를 재봤을때는 0.39m였습니다. 즉, planner는 이미 좋은 후보를 내고 있는데 잘못 고르고 있다는게 저자들의 핵심 분석입니다. 그리고 잘못 고르는 이유는 맥락에 의존해서 고르기 때문이라고 집어냅니다.
이러한 걸 해결하는데는 VLM만한게 없습니다. 방대한 사전지식으로 사회적 규범들을 바삭히 알고 있기 때문입니다. VLM은 두가지 방식으로 활용됩니다. 첫번째는 E2E로 이미지부터 궤적 생성까지 한번에 해냅니다. 그리고 두번째는 플래너가 뽑은 경로를 이미지에 그려내서 VLM한테 던져주는 것입니다.
두방식 모두 VLM의 내재적인 한계에 부딧칩니다. 바로 느리다는 것입니다. 이에대한 기존 대처법은 3가지로 저자들은 분류합니다.
1. 다음 응답이 올때까지 이전 VLM의 궤적 실행
2. VLM이 큰 경로만 잡아주고, 세부 경로는 low-level 제어기에 맡깁니다
3. fast-slow의 이중 시스템을 e2e로 학습시켜서 사용합니다.(2번을 E2E로 학습시키는 방식입니다)
저자들은 이에 다른 접근을 취합니다. “don’t stop, but do fusion” 멈추지말고 fusion하자고 합니다.
1. planner가 저수준 제어를, VLM이 semantic을 담당합니다.(planner가 경로를 내놓고, VLM이 인덱스를 선택하는 방식)
2. VLM을 학습없이 사용합니다.
3. 낡은 VLM의 선택을 그대로 실행하지 않고, 매 tick 새로 뽑힌 후보들의 점수들에 가산점으로 활용합니다. VLM이 2초 걸린다고 가정하면, VLM이 요청을 하고 이미 이동을 꽤 한 상태에 VLM의 결과가 도착합니다. 그러면 VLM이 정답으로 고른 궤적은 이미 존재하지 않는 상태입니다. 그렇기에 VLM의 궤적을 그대로 사용하는 것이 아닌, 방향에 대한 bias로만 사용한다는 것입니다.
Method
– System Overview
시스템은 Fast Loop(플래너)와 Slow Loop(VLM)로 이루어져 있습니다. 먼저 Fast Loop는 매 tick마다 후보 궤적 K개를 생성합니다. 그리고 각 궤적은 (x, y)의 waypoint로 이루어져있습니다. 그리고 Slow Loop는 비동기적으로 작용합니다. 현재 카메라 이미지에 후보 궤적은 K개의 색깔로 선으로 투영시켜서 그린걸 입력으로 받습니다. 그리고 output으로 가장 목표 방향과 사회 규범을 잘 만족하는 trajectory 번호를 내놓습니다. Slow Loop는 평균 1-2s 걸린다고 합니다. 물론 그 사이에 로봇은 이미 이동 중이여서, fast loop는 새로운 후보를 만든 상태입니다.
이를 해결하기 위해서, fusion을 합니다. 저자는 semantic intent로 현재 플래너의 trajectory를 bias한다고 합니다. VLM의 high-level한 명령은 특정한 trajectory가 더이상 유효하지 않아도, high-level은 유효하다고 합니다.
– Visual Trajectory Selection
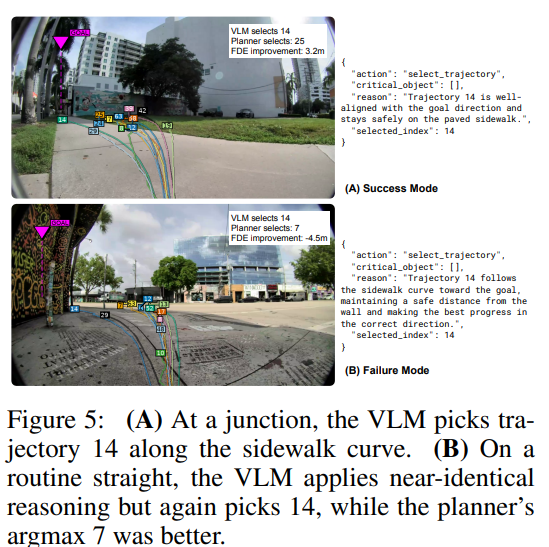
VLM이 궤적을 선택하는 과정을 설명하는 부분입니다. 먼저 플래너가 만들어낸 후보 궤적을 이미지에 투영해냅니다. 궤적의 색깔도 다르게하고, 끝에 궤적의 index도 표기합니다(아래 그림 참고). 그리고 장기 goal 방향은 화살표로 표시합니다.
그리고 output은 JSON을 내뱉게 합니다. VLM은 stop도 고를 수 있습니다. 만약 VLM이 parse가 안되는 잘못된 output을 내뱉으면 planner의 결과를 사용하는 fallback도 있습니다. 이 모든 과정은 VLM을 전혀 학습시키지 않고 진행됩니다. Gemini, GPT-5, Qwen 같은 기성 모델을 zero-shot으로 그대로 사용합니다.
– Latency-Resilient Fusion
VLM의 semantic한 intent를 녹여내기 위해 저자는 두가지 개념을 사용합니다. 첫번재는 기하학적 유사도입니다. VLM이 선택한 궤적은 \hat{\tau}_{\text{vlm}}이라고 할 때, 이 궤적은 질의 시점(VLM에 던진 시점)의 좌표계로 먼저 표현할 수 있습니다. 그리고 odometry를 통해, 단기적으로 어디로 갔는지 얻어낼 수 있습니다. 그러면 궤적도 현재의 로봇의 좌표계로 옮길 수 있습니다. 그러면 해당 좌표계에서의 궤적과 유사도를 계산해낼 수 있습니다. 아래와 같은 수식으로 계산합니다.
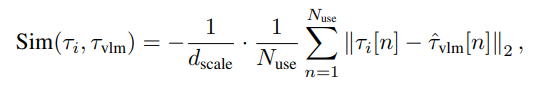
다음은 노후도 감쇠(Staleness decay)입니다. 간단하게 얘기하지만, VLM이 추론결과가 오래될수록 신뢰할 수 없다는 겁니다. 아래와 같은 간단한 수식으로 적용합니다. 수식에서 \tau_{\text{decay}}는 시간 상수입니다.
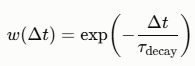
– Score Fusion
그래서 얻은 점수들을 가중합으로 최종 score로 만들어냅니다. S_1은 플래너의 score, 그리고 뒷항은 VLM으로 만들어진 score입니다. 결국 lambda가 VLM이 얼마나 영향을 줄지 결정합니다.
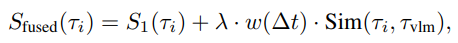
이 방식의 장점은 상황이 나빠져도 자연스럽게 버틴다는 것입니다. VLM 결과가 아직 없으면 뒷항이 사라져 플래너 1순위를 그대로 따르고, 결과가 오래될수록 w(\Delta t)가 작아져 다시 플래너 쪽으로 돌아갑니다. 어떤 경우에도 실제로 실행되는 궤적은 항상 현재 관측으로 만든 플래너 후보 중 하나입니다.
– Probability Fusion
Score fusion은 한가지 문제가 있습니다. VLM쪽 유사도에는 상한이 없습니다. planner의 점수는 0~1인데 유사도는 scale이 횔씬 큽니다. 저자들은 이를 probability를 도입하려 해결하려 했습니다. 두 점수를 각각 확률분포로 바꾸고 섞는 방식을 제안합니다.
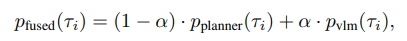
p_{\text{planner}}는 플래너 점수에, p_{\text{vlm}}은 유사도에 softmax를 적용한 분포입니다. 두 분포를 섞는 비율 \alpha는 아래와 같이 정합니다.
\alpha = \frac{\lambda}{\lambda + 1} \cdot w(\Delta t)
이 식에는 두 가지 장점이 있습니다. 첫째, \lambda를 아무리 키워도 \frac{\lambda}{\lambda+1}은 1을 넘지 못하므로, VLM이 차지하는 비율에 상한이 생깁니다. 둘째, VLM 결과가 오래될수록 w(\Delta t)가 작아지므로, 자연스럽게 플래너 쪽 비중이 커집니다. 로봇은 섞인 분포에서 확률이 가장 높은 궤적을 실행합니다.
저자들은 시뮬레이션에서 Probability Fusion이 Score Fusion보다 하이퍼파라미터에 덜 민감하다고 보고, 실제 로봇 실험에서는 이 방식을 사용했습니다.
Experiments
평가는 3가지로 합니다.
- Offline Trajectory Selection
Dataset: 도심지에서 바퀴 달린 로봇으로 인도로 주행한 데이터입니다. 한 샘플은 RGB 한장, 64개의 앵커 궤적과 플래너 점수, 그리고 사람이 실제로 간 GT로 이루어져 있습니다. 이때 궤적을 만든 플래너는 S2E를 사용했습니다
그리고 데이터는 두개의 pool에서 가져왔는데 하나는 2000장으로 이루어진 hard pool이고(캠퍼스에서 갈림길, 사람, 자전거 탄 사람, 연석등이 많은 케이스)와 3000장의 normal pool(도심지 인도 주행 케이스)입니다.
Baseline: Planner Argmax(플래너만으로 결정한 궤적), Oracle(64개의 궤적중, GT와 가장 ADE가 작은 경로)
Result: 아래 Fig2와 같이 normal, hard에서 분리해서 평가했습니다. VLM은 Gemini 3 Flash를 사용했습니다. normal에서는 Planner보다 VLM을 사용했을 때 결과가 오히려 안좋아졌습니다. 반면, semantic challenging한 hard에서는 VLM을 사용했을 때 planner보다 큰폭으로 성능 향상을 보였습니다. 이는 VLM이 edge case에는 강하지만 평범한 상황에는 과하게 생각하는 경향을 보여준다고 합니다.
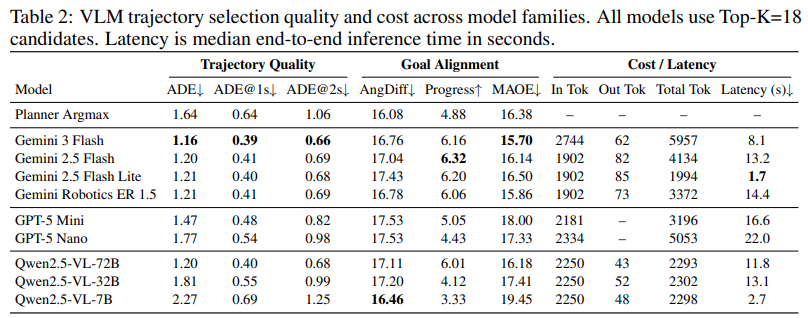
아래 Table 2는 VLM 모델에 따른 성능 차이를 보여줍니다(hard에서). Gemini 3 Flash가 전반적으로 가장 높은 성능을 보였으며, Gemini 2.5 Flash, Qwen2.5-VL-72B, GPT-5가 그나마 제일 따라왔다고 합니다. 실사용 관점에서 저자는 Gemini 2.5 Flash Lite를 저자는 추천하고 있습니다.
2. Real-World Deployment
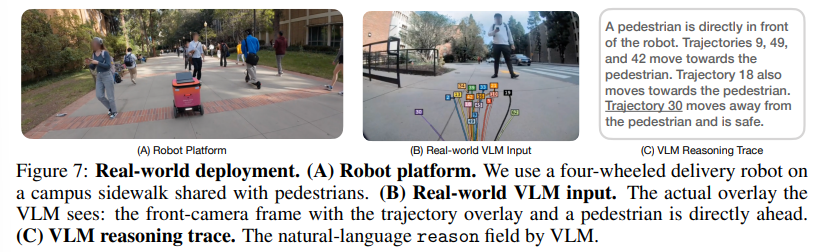
실제 주행 실험은 4륜 배달로봇을 사용했습니다. RTX 3080이 있는 노트북으로 실험했고, VLM은 Gemini 2.5 Flash Lite를 이용했습니다. 지연은 1.5s에서 3s라고 합니다.
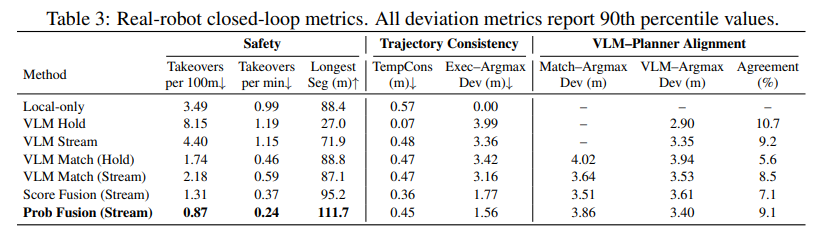
지표는 Safety, Trajectory Consistency, VLM-Planner Alignment로 크게 나눴습니다. 먼저 Stream은 응답 여부와 상관없이 1hz로 계속 요청을 보내는 거고, Hold는 요청에 대한 대답을 들은 후에 새로운 응답을 듣는 방식입니다. Stream은 더 빠르지만 부정확하고, Hold는 느리지만 정확합니다.
VLM Hold와 VLM stream은 VLM의 옛 궤적(지연 때문에 늦게 얻어진 궤적)을 실행하는 방식입니다. 둘다 Safety가 굉장히 낮을걸 볼 수 있습니다. 그리고 VLM Match는 옛 궤적을 현재 좌표계로 옮긴것과 가장 유사한걸 고르는 방식입니다. 이는 Safety를 많이 낮췄지만, 결국 fusion 방식이 압도적으로 안전한걸 확인할 수 있습니다.
저자들이 real-world를 돌렸을때 로봇이 마치 intention을 가진것처럼 움직인다고 얘기합니다. 물론 이는 저자들의 주장이기에 무조건 신뢰를 할수는 없지만, VLM의 semantic한 정보를 planner에 잘 녹여낸걸로 보입니다.
Conclusion
결국 VLM은 느려서 로봇 자율주행에 쓰기 어려운데 어떻게 할것인가?를 풀려고한 논문입니다. 논문은 이를 VLM이 늦게 오더라고 그 결과를 잘 쓰기 위한 방식을 제안했습니다. 그리고 이를 통해 유의미하게 성능도 올렸고 실주행으로 실험도 잘 보였다고 생각합니다.
그러나 결국 앞단 planner가 좋은 후보를 하나도 내지 못하는 경우가 병목이라고 저자들은 얘기하고 있습니다. 또한 개인적으로는 다른 방법론과의 비교 실험이 없는 점이 아쉽습니다.

