안녕하세요. 이번 리뷰에서는 ECCV 2026에서 접한 Long-term Action Anticipation 논문을 가져왔습니다. Long-term Action Anticipation(LTA)은 관찰된 비디오를 바탕으로, 이후에 이어질 Z개의 행동으로 이루어진 시퀀스를 예측하는 task입니다. 여기서 action은 (take, cup)과 같이 (동사, 명사) 쌍으로 표현됩니다. 보통 입력 데이터는 1인칭 비디오와 각 행동의 시작·종료 시점(segment) 및 (동사, 명사) 라벨을 포함한 annotation으로 구성됩니다. 행동 구간에 따라 나눈 과거 영상들을 입력으로 사용하고, 이후 행동들의 정답 라벨을 이용해 미래 행동 시퀀스를 예측하도록 학습합니다.
Intro
LTA 연구는 일상에서 사람의 행동을 예측한 뒤 proactive한 도움을 주고, 더 안전한 사람-로봇 상호작용에도 도움을 준다는 점에서 활발하게 연구되고 있습니다. 지금까지의 LTA 모델들은 보통 Ego4D라는 데이터셋을 사용해서 학습 및 평가를 진행했는데, 저자들은 지금까지의 방법론들이 학습 데이터에 포함된 action label만 예측할 수 있다고 주장했습니다. 이렇게 학습 데이터 기반의 action label만 예측하게 되는 환경을 closed-set setting 이라고 정의합니다.
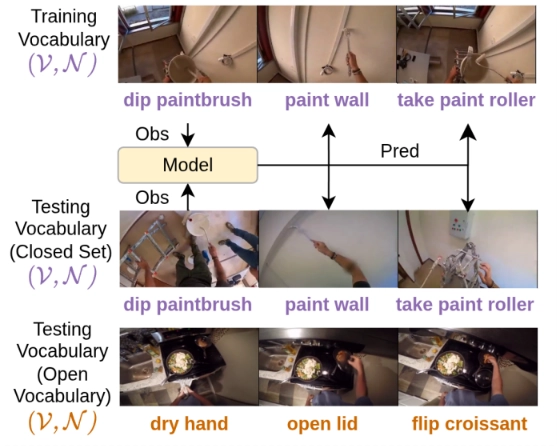
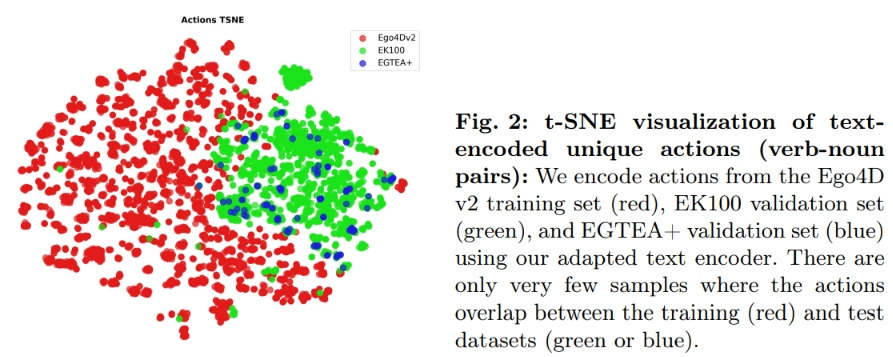
하지만 real world에서는 발생 가능한 action의 범위가 더 넓기 때문에 novel한 action class에 대한 일반화 능력을 평가하는 것이 중요하다고 강조합니다. 이러한 문제 정의에서 저자들은 LTA task에서 처음으로 OOD환경에서 모델을 평가하는 open vocabulary 평가 방식을 제안합니다. 말은 거창하지만, 쉽게 말하면 학습 데이터로 주로 활용되는 Ego4D 데이터셋 대신 unseen action class를 가진 다른 데이터셋에서도 평가해보겠다는 것입니다. 이를 위해 저자들은 모델을 Ego4D protocol에 맞추고 Ego4D 데이터셋으로 학습시킨 뒤, closed set setting(Ego4D) 환경 및 EPIC-Kitchens와 EGTEA+ 데이터셋을 통한 open vocabulary 환경을 모두 평가합니다. 참고로 EPIC-Kitchens & EGTEA+ 데이터셋과 Ego4D 데이터셋 사이에 겹치는 action class가 거의 없어 전자의 두 데이터셋이 open vocabulary eval에 사용될 수 있음을 뒷받침했습니다(Fig 2).
Open vocabulary LTA라는 새로운 task를 제안하는 만큼, 저자들은 기존의 LTA 모델을 open vocab 환경에 맞춰 개조한 뒤 평가를 진행했고 open vocabulary 환경에서는 기존 방법론들의 성능이 떨어진다는 것을 확인했습니다. 평가에 사용된 모델 중 XCLIP과 LaViLa는 비디오-텍스트 표현 학습 모델이며 본 세팅에서는 future action 별 prediction head를 도입하여 action을 예측하도록 했는데, 일관적인 future action sequence를 생성하는 데 실패했다고 합니다. 이에 Open vocabulary LTA에 맞는 아키텍처인 Multi-Horizon Cross-Attention Decoder(MHCAD)를 제안합니다. Z개의 future action을 예측하기 위해 각각의 prediction head를 두는 대신, 각 future action에 대한 learnable query를 이용하는 방식입니다. 또한 임베딩으로부터 동사/명사를 직접 예측하는 text encoder에 약간의 adaptation을 추가한 통합 아키텍처는 closed-set, open vocabulary 환경 모두에서 성능 개선에 성공했습니다.
Contributions
- 여러 개 데이터셋을 사용하여 ID, OOD 환경 모두에서 평가하는 open vocabulary 평가 프레임워크를 처음으로 제안
- closed set, open vocabulary setting 모두에 적용 가능한 MHCAD 아키텍처 제안
Task Definition
method 설명에 앞서 task 및 평가 방식 정의하고 넘어가겠습니다.
입력 비디오는 1인칭 비디오(egocentric)이며
- input : O=8개의 observed actions ([verb,noun] text pairs) {a^1, …, a^O}, 각 action에 해당하는 video segment/clip {S^1, …, S^O}
- output : Z=20개의 future action sequence
지금까지 LTA task는 Ego4D 데이터셋을 활용한 평가가 메인이었지만, action label이 train data에 포함되어 있는 closed set setting에서만 평가하게 된다는 문제가 있어 open vocabulary setting에서의 평가를 위해 EPIC-Kitchens-100 데이터셋과 EGTEA+ 데이터셋을 사용하여 평가했습니다. Open vocabulary Evaluation을 좀 더 자세히 설명드리면, LTA 모델 학습은 Ego4D v2로만 진행하고 EPIC Kitchens와 EGTEA+로 평가만 진행합니다. 원래 EPIC Kitchens와 EGTEA+는 LTA 벤치마크가 아니라 각각 next action, last action anticipation으로 action sequence를 맞춘다기보다 단일 행동을 예측하는 데 중점을 두고 평가 지표 또한 Edit Distance가 아닌 mAP나 top 5 recall을 사용했었는데, 저자들은 LTA task에 맞게 Ego4D처럼 두 데이터셋을 바꿔서 edit distance로 open vocabulary 능력을 평가했습니다.
Method
Open vocabulary Long term action anticipation을 최초로 다루는 만큼 저자들은 다양한 방법론을 개조해서 학습 및 평가했습니다. 베이스라인은 모델은 video encoder(LaViLa)에 multi-head decoder를 결합한, 기존 LTA에서 많이 쓰이던 형태의 기본 모델입니다.
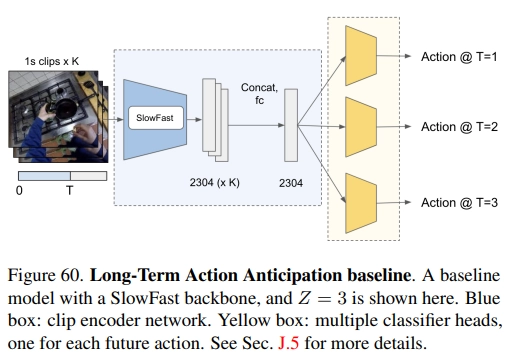
위 figure는 Ego4D 논문에서 가져온 LTA 베이스라인 모델 figure인데, 현재 논문에서 말하는 베이스라인 모델의 개념을 설명하기 좋은 그림인 거 같아 가져왔습니다. 저렇게 비디오 클립(segments)을 받아서 각각 video encoder로 인코딩하여 latent를 뽑고 fc layer를 거쳐 single latent로 만듧니다. 이 하나의 latent를 가지고 미래 n번째 행동 예측을 담당하는 head에 입력하여 action을 예측하는 구조입니다. 예를 들어 그림처럼 다음 3개의 행동을 예측해야 된다면, 1번째 행동을 예측하는 head, 2번째 행동을 예측하는 head, 3번째 행동을 예측하는 head에 동일한 latent를 입력해서 future action을 예측하게 된다는 것이죠.
저자들은 이런 아키텍처가 이 single latent를 가지고 multiple head로 예측하는 구조가 future action sequence의 일관성을 유지하는데 한계를 보인다고 지적합니다. 이를 해결하기 위해 horizon-specific query를 도입해서 각 future action을 담당하는 임베딩 벡터들을 산출하고 text encoder feature와의 유사도 계산으로 future action(text)를 예측하는 구조를 도입했습니다. 이 새로운 decoder 설계를 통해 closed set 및 open vocabulary 환경에서의 성능을 입증했습니다.
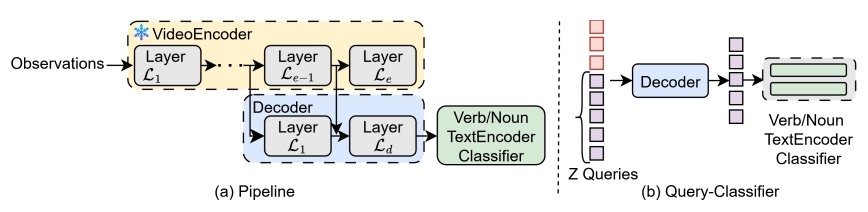
저자들이 제안하는 framework의 Fig.3 Model overview 그림입니다. frozen video encoder로 비디오를 인코딩합니다. 이때 video clip(segment)별로 입력이 되어, 클립 내에서 uniform sampling한 프레임들을 video encoder에 입력합니다. 인코딩된 정보는 T(프레임 수) x P(패치 토큰 개수) x d(feature dim) 차원의 벡터입니다. 여기서 최종 encoder output만 가져오는 게 아니라, decoder layer의 개수에 맞게 earlier layer의 output latent도 decoder로 가져가서 cross-attention에 활용합니다. Z Queries가 아까 말씀드린 horizon-specific queries인데 쉽게 말하면 예측할 미래 행동의 개수에 맞게 learnable query를 깔아둔 뒤 decoder에 입력하고, refine된 각 future action별 query를 text encoder feature와 유사도 계산해서 확률 높은 단어 텍스트를 뽑는 흐름입니다. 이때 text encoder에는 데이터셋의 동사/명사 vocabulary가 입력됩니다.
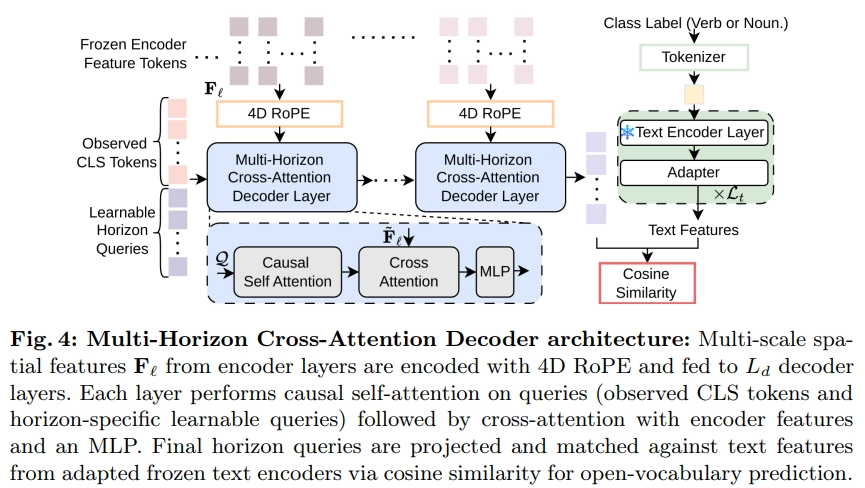
저자들이 제안한 novel decoder는 Multi-Horizon Cross-Attention Decoder(MHCAD)로, 지금부터는 decoder에서의 forward 과정을 설명드리겠습니다. 우선 decoder layer를 2개로 구성했다고 할 때, encoder의 마지막 두 개 layer의 output latent를 가져와서 각각 대응하는 decoder layer에 넣어줍니다. 이 encoder layer에서 가져온 정보는 clip별로 인코딩된 feature를 concat한 뒤 4D RoPE를 적용한 피처입니다. 수식적으로 다시 설명하면,
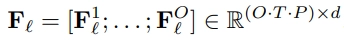
O가 observed video segments(=clips)의 개수, T가 sampled frame개수, P가 패치 토큰 개수, d가 feature dimension이라고 할 때 F_l은 각 segment에서 인코딩된 피처를 시간순으로 concat한 결과입니다. 저자들은 이 패치 토큰 기반의 피처가 CLS token보다 더 추가적인 fine-grained info를 제공하고 open vocabulary 성능에 도움을 주었다고 주장했습니다. 또한 모델이 토큰 내의 계층적인 시공간 구조를 구별할 수 있도록하기 위해, segment 순서(i), segment 내부의 시간 순서 (t), spatial location (h,w)를 고려한 4D Rotary Position Embedding을 적용했습니다. F_l의 d차원 feature vector를 4등분해서 각 파트에 i,t,h,w에 해당하는 independent한 rotary embedding을 적용했습니다.
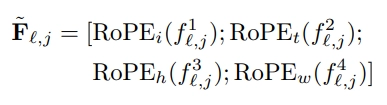
쉽게 말하면 d차원인 피처를 네 덩어리로 나눴을 때 첫 번째 덩어리를 segment 순서 관련 RoPE, 두 번째는 segment 내 시간 관련 RoPE, … 이런 식으로 넣어주었다고 보시면 되겠습니다. 이렇게 4D RoPE까지 추가한 feature는 MHCAD decoder로 전달되어 cross attention의 key,value로 활용됩니다.
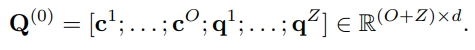
다음은 decoder에 입력되는 벡터에 대한 설명입니다. c는 encoder에서 인코딩된 후 산출된 최종 cls token인데, segment 별로 만들어졌기 때문에 O개의 cls token이 생성됩니다. q는 horizon-specific queries로 예측할 미래 행동의 개수에 맞춰 선언하여 cls tokens 뒤에 concat하여 쿼리 토큰을 구성합니다.
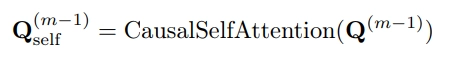
쿼리 토큰이 입력되고 MHCAD decoder layer에서는 먼저 causal self attention을 수행합니다. 시간적인 인과성 causality를 고려해서 attention 시 본인 토큰 이후의 토큰은 참고할 수 없도록 구성한 것인데, 개인적으로 cls token+learnable query로 구성된 쿼리 토큰으로 masked attention을 수행하니 cls token 단에서는 본인 이전 토큰만을 사용해서 정보를 처리하고 learnable query는 본인 이전의 action에 대한 global한 정보를 보고 이후 행동에 대한 힌트를 얻는 느낌이구나 라는 생각이 들었습니다.
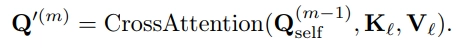
이후 쿼리 토큰과 encoder layer에서 가져온 encoder layer feature (as key, value) 간의 cross attention을 수행합니다. 이를 통해 더 fine한 정보를 가져오게 되고 이후 DropPath, LayerNorm, FFN을 거쳐 최종 horizon-specific queries를 산출합니다. 쿼리 토큰에서 cls token 쪽은 버리고 horizion-specific queries만 가져와서 text distribution으로 projection한 후 action label 예측에 사용합니다. 동사/명사 action label 예측은 모든 horizion specific query에 대해 shared prediction head를 적용합니다. 이미 각각의 행동에 해당하는 쿼리가 시공간적으로 일관적인 미래 행동 관련 정보를 담아냈으니 prediction head는 단어 예측만 잘 해라! 라는 의도가 느껴졌던 설계였습니다.
text encoder는 동사와 명사를 각각 나눠서 shared encoder를 사용하는데, 논문에선 CLIP에서 흔히 쓰이는 BERT 스타일의 transforemr architecture를 가지고 사용했습니다. 여기에 아주 간단한 수정만 추가했는데, transformer의 특정 layer 이후 lightweight bottleneck adapter module을 삽입했습니다. 정말 단순한, ResNet block 같은 lower dimension project → back to original dimension 구조입니다.
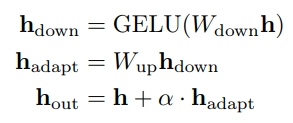
이 다음 과정은 흔히 아는 CLIP 식 feature extraction + matching 과정이라 생략하겠습니다. Loss는 CrossEntropyLoss로, 모든 미래 시점의 동사&명사 label에 대한 loss입니다. (아래 그림 참고) s가 predicion, y가 GT입니다.
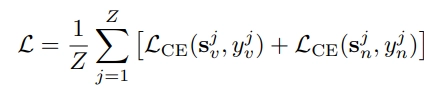
Experiments
video 및 text encoder는 frozen LaViLA-Large를 사용했고, decoder(MHCAD)의 경우 scratch로 학습시켰습니다. 위에서 말씀드린 대로 Ego4D v2 train set으로 학습을 진행했으며, 표를 확인하실 때 Ego4D 평가는 closed set setting, EPIC kitchen/EGTEA+ 평가는 open vocabulary 성능이라고 이해해주시면 되겠습니다. 평가 지표는 Edit distance로, predicted action sequence가 GT action sequence가 되기 위해서는 몇 번의 수정과정을 거쳤는지를 수치화한 후 정규화해서 나타낸 지표로, 0에 가까울수록&낮을수록 좋은 성능입니다.
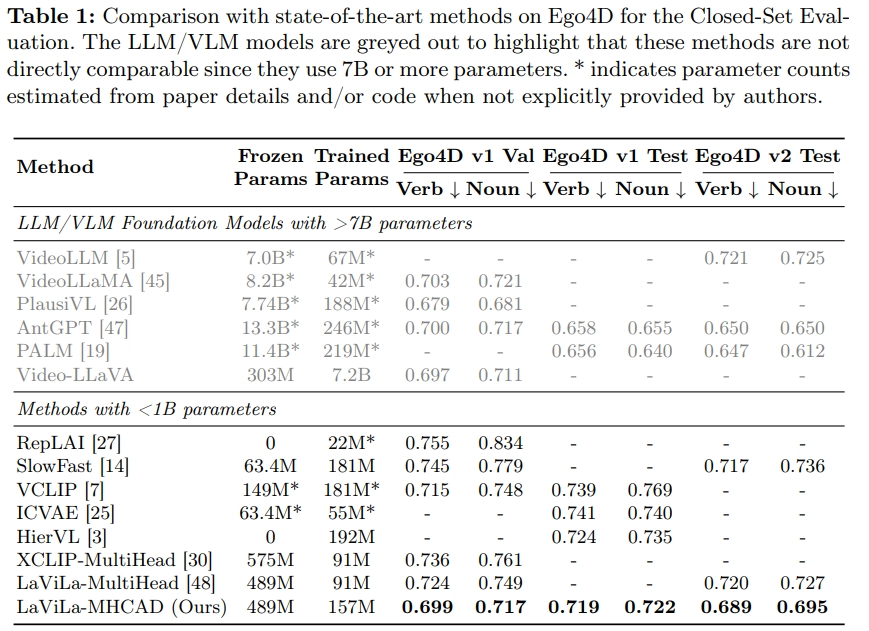
Table 1 closed set setting에서의 성능표입니다. 평가에 사용한 데이터셋이 Ego4d이긴 하나 v1 val도 있고 test도 있고 v2 test도 있고 그런데, 이전 LTA 연구들이 평가에 사용한 데이터셋이 제각각이어서 모든 평가셋을 가지고 성능을 리포팅했다고 합니다. 회색 글씨 쪽은 action anticipation에 LLM/VLM을 사용한 큰 규모의 모델들이고, 밑에 까만 글씨 모델들은 transformer 기반의 상대적으로 light한 parameter size의 모델들입니다. 저자들이 제시한 MHCAD 기반 방법론은 transformer 기반 방법론 중 closed set setting에서 가장 낮은 ED를 기록하여 좋은 성능을 보여주었습니다. 다만 fair comparison이라고 볼 수 없는 LLM/VLM 기반 모델들과 비교했을 때, 특히 근래 베이스라인 모델로 가장 많이 언급되는 AntGPT에 비해서는 많이 부족한 성능을 보여주는 것이 눈에 띄었습니다.
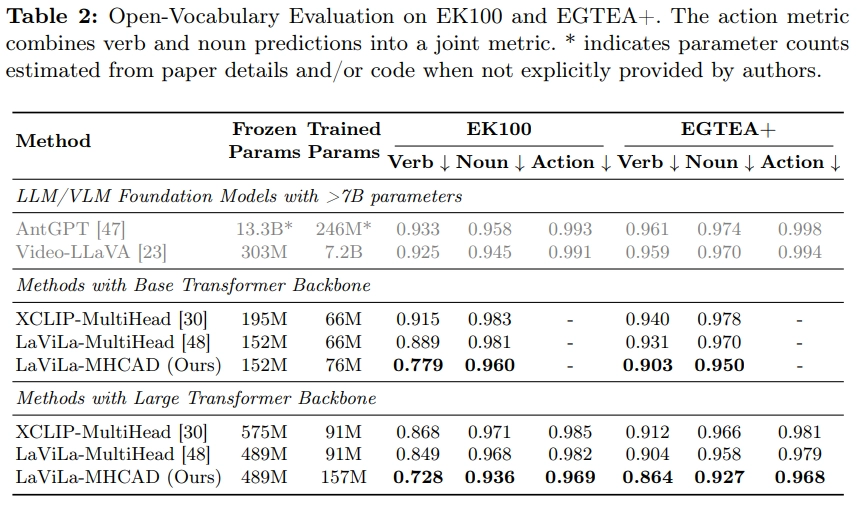
table 2 open vocabulary 평가 성능입니다. 놀라운(?) 일이 발생했는데, closed set setting에서 좋은 성능을 보여주던 AntGPT가 OV 성능에서는 0.9를 넘을 정도로 ED가 높아졌습니다. 반대로 저자들의 LaViLa MHCAD는 특히 동사에서 많은 차이를 보이며 LLM 기반 모델을 앞서는 OV 성능을 보였습니다. 하지만 저자들의 실제 베이스라인인 LaViLa-MultiHead가 이미 AntGPT와 Video-LLaVA의 성능을 앞선다는 것을 볼 수 있는데, OV setting에서는 LLM 기반 모델보다 사전학습된 비디오–텍스트 표현과 새로운 vocabulary에 대응하는 방식이 더 유효했다는 것을 의미하고 MHCAD는 OV 능력을 위한 근본적인 해결책이 아니라 단순히 더 좋은 representation을 제공하는 방법인 것 아닌가라는 생각이 들었습니다.
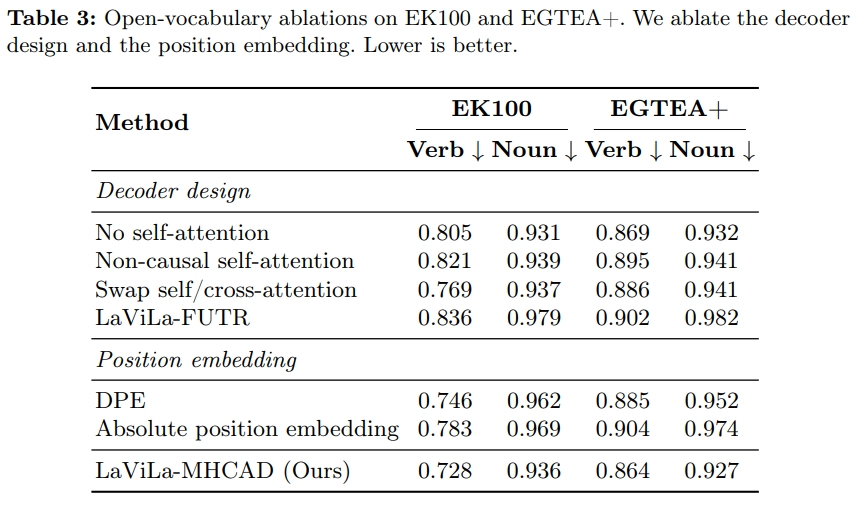
decoder design과 position embedding 설정에 대한 ablation입니다.
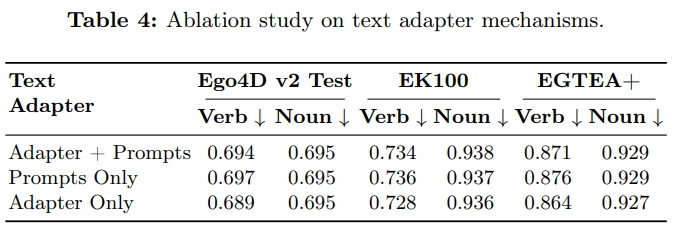
text encoder에서 bottleneck adapter 추가 및 prompt 토큰 유무에 따른 ablation입니다. 여기서 prompt는 text encoder에 ‘learnable token+action label(명사/동사)’를 입력하여 텍스트 표현을 task에 맞게 조정하는 방식인데, 결론만 말씀드리면 없는 게 나았고, adapter의 경우 prompt → adapter+prompt, adapter only 두 가지 케이스 모두 adapter 추가에 따른 성능 향상을 보여 adapter의 필요성을 입증했습니다.
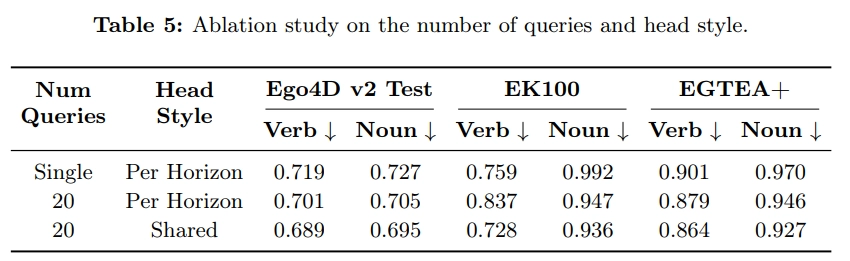
action prediction 시 single latent vs multiple latent(query), prediction head가 미래 예측 별 separate한 예측인지 shared head로 예측인지에 대한 ablation입니다.