안녕하세요. 이번에는 AdaThinkV: Adaptive Thinking for Token-Efficient Video Reasoning 논문을 읽어보았습니다. 아카이브 논문이지만, 저자가 이번 ECCV에 1,7저자로 두편 붙인 이력이 있고, 1저자가 26년도 석사시작인 것 같은데 논문수가 꽤나 있네요..
최근 Video-MLLM에서 Chain-of-Thought(CoT)를 길게 생성하면서 reasoning 성능을 높이는 방식이 많이 사용되고 있는데요. 문제는 모든 질문에 동일하게 긴 reasoning이 필요한 것은 아니라는 점입니다.
간단한 perception 문제는 바로 답해도 충분하지만, temporal ordering이나 state tracking, causal reasoning처럼 여러 단계를 거쳐야 하는 문제는 explicit reasoning이 필요할 수 있습니다.
본 논문은 여기서 모델이 질문마다 reasoning을 할지 말지를 스스로 선택하게 만들 수 있을까?라는 문제를 다룬다고 생각하면 되겠습니다.
그럼 리뷰 시작하겠습니다.
Abstract
기존 explicit CoT reasoning은 어려운 video question에서는 성능을 높일 수 있지만, 쉬운 질문에서도 불필요하게 많은 decoding token을 생성한다는 문제가 있습니다.
저자들은 이를 해결하기 위해 질문마다 explicit reasoning을 할지, 바로 answer를 생성할지 adaptive하게 선택하는 AdaThinkV를 제안합니다.
기존 adaptive reasoning 방법은 보통 question difficulty label이나 confidence threshold, 별도의 router를 이용해 reasoning 여부를 결정합니다.
AdaThinkV는 이런 별도 supervision 없이, reinforcement learning 과정에서 하나의 prompt에 대해
- explicit reasoning mode
- direct answering mode
두 가지 rollout을 함께 생성합니다. 여기서 rollout이란 한번의 샘플링을 통해 나오는 reasoning 과정과 최종 답변이라고 이해하면 됩니다.
강화학습에서 주로 쓰던 개념이 LLM 에서 GRPO 를 다루게 되면서 동시에 쓰이게 된 말인 것 같은데, 활용 예시로는 LLM finetuning 시 정답을 맞춘 생각 경로와 맞추지 못한 생각 경로중 맞춘 생각 경로로 하여금 Reward를 1 주고, 못맞춘 경로는 reward를 0을 주는 방식으로 학습할 수 있습니다.
그리고 ThinkGain이라는 지표를 이용해 explicit reasoning의 utility를 계산합니다.
ThinkGain은 단순히 reasoning했을 때 정답률이 좋아졌는지만 보는 것이 아니라, 추가적으로 사용한 response length까지 함께 고려합니다.
즉 explicit reasoning을 했을 때 얻는 accuracy gain이 추가 token cost를 감수할 만큼 가치가 있는지를 계산하는 것입니다.
또 하나의 문제는 어려운 prompt입니다.
Rollout 수가 제한되어 있으면 어려운 문제에서는 모든 response가 실패할 수 있고, 이 경우 reward variance가 거의 없어 RL signal이 사라집니다.
이를 해결하기 위해 저자들은 Variance Recovery Policy Optimization(VRPO)을 제안합니다.
VRPO는 이런 low-variance group을 버리지 않고 기존 sample을 유지하면서 rollout group을 점진적으로 확장해, 어려운 문제에서도 유효한 reward signal을 다시 확보하도록 합니다.
Inference에서는 별도의 router를 호출하지 않고, 모델이 response mode marker와 실제 answer를 하나의 autoregressive sequence에서 함께 생성합니다.
실험에서는 AdaThinkV가 평균 accuracy 40.79, 평균 output token 257.20을 기록했고, 가장 강한 adaptive baseline보다 accuracy는 2.98%p 높으면서 token은 22.7% 적게 사용했습니다.
Introduction
앞서 말했듯이 Explicit CoT는 복잡한 video reasoning 성능을 향상시킬 수 있지만, 모든 video question에서 긴 reasoning trace가 필요한 것은 아닙니다.
간단한 visual perception은 direct answer만으로 해결할 수 있지만, event ordering, state tracking, causal analysis처럼 여러 evidence를 연결해야 하는 문제에서는 multi-step reasoning이 필요할 수 있습니다.
따라서 저자들은 video MLLM이 단순히 어떻게 reasoning할지만 배우는 것이 아니라, 현재 질문에서 reasoning 자체가 필요한지도 판단해야 한다고 봅니다.
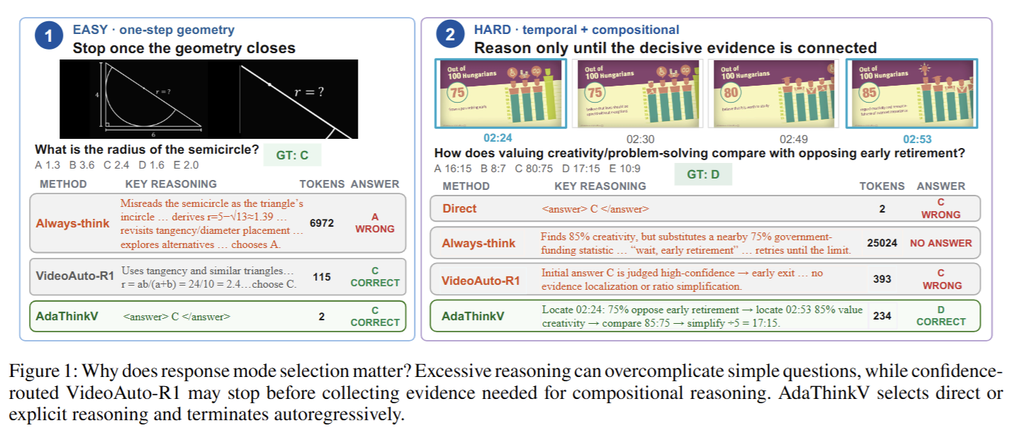
기존 adaptive reasoning 방법들은 direct mode와 explicit reasoning mode를 전환하는 다양한 전략을 사용해왔습니다.
VideoAuto-R1의 경우 이전 응답의 confidence를 이용해 reasoning 여부를 결정합니다.
하지만 저자들은 confidence가 reasoning utility를 직접 나타내지는 않는다고 지적합니다.
모델이 uncertainty가 높다고 해서 추가 reasoning이 반드시 도움이 되는 것은 아니고, 반대로 confidence가 높더라도 중요한 temporal evidence를 놓쳐 잘못된 답을 낼 수도 있기 때문입니다. 논문 전반에 걸쳐 해당 주장의 정량적 분석은 없지만, Figure1을 보게 됐을때 VideoAuto-R1가 쉬운 문제에서는 맞추지만 어려운 문제에 대해서는 초기 잘못된 주장을 높은 confidence로 하게되어 틀린 모습을 보여줍니다.
따라서 중요한 것은 단순한 uncertainty가 아니라, 추가 reasoning이 실제 accuracy를 얼마나 향상시키며, 그 향상이 추가 token cost를 감수할 만큼 가치가 있는가 입니다.
저자들은 이를 conditional net utility of reasoning으로 정의합니다. 같은 input에 대해 explicit reasoning과 direct answering을 각각 수행하고, reasoning으로 얻은 accuracy gain에서 추가 generation cost를 함께 고려하는 방식입니다.
이를 학습하기 위해 AdaThinkV에서는 각 prompt에 대해 THINK mode와 ANSWER mode의 rollout을 함께 생성하고, ThinkGain을 통해 prompt-level reasoning utility를 추정합니다.
ThinkGain은 이후
- 어떤 mode를 선택해야 하는지
- 선택한 mode에서 어떤 response를 생성해야 하는지
두 가지를 모두 학습하기 위한 supervision으로 사용됩니다.
하지만 reinforcement learning 과정에서는 또 다른 문제가 발생합니다.
특히 어려운 prompt에서는 제한된 rollout을 여러 번 생성해도 전부 오답이 나올 수 있습니다.
이 경우 같은 group 안의 accuracy reward가 모두 동일해지면서 reward variance가 사라지고, 모델이 무엇을 더 잘해야 하는지 학습할 signal이 부족해집니다.
기존 dynamic sampling 방식은 이런 zero-variance group을 제거하고 다른 prompt를 더 sampling하는 방식으로 해결하려 했습니다.
하지만 이 방식은 실제로 어려운 문제를 버리면서, reward variance가 높은 비교적 쉬운 문제만 남기는 bias를 만들 수 있습니다.
이를 해결하기 위해 저자들은 Variance Recovery Policy Optimization(VRPO)을 제안합니다.
VRPO는 어려운 prompt의 rollout group을 바로 버리지 않고 기존 sample을 유지한 상태에서 rollout 수를 점진적으로 늘립니다.
이를 통해 처음에는 전부 실패했던 문제에서도 성공 sample이나 reward variation이 나타날 가능성을 높이고, 어려우면서도 실제로 해결 가능한 prompt에서 RL signal을 확보합니다.
Inference 과정도 비교적 단순합니다.
별도의 confidence estimator나 external router를 사용하지 않고, 모델 자체가 먼저 reasoning mode를 선택하는 marker를 생성한 뒤 그 mode에 맞는 response를 이어서 생성합니다. 즉 mode selection과 response generation이 하나의 autoregressive sequence 안에서 함께 이루어집니다.
실험은 temporal reasoning, video mathematics, scientific video understanding을 포함한 여러 benchmark에서 진행됩니다.
AdaThinkV는 평균 accuracy 40.79, 평균 output token 257.20을 기록했습니다.
VideoAuto-R1-Qwen3와 비교하면 accuracy는 +2.98%p, output token은 22.7% 감소했고, Qwen3-VL-8B-Thinking과 비교하면 accuracy는 +3.66%p 높으면서 token은 95.8% 적게 사용했다고 합니다.
저자들이 주장하는 contribution은 크게 네 가지입니다.
- video reasoning에서 explicit reasoning 여부를 prompt-level utility estimation 문제로 정의하고, 별도의 difficulty label이나 confidence threshold 없이 adaptive하게 mode를 선택하는 AdaThinkV를 제안합니다.
- accuracy gain과 token cost를 함께 고려하는 ThinkGain을 제안합니다.
- 어려운 prompt에서 사라지는 reward variance를 복구하기 위한 VRPO를 제안합니다.
- 다양한 video reasoning benchmark에서 adaptive baseline과 always-thinking baseline보다 더 높은 accuracy–efficiency trade-off를 보입니다.
Method
AdaThinkV의 핵심은 크게 두 부분입니다.
첫 번째는 ThinkGain으로, 현재 질문에서 explicit reasoning을 하는 것이 실제로 이득인지 계산합니다.
두 번째는 Variance Recovery Policy Optimization(VRPO)으로, 너무 어려워서 초기 rollout에서 전부 실패한 prompt를 바로 버리지 않고 추가 exploration을 수행해 RL signal을 확보합니다.
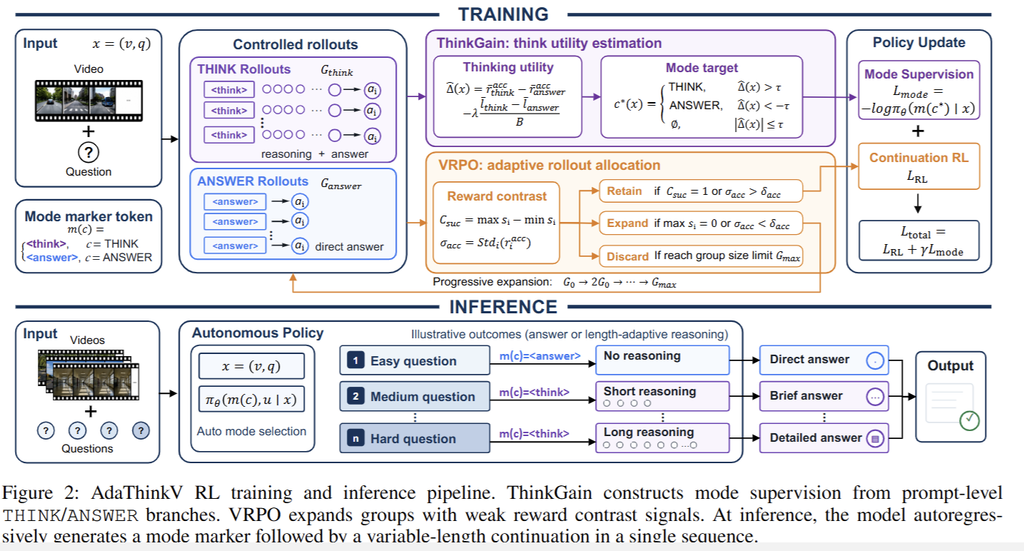
Method Overview
입력은 video와 question으로 구성되고, 모델은 두 가지 response mode 중 하나를 사용합니다.
THINK mode에서는
<think> reasoning </think> <answer> answer </answer>
형태로 explicit reasoning을 먼저 생성하고,
ANSWER mode에서는
<answer> answer </answer>
형태로 바로 답을 생성합니다.
여기서 첫 번째 <think> 또는 <answer> token이 mode marker 역할을 합니다.
즉 inference에서는 별도의 router가 따로 존재하는 것이 아니라, 모델이 먼저 <think> 또는 <answer>를 autoregressive하게 생성하면서 자신의 response mode를 직접 결정합니다.
이후 marker 뒤에 reasoning과 answer를 포함한 continuation을 생성합니다.
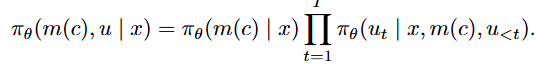
여기서 x 는 입력인 video + question, c는 mode 즉 Think 혹은 Ansewr입니다. m(c) 는 mode를 나타내는 marker이고 u는 maker 뒤에 이어지는 전체 response로 파이세타가 결국 현재 모델의 생성 확률을 뜻합니다.
뒤의 확률곱은 기존의 autoregressive LLM 과 동일하고 앞의 파이세타(m(c) 부분이 저자의 marker 선택하는 부분을 표현한다고 생각할 수 있습니다.
학습은 먼저 THINK와 ANSWER 형식이 균형 있게 포함된 데이터로 SFT cold start를 수행한 뒤 RL training으로 넘어갑니다.
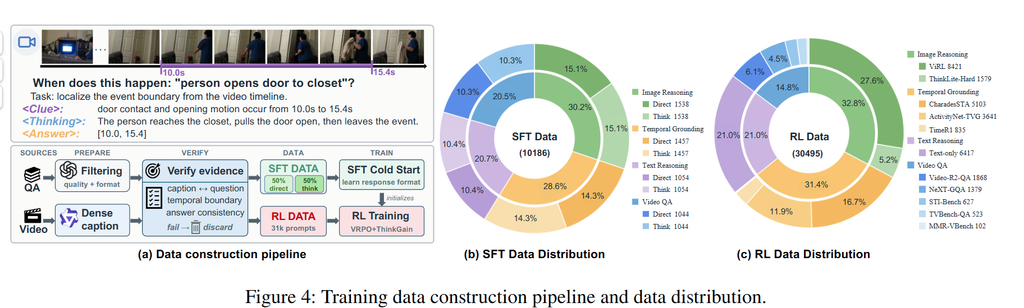
위의 Figure4를 보면 SFT 데이터로 우선 Think 와 Answer중 어떤걸 먼저 내뱉어야하는지 50대 50으로 비율을 맞춰 SFT를 진행하게되고 이후 RL 로 추가학습 한다고 생각하면 됩니다.
RL에서는 각 prompt에 대해 THINK와 ANSWER 두 mode를 모두 강제로 sampling하여 어느 mode가 더 유리한지를 비교합니다.
ThinkGain: Prompt-Level Reasoning Utility
ThinkGain의 목적은 단순합니다.
현재 prompt에서 reasoning을 하는 것이 실제로 worth it인지 측정하는 것입니다.
Controlled Rollouts
하나의 prompt에 대해 여러 rollout을 생성할 때, 일부는 강제로 THINK mode로 시작하게 하고 나머지는 ANSWER mode로 시작하게 합니다.
예를 들어 rollout group이 8개라면 THINK와 ANSWER에서 각각 일정 비율로 response를 sampling합니다.
여기서 rollout은 하나의 prompt에 대해 모델이 한 번 sampling해서 생성한 전체 response trajectory를 의미합니다.
THINK rollout이라면 reasoning trace와 final answer 전체가 포함되고, ANSWER rollout이라면 direct answer가 하나의 rollout이 됩니다.
중요한 점은 THINK와 ANSWER가 동일한 video-question pair와 동일한 decoding setting에서 생성된다는 것입니다.
따라서 서로 다른 문제의 difficulty 차이를 비교하는 것이 아니라, 같은 문제에서 reasoning을 했을 때와 하지 않았을 때의 차이를 직접 비교할 수 있습니다.
ThinkGain
각 mode에서 평균 accuracy reward와 평균 response length를 계산합니다.
그리고 THINK mode가 ANSWER mode보다 얼마나 정확도가 높아졌는지에서, 추가로 사용한 token cost를 빼서 reasoning utility를 정의합니다.
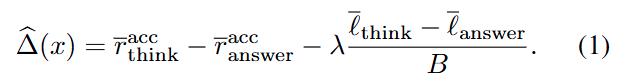
쉽게 말하면,
ThinkGain = reasoning으로 얻은 accuracy gain - 추가 token cost
입니다.
따라서 reasoning을 해서 accuracy가 조금 올라가더라도 수천 개의 token을 더 사용했다면 utility는 낮아질 수 있습니다.
반대로 비교적 짧은 reasoning으로 정확도가 크게 좋아진다면 THINK mode의 utility가 높아집니다.
저자들은 여기에 margin tau를 두고 최종 mode target을 결정합니다.
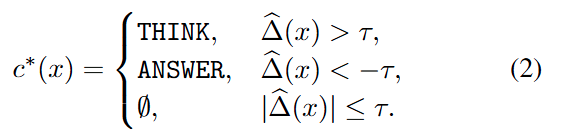
ThinkGain이 충분히 양수이면 THINK,
충분히 음수이면 ANSWER,
두 mode의 차이가 작은 경우에는 mode supervision을 주지 않습니다.
이 중간 영역을 dead zone이라고 한다네요.
ThinkGain 자체가 제한된 rollout으로 얻은 Monte Carlo estimate이기 때문에, 작은 차이까지 무조건 THINK 또는 ANSWER label로 만드는 것을 피하기 위한 것입니다.
저자들도 이것을 ground-truth difficulty label이라고 보지는 않고, 현재 policy에서 측정된 noisy utility preference라고 설명합니다.
Mode Selection Learning
여기서 조금 특이한 부분이 있습니다.
Training rollout을 만들 때 사용한 <think>와 <answer> marker는 모델이 직접 선택한 것이 아니라 강제로 지정된 marker입니다.
따라서 이 marker에 그대로 policy gradient를 걸지는 않습니다.
Forced marker는 RL loss에서 mask하고, marker 이후 continuation만 RL로 학습합니다.
대신 ThinkGain으로 얻은 mode target을 이용해 별도의 supervised mode-selection loss를 사용합니다.
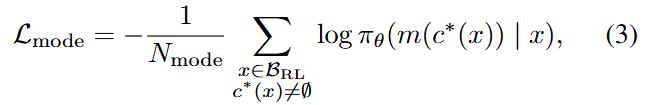
즉 학습 역할이 분리됩니다.
<think>/<answer>를 어떤 상황에서 선택할지 → Mode supervision- 해당 mode에서 reasoning과 answer를 어떻게 생성할지 → RL
이렇게 두 부분을 따로 학습하지만, 실제 inference에서는 하나의 모델이 mode marker부터 response까지 전부 autoregressive하게 생성합니다.
Variance Recovery Policy Optimization
ThinkGain이 reasoning 여부를 정하는 방법이라면, VRPO는 어려운 prompt에서도 RL signal을 확보하기 위한 방법입니다.
Figure 3에서 GRPO, DAPO, VRPO의 차이를 확인할 수 있습니다.
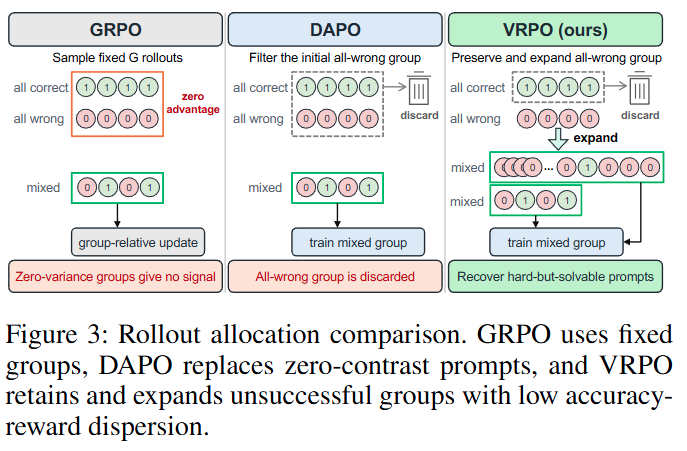
일반적인 group-relative RL에서는 같은 prompt에서 여러 rollout을 생성하고, reward가 높은 trajectory와 낮은 trajectory를 비교해 학습합니다.
예를 들어
[0, 1, 0, 1]
처럼 정답과 오답이 섞여 있다면 reward 차이가 있기 때문에 학습할 signal이 존재합니다.
반면 어려운 문제에서는
[0, 0, 0, 0]
처럼 모든 rollout이 실패할 수 있습니다.
이 경우 group 내부의 accuracy reward variance가 사라지기 때문에 어떤 trajectory를 높이고 낮춰야 할지 판단하기 어렵습니다.
GRPO, DAPO, VRPO의 차이
GRPO는 정해진 수의 rollout만 사용하기 때문에 all-wrong group에서는 사실상 유효한 signal이 없습니다.
DAPO의 dynamic sampling은 이런 zero-variance group을 버리고 다른 prompt를 sampling합니다.
하지만 이 경우 어려운 prompt 자체가 학습 데이터에서 계속 제거될 수 있습니다.
VRPO는 반대로 해당 prompt를 바로 버리지 않습니다.
기존 rollout들을 그대로 유지한 채 추가 rollout을 sampling하면서 group size를 점진적으로 확장합니다.
그 과정에서 successful response나 충분한 reward variation이 발견되면 해당 group을 training에 사용합니다.
이를 통해 저자들은 hard-but-solvable prompt를 학습 과정에 다시 포함시키는 것을 목표로 합니다.
(여기서 생각할 수 있는 단점은 어려운 문제일때 MCQ 같은 문제를 학습하는 과정이라면 random 으로 찍어서 맞춘 확률이 학습에 사용되어 노이즈가 될 수 있다고 개인적으로 생각합니다.)
Composite Reward
실제 policy update에는 answer accuracy만 사용하는 것은 아닙니다.
전체 trajectory reward는
- task accuracy
- response format
- over-length penalty
- ThinkGain에서 정한 mode와 실제 rollout mode가 일치하는지에 대한 bonus
를 함께 사용합니다.
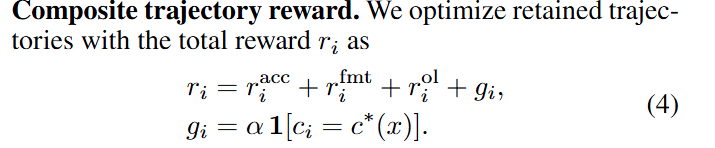
다만 여기서 중요한 점은 VRPO가 group을 retain하거나 expand할지 판단할 때는 task accuracy reward만 사용한다는 것입니다.
즉 format이나 mode bonus가 VRPO의 exploration 여부를 결정하지는 않습니다.
어떤 Group을 Expand하는가?
저자들은 단순히 all-wrong인지뿐만 아니라 accuracy reward dispersion도 같이 봅니다.
Binary VQA처럼 reward가 0 또는 1인 task라면 정답/오답이 섞여 있는지가 중요하고,
temporal IoU처럼 continuous reward를 사용하는 task라면 모든 response가 같은 success/failure 상태더라도 reward 값 자체에 충분한 차이가 있을 수 있습니다.
그래서 두 가지를 확인합니다.
첫 번째는 group 안에 success와 failure가 함께 존재하는지,
두 번째는 accuracy reward의 분산이 충분히 큰지입니다.
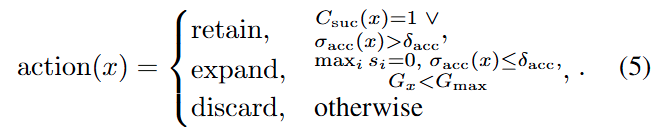
결과적으로
- 성공/실패 contrast가 있거나 reward dispersion이 충분하다 → retain
- 전부 실패했고 reward variation도 작다 → expand
- 최대 rollout budget까지 늘렸는데도 signal이 없다 → discard
가 됩니다.
즉 VRPO는 단순히 정답이 나올 때까지 무한히 sampling하는 방식은 아니고, 일정한 최대 rollout budget 안에서 reward signal이 복구될 가능성이 있는 hard prompt에 추가 sampling budget을 배분하는 방식입니다.
Group-Relative Policy Optimization
VRPO를 통해 최종적으로 retain된 group에서는 reward를 group 내부에서 normalize해 각 rollout의 advantage를 계산합니다.
즉 해당 문제에서 다른 response보다 상대적으로 reward가 높았는지를 기준으로 advantage를 만듭니다.
이 하나의 trajectory-level advantage를 해당 response의 모든 continuation token에 동일하게 적용합니다.
그리고 DAPO와 마찬가지로 clipped policy objective를 사용해 policy를 업데이트합니다.
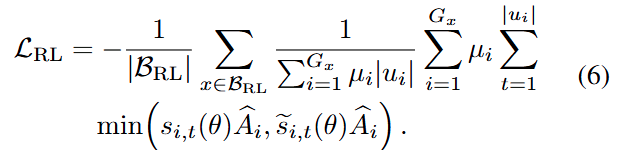
Response가 maximum token length에서 잘려버린 경우에는 hard overlong mask를 적용해 해당 completion을 policy-gradient update에서 제거합니다.
또 recovered group의 크기가 커졌다고 해서 해당 prompt가 minibatch를 지나치게 지배하지 않도록 token-level normalization을 적용합니다.
최종 objective는 continuation을 학습하는 RL loss와 mode selection loss를 합친 형태입니다.
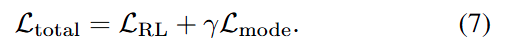
Inference
Inference에서는 training 때처럼 THINK와 ANSWER mode를 강제로 지정하지 않습니다.
Video와 question이 들어오면 모델이 먼저
<think>
또는
<answer>
marker를 직접 생성합니다.
<answer>를 선택하면 바로 짧은 direct answer를 생성하고,
<think>를 선택하면 reasoning trace를 생성한 뒤 <answer>를 통해 최종 답을 출력합니다.
Experiments
모든 table 성능은 기본적으로 Qwen3 VL 8B 모델에서 SFT 후 RL 했다고 생각하면 됩니다.
Video Reasoning
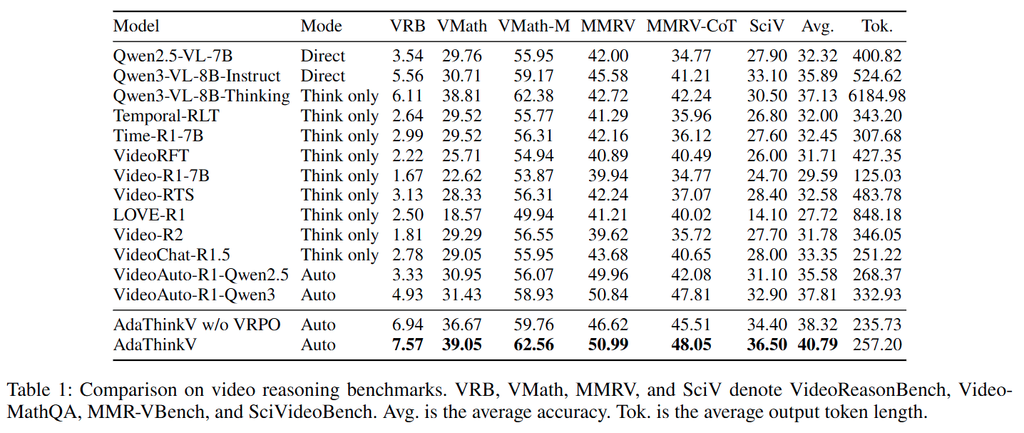
AdaThinkV는 VideoReasonBench, VideoMathQA, MMR-VBench, SciVideoBench 등 다양한 video reasoning benchmark에서 평균 accuracy 40.79를 기록했습니다.
기존 adaptive reasoning 방법인 VideoAuto-R1-Qwen3의 평균 accuracy 37.81보다 +2.98%p 높은 성능을 보였고, 동시에 평균 output token은 332.93에서 257.20으로 22.7% 감소했습니다.
Always-thinking 방식인 Qwen3-VL-8B-Thinking과 비교하면 accuracy는 37.13에서 40.79로 향상되면서, output token은 6184.98에서 257.20으로 크게 감소합니다.
즉 모든 문제에서 reasoning을 수행하는 것보다 필요한 문제에서만 THINK mode를 선택하는 것이 accuracy와 efficiency 모두에서 유리하다는 결과입니다.
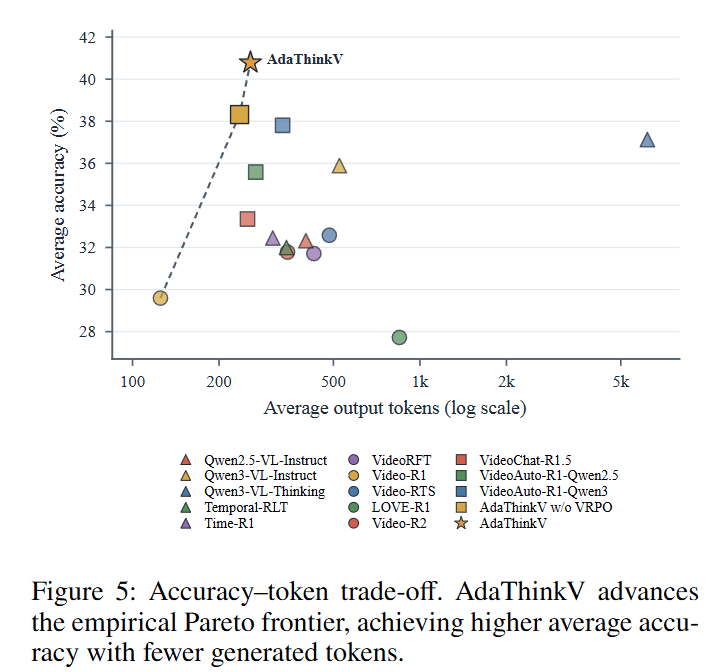
Figure 5에서도 AdaThinkV가 기존 방법들보다 높은 accuracy를 유지하면서 더 적은 token을 사용하는 Pareto frontier에 위치합니다.
General Video Understanding
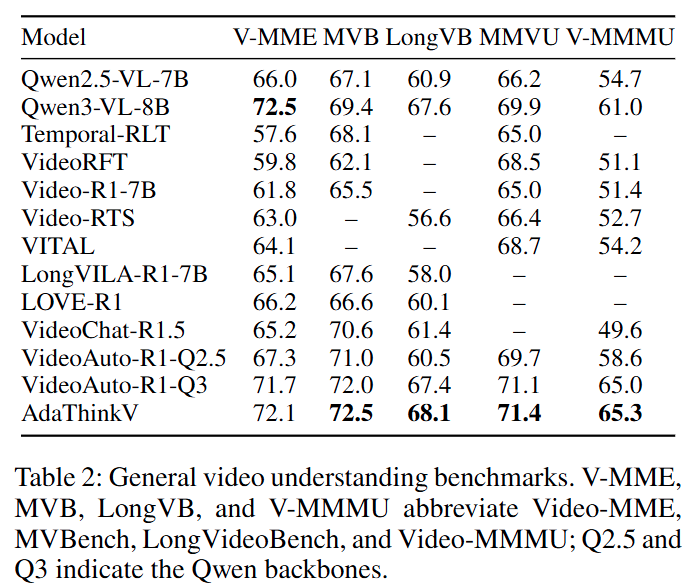
Video-MME, MVBench, LongVideoBench, MMVU, Video-MMMU에서도 AdaThinkV는 대부분의 benchmark에서 가장 높은 성능을 보였습니다.
즉 AdaThinkV의 adaptive reasoning 전략이 특정 reasoning benchmark에만 한정되지 않고 일반적인 video understanding task에도 적용될 수 있음을 보여줍니다.
Temporal Grounding and Streaming Video
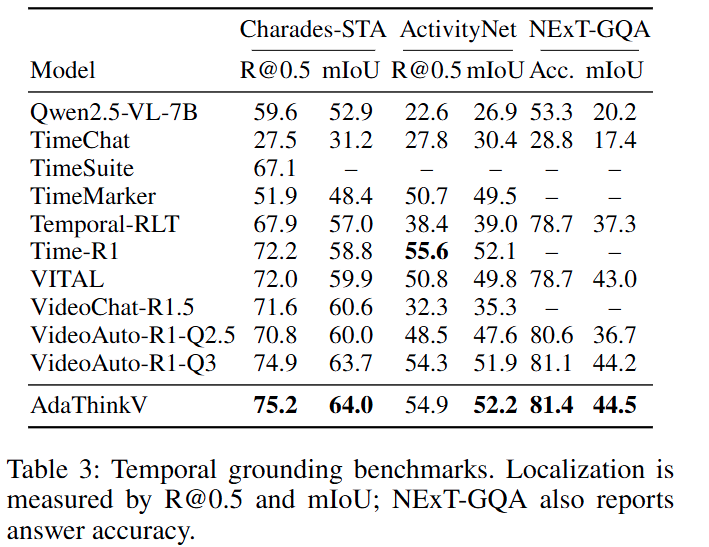
Charades-STA, ActivityNet, NExT-GQA에서도 AdaThinkV는 대부분의 temporal grounding metric에서 가장 높은 성능을 기록했습니다. 맨위 Qwen2.5 VL-7B 가 base 모델은 아니고 VideoAuto-R1-Q3와 비교하면 됩니다.
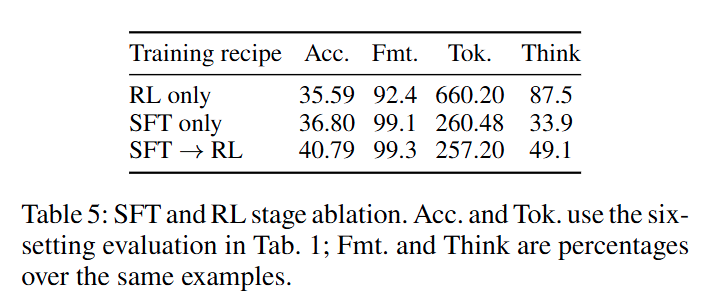
개인적으로 가장 필요하다고 생각되는 table인데 , 단순 SFT나 RL 대비 저자의 방법론이 얼마나 좋은지를 볼 수 있습니다.
SFT only에서는 accuracy가 36.80이고, RL only에서는 35.59입니다.
반면 SFT 이후 RL까지 수행한 경우 40.79로 가장 높은 성능을 기록합니다.
또 하나 흥미로운 점은 mode selection입니다.
RL only 모델은 THINK 비율이 87.5%로 지나치게 높고, 평균 token도 660.20개까지 증가합니다.
반면 SFT → RL에서는 THINK 비율이 49.1%, 평균 token은 257.20으로 크게 줄면서 accuracy도 가장 높습니다.
즉 SFT cold start는 단순히 response format을 학습하는 것뿐만 아니라, 이후 RL에서 THINK/ANSWER 두 mode를 안정적으로 활용할 수 있는 초기 policy를 만들어주는 역할을 합니다.
ThinkGain과 VRPO의 역할
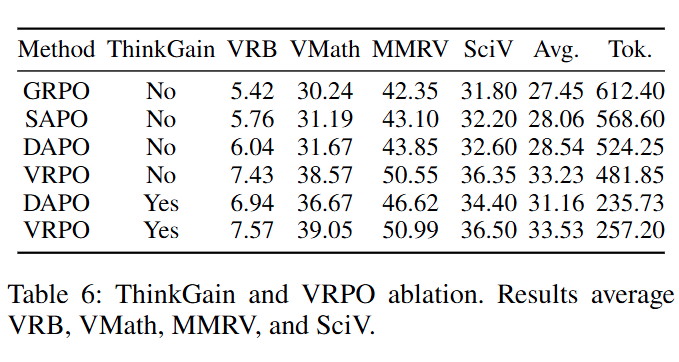
Table 6도 이 논문의 핵심 ablation입니다.
먼저 DAPO만 사용했을 때 평균 accuracy는 28.54, token은 524.25입니다.
여기에 ThinkGain을 추가하면 accuracy가 31.16으로 +2.62%p 향상되고, token은 235.73으로 절반 이하로 줄어듭니다.
즉 ThinkGain의 주된 효과는 reasoning을 언제 사용할지를 학습해 accuracy–token trade-off를 개선하는 것입니다.
반면 VRPO는 absolute accuracy를 높이는 역할이 더 큽니다.
ThinkGain이 없는 상태에서 DAPO 28.54에서 VRPO는 33.23까지 크게 향상됩니다.
ThinkGain을 고정한 상태에서도 DAPO+ThinkGain 31.16에서 VRPO+ThinkGain은 33.53으로 +2.37%p 향상됩니다.
따라서 저자들은
- ThinkGain → 불필요한 reasoning을 줄이고 mode selection을 개선
- VRPO → 어려운 prompt에서 learning signal을 복구해 absolute accuracy 향상
으로 두 component의 역할을 구분합니다.
실제로 Adaptive하게 THINK하는가?
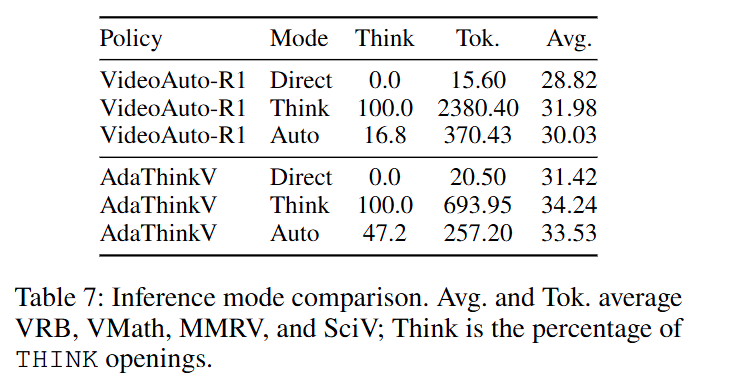
AdaThinkV를 Direct, Think, Auto mode로 각각 평가합니다.
Direct only는 평균 accuracy 31.42, Think only는 34.24, Auto는 33.53입니다.
Auto mode는 Think only보다 accuracy가 0.71%p 낮지만, 평균 token은 62.9% 감소합니다.
반대로 Direct only보다 Auto mode는 accuracy가 +2.11% 높습니다.
즉 AdaThinkV는 always-think 수준에 가까운 accuracy를 유지하면서 훨씬 적은 token을 사용합니다.
Conclusion
저자는 video reasoning에서 질문마다 explicit reasoning의 필요성을 adaptive하게 판단하는 AdaThinkV를 제안했습니다. 저자는 향후 이러한 adaptive reasoning framework를 image reasoning과 다른 multimodal task로 확장하고, 현재의 scalar accuracy reward를 넘어 generative reward model이나 rubric-based feedback을 이용한 utility estimation 및 rollout allocation으로 확장하는 것을 future work로 제시한다고 합니다.
감사합니다.