안녕하세요.
이번주에 GSV-Cities : Toward Appropriate Supervised Visual Place Recognition 논문을 읽고, 세미나 발표 대신 X-Review로 대신하게 되었습니다
Visual Place Recognition(VPR)은 주어진 query image가 어느 장소에서 촬영되었는지를 database에 저장된 이미지와 비교하여 찾아내는 task입니다. 기존 VPR에서 가장 어려운 문제 중 하나는 동일한 장소가 weather, illumination, season, traffic, occlusion, viewpoint 등에 따라 전혀 다른 모습으로 보일 수 있다는 점입니다.
이 논문이 나올 당시에 VPR 분야에서는 정확한 ground truth를 가진 large database의 부족으로 인해 어려움을 겪고 있었다는데요, 따라서 해당 논문에서는 기존 VPR 연구에서 model 뿐 아니라 training data 자체에도 문제가 존재한다고 지적하면서, VPR 분야에서 model들을 training 하기 위한 dataset에 더하여 새로운 VPR model까지 제안합니다.
즉 저자들이 제안한 새로운 dataset으로 train한다면 성능이 얼만큼 오르는지, 저자들이 제안한 model로 VPR을 했을 때 성능이 어떻게 되는지 실험해보는 논문입니다.
그럼 첫 리뷰 시작하도록 하겠습니다!
Introduction
저자들이 기존 VPR dataset에서 중요하게 보는 조건은 크게 세 가지입니다.
첫 번째는 Geographical coverage(지리적 범위)입니다. 많은 dataset이 특정 도시나 좁은 지역에 한정되어 있기 때문에 VPR 모델을 다양한 지역에 일반화가 가능하도록 학습하는 것은 충분하지 않다고 합니다. (다양한 지역에 일반화가 가능하게 하는 dataset을 저자들은 Large-scale dataset이라고 표현합니다)
두 번째는 Accurate Ground Truth입니다. 기존 Large-scale dataset들은 GPS 정보를 이용해 GT를 구성하지만(여기서부터는 GT라고 하겠습니다), 두 이미지가 있다고 할 때 촬영한 위치가 GPS 상 가깝다고 해서 반드시 동일한 장소를 바라보고 있는 것은 아니기 때문에 정확한 Positive pair(여기서 positive는 같은 장소임을 뜻함)를 구성하기 어렵고, supervised learning에 활용하기 위한 GT이기에는 한계가 있다고 합니다.
마지막은 Perceptual diversity(인식의 다양성)입니다. dataset은 viewpoint, season, illumination, structural change 등의 appearance variation을 충분히 포함해야 합니다.
저자들은 기존 dataset들이 위 3가지를 동시에 만족시키지는 못했다고 지적합니다. 특히 저자들이 집중하는 것은 정확한 GT의 부족입니다.
VPR에서 negative pair을 만드는 것은 positive pair에 비해 간단합니다. 예를 들어서 GPS 좌표가 50m 이상 떨어져 있다면 두 이미지가 서로 다른 장소라고 판단 가능합니다. 반면 positive pair을 만드는 것은 어렵습니다. 두 이미지의 GPS 좌표가 동일하더라도(매우 가깝더라도) 다른 장면을 볼 수 있기 때문입니다. 여기서 bearing(방위각), 즉 카메라가 바라보는 방향이 중요해집니다.
저자들은 이러한 문제를 해결하기 위해 GSV-Cities dataset을 제안합니다.
GSV-Cities는 Google Street View를 이용해 40개 도시에서 14년에 걸쳐 촬영된 이미지와 정확한 place label을 제공합니다. 이 내용에서 기존 dataset들과 비교해 어떤 부분들이 다른지를 더 잘 보여드리기 위해서 Related work도 설명해드리도록 하겠습니다.
Related Work
대표적으로 Nordland, Oxford RobotCar, Pitts250k/TokyoTM, Mapillary SLS(MSLS)를 설명하며 비교하도록 하겠습니다.
Nordland dataset은 동일한 기차 경로를 서로 다른 계절에 촬영하였습니다. 즉, 계절 변화를 비교할 수 있지만, 동일한 기차 경로에서 촬영되기 때문에 viewpoint나 structural variation이 제한적입니다.
Oxford RobotCar는 동일한 10km 경로를 반복 주행하면서 데이터를 수집합니다. 시간, 날씨 등의 변화를 포함하며, 3D point cloud 정보를 활용합니다. 하지만 데이터가 Oxford라는 제한된 지역에서 수집되었기 때문에 geographical coverage가 부족합니다.
Pitts250k/TokyoTM은 Google Street View panorama를 기반으로 구축했고, 많은 viewpoint variation과 정확한 GPS 정보를 포함하지만, bearing 정보가 제공되지 않기 때문에 positive pair를 정확하게 구성하기 어렵습니다.
MSLS는 전 세계 여러 도시에서 촬영한 large-scale VPR dataset이며, viewpoint, season, illumination 등의 다양한 환경 변화를 포함합니다. 하지만 많은 이미지가 차량의 전방 방향을 바라보기 때문에 도로가 이미지 중앙에 나타나는 viewpoint bias가 존재할 수 있습니다.
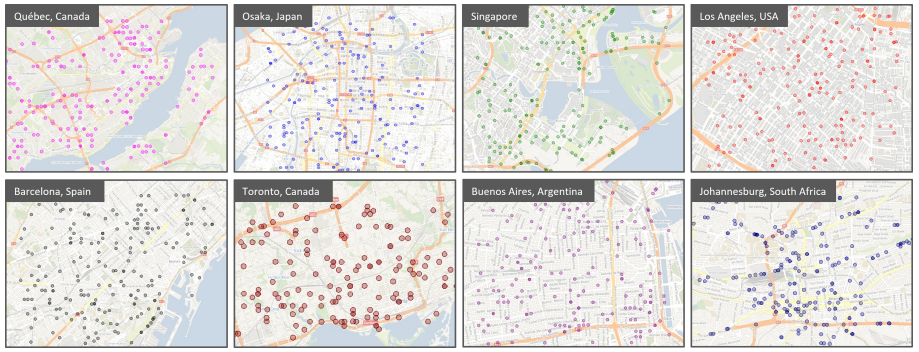
GSV-Cities는 각 도시에서 이미지를 무작위로 가져오는 것이 아니라, latitude와 longitude를 0.001° 간격으로(실제 거리 100~150m라고 함) 이동하면서 Google Street View에 query를 보내는 방식으로 data를 수집합니다.
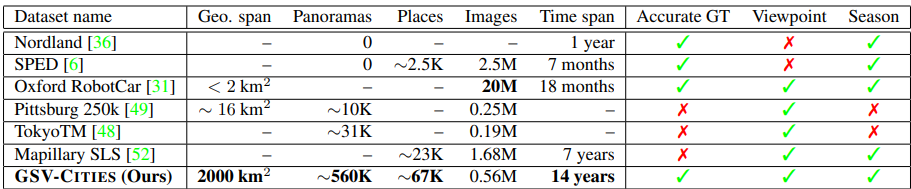
즉 GSV-Cities dataset은 모든 부분을 보완한 large-scale dataset이라고 주장합니다.
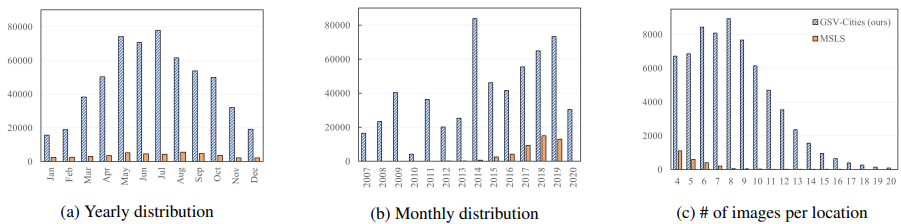
대표적으로 MSLS dataset과 distribution 부분에서 비교한 figure인데, MSLS dataset이 168만장인데에 비해 figure에서는 그렇지 않은 모습을 보입니다. 논문 전체를 확인해봐도, MSLS의 어떤 subset을 이용해 비교했는지 명확하게 나와있지 않습니다. 따라서 저자들은 해당 figure를 통해 저자들의 dataset이 MSLS dataset보다 ‘far richer and more diverse’하다고 하지만, 이 부분에서는 비판적으로 봐야할 필요가 있을 것 같긴 합니다.
Model Framework
논문에서 하나의 place는 다음과 같이 정의됩니다.
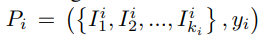
여기서 P_i는 하나의 place이고, 하나의 P 속 I 들은 모두 동일한 location을 나타내는 이미지들입니다. 즉 같은 P 내부의 I 끼리는 positive라고 볼 수 있겠습니다. 또한 y_i는 해당 place에 할당된 target label, 즉 place ID 입니다.
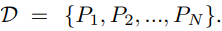
D는 여러 place의 집합으로 표현됩니다. 같은 방식으로, 서로 다른 place의 I 끼리는 negative라고 볼 수 있습니다.
우선 Model의 전체적인 Framework는 다음과 같습니다.
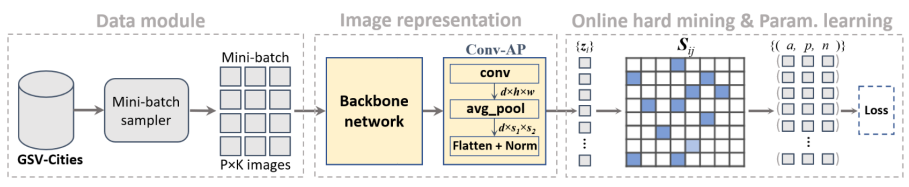
GSV-Cities의 장점은 정확한 place label 덕분에 mini-batch를 쉽게 구성할 수 있다는 점입니다.
Data module
먼저 Data module을 보면, Batch size를 정하고, P(place) 및 K(image 개수)를 선택해서 구성합니다. 따라서 하나의 batch에는 B = P * K 개의 image가 존재합니다.
Image representation
batch의 각 이미지는 먼저 CNN backbone을 통과합니다. 논문에서는 ImageNet으로 pretrain된 ResNet50을 backbone으로 사용하는데, 자세한 건 뒤의 experiment에서 설명하도록 하겠습니다.
우선 간단히 보자면 ResNet50의 마지막에는 classification을 위해 Average Pooling과 FC layer가 존재하는데, 이를 제거하고 VPR을 위한 Conv-AP layer(Convolutional Aggregation with Adaptive Pooling layer)를 연결합니다. CNN이 추출한 feature map을 global descriptor로 만드는 과정입니다. 내부를 보겠습니다.
H*W*C 형태의 feature map이 나왔다고 할 때, 먼저 conv layer를 통해 C dimension을 d차원으로 변환합니다. 이후 Adaptive average pooling layer를 통해 H*W를 원하는 크기인 S1 * S2 로 줄입니다. 마지막으로 flatten 및 normalization을 통해 하나의 global descriptor를 얻습니다. 여기서 d와 S를 조절해 원하는 descriptor 크기를 정합니다.
Similarity Matrix
Batch의 각 이미지는 그렇게 각각의 global descriptor가 됩니다. 따라서 batch에 P * K 개의 이미지가 있다면 P * K 개의 global descriptor가 만들어집니다. 이제 이 descriptor들을 서로 비교해서 similarity matrix를 구성하는데, similarity를 계산하는 방법은 논문에서는 cosine similarity라고 합니다.
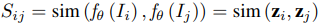
일단 그래서 matrix의 크기는 PK * PK 입니다.
Online Hard Mining
저자들은 이후에 각 이미지에 대해서 hard positive, negative를 mining하는 Hard mining을 기존에 model들이 사용하던 offline(학습 이전에) mining 대신 Online(실시간) mining을 사용합니다.
Offline mining에서는 dataset 전체를 대상으로 hard sample을 탐색해야 합니다. 또한 모델의 parameter가 학습되면서 representation이 변하기 때문에, 이전에 hard했던 sample이 학습 후에도 계속 hard하다는 보장이 없습니다.
반면 online mining은 현재 mini-batch의 forward pass에서 이미 계산된 descriptor를 이용해 on the fly, 즉 학습 도중 바로 sample을 선택합니다. 한 이미지 a (anchor)가 있다고 할 때 같은 place인데 similarity가 낮다면 hard positive로, 다른 place인데 similarity가 높다면 hard negative로 mining합니다.
Learning Loss
이렇게 정해진 (q, P, N)을 가지고 loss를 구하는데, 논문에서는 3가지 loss function을 제시하고 experiment에서 비교합니다.
1) Contrastive loss(pair loss)
positive와는 거리가 0이 되도록, negative와는 margin 이상 멀어지도록 합니다.
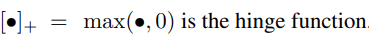
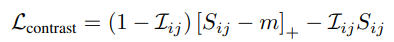
hinge function으로 인해 negative가 margin 보다 멀어지면 더 이상 loss를 주지 않습니다.
2) Triplet Margin loss
Contrastive loss랑 다르게 positive와의 거리를 0으로 만든다기보다 negative가 positive보다 margin 이상 멀리 있도록 상대적인 관계로 학습합니다.
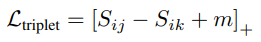
3) Multi-Similarity loss
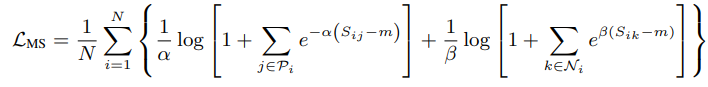
해당 loss function은 위 2가지 function과 다르게 하나의 hard positive와 하나의 hard negative만 보지 않고, 여러 informative positive/negative pair를 동시에 봅니다. 그래서 hard positive들 간 similarity가 낮다면, hard negative들 간 similarity가 높다면 loss가 크도록 설계했습니다. 여기서 hard positive, hard negative에 대한 기준은 나와있지 않아서, 아마 해당 loss function을 발표한 논문에 쓰여있을 것 같습니다. 공식 git으로도 확인해봐야할 것 같습니다.
Experiments
1) Pretrained backbone
backbone으로는 여러가지 backbone을 사용해 비교해본 후, 가장 좋은 걸 사용했습니다. (그래서 ResNet50 사용)
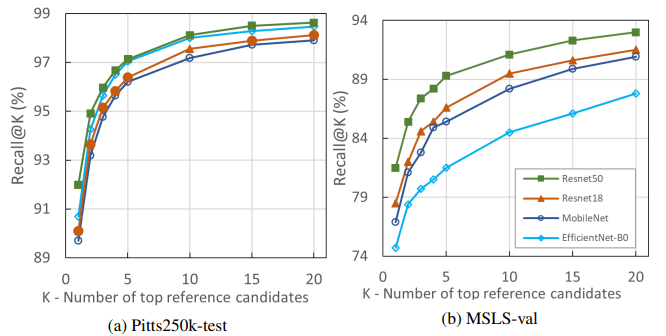
GSV-Cities dataset으로 train하고, 해당 test set들로 평가했을 떄, ImageNet으로 Pretrain된 Resnet50 backbone이 가장 좋았다고 합니다. 여기서 초기값만 ResNet50의 weight를 가져오고, 이후에는 loss function을 통해 학습된다고 합니다. 다만 여기서 어느 layer까지 freeze되고, 어느 layer부터 train 되는지는 공식 git에서 코드를 확인해야할 것 같습니다.
2) Experimental Setup
학습에 사용한 이미지 크기는 320 * 320이고, 하나의 mini batch는 100개의 place에서 각각 4장의 이미지를 선택합니다. 그래서 batch size = 100 * 4 = 400 입니다. Optimizer는 SGD를 사용하고, momentum은 0.9, weight decay는 0.001로 설정했습니다. 초기 learning rate는 0.03이고, 5 epoch마다 0.3배로 감소시키며 최대 30 epoch 동안 학습합니다.
3) 성능 비교
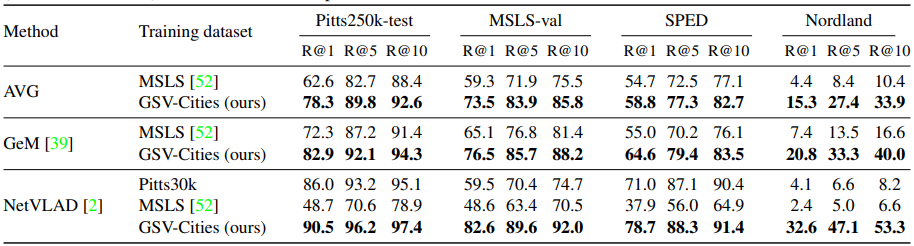
먼저 저자들은 어떤 dataset으로 모델을 학습하느냐에 따라 VPR 성능이 어떻게 달라지는지 비교합니다. 저자들은 해당 Table에서 NetVLAD를 학습시킬 때 MSLS를 통해 train하면 수렴하는데 55일이 걸리는데에 비해, GSV-Cities를 통해 train하면 8시간이 걸린다고 주장합니다. 이에 대한 이유는 MSLS는 offline mining으로 인해 오랜 시간이 걸리지만, GSV-Cities는 online mining으로 인해 훨씬 빠른 것 이라고 합니다.
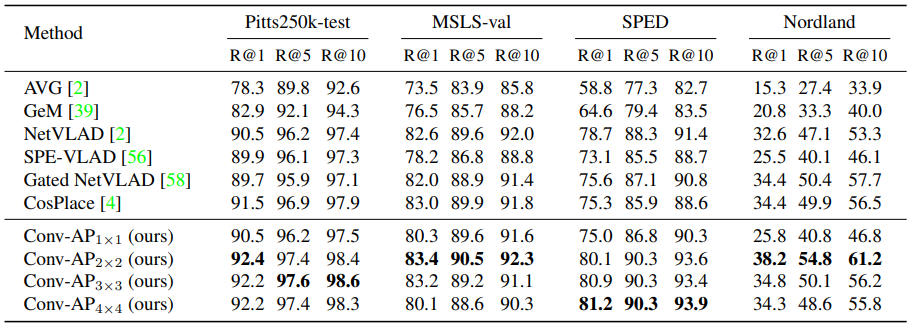
다음은 aggregation layer에 대한 실험입니다. model들은 GSV-Cities dataset을 통해 train 되었다고 합니다.
저자들은 기존 Global descriptor aggregation 방법들인 Average Pooling(AVG), Generalized Mean Pooling(GeM), NetVLAD와 저자들이 제안한 Conv-AP를 비교합니다.
여기서 Conv-AP 내에서 descriptor dimension도 함께 고려합니다.
저자들은 여기서 성능 뿐만 아니라 descriptor의 차원 면에서도 언급을 합니다. NetVLAD의 경우 cluster 수를 16으로 설정하고, backbone에서 추출한 feature의 channel dimension이 2048이라면 최종 global descriptor의 dimension은 32768 차원입니다. 반면 Conv-AP는 최종 descriptor의 크기를 직접 설계 가능합니다.
예시로 Conv512-AP2*2라고 한다면 2048 차원입니다. (논문에서는 이렇게 비교했습니다)
즉 저자들은 낮은 차원의 descriptor를 사용하면서도 성능은 더 좋다고 강조합니다.
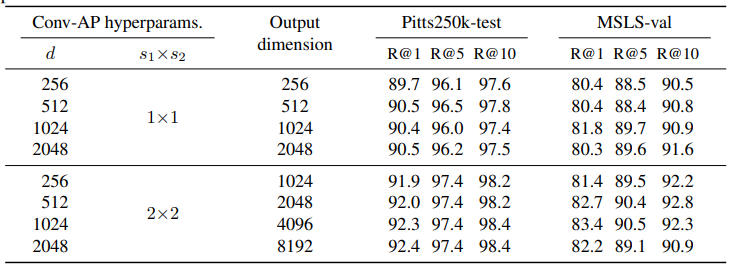
그럼 위의 table에서 d는 뭘로 설정한거냐? 라고 궁금해하실 수도 있을 것 같습니다. 결론은 논문에도 나와있지 않습니다…. 대신 저자들은 다음 table을 이것으로 제시합니다. 저자들이 해당 table을 통해 내린 결론은 무엇이냐면, “We observe that reducing the depth d does not necessarily result in lower performance.” 라는 것입니다. 그래도 해당 table을 참고해보면 위 table에서는 Conv-AP2*2 (ours)를 d = 2048로 사용한 것 같습니다.
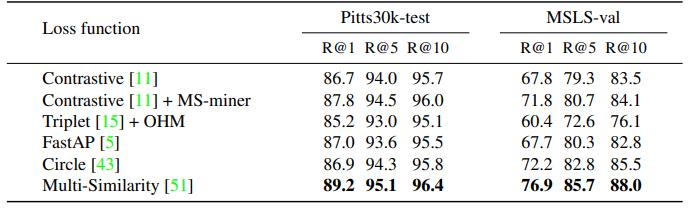
마지막으로 loss function 비교 table입니다. 다른 loss들보다 Multi-Similarity loss function을 사용했을 때 성능이 좋았음을 확인할 수 있습니다.
Conclusion
이번 논문에서는 기존 VPR의 model의 architecture도 중요하지만, 학습에 사용하는 dataset의 규모와 GT 정확도 역시 VPR 성능을 결정하는 중요한 요소라는 점을 강조하는 것 같습니다. 이를 위해서 저자들은 40개 도시에서 14년에 걸쳐서 수집된 이미지로 구성된 GSV-Cities dataset을 제안했습니다. 또한 새로운 모델도 제안했습니다.
하지만 개인적으로 아쉽다고 생각한 점도 몇가지 있었습니다.
먼저 dataset diversity를 비교하는 Figure에서 저자들은 GSV-Cities가 MSLS보다 훨씬 풍부하고 다양하다고 주장하지만, MSLS dataset을 사용해본 입장에서 해당 Figure만으로 두 dataset의 전제적인 다양성을 판단하기에는 근거가 부족한 것 같습니다. (어떤 subset인지도 언급하지 않았습니다…)그리고 online mining은 mini-batch 내에 있는 image들만을 대상으로 해서 hard positive와 hard negative를 찾습니다. 그래서 batch에 어떤 place와 image가 포함되는지에 따라서 mining할 수 있는 sample이 달라진다는 한계점이 있는 것 같습니다. (batch에 포함되지 않은 image에 더 hard 한 negative가 존재하지 않을까 라고 생각해봤습니다.)
그리고 결과 table을 확인해보면 global descriptor 기반 VPR 방법론들이랑만 비교를 한 것 같은데, 사실 이 논문이 나오기 전에 Superpoint처럼 local descriptor 기반 VPR 방법론들이랑도 비교할 필요가 있을 것 같다는 생각이 듭니다. 그 model들이 성능이 더 좋을 수 있습니다.
결과적으로 GSV-Cities는 정확한 GT를 갖춘 large-scale dataset의 중요성을 보여주고, 이를 활용한 supervised VPR 학습과 이미지를 표현하는 descriptor의 차원을 줄이면서도 높은 VPR 성능을 얻을 수 있음을 보여준 연구라고 생각합니다.
첫 리뷰라서 부족한 점이 많았을 것 같습니다… 다 중요한 내용들인 것 같아서 내용도 의도치 않게 길어지게 되었습니다. 첫 리뷰라는 점을 감안해서 이번 리뷰만 너그럽게 봐주시면 감사드리겠습니다….! 읽어주셔서 감사합니다.