안녕하세요
오늘은 M4-RAG: A Massive-Scale Multilingual Multi-Cultural Multimodal RAG라는 논문을 읽어보았습니다
이 논문은 multilingual + multimodal 환경에서 RAG가 실제로 얼마나 잘 작동하는지를 평가하기 위한 대규모 benchmark인 M4-RAG를 제안하는 논문인데요!
기존의 RAG연구가 주로 영어중심이거나 text중심이였다는 점을 모티베이션으로 다양한 언어나 문화적인 지식+이미지까지 함께 들어오는 좀 더 현실적인(?)환경에서 RAG가 실제로 잘 먹히는지, 또 어디서 생각보다 잘 안 되는지를 쭉 실험해본 논문입니다!
바로 리뷰 시작하겠습니다
INTRO
이 논문의 출발점은 VLM이 똑똑해도 자기학습 시점 이후의 정보나, 아주 지역적이고 문화적인 지식까지 다 알고 있는건 아니다!! 라는 것 입니다.
그래허 흔히 알다 싶이 외부 문서를 검색해서 같이 넣어주는 RAG가 필요해지는 것이죠!
여기서 저자들이 문제삼는건 기존 RAG연구가 주로 텍스트 중심이거나 영어중심이였다는 점 입니다!
실제 세상에는 질문이 한국어일 수도 잇고 이미지가 들어올 수도 있고 검색해야 할 문서는 다른 언어일 수도 있는거잖아요! 그래서 이 논문은 multilingual + multimodal + multicultural을 한꺼번에 놓고 보겠다고 하는 것 입니다!
조금 더 구체적으로 보면 기존 RAG 연구는 크게 multilingual RAG와 multimodal RAG 두 방향으로 발전해왔습니다
multilingual RAG는 질문과 검색되는 문서의 언어가 달라도 정보를 찾을 수 있도록 하는 것이고, multimodal RAG는 이미지, 표, 비디오 같은 다양한 modality를 retrieval과 generation 과정에 함께 활용하는 방식입니다.
문제는 이 둘은 각각 많이 연구되어 왔는데 multilingual + multimodal을 동시에 다루는 연구는 아직 상대적으로 부족했다!는 것입니다!
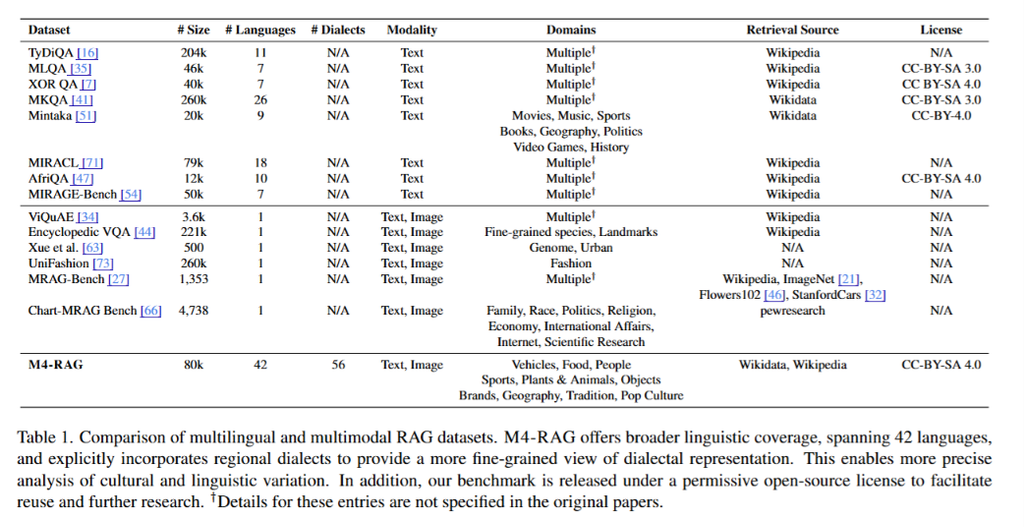
실제로 위의 table1을 보면 기존 benchmark들은 multilingual이거나 multimodal인 경우가 대부분이고, 두 가지를 동시에 대규모로 다루는 경우는 거의 없습니다
특히 multimodal benchmark들은 대부분 단일 언어 중심인 반면, M4-RAG는 80k 규모의 데이터에서 42개 언어, 56개의 dialect/register, Text+Image modality를 함께 포함하고 있습니다.
즉 이 표는 저자들이 말하는 multilingual + multimodal RAG의 연구 gap을 한눈에 보여주는 표라고 보면 됩니다!
저자들이 제안하는 M4-RAG는 새로운 생성 모델 자체라기보다는 서로 다른 언어와 모달리티 환경에서 RAG를 제대로 평가하기 위한 대규모의 benchmark/framework입니다
총 43개의 언어와 56개의 방언(register), 189개의 국가, 8만 개 이상의 image-question pair를 사용해서 실험합니다!
특히 저자들은 문화적 지식을 평가 대상으로 선택했는데 이 이유는 문화적인 정보가 long-tail하고 지역 특화적이어서 대형 모델조차 parameter 내부에 안정적으로 저장하고 있지 못하는 경우가 많기 때문입니다
즉 애초에 외부 지식이 필요한 상황을 의도적으로 구성한 것입니다!
여기서 중요한 점은 그냥 냅다 웹 검색을 붙인 것이 아니라 수백만 개의 다국어 문서를 모아 controlled retrieval environment를 만들었다는 점 입니다. 현실적인 검색 상황을 비슷하게 만들되 실험마다 검색결과가 바뀌는 문제를 줄여서 비교 가능하게 만든 것이죠!
도한 이 논문은 multilingual과 multimodal을 단순히 동시에 사용하는 데서 끝나지 않고 서로 다른 언어사이에서 retrieval이 얼마나 잘 정렬되는지, 서로 다른 modality의 정보를 얼마나 잘 연결하는지, 그리고 retrieved evidence를 VLM이 실제 reasoning에 얼마나 잘 통합하는지까지 평가합니다
따라서 retriever 성능과 generation 성능을 따로 보는 기존 평가와 달리, retrieval이 최종 VQA 성능에 실제로 어떤 영향을 주는지 end-to-end로 본다는 점이 이 논문의 중요한 포인트입니다
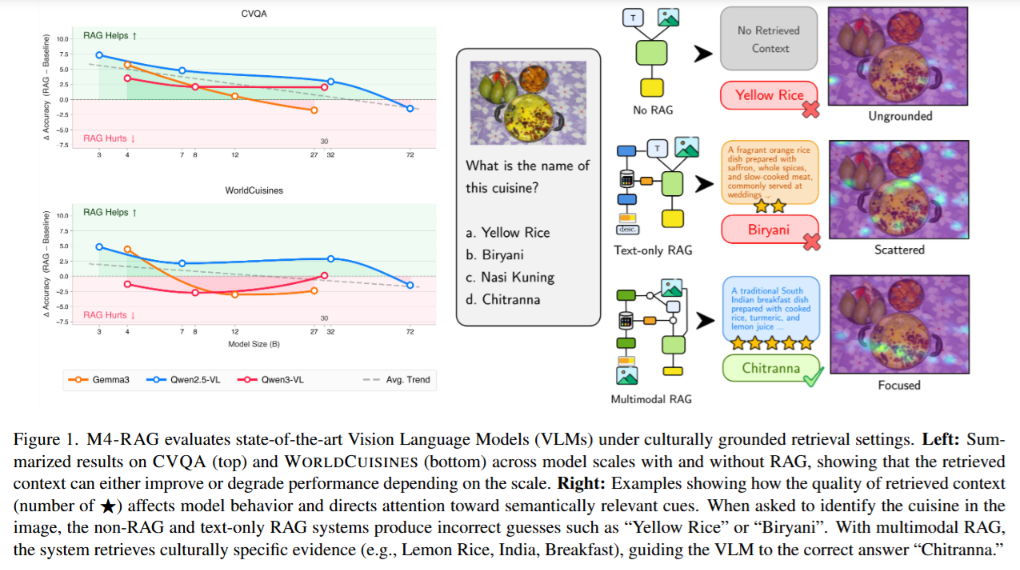
위의 fig1을 보면 논문의 아이디어를 직관적으로 볼수 있는데, 왼쪽의 그래프는 모델 크기에 따라 No-RAG와 RAG의 성능이 어떻게 달라지는지를 보여주고, 오른쪽은 실제 retrieval 사례를 보여줍니다!
예를들어 음식 이미지를 보고 어떤 음식인지 맞추는 문제에서 No-RAG에서는 모델이 단순히 이미지만 보고 Yellow Rice라고 틀리게 예측하고 Text-only RAG를 사용했을 때도 Biryani라고 틀린 답을 냅니다
반면 Multimodal RAG에서는 이미지와 질문을 함께 활용해 더 적절한 정보를 retrieval하고, Lemon Rice, India, Breakfast 같은 문화적 단서들을 가져오면서 최종적으로 정답인 Chitranna를 맞추게 됩니다
즉 단순히 외부지식을 많~이 넣어주면 된다!! 가 아니라 어떤 방식으로 retrieval하느냐에 따라 VLM이 실제로 참고하게 되는 evidence의 질 자체가 달라질 수 있다는 것 입니다!
특히 저자들은 multimodal retrieval이 모델을 semantically relevant cue, 즉 답에 필요한 시각적 단서 쪽으로 유도할 수 있다고 설명합니다
따라서 retrieval은 단순히 텍스트 지식을 추가하는 역할만 하는게 아니라, VLM이 이미지에서 무엇을 봐야하는지에도 영향을 줄 수 있다는 것이죠
저자들의 방법으로 평가한 결과, small VLM은 내부 지식 자체가 부족하기 때문에 RAG의 도움을 받아 외부 evidence가 들어오면 성능이 오른다는 것을 알수 있었습니다. 이 부분은 자명한 결과인것 같은데, 반면에 large VLM은 어떻게 됐을까요?
모델이 커질수록 RAG도 더 잘쓰지 않을까~ 싶지만 결과는 오히려 RAG효과가 줄어들거나 성능이 떨어졌습니다..!
또한 영어어가 아닌 언어로 prompt나 retrieved context를 줄 경우에도 성능이 떨어지는 결과를 보였습니다. 즉 multilingual capability가 있다고 해서 retrieval된 다국어 evidence까지 잘 통합하는 건 아니라는 것 이죠!
여기서 한가지 더 중요한 결과가 있는데 retrieval relevance가 높다고 해서 RAG가 반드시 성공하는 것은 아니다! 라는 것입니다
retriever가 정답과 매우 관련 있는 문서를 제대로 가져왔더라도, VLM이 그 evidence를 무시하고 자기 내부 지식만 믿고 답해버리면 retrieval 자체는 성공했어도 최종 RAG pipeline은 실패한 것이죠
즉 (잘 찾았는가? = Retrieval Quality)와 (찾아온 정보를 실제 답에 잘 사용했는가? = Evidence Integration)는 서로 다른 문제라는 것 입니다
따라서 RAG의 성능은 단순히 좋은 정보를 검색했는지?!로 끝나는게 아니라 모델의 사이즈나 검색 방식이나 언어가 달라지면 retrieval 정보를 실제로 활용하는 능력도 달라진다는 것이 저자들의 메시지 입니다!
M4-RAG
1. Tasks and Objectives
M4-RAG는 retriever 자체 성능만 따로 보는 것이 아니라, retrieval이 실제 최종 VQA 성능에 어떤 영향을 주는지를 end-to-end로 평가하는 framework입니다.
전체 구조는 매우 간단한데,
Question + Image + Corpus → Retriever → Top-k Documents → VLM → Answer 의 형태입니다
Retriever는 질문 q, 이미지I, 전체 corpus C를 보고 아래의 수식 1처럼 가장 관령성 높은 top-k문서 Dk를 찾고
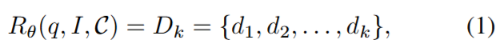
이후 VLM은 질문, 이미지, 검색된 context를 모두 이용해서 아래의 수식2처럼 최종 답변을 생성합니다!
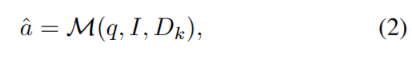
여기서 중요한 점은 검색된 문서의 언어가 질문과 같을 필요는 없다는 점 입니다!
즉 cross-lingual + multimodal retrieval이 실제 최종 VQA 성능에 어떤 영향을 주는지까지 함께 보는 구조입니다!
2. Evaluation Benchmark Source
M4-RAG에서는 새로운 VQA dataset을 직접 만드는 것이 아니라 기존의 문화적 multilingual dataset인 CVQA와 WORLDCUISINES를 사용합니다
두 dataset 모두 cultural knowledge를 기반으로 하는데, 앞에서도 말했듯 이런 정보는 long-tail하고 region-specific해서 대형 모델도 parameter 내부에 안정적으로 가지고 있다고 보기 어렵기 때문에 RAG가 정말 필요한 상황을 평가하기 적합합니다
두 데이터셋을 합치면 총42개 언어와 56개의 지역 방언을 포함합니다
[CVQA]
먼저 CVQA는 30개 국가, 31개 언어, 10개의 문화적 category에서 10k 이상의 VQA pair로 구성되어 있습니다.
WORLDCUISINES가 음식이라는 특정 domain에 집중되어 있는 반면, CVQA는 다양한 문화적 domain을 포함하기 때문에 RAG가 특정 domain뿐 아니라 여러 문화적 지식을 폭넓게 retrieve하고 reasoning할 수 있는지를 보기 위해 사용합니다
즉 간단하게 말하자면 CVQA = 여러 문화 domain에서 넓게 평가! 입니다!
[WORLDCUISINES]
다음으로 WORLDCUISINES는 세계 음식 문화를 중심으로 30개의 언어와 방언에 걸쳐 parallel하게 구성된 60k VQA pair를 포함합니다
여기서 중요한 점은 같은 semantic content가 여러 언어로 존재한다는 점인데, 덕분에 내용은 동일하게 유지하면서 언어만 바꿔 cross-lingual retrieval 성능을 비교할수 있습니다!
즉 WORLDCUISINES = 하나의 domain에서 언어 차이를 통제해서 깊게 평가!입니다!
또한 부러 잘못된 context를 주는 adversarial setting도 포함하고 있어서, 모델이 misleading information에 끌려가는지 아니면 retrieval한 factual evidence를 보고 기존의 잘못된 판단을 다시 수정할 수 있는지까지 볼 수 있습니다
3. Knowledge Base Creation
그럼 RAG에서 검색할 문서 DB를 어떻게 만들까요??
저자들은 단순히 실시간 웹 검색을 붙인 것이 아니라 실험용으로 고정된 multilingual knowledge corpus를 직접 만들어 놓고 거기서 검색합니다
이를 위해 2025년 4월 Wikipedia snapshot을 사용했는데, 이렇게 해야 실험할 때마다 검색 결과가 바뀌지 않고 여러 retriever를 공정하게 비교할수 있기 때문입니다
각 VQA sample마다 하나의 query만 사용하는 것이 아니라 Question-only / Answer-only / Culturally enriched query와 같이 여러 종류의 쿼리를 만들어 관련 Wikipedia article을 최대한 넓게 수집합니다.
예를 들어서 스시(sushi)와 관련된 샘플이라면 단순히 스시만 검색하는 것이 아니라 Japanese cuisine처럼 cultural/domain 정보를 추가한 query도 함께 사용합니다
여기서 주의할 점은 answer를 query로 사용하는 것은 실제 inference에서 정답을 미리 알고 retrieval한다는 의미가 아니라, retrieval 대상이 되는 knowledge corpus 자체를 구축하기 위한 과정이라는 점 입니다!
그리고 각 쿼리에 대해 English와 해당 target language에서 각각 독립적으로 Top-25 article을 검색합니다
단순 번역을 사용하는 것이 아니라 각 언어에서 직접 검색함으로써 실제 문화권에서 사용하는 terminology를 최대한 유지하는 것이죠!
이후 Wikipedia article을 heading 기준으로 section 단위로 나누고 불필요한 script/table/navigation 등을 제거한 뒤 중복을 제거해줍니다
이렇게 하면 최종적으로 (WORLDCUISINES: 223,468 articles), (CVQA: 306,794 articles) 규모의 knowledge corpus를 구축하게 됩니다!
Experimental Setup
1. Retrieval Settings
이제 실제 실험에서 어떤 retrieval setting들을 비교했는지를 봅니다
모든 RAG방식에서는 top-k passage를 k=5로 설정했고 총 4개의 main configuration을 사용한다고 합니다
이때 Text-Based RAG와 Multimodal RAG가 각각 2개의 방식으로 나뉘기 때문에 실제로는 모델당 총 6개의 variant를 비교합니다!
1) Baseline (No Retrieval)
가장 기본적인 setting으로, VLM에 Question + Image만 입력하고 외부 context는 주지 않습니다
즉 모델 자체의 성능을 보고 이후 RAG를 붙였을 떄 얼마나 좋아지는지 나빠지는지를 비교하기 위한 baseline입니다
2) Oracle Context
이번에는 retrieval을 하는 대신 정답과 직접적으로 관련된 완벽한 context를 VLM에 제공합니다
즉 retrieval이 완벽하게 됐다면 성능이 어디까지 올라갈 수 있을까?를 보는 upper bound setting인거죠!
WORLDCUISINES에서는 human-labeled food description을 사용하고, CVQA에는 정답 evidence가 따로 없기 때문에 Qwen2.5-VL-72B-Instruct에 Image + question + GT answer를 넣어 oracle caption을 생성합니다
이 caption의 품질도 따로 human validation했는데, 200개 sample을 4명이 평가한 결과 모두 relevance 5점 + full agreement가 나왔습니다
3) Text-Based RAG
이미지를 직접 retrieval에 사용하는 대신 caption으로 text화한 뒤 E5를 이용해 text retrieval을 해줍니다
이때 여기서는 다시 두가지 setting으로 나뉘는데
먼저 Oracle-Query RAG으로 oracle context 자체를 query로 사용하고, 거의 완벽한 text query가 있을 때 retrieval이 얼마나 잘 되는지 보는 strong reference입니다
두번째로 Caption-Query RAG으로 Qwen2.5-VL-72B로 Image + question에서 caption 생성한 뒤 question + caption을 query로 문서 retrieval을 해줍니다. 쉽게 말하자면 이미지를 text로 변환해서 검색하는 기존 방식입니다
4) Multimodal RAG
이번에는 이미지 정보를 텍스트로 변환하지 않고 question + image를 직접 같이 사용해서 retrieval해줍니다!
여기서는 multimodal enbedding model로 mmE5 (11B)와 B3 (7B, VLM2Vec)를 사용합니다!
(두 모델에 대한 정보는 하이링크로 걸어두겠습니다! 궁금하신 분들은 참고하세용)
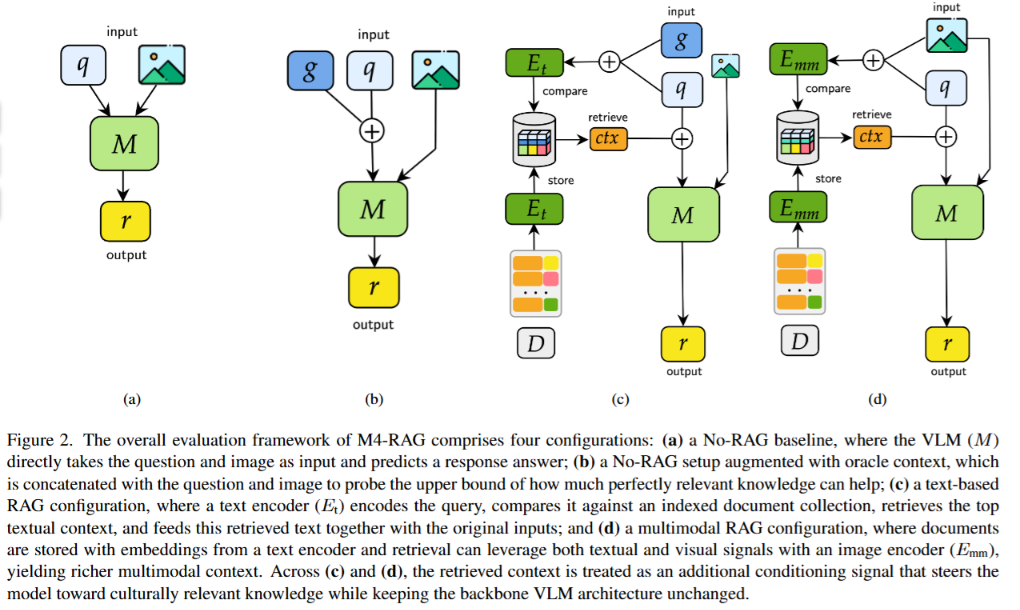
위의 Fig 2는 위 4개의 setting을 한눈에 보여줍니다!
(a) No-RAG :question + Image → VLM
(b) Oracle :question + image + perfect context → VLM
**(c) Text RAG :**이미지를 text로 바꿔 text encoder로 retrieval
(d) Multimodal RAG :question + image의 textual/visual signal을 함께 이용해 retrieval
여기서 중요한 점은 RAG setting에서도 backbone VLM 자체를 수정하는 것이 아니라, retrieved context를 추가 conditioning signal로 넣어주는 구조라는 것 입니다!
2. Other Experimental Settings
1) Vision Language Models
실험에는 총 4개의 open source multilingual VLM을 사용합니다
- Gemma3: 4B / 12B / 27B
- Qwen2.5-VL: 3B / 7B / 32B / 72B
- Qwen3-VL with reasoning: 4B / 8B / 30B-A3B
- Pangea: 7B
여기서 같은 model군 이라도 여러 scale을 사용하는 이유는 모델 크기에 따라 RAG효과가 어떻게 달라지는지를 보기 위해서 입니다!
2) Multilingual VQA
또한 언어가 VQA 성능에 어떤 영향을 주는지를 보기 위해 두 가지 multilingual setting을 만듭니다
먼저 Multilingual Prompts는 전체 instruction prompt를 각 target language로 번역하는 것이고, English prompt baseline과 비교해서 native-language instruction이 성능에 어떤 영향을 주는지 확인합니다
두번째로 Multilingual Oracle Context는 oracle context를 target language로 번역한 것이고 English context와 비교해서 evidence가 해당 문화권의 언어로 제공되었을 때 더 잘 활용하는지 확인합니다
(이때 번역은 Gemini-2.5-Flash를 사용했고, 이후 annotator가 직접 검증했다고 합니다)
여기서 중요한 점은 prompt language와 context language를 따로 바꿔본다는 점인데
나중에 성능이 떨어졌을때 단순히 instruction-following 문제인지 아니면 non-English evidence integration 문제인지를 구분해서 볼 수 있습니다
3) Evaluation Metrics
최종 VQA 답변은 multiple-choice 기준 macro-averaged accuracy로 평가합니다
그리고 retrieved context의 relevance처럼 별도의 annotation이 필요한 경우에는 reasoning rubric 기반 VLM-as-a-judge를 사용합니다!
Results and Analysis
1. main result
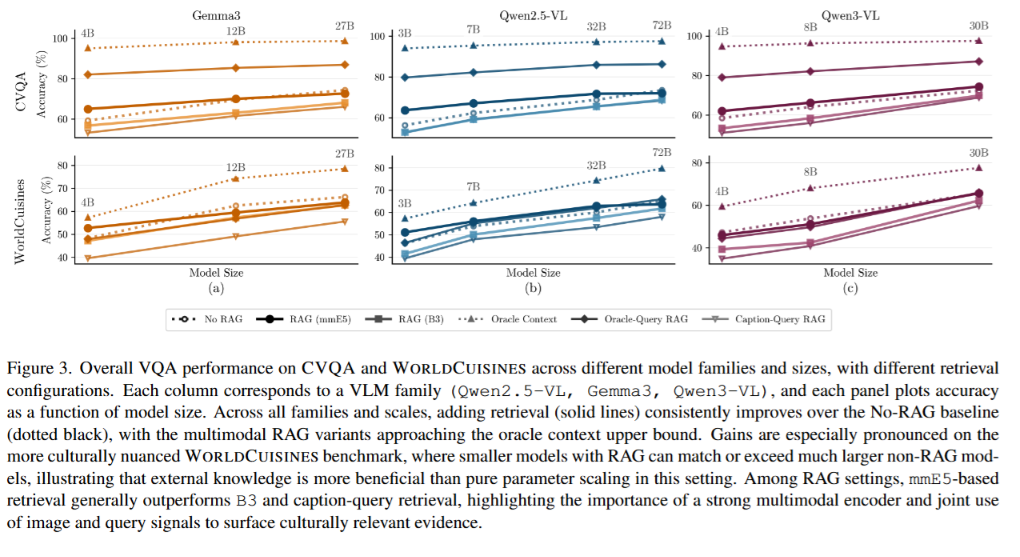
먼저 전체적인 성능의 위의 fig3처럼 확인할 수 있는데 CVQA와 WORLDCUISINES에서 model family / model size / retrieval setting에 따라 VQA 성능이 어떻게 달라지는지를 보여줍니다
먼저 No-RAG baseline에서는 Gemma3 27B가 CVQA와 WORLDCUISINES 모두에서 가장 높은 성능을 보이는 것을 확인할 수 있습니다
예상했던것 처럼 정답이랑 직접적으로 관련되어있는 Oracle Context가 모든 model 데이터셋에서 가장 높은 성능을 보였는데 이는 retrieval이 완벽하게만 된다면 외부 knowledge가 VLM 성능에 큰 도움을 줄 수 있다는 것을 보여주는 upper bound가 됩니다
이때 retrieval strategy를 비교하면 흥미로운 결과가 나오는데 Text-Based RAG가 가장 낮은 성능을 보였고 심지어 No-RAG baseline보다 성능이 떨어지는 경우도 많았습니다!
저자들은 이미지 정보를 caption으로 text화 하는 과정에서 비주얼 정보가 손실되거나 노이즈가 추가될수 있기 때문이라고 해석합니다
반면에 Multimodal RAG는 Text-Based RAG보다 일관되게 높은 성능을 보였고 그 중에서도 mmE5가 B3보다 전반적으로 더 좋은 결과를 보였습니다!
즉 이미지가 함께 있는 환경에서는 이 이미지를 억지로 text로 바꿔 retrieval하기보다는 image + text signal을 직접 함께 사용하는 multimodal retrieval이 더 효과적이라는 것 입니다
또한 reasoning VLM이 비슷하거나 더 큰 non-reasoning VLM보다 RAG 환경에서 더 높은 성능을 보였는데, 저자들은 이 부분에 대해서는 reasoning capability가 retrieved context를 더 잘 integration하는 데 도움을 주기 때문이라고 설명합니다!
그냥 간단하게 말하자면 핵심은 결국 좋은 external context는 분명 도움이 되지만, 어떤 방식으로 retrieve하느냐와 VLM이 그 context를 얼마나 잘 활용하느냐에 따라 RAG 성능이 크게 달라진다!! 라고 보면 됩니다
2. Result about Model Scaling
다음으로는 모델 크기에 따른 RAG효과를 살펴볼건데 앞서 살펴봤던 fig3을 모델 scale 관점에서 다시 보겠습니다
위의 그림에서 바로 볼수 있다 싶이 모델이 커질수록 VQA성능 자체는 좋아지지만 RAG benefit까지 같이 커지지는 않는걸 확인할수 있습니다
Text-based RAG는 전반적으로 scaling이 잘 되지 않았고, multimodal RAG도 작은 모델에서는 성능 향상이 뚜렷하지만 큰 모델로 갈수록 그 차이가 줄어들어 No-RAG가 RAG와 비슷하거나 더 높은 경우도 나타났습니다. 저자들은 Reasoning VLM은 이런 현상에 상대적으로 더 robust했지만, 전체적으로는 모델이 커질수록 external context 의존도가 감소했다고 말합니다
저자들은 이 부분에 대해서 model scale과 retrieval utility 사이의 tension이라고 설명하면서 강한 parametric knowledge가 retrieved evidence와 상호보완되기보다는 오히려 서로 충돌하거나 경쟁할수 있다고 해석합니다
3. When Does RAG Succeed and Fail?
그럼 RAG가 정확히 언제 성공하고 실패할까요?
요번에는 단순 accuracy가 아니라 retrieval quality가 실제 RAG success/failure에 어떤 영향을 주는지를 분석합니다!
저자들은 두가지 metric을 사용하는데 (Correctness Retention: 원래 맞았던 답이 RAG 이후에도 그대로 맞는 비율)과 (Correction Rate: 원래 틀렸던 답이 RAG 이후에 맞게 수정되는 비율)을 사용합니다!
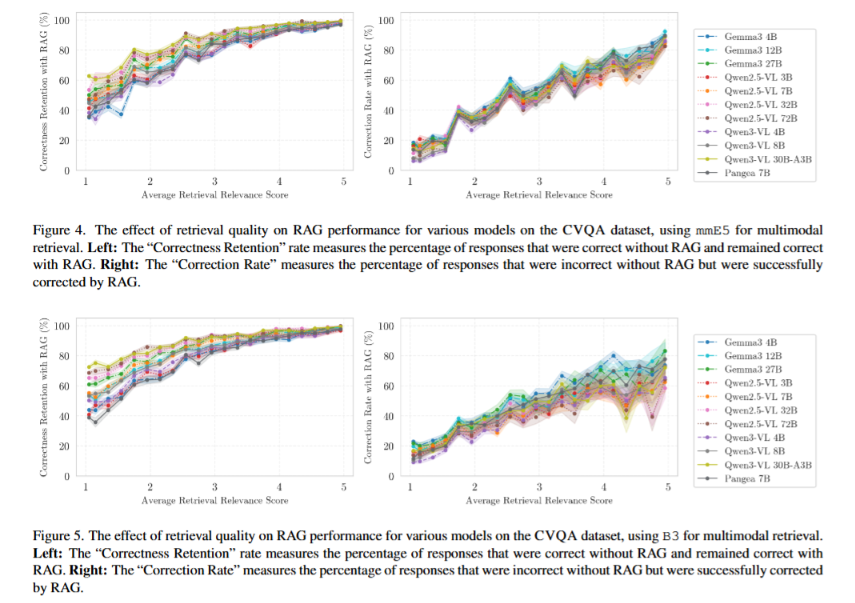
먼저 위의 fig4는 mmE5에 대한 실험이고 fig5는 B3에 대한 실험 결과 입니다.
결과적으로 두 fig 다 retrieval relevance가 높아질수록 성능이 좋아지는 경향을 보입니다
또한 이러한 차이는 mmE5보다 B3에서 더 크게 나타났는데 저자들은 weaker retriever일수록 모델별 context integration 능력 차이가 더 크게 드러난다고 해석합니다!
먼저 Correctness Retention은 retrieval quality가 낮을 경우 relevance score 2 이하에서 40~60%까지 떨어졌고, 저자들은 이 부분에 대해 irrelevant context가 원래 맞던 답까지 망칠 수 있다는 것을 보여준다고 합니다.
반대로 relevance가 높아지면 retention은 95~100%에 가까워집니다! 하지만 Correction Rate는 조금 다른데 High-relevance context를 줘도 약 80~90% 수준까지 올라갈 뿐 완전히 수렴하지는 않았고 모델별 차이도 크게 계속 크게 남아있는 것을 볼수 있습니다
즉 좋은 evidence를 가져왔다고 해서 모델이 반드시 기존의 틀린 답을 수정하는것은 아니다!! 라는 것 입니다
또한 큰 모델은 원래 맞던 답은 더 잘 유지하지만 좋은 좋은 evidence를 줘도 기존의 틀린 답을 상대적으로 덜 수정하는 모습을 보였다고 합니다
저자들은 이 부분에 대해 inertial priors라고 설명하는데 model scale이 커질수록 내부 belief가 강해져서 external context에 의해 쉽게 업데이트되지 않는 것이라고 합니다
결국 큰 모델은 bad retrieval에는 덜 속지만 good retrieval에도 덜 설득된다!!라고 보면 된다고 합니다!
4. Multilingual Performance Gaps
마지막으로 언어가 바뀌면 VLM의 RAG 성능이 어떻게 달라지는지 확인합니다!
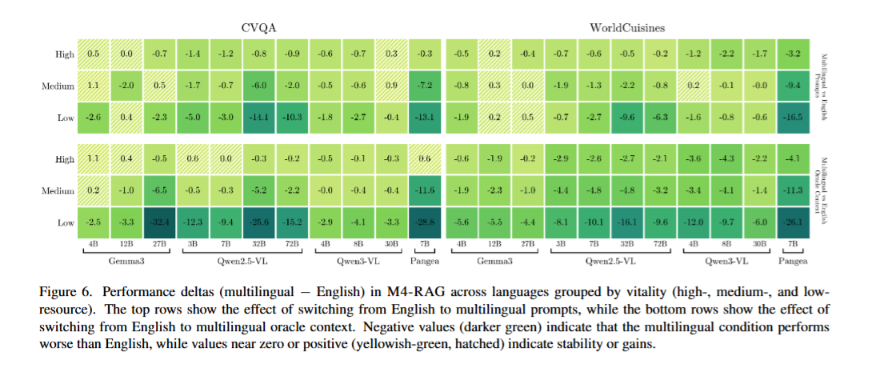
위의 fig6은 English setting을 기준으로 multilingual setting으로 변경했을 때의 performance delta를 보여줍니다
위쪽은 English Prompt → Multilingual Prompt이고 아래쪽은 English Oracle Context → Multilingual Oracle Context로 바꿨을 때의 결과입니다
먼저 prompt를 target language로 바꾸면 전반적으로 성능이 떨어지는 것을 볼수 있고
high-resource language에서는 약 -1~-2% 정도로 비교적 작았지만 low-resource language로 갈수록 성능 저하가 커지는것을 확인할 수 있습니다
여기서 더 큰 문제는 context language였습니다! English oracle context를 target language로 바꾸자 성능이 훨씬 크게 떨어졌고, 일부 low-resource setting에서는 -30% 이상의 성능 하락도 나타났습니다
즉 VLM은 non-English instruction 자체는 어느 정도 처리할 수 있지만, retrieved evidence 자체가 non-English일 경우 이를 reasoning에 통합하는 데 훨씬 더 큰 어려움을 겪는다는 것입니다!
따라서 저자들은 단순한 instruction-following보다 cross-lingual evidence integration이 더 큰 bottleneck이라고 해석합니다!
또한 multilingual/multicultural data로 학습된 Pangea에서도 큰 성능 저하가 나타났는데 이는 단순히 multilingual data를 학습했다고 해서 non-English retrieved context를 잘 활용하게 되는 것은 아니라는 것을 보여줍니다
그리고 이 실험에서도 model scale에 대한 결과를 볼수 있는데 역시 모델 크기가 크다고 이 문제가 해결되는 것도 아니였습니다. 오히려 작은 모델은 target language prompt를 받아도 영어로 code-switch하는 경우가 있어 성능 하락이 상대적으로 작았고 큰 모델은 큰 모델은 target language로 끝까지 답하려다 더 크게 실패하는 경우가 나타났습니다
결국 multilingual capability가 있다고 해서 cross-lingual evidence integration까지 잘 되는 것은 아니다! 라고 볼 수 있습니다.
Conclusion
정리해보자면 논문의 핵심은 생각보다 단순합니다
RAG는 좋은 정보를 retrieve하는 것만으로 끝나는게 아니라, 그 정보를 VLM이 실제 reasoning에 잘 활용할 수 있어야 한다!!라는 것 입니다
작은 모델은 RAG의 도움을 많이 받았지만 큰 모델은 자기 parametric knowledge에 더 의존하면서 좋은 evidence가 들어와도 기존 답을 잘 수정하지 않았고 non-English context를 활용하는 데에도 큰 한계를 보였습니다
따라서 저자들은 앞으로 단순한 relevance 기반 retrieval보다 VLM이 실제로 잘 활용할 수 있는 evidence를 가져오는 model-aware retrieval이 필요하다~~라고 주장하는 것 입니다
개인적으로는 잘 찾는 것이랑 찾아온걸 실제로 쓰는 것이 완전히 다른 문제라는 점이 흥미로웠는데 failure를 잘 보여주긴 했다만 그래서 이걸 어케해결하는건데? 하는 부분은 그냥 후속연구로 남겨둔(?)느낌입니다



안녕하세요 찬미님 좋은 리뷰 감사합니다.
1. Multimodal RAG라고 했는데, 실제로 retrieval되는 context 자체에도 이미지가 포함되는 건가요? 아니면 query를 만들 때만 question과 image를 같이 사용하고, 최종적으로 가져오는 evidence는 text passage인가요?
2. Retrieval quality를 1~5점으로 평가했다고 했는데, 이 relevance score는 정확히 어떤 정보를 보고 매긴 건가요? Query와 image만 보는 건지, 실제 ground-truth answer까지 judge에게 제공하는 건지도 궁금합니다.
감사합니다.