- Venue: Arxiv 2026
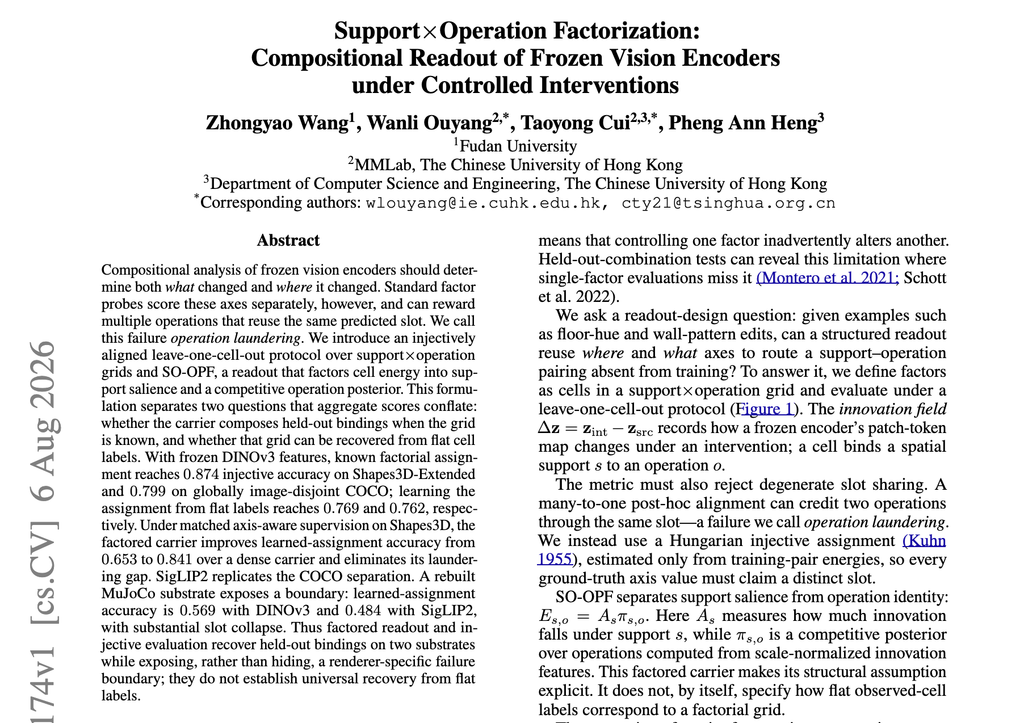
- Authors: Zhongyao Wang, Wanli Ouyang, Taoyong Cui, Pheng Ann Heng
- Affiliation: Fudan University, MMLab (The Chinese University of Hong Kong)
- Title: Compositional Readout of Frozen Vision Encoders under Controlled Interventions
1. Vision Encoder는 정말 Compositional할까?
최근 DINOv3나 SigLIP2와 같은 Vision Encoder들은 이미지의 객체, 위치, 속성 등 다양한 정보를 상당히 잘 표현한다고 알려져 있습니다. 그렇다면 여기서 한 가지 질문이 생깁니다. 이러한 정보들이 서로 조합 가능한 형태로 representation 안에 저장되어 있을까요?
예를 들어 이미지의 Object 영역과 색을 반전시키는 Invert라는 변화를 생각해보겠습니다. 모델이 학습 과정에서 Object도 본 적이 있고, Invert라는 변화도 본 적이 있다고 해봅시다. 그렇다면 Object × Invert라는 조합을 한 번도 본 적이 없어도 이를 알아낼 수 있을까요?
저자들은 바로 이 능력을 visual representation의 compositionality 라고 봤다고 합니다. 그리고 이를 조금 더 명확하게 분석하기 위해, 이미지에서 발생하는 변화를 두 가지 factor로 나누었습니다.
- Support (Where): 변화가 어디에서 발생했는가?
→Floor,Wall,Object - Operation (What): 해당 영역에 어떤 변화가 발생했는가?
→Hue,Invert,Pattern
즉 하나의 visual factor를 단순히 Invert라고 보는 것이 아니라, \text{Support (Where)} \times \text{Operation (What)} 처럼 어디가 어떻게 변했는지의 조합으로 정의한 것이죠
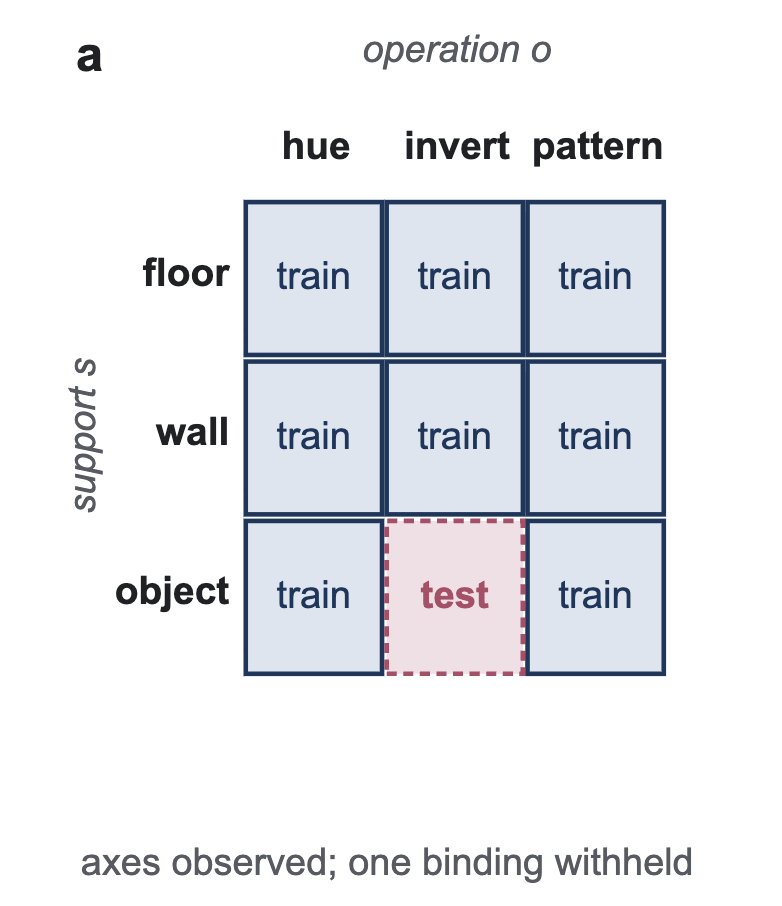
위 그림을 보면 조금 더 이해하기 쉬울 것 같습니다. 저자들은 Floor / Wall / Object와 Hue / Invert / Pattern을 조합하여 3×3 grid를 만들고, 이 중 하나의 조합만 학습에서 제외했습니다. 예를 들어 Object × Invert를 제외했다면, 모델은 학습 과정에서 Object 도 여러 번 보았고 Invert 도 다른 영역에서 여러 번 보았습니다. 하지만 Object 에 Invert 가 적용된 경우만 처음 보는 상황이 되는 것이죠.
따라서 테스트에서 이 조합까지 맞힐 수 있다면, 단순히 각 training example을 기억한 것이 아니라 이미 알고 있는 Where과 What을 새로운 방식으로 조합할 수 있다고 볼 수 있습니다.
결국 이 논문에서 살펴보고 싶은건 다음과 같습니다: Frozen Vision Encoder는 단순히 다양한 visual information을 가지고 있는 것을 넘어, 이 정보들을 새로운 Where × What 조합으로 읽어낼 수 있을 만큼 compositional하게 표현하고 있을까?
다음 장에서는 이를 확인하기 위해 저자들이 원본 이미지와 변형된 이미지의 patch representation 차이를 어떻게 분석했는지 살펴보겠습니다.
2. 이미지가 바뀔 때 patch representation의 변화
그렇다면 Where × What 정보는 Vision Encoder의 representation에서 어떻게 찾을 수 있을까요? 저자들은 원본 이미지와 특정 영역에 intervention을 적용한 이미지의 patch representation 차이를 살펴보았습니다
\Delta z = z_{\text{int}} - z_{\text{src}}. 저자들은 이 patch-wise difference를 Innovation Field라고 불렀습니다.
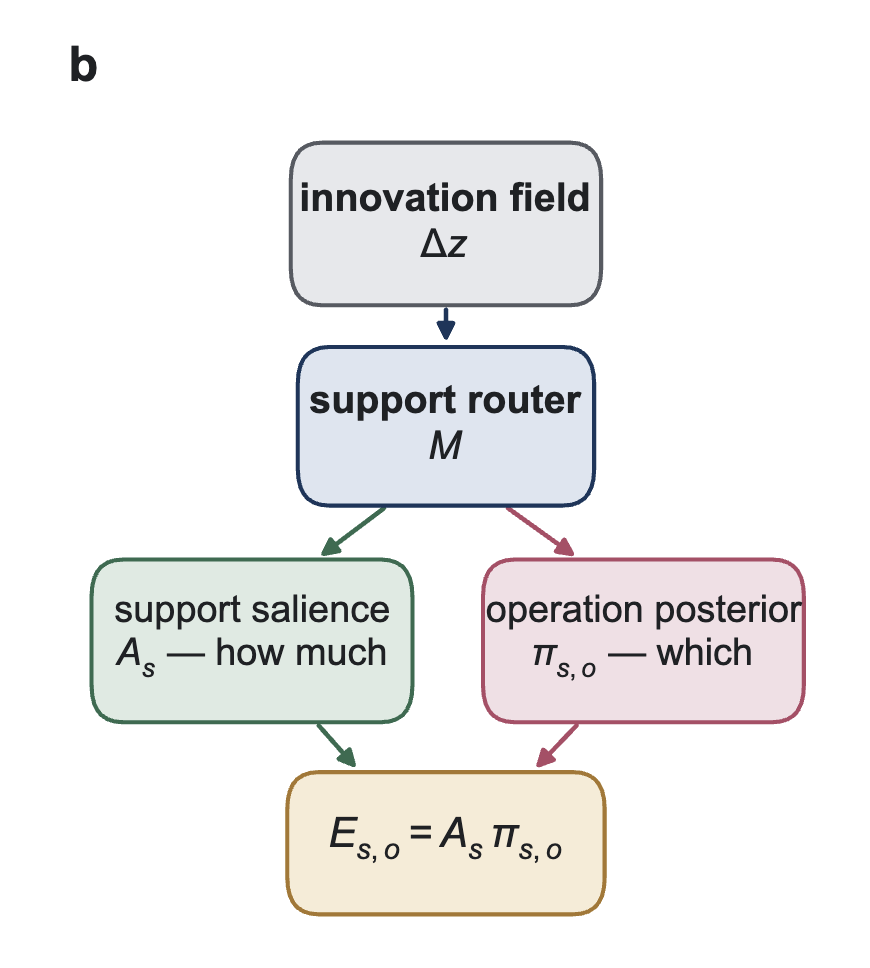
저자들은 왜 원본 feature가 아니라 두 이미지의 차이를 봤을까요?
원본 representation에는 객체, 색상, 배경 등 다양한 정보가 섞여 있지만, 두 이미지에서 실제로 달라진 것은 intervention에 의해 바뀐 부분뿐입니다. 따라서 \Delta z를 보면 “이미지에 무엇이 있는가” 보다 “무엇이 바뀌었는가“에 집중할 수 있습니다.
또한 저자들은 global embedding이 아니라 patch token 단위의 변화를 사용합니다. 덕분에 \Delta z에는 자연스럽게
- Where: 어느 영역이 변했는가?
- What: 어떤 방식으로 변했는가?
라는 두 종류의 정보가 포함될 수 있게되는거죠. 따라서 Innovation Field에서 Where와 What을 각각 읽어내자는 것이 저자가 제안하는 SO-OPF의 시작입니다.
3. Proposed Method: SO-OPF
앞서 만든 Innovation Field \Delta z에서 저자들은 두 가지 정보를 따로 읽어냅니다.
먼저 Where입니다. 어떤 영역의 patch가 크게 변했는지를 계산하여, 변화가 Floor, Wall, Object 중 어디에서 발생했는지를 찾습니다. 이를 Support Salience A_s로 표현합니다.
다음은 What입니다. 변화가 발생한 영역의 feature를 이용해, 해당 변화가 Hue, Invert, Pattern 중 무엇인지 판단합니다. 이를 Operation Posterior \pi_{s,o}로 표현합니다.
마지막으로 두 정보를 결합해 각 Support × Operation 조합의 score를 계산합니다. E_{s,o}=A_x\pi_{s,o}
되게 복잡하게 말해서 그렇지, SO-OPF의 핵심은 생각보다 간단합니다.
- A_s: 어디가 바뀌었는가?
- \pi_{s,o}: 어떻게 바뀌었는가?
- E_{s,o}: 어디가 어떻게 바뀌었는가?
결국 하나의 classifier가 모든 조합을 직접 외우게 하는 대신, Where와 What을 분리해서 읽고 마지막에 다시 조합하는 구조라고 이해하면 될 것 같습니다.
4. Q 설정: Label과 Factor Grid 연결하기
SO-OPF를 통해 Support × Operation의 3×3 score grid를 만들었지만, 아직 한 가지 문제가 남아 있습니다.
실제 학습 데이터의 label은 단순히 class 0, class 1, … 형태이기 때문에, 각 label이 grid의 어느 위치에 해당하는지 연결해줘야 합니다. 저자들은 이 mapping을 라고 정의합니다.
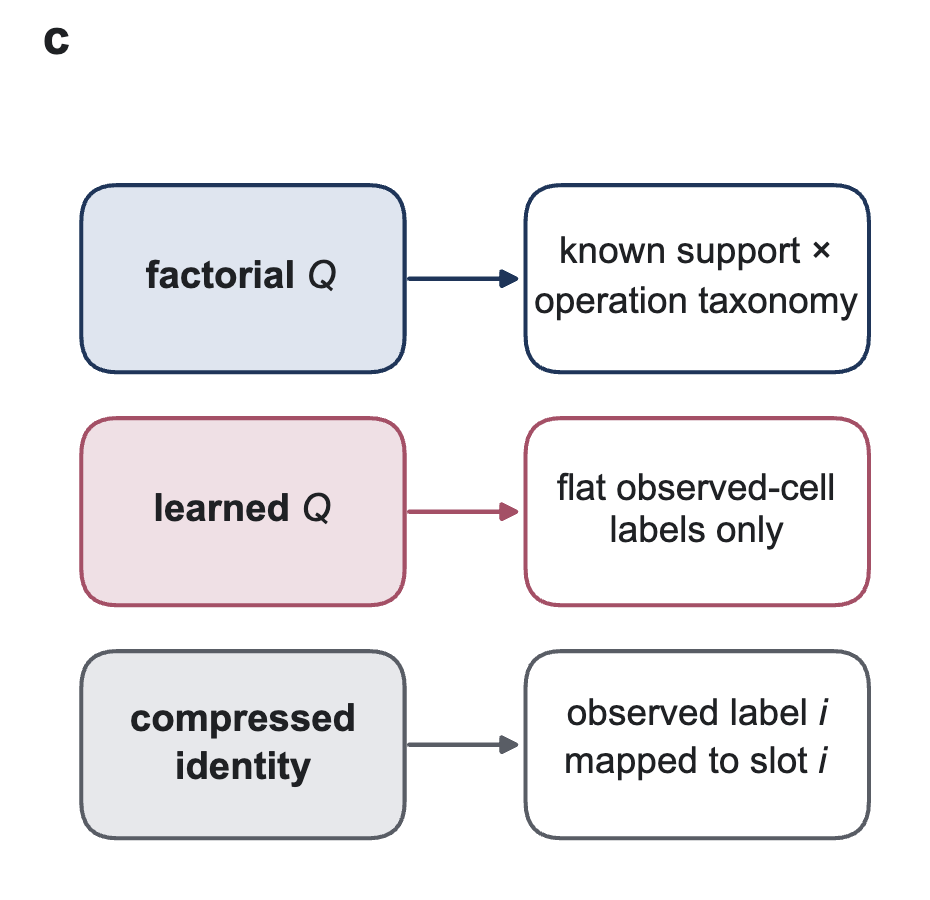
논문에서는 크게 두 가지 설정을 중요하게 봤다고 합니다.
- Factorial Q: Object × Invert처럼 각 label이 어느 cell인지 정답 mapping을 알려줌
- Learned Q: 3×3 구조만 알려주고, label과 cell의 대응 관계는 모델이 직접 학습
따라서 Factorial Q는 representation 자체에 새로운 조합을 읽어낼 정보가 있는지를 확인하는 설정이고, Learned Q는 한 단계 더 나아가 flat label만으로 factor 구조까지 찾아낼 수 있는지를 확인하는 설정이라고 볼 수 있습니다.
이 차이를 기억해두면 이후 실험 결과를 훨씬 이해하는데 도움이 될 것 같네요
5. 새로운 조합을 읽어낼 수 있을까?
저자들은 SO-OPF가 실제로 보지 못한 Support × Operation 조합을 읽어낼 수 있는지 Shapes3D, MuJoCo, COCO 세 데이터셋에서 실험하였습니다.
세 데이터셋 모두 기본적으로 3개의 Support와 3개의 Operation으로 이루어진 3×3 grid를 구성하고, 각 실험에서는 하나의 cell을 제외한 나머지 8개 cell만 학습합니다. Main experiment에서는 frozen DINOv3 ViT-L/16의 patch feature를 사용했습니다 (SigLIP2도 실험에 활용했습니다)
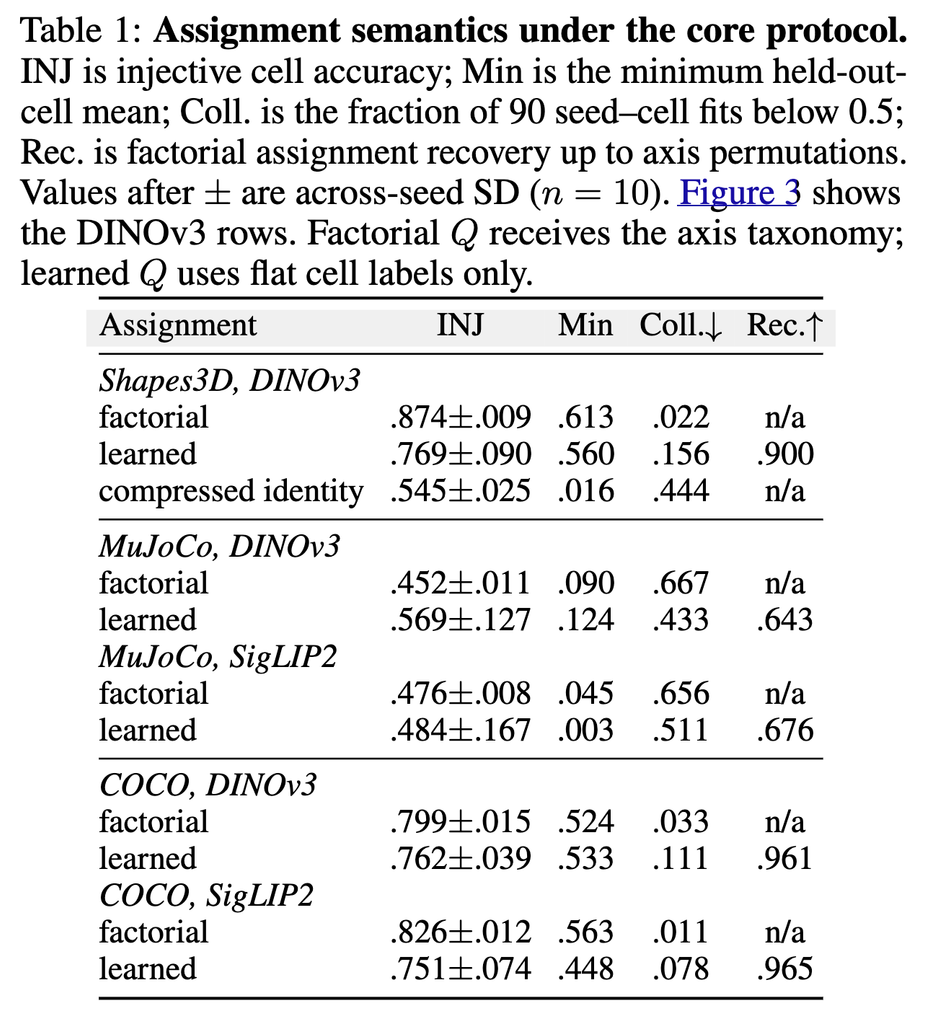
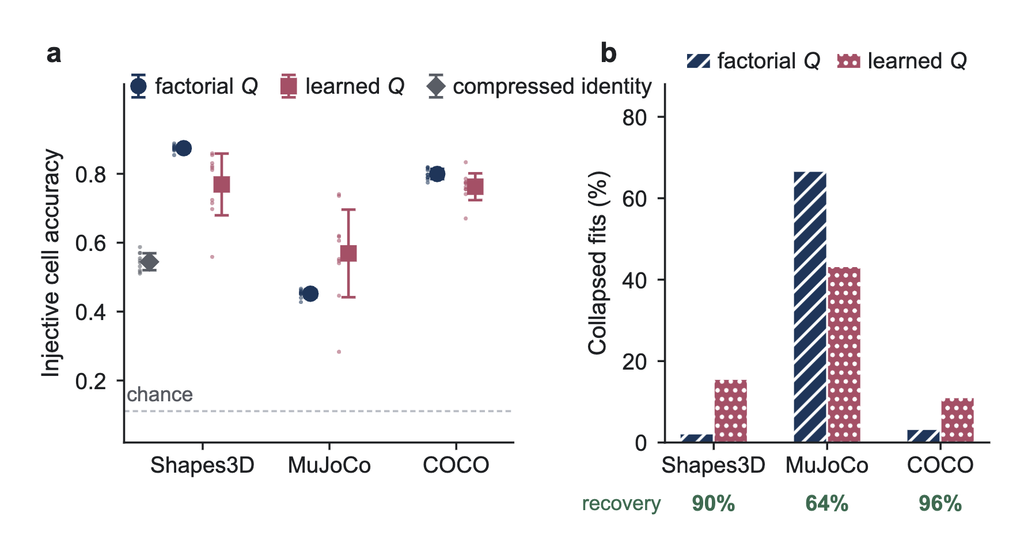
먼저 Factorial Q의 결과를 보면 Shapes3D에서는 0.874, COCO에서는 0.799의 Injective Cell Accuracy를 보였습니다. 즉, Support와 Operation의 구조를 알려준 상태에서는 학습에서 제외했던 새로운 조합도 상당히 높은 정확도로 읽어낼 수 있었던 건데요
더 재밌는건 Learned Q 라고 합니다. 각 label이 어떤 Support × Operation에 해당하는지 알려주지 않았음에도 Shapes3D 0.769, COCO 0.762의 성능을 보였고, 실제 factorial grid와 동일한 구조를 복원한 비율도 각각 90.0%, 96.1%였습니다. (SigLIP2에서도 COCO에서 Factorial Q 0.826, Learned Q 0.751로 비슷한 결과가 나타났습니다. 따라서 이러한 현상이 DINOv3에만 나타나는 건 아닌거죠?)
여기까지만 보면, Frozen Vision Encoder의 patch representation에는 보지 못한 Where × What 조합까지 읽어낼 수 있는 정보가 어느 정도 존재한다고 볼 수 있을 것 같습니다. 그런데 Table 1을 자세히 보면 이상한 데이터셋이 하나 있습니다. 바로 MuJoCo입니다. 다른 두 데이터셋과 달리 성능이 크게 떨어지고, seed에 따른 collapse도 자주 발생합니다.
왜 MuJoCo에서만 이런 현상이 나타났을까요?
5.1 MuJoCo
table 1에서 DINOv3 기준 Factorial Q의 INJ는 0.452, Learned Q도 0.569에 그쳤고, 학습이 무너진 collapsed fit의 비율도 각각 66.7%, 43.3%로 상당히 높았습니다. SigLIP2에서도 비슷한 현상이 나타났기 때문에, 특정 encoder만의 문제라고 보기는 어려웠습니다.
일반적인 many-to-one matching으로 평가하면 MuJoCo의 Learned Q 성능은 0.790으로 꽤 높게 나타납니다. 하지만 저자들이 Hungarian matching을 이용해 각 operation이 서로 다른 slot을 사용하도록 강제하자, 0.790 \rightarrow 0.569 로 성능이 크게 떨어졌습니다. 10개의 seed 중 9개에서 동일한 현상이 나타났습니다.
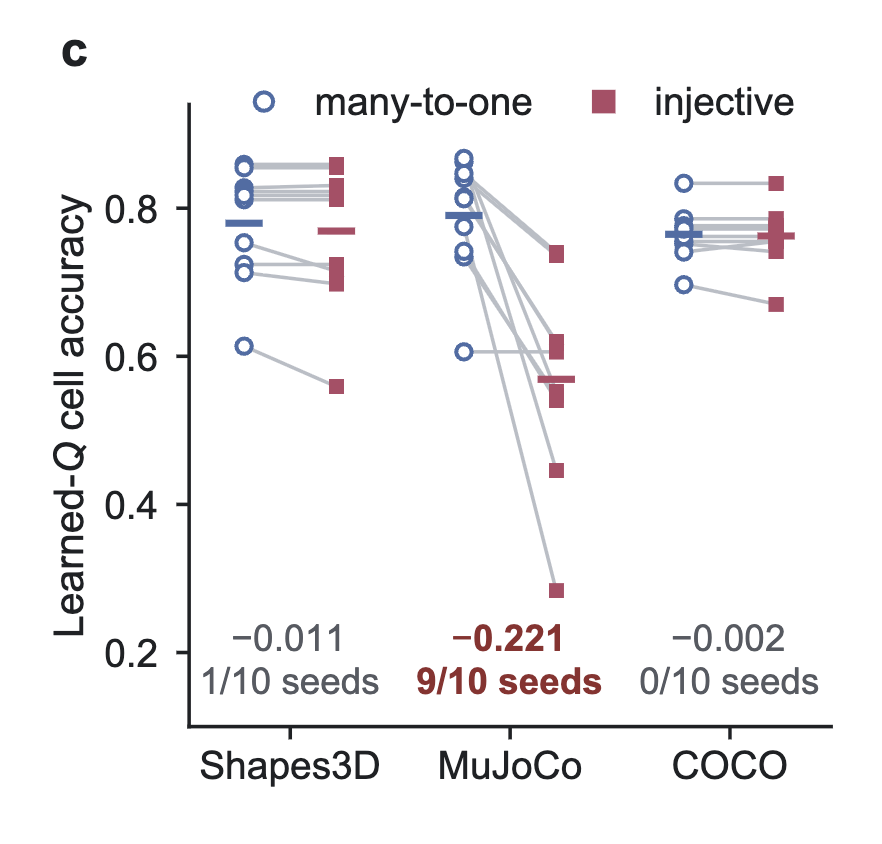
왜 이런 차이가 생긴 걸까요?
기존 방식에서는 Hue와 Invert처럼 서로 다른 operation이 같은 predicted slot을 사용하더라도 각각 정답으로 인정될 수 있습니다. 즉 실제로는 operation을 제대로 분리하지 못했는데도 accuracy가 높아질 수 있다는 것이죠. 저자들은 이를 Operation Laundering이라고 불렀습니다.
반면 Shapes3D와 COCO에서는 injective scoring을 적용해도 성능 감소가 각각 0.011, 0.002에 불과했습니다. 즉 MuJoCo에서만 높은 score 뒤에 slot reuse가 상당히 많이 숨어 있었던 것입니다.
그렇다면 MuJoCo 자체가 어려운 이유는 무엇일까요? Supplementary 을 살펴보니까 Pattern은 DINOv3와 SigLIP2 모두 거의 100%에 가까운 성능을 보인 반면, Hue와 Invert에서 성능이 크게 떨어졌습니다.
저자들은 그 원인 중 하나로 intervention 방식의 차이를 언급하였습니다. Pattern은 이미지 위에 직접 적용되는 pixel-space 변화인 반면, Hue와 Invert는 MuJoCo의 material을 수정한 뒤 다시 rendering하기 때문에 lighting이나 renderer의 영향을 함께 받습니다.
즉 MuJoCo의 결과는 Vision Encoder가 언제나 깔끔한 Where × What 구조를 만들어주는 것은 아니며, 어떤 종류의 visual change를 다루느냐에 따라 compositional information 자체가 훨씬 모호해질 수 있다는 boundary를 보여주는 결과라고 볼 수 있을 것 같습니다.
6. 구조화된 Readout이 중요한가?
앞선 결과만 보면 한 가지 의문이 생깁니다. SO-OPF의 성능이 좋은 것이 DINOv3 representation 자체가 좋아서일까요, 아니면 Where × What으로 나누어 읽는 구조가 실제로 중요한 걸까요?
저자들은 이를 확인하기 위해 SO-OPF를 여러 readout과 비교하였습니다.
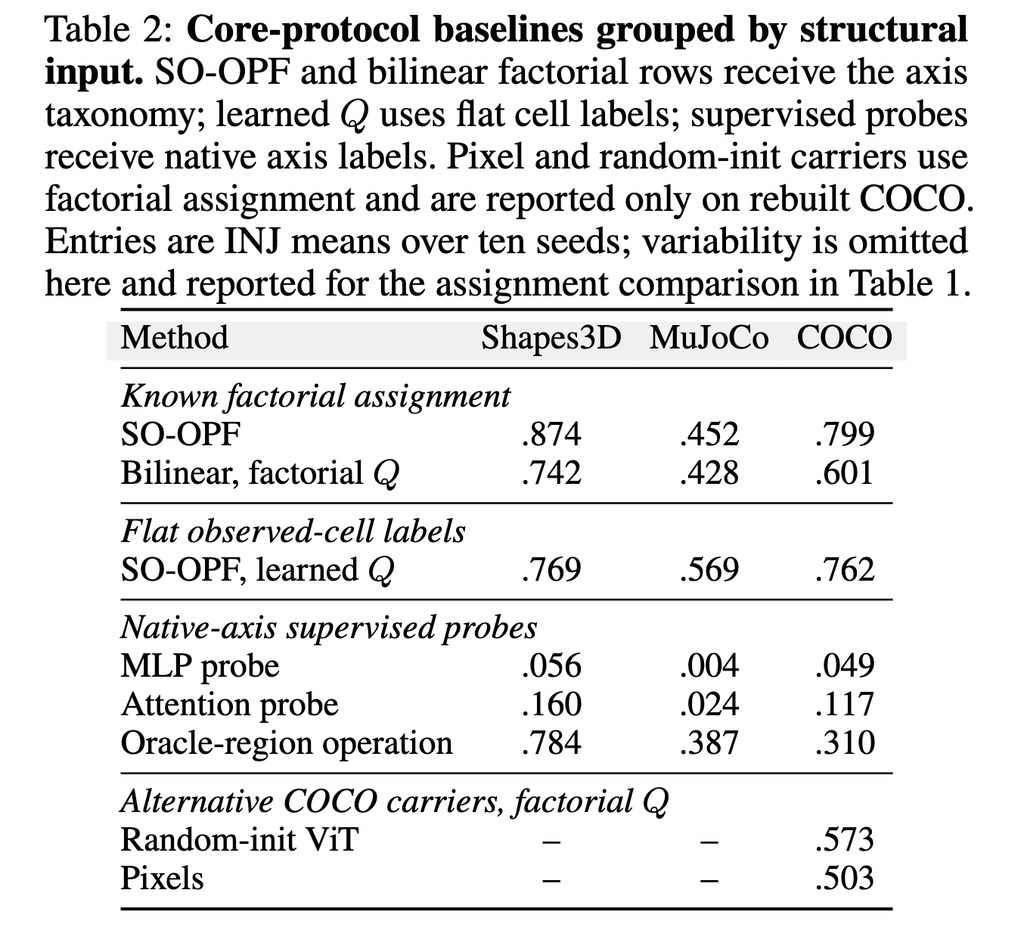
COCO 결과를 보면 SO-OPF는 0.799의 INJ를 기록한 반면, 일반적인 Bilinear readout은 0.601에 그쳤습니다. 더 단순한 MLP와 Attention probe는 각각 0.049, 0.117로 거의 새로운 조합을 읽어내지 못했습니다.
재미있는 점은 Random-init ViT도 0.573, Raw Pixel도 0.503이라는 꽤 높은 성능을 보였다는 것입니다. 즉 이 task는 좋은 pretrained feature만 있다고 해결되는 것도 아니고, 반대로 SO-OPF 구조만으로 전부 설명되는 것도 아닙니다. 저자들은 representation과 structured readout이 모두 중요하다고 해석합니다.
그렇다면 정말 Where와 What을 분리하는 factored structure 자체가 효과가 있는지도 확인해야겠죠.
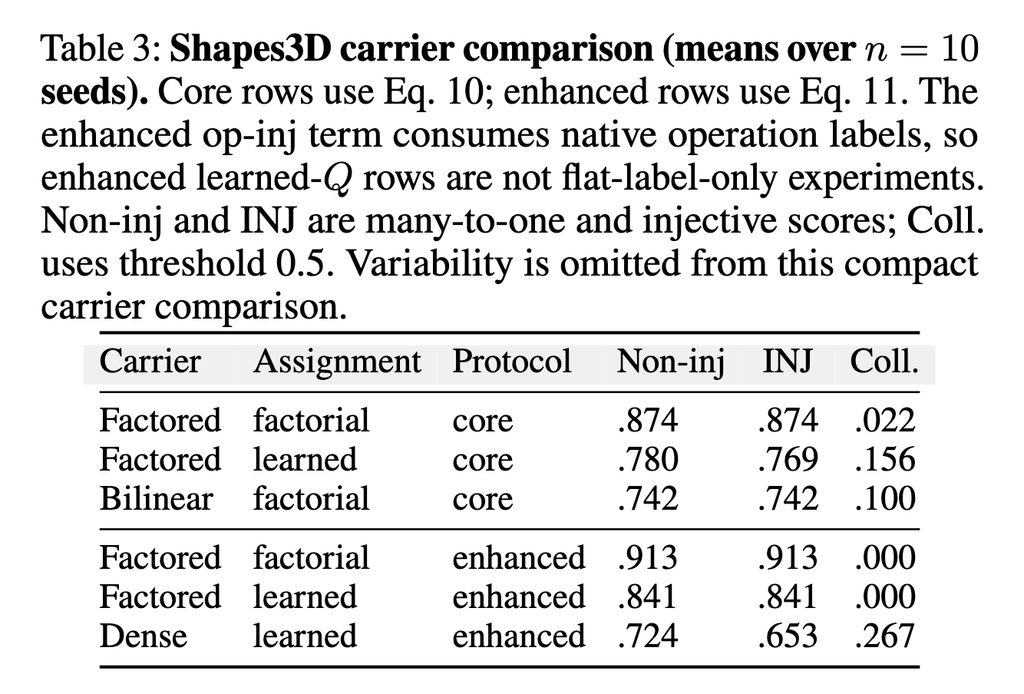
동일한 supervision을 사용했을 때 Factored carrier의 Learned-Q INJ는 0.841, Dense carrier는 0.653이었습니다. 특히 Dense carrier는 일반 score가 0.724였지만 injective evaluation에서는 0.653으로 떨어져 0.071의 Operation Laundering이 나타난 반면, Factored carrier는 0.841 → 0.841로 차이가 없었습니다.
즉 저자들이 Where와 What을 굳이 분리한 것은 단순한 설계 선택이 아니라, 서로 다른 operation이 하나의 slot을 공유하는 것을 억제하고 새로운 조합을 더 안정적으로 읽어내는 데 실제로 도움이 되었다고 볼 수 있을 것 같습니다
다만 Table 3의 enhanced setting은 operation label까지 supervision으로 사용하기 때문에, 이 결과를 “flat label만으로 factor 구조를 스스로 발견했다”고 해석해서는 안 된다는 점을 주의해야 한다고 하네요
7. Conclusion
이 논문을 읽고 가져갈 한 문장으로는 “Final representation에서 compositionality가 잘 보이지 않는다고 해서, encoder 내부에 조합 가능한 정보가 없는 것은 아니다” 정도가 될 것 같습니다.
저자들은 이미지의 변화를 Where × What으로 분해하고, frozen DINOv3와 SigLIP2의 patch representation에서 학습 때 보지 못했던 새로운 조합까지 읽어낼 수 있음을 보여주었습니다. 특히 단순한 MLP probe보다 Where와 What을 분리해서 읽는 SO-OPF가 훨씬 안정적인 결과를 보였다는 점도 흥미롭습니다.
즉, compositionality를 분석할 때는 단순히 representation에 정보가 있느냐 없느냐만 볼 것이 아니라, 그 정보가 어디에 존재하고 어떤 방식으로 읽어내야 하는가까지 함께 고민해야 한다는 것이 중요한 메시지인 것 같습니다.
개인적으로 아쉬웠던 점은 현재 사용한 Operation이 대부분 Hue, Invert, Pattern, Blur처럼 비교적 low-level visual change에 집중되어 있다는 점입니다.
우리가 일반적으로 VLM의 compositionality를 이야기할 때 관심을 가지는 것은 dog chasing man ↔ man chasing dog와 같은 relation, not a dog와 같은 negation, 혹은 attribute binding이나 word order처럼 보다 semantic한 변화입니다.
따라서 현재 발견한 Where × What 구조가 이러한 semantic compositionality에서도 동일하게 나타나는지는 아직 확인이 필요해 보입니다.
그럼에도 이 논문은 global representation의 실패를 곧바로 encoder 자체의 실패로 해석해서는 안 된다는 점을 잘 보여준다는 점에서 의미가 있다고 생각합니다. 특히 patch-level representation과 structured readout이라는 관점은 앞으로 Vision Encoder의 compositionality를 분석할 때 꽤 유용한 방향이 될 수 있을 것 같습니다.
이상 리뷰 마치겠습니다!