최근 multi agent system은 여러 에이전트의 의견을 통합하여 우연히 발생하는 잡음에 의한 오류를 최소화하거나 복잡한 문제를 해결한다는 장점이 있으나 최근에는 여러 에이전트의 결과를 종합하는 과정에서 우연히 자주 발생하는 출력에 대해 동조하여 증폭되는 현상이 발견되고 있습니다. 이 모습이 마치 밈이 인터넷에 퍼지는 모습과 유사하다고 하여 본 논문에서는 memmetic drift라고도 표현했습니다.
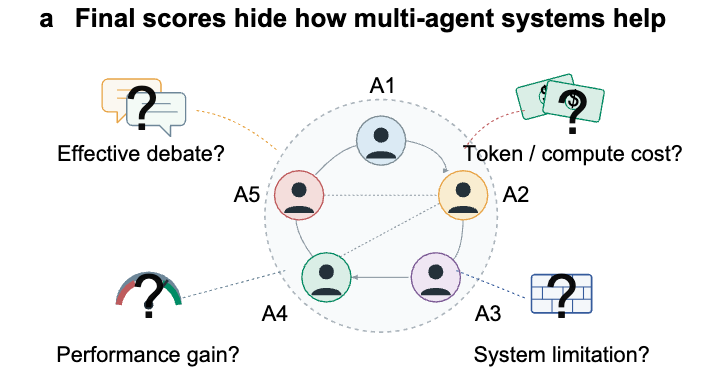
즉 우연성에 의한 오류가 있는 모델을 여러번 사용하여 결과/추론을 수행하는 multi agent system에는 memetic drift와 같이 우연이 중첩되어 발생하는 오류가 여전히 남아있을 수 있다는 것입니다. 따라서 논문에서는 multi agent system(이하 MAS)에서는 오류가 누적되기 전 검증하는 과정이 필수적이라고 언급합니다. 기존 MAS 연구에서는 시스템을 통째로 하여 성능을 측정 및 비교하였으나 위의 fig1에서와 같이 MAS에는 다양한 agent가 관여하여 최종 성능만으로 비교하기에는 개선의 효율이 떨어집니다. 즉, 성능 하락의 위치를 정확히 특정할 수 없어 시스템 개선이 어려워집니다. 가장 효과적인 검증을 위해 논문은 multi agent 아키텍처를 candidate generation, judge realiability, anser selection 세가지 요소로 분리해야함을 주장합니다. 특히 multi agent system의 성능 개선의 어려움을 LLM judging 방법을 통해 개선하므로써 이러한 시스템 분해가 유용함을 다루고 있습니다.
논문에서는 실험을 4가지 질문으로 나누어 구성했습니다:
Exp1: muiti agent는 최종 정확도 개선에 유효한가? [generation 검토]
Exp2: LLM judge는 언제 신뢰할 수 있는가? [judge system 검토]
Exp3: 최종 선택 전략은 어떻게 구성하는게 좋은가? [selection 검토]
Exp4: 최종 정확도 개선에 있어서 어떤 파트를 개선하는게 효율적인가? [최종 설계 방법]
본 리뷰에서는 논문의 제시하는 네가지 질문과 이에 대한 논문의 분석을 순서대로 소개하겠습니다.
[Exp1] muiti agent는 최종 정확도 개선에 유효한가?
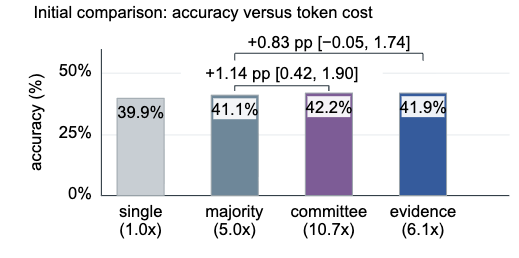
최근 MAS 연구에서는 multi agent system을 구축하는 것이 연산량에 대비하여 종종 효율적이지 않다고 분석하고 있습니다. 특히 위와 같은 연구에서는 서로 다른 모델을 활용하거나 페르소나를 다양하게 하는 등의 변주가 함께 사용됩니다. 한편 본 연구에서는 동형(DeepSeek-V4-Flash) 모델에 동일한 프롬프트 (seed 변경) 세팅에서 MAS를 구축하여 연산량 대비 시스템 구축을 통한 성능개선의 한개를 극적으로 보여줍니다. fig2를 보면 단일 모델을 사용한 것 보다 5개의 agent를 추가로 활용하여 답변을 major voting 방식으로 집계한 가장 대표적 방법인 majority, 하나의 llm 기반 집계기를 추가한 evidence, 2라운드의 답변 생성 과정을 거친 committee를 비교하였을 때 연산량이 5배 혹은 그 이상이 증가하더라도 최종 성능 개선에 한계가 있음을 명확하게 보여주고 있습니다.
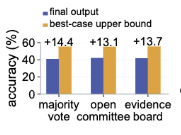
논문에서는 최초 생성된 후보 중 정답이 존재한다면 성능으로 간주하는 oracle 수치(fig3, 노란색)를 통해 각 시스템이 single agent로는 달성 할 수 없는 성능 개선(13.1+α)이 있음을 밝히며 이러한 MAS의 성능 개선의 한계의 원인이 generation 단계가 아닌 다른 단계에 있음을 확인하였습니다.
즉 muiti agent는 최종 정확도 개선에 유효한가?에 대하여 최종 성능만을 보면 그다지 유용해 보이지 않을 수 있으나, generation이 아닌 다른 부분의 병목을 개선하면 이를 해결할 수 있음을 보여주고 있습니다.
[Exp2] LLM judge는 언제 신뢰할 수 있는가?
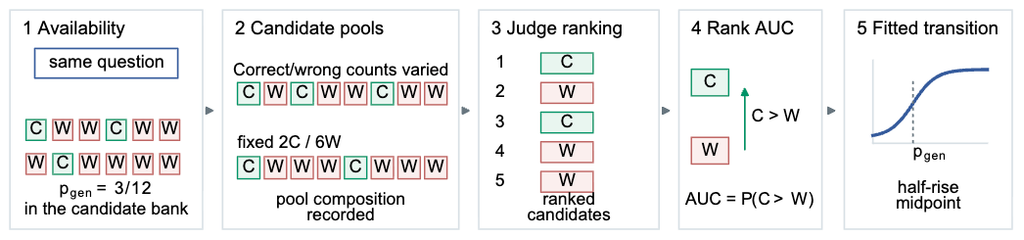
Exp1에서는 candidate generation, judge realiability, anser selection로 구성된 MAS 시스템의 성능 개선 병목이 generation이 아닌 다음 단계임을 확인했습니다. Exp2에서는 judge를 언제 신뢰할 수 있는지 분석해 신뢰성을 개선하여 최종 MAS 성능을 개선 시키고자 하였습니다.
judge 모듈의 분석을 위해 저자들은 아래의 방식(fig4의 5)으로 성능을 리포팅 하였는데, x 축을 generator의 성능 지표(P_gen) y축을 Rank AUC라는 judge의 정확도로 두어 그래프를 리포팅 하였습니다. 이때 Rank AUC는 fig4의 4와 같이 judge가 정답에 해당하는 에이전트의 순위를 오답보다 높게 하는 정도를 집계한 것으로 judge의 성능을 의미합니다.
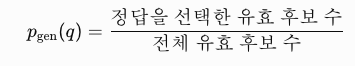
제안한 리포팅 방식으로 분석한 결과는 fig 5와 같으며 시그모이드 함수와 같은 곡선이 관찰되었다고 리포팅 합니다. 이러한 형태의 의미는 generator의 정확도가 낮을때는 judge가 제 성능을 발휘하지 못하지만, 특정 정확도를 넘는 순간 judge의 정확도가 상승하여 시스템 구축을 통해 얻을 수 있는 최적의 정확도에 빠르게 수렴함을 의미합니다. 즉 특정한 특이점을 넘는다면 judge 모듈을 높은 신뢰도로 이점을 얻을 수 있다는 의미입니다.
fig 5에서는 시스템을 2가지 세팅에서 리포팅 하였는데, 이것은 generator의 성능을 정의하는데 의미가 있습니다 먼저 왼쪽의 실험 세팅은 judge 모듈이 답변을 선택해야하는 generator의 결과 집합(이하 pool)이 단순히 8번의 생성 결과를 모은것인 가장 기본적인 세팅입니다. 한편 왼쪽의 경우 pool 구축에 있어서 정답과 오답의 비율을 통제한 상황으로 generation을 반복한 결과에서 정답 2개 오답 6개(2C/6W)로 pool 구성을 통제한 것으로 해당 상황에서도 동일한 시그모이드 형태가 관찰되었음을 확인할 수 있으며 judgement에 관여되는 geneator 성능이 단순히 판독의 난이도인 majority/pool의 구성 비율이 아닌 실제로 generation의 난이도/generator의 성능과 관계있음을 짐작할 수 있는 실험 결과입니다.
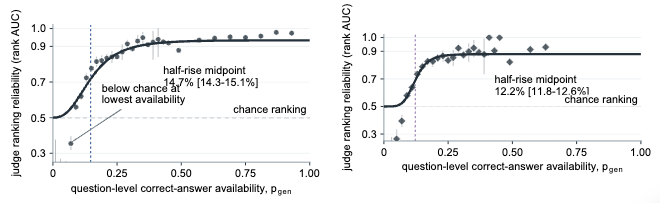
Exp2를 정리하면 judge는 특정 임계값을 넘게되면 신뢰도가 크게 상승할 수 있는 모듈이나, 임계값의 수치는 generator의 성능을 반영한 것으로 고정된 속성은 아님을 확인할 수 있습니다.
[Exp3] 최종 선택 전략은 어떻게 구성하는게 좋은가?

우리는 앞선 실험을 통해 MAS는 generator의 성능이나 잠재성 개선이 아닌 judgement와 selection의 방법 변화를 통해 최종 MAS의 성능을 개선할 수 있으며 특히 judgement는 특정 임계점을 기준으로 유용성이 결정됨을 확인할 수 있었습니다. 즉 특정 임계점을 넘은 상태에서는 judgment 결과를 적극적으로 활용하고, 그렇지 않은 상황에서는 해당 결과를 배제하여 selection을 설계한다면 MAS는 최적의 이득을 얻을 수 있습니다.
Exp3에서는 selection 전략을 어떻게 설계하면 좋을지에 대한 인사이트를 제공합니다. 우리가 MAS에서 선택할 수 있는 selection 전략은 2가지로 pool의 다수 의견을 최종 정답으로 하는 majority voting과 LLM selector를 이용하는 방법이 있습니다. 본 연구에서는 LLM selector를 통해 Pool의 후보의 등수를 매겨 최종 답을 선택하는 judge’s first-ranked candidate(fig 6)을 비교했습니다.
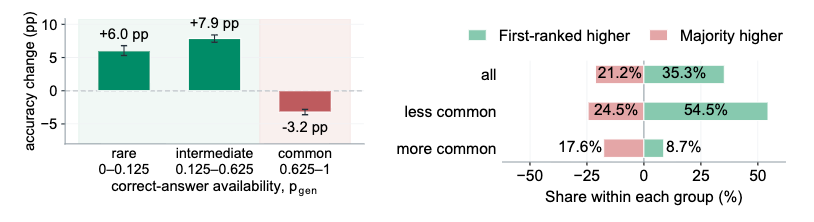
비교 결과는 fig 7과 같습니다. 즉 selector에서 pool의 구성에 따라 방법의 효과가 달랐습니다. fig7의 왼쪽과 오른쪽의 실험은 비슷한 결과를 다루고 있는데, 우선 왼쪽의 경우 P_gen의 성능에 따른 LLM selector 기반 선택방법의 효과입니다. generator가 생성한 정답에서 올바른 답변을 가진 후보가 적을 경우 selector가 유의미했으며, 반대로 selector가 정답을 언제나 생성하는 경우에는 selector로 인해 오히려 소수의 오답이 최종 출력으로 선택되어 성능을 악화시킬수도 있었습니다. 한편 오른쪽의 경우 LLM selecto(녹색)과 major voting(붉은색) 방식을 직접 비교한 결과인데, pool에 정답을 말한 후보가 50% 미만인 경우인 less common에서는 first-ranked higher(LLM selector) 도입을 통한 성능 개선이 우세하였으며, Pool에 정답이 많이 포함되는 상황인 more common에는 majority voting이 정답을 선택할 확률이 높았음을 확인할 수 있습니다. 즉 major voting과 LLM selector를 pool에서 정답 가용성에 따라 selection 전략을 적절하게 번갈아가며 사용하는것이 최종 MAS 의 성능 개선에 필요함을 확인하는 실험이였습니다.
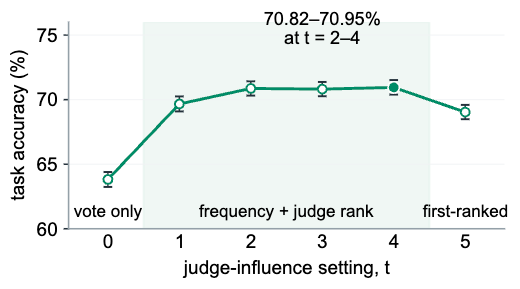
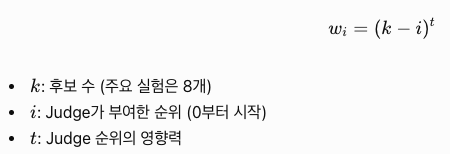
논문은 이러한 분석을 실제 selector 설계에 활용하여 성능이 개선될 수 있음을 fig 8을 통해 보였습니다. voting과 LLM selector의 결과를 모두 selection에 활용할 수 있는 설계로, major voting을 집계할 때, 각 정답의 카운트 수에 가중치를 부여한 것입니다. 이때 가중치는 아래의 w_i로 정의됩니다. 즉, judgement가 부여한 순위가 높은 agent 일수록 답변의 신뢰도를 높여 강하게 voting 하는 것 입니다. 그 결과 judment의 수치와 major voting을 적절히 배합할 때(t=2~4) 가장 효과적이였음을 실험을 통해 확인할 수 있었습니다.
Ex[Exp4] 최종 정확도 개선에 있어서 어떤 파트를 개선하는게 효율적인가?
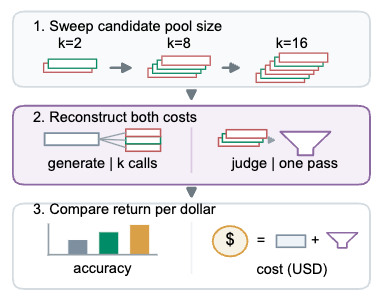
MAS 시스템의 개선을 위해 설계자는 judge 모듈 추가 혹은 agent의 추가를 고려할 수 있습니다. 두 모듈 동일하게 한번의 추론 연산이 추가되며, 앞선 분석을 통해 각 모듈이 성능 개선의 임계점을 넘는 순간이 상황에 따른 의존성이 있기에 설계에 어떤 점을 고려해야하는지 불명확할 수 있습니다. Exp4에서는 MAS 아키텍처 설계의 기준을 명확하게 하기위해 각 시스템 추가 구축의 이점을 비용에 따라 비교 분석하였습니다.
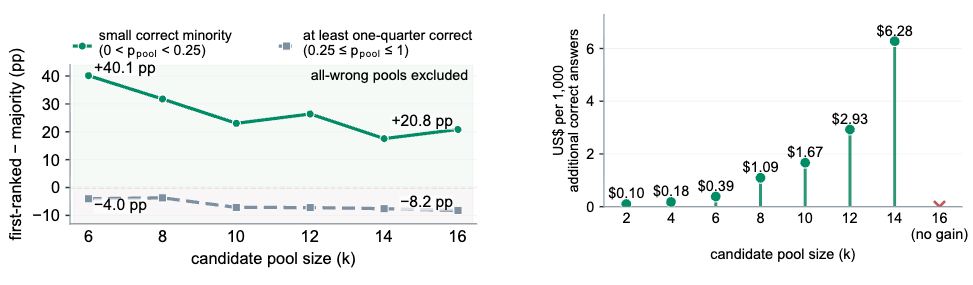
분석의 결과로 fig 10의 실험을 하나씩 확인해보겠습니다. 먼저 왼쪽의 경우 agent 추가를 통한 candidate pool size 증가의 효과입니다. pool 내부에 정답이 적은 경우(1/4 이하)에는 candidate size가 증가함에 따라 first-ranked와 major voting의 개선폭이 감소하여 LLM selector의 이점이 감소하였음을 알 수 있으며 pool 내에 정답이 1/4 이상이 보장되는 경우에는 major voting이 언제나 나았습니다. 또한 오른쪽에서는 candidate 를 증가시킴에 따라 judge LLM을 호출하는 비용의 변화를 보인것입니다. 두 결과 모두 pool size가 증가하면 llm 호출이 효율성이 떨어짐을 보여주고 있습니다. 즉 pool이 이미 크거나 정답이 잦게 나오는 쉬운 상황에서는 성능 개선을 위해 agent 를 추가하는게 나으며, pool이 작거나 agent가 정답을 추론할 확률이 낮은 경우에는 LLM selector를 추가하면 비용대비 최대 효율을 얻을 수 있음을 확인한 것입니다. 이때, 각 비용은 DeepSeek-V4-Flash(preview) 기준으로 산출되었다고 합니다.
정리하며
우리는 본 논문을 통해 MAS를 3가지 모듈로 나누고, 각 모듈의 효율적 설계를 통해 최종 MAS의 개선이 가능하였음을 확인할 수 있었습니다. 특히 MAS의 에이전트 별 답변의 다양성을 적극적으로 활용한 기존 연구와 다르게 동형 모델과 거의 동일한 프롬프트를 활용한 MAS 시스템에서도 설계를 통해 성능 개선이 가능함을 보인 잘 통제된 실험이였던 것이 인상깊었던 것 같네요. 이상으로 리뷰를 마치겠습니다. 감사합니다.