안녕하세요
오늘은 저번 리뷰와 비슷하지만 조금은 다른 Regional Style Transfer를 task로 특정 객체에만 원하는 스타일을 적용하면서 나머지 영역은 그대로 유지하는 문제를 해결하려는 RegionRoute: Regional Style Transfer with Diffusion Model 논문을 읽어보았습니다!
기존 diffusion model은 스타일 자체는 잘 표현하지만 그 스타일을 원하는 영역에만 적용하는 건 여전히 어려운 문제라고 하는데요!! 저자들은 이를 attention supervision을 통해 해결하려고 합니다!
그럼 바로 리뷰 시작하겠습니다
INTRO
최근 Diffusion 기반 생성 모델들은 Image Generation뿐만 아니라 Image Editing, Style Transfer 등 다양한 작업에서 좋은 성능을 보여주고 있습니다!
특히 Stable Diffusion이나 FLUX 같은 모델들은 이미지의 퀄리티뿐만 아니라 텍스트 프롬프트를 기반으로 원하는 스타일을 표현하는 능력도 상당히 좋아졌는데요
하지만 여전히 해결되지 않은 문제가 있습니다. 바로 스타일이 적용되는 위치를 정확하게 제어하기 어렵다는 점 입니다!
기존 Style transfer 모델들은 일반적으로 스타일을 Global feature로 취급하기 때문에 특정 객체에만 스타일을 적용하기보다는 이미지 전체에 적용하는 경향이 있습니다
예를 들어 원본 이미지에 Pixel art 스타일을 적용하면 이미지 전체가 픽셀아트 느낌으로 바뀌는 것이죠!
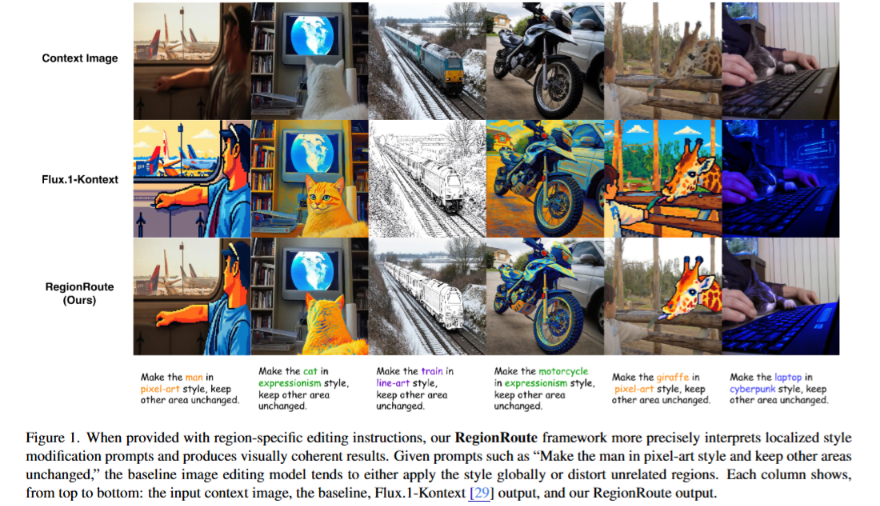
그럼 이런 상황에서 특정 객체에만 스타일을 적용하려면 어떻게 해야할까요?
기존에는 전체 이미지에 먼저 Style transfer를 수행한 후 mask를 이용해 목표 객체 영역만 원본 이미지에 합성하는 방법 등을 사용했습니다
간단하게 생각하면 꽤 괜찮은 방법 같지만 여기에도 문제가 있습니다! 바로 객체와 배경의 경계 부분에서 이질감이 생길 수 있다는 것인데요
조명이나 색상 질감이 서로 다를 수도 있고 mask 경계가 부정확하면 잘라 붙인 듯한 결과가 나올 수도 있겠죠!
저자들은 이런 외부적인 합성 과정을 거치지 않고 생성 모델 자체가 특정 영역에만 스타일을 적용하도록 학습시키는 방법으로 접근합니다!
그런데 여기서 한 가지 의문이 생깁니다
Diffusion Model은 이미 객체가 어디에 있는지 어느 정도 알고 있지 않을까요?
실제로 Diffusion Model은 attention을 통해 특정 Text token과 Image region 사이의 관계를 포착할 수 있습니다
예를 들어 모델이 cat이라는 Text token을 처리할 때 이미지에서 고양이가 위치한 영역과 높은 관련성을 가질 수 있다는 거죠!
하지만 여기서 중요한 차이가 있습니다!
객체의 위치를 인식하는 것과 그 객체에만 특정 스타일을 적용하는 것은 다른 문제입니다!
예를 들어 (Make the cat in pixel-art style, keep other areas unchanged) 라는 프롬프트가 들어왔다고 가정해봅시다
모델은 cat과 pixel-art style이라는 개념을 이해할 수 있습니다. 하지만 스타일에 대한 정보가 고양이 영역에만 작용하도록 충분히 학습되지 않았다면 배경까지 픽셀아트로 바뀔 수도 있겠죠!
즉 스타일에 대한 표현 능력과 스타일의 공간적인 제어 능력은 별개의 문제라는 점입니다!
저자들은 바로 이 부분에 주목합니다
기존 모델이 객체의 위치를 어느 정도 알고 있다면 Style Token 자체를 해당 객체의 영역과 명시적으로 연결해 주면 되지 않을까? 라는 것이죠!
이를 위해 저자들은 RegionRoute라는 Attention-Supervised Diffusion 프레임워크를 제안합니다!
핵심 아이디어는 생각보다 간단합니다
Diffusion Model 내부에는 Text token과 Image token 사이의 attention 관계가 존재하는데
저자들은 이 관계를 활용해서 Style Token의 Attention 맵이 목표 객체의 Segmentation Mask와 일치하도록 학습시키는 것입니다!
원래는 Style token이 배경까지 넓게 attention을 가질 수 있지만 학습 과정에서 실제 객체 영역에 맞추도록 유도하는 것이죠!
이때 Focus Loss와 Cover Loss라는 두 가지 Loss를 사용하는데, Focus Loss는 Attention이 목표 객체 영역에 집중되도록 하고 Cover Loss는 객체의 일부가 아닌 전체 영역을 충분히 커버하도록 유도합니다 (두 Loss는 이후 Method에서 자세히 살펴보겠습니다!)
또한 다양한 스타일을 효율적으로 학습하기 위해 LoRA-MoE 구조도 활용합니다
스타일별로 LoRA expert를 두고 공통 백본은 스타일이 적용될 위치를 학습하도록 하는 방식인데요
요 방식을 통해 여러 스타일을 각각 학습하면서도 전체 모델을 매번 다시 학습할 필요 없이 새로운 스타일을 추가할 수 있도록 설계했습니다!
그리고 여기서 중요한 점!
학습할 때는 GT Segmentation Mask를 사용하지만 추론할 때는 별도의 Mask가 필요 없다는 것입니다!
즉 사용자는 원본 이미지와 (고양이만 픽셀아트 스타일로 바꿔줘~)라는 텍스트 명령만 입력하면 되는 것이죠!
마지막으로 저자들은 기존의 Style transfer 평가 방식에도 한계가 있다고 지적합니다
기존 지표들은 이미지 전체의 Style similarity나 Perceptual quality를 주로 측정하다 보니 특정 객체에만 스타일이 잘 적용됐는지는 제대로 평가하기 어렵다는 것인데요
이를 위해 목표 영역의 스타일 적용 정도와 편집되지 않은 영역의 보존 정도를 함께 측정하는 Regional Style Editing Score도 제안합니다!
정리하자면 이 논문은 Style Token의 Attention을 객체 영역과 명시적으로 연결하도록 학습시켜 별도의 Mask 없이 원하는 객체에만 스타일을 적용하는 방법을 제안한 연구입니다!
그럼 이제 Method에서 구체적으로 어떻게 구현했는지 살펴보겠습니다!!
METHOD
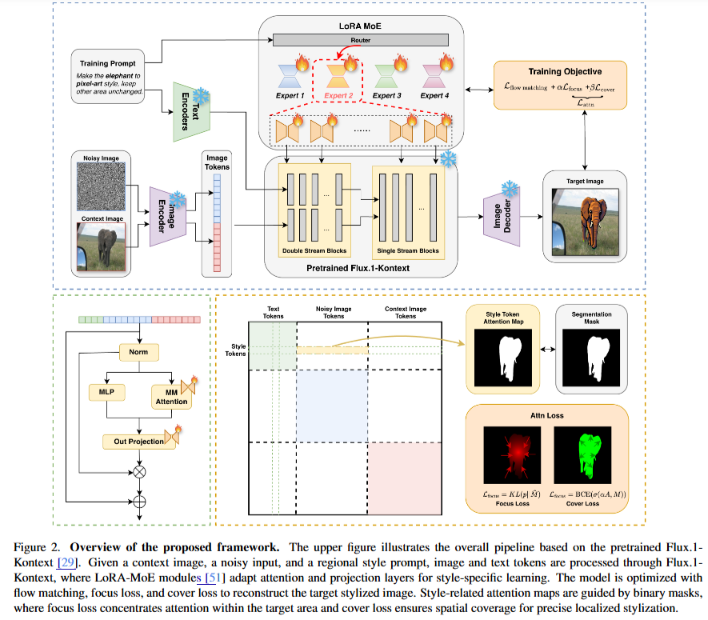
이제 RegionRoute의 Method를 살펴보겠습니다!
위의 fig2 는 제안하는 RegionRoute의 전체 프레임워크를 보여주고 있습니다
RegionRoute는 Flux.1-Kontext를 Backbone으로 사용하며, 원본 이미지(Context image), 노이즈 이미지, Regional style prompt를 입력으로 받습니다
여기에 Attention supervision을 통해 style token과 목표 객체 영역 사이의 공간적 관계를 학습하고, LoRA-MoE를 활용해서 다양한 스타일을 효율적으로 학습하도록 구성했습니다!
학습 과정에서는 Flow matching loss와 함께 Focus loss, Cover loss를 사용하며, 추론 시에는 별도의 Segmentation mask 없이 특정 객체에만 스타일을 적용할 수 있도록 합니다
그럼 각 구성 요소들을 하나씩 살펴보겠습니다!
1. Attention Map Extraction
그럼 이제 style token에 대한 attention map을 어떻게 추출하는지 살펴보겠습니다!
앞서 설명했듯이 Flux.1-Kontext는 text token과 image token을 함께 처리하는 multi-head self-attention 구조를 사용합니다
저자들은 여기서 image token이 style token에 얼마나 attention을 주는지에 해당하는 부분을 추출합니다!
예를 들어 “Make the elephant in pixel-art style”이라는 프롬프트가 주어졌다고 해봅시다
여기서 관심 있는 건 elephant라는 객체 token이 아니라 pixel-art style이라는 style token에 대한 attention입니다
왜냐하면 이 논문의 목적은 단순히 객체의 위치를 찾는 것이 아니라 특정 스타일이 해당 객체 영역에만 적용되도록 학습시키는 것이기 때문이죠!
그럼 이 attention을 어떻게 추출할까요?
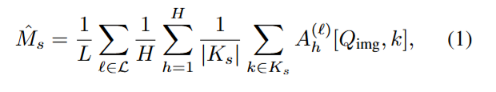
여기서 A_h^{(\ell)}는 \ell번째 layer의 h번째 attention head를 의미하며, Q_{\mathrm{img}}는 image query, K_s는 style token에 해당합니다
저자들은 먼저 image query에서 style token key로 향하는 attention score를 추출합니다
이때 하나의 스타일 표현이 여러 token으로 나뉠 수 있기 때문에 해당 style token들의 attention을 평균 내고, 여러 attention head와 layer에 대해서도 평균을 계산합니다
즉 수식(1)은 style token, attention head, layer에 대한 attention을 평균 내서 하나의 map으로 통합하는 과정을 나타내는 것이죠!
이렇게 얻어진 \hat{M}_s \in \mathbb{R}^{h \times w}가 최종 style attention map이며, 이미지의 각 위치가 해당 스타일에 얼마나 강하게 attention을 주는지를 나타냅니다!
이제 이 attention map이 실제 객체 영역과 일치하도록 학습시켜야겠죠?
이를 위해 저자들은 GT segmentation mask를 attention map과 동일한 해상도로 downsampling하여 M_s를 얻습니다
결국 예측한 style attention map \hat{M}_s와 실제 객체 mask M_s 를 준비한 것이죠!
그럼 이 두 map을 어떻게 일치하도록 학습시킬까요?
이 부분은 다음 Attention Supervision Losses에서 살펴보겠습니다!
2. Attention Supervision Losses
앞서 3.2에서는 style token에 대한 attention map을 추출하고 GT mask와 비교할 준비까지 마쳤습니다!
그럼 이제 이 attention map을 실제 객체 영역과 어떻게 일치하도록 학습시킬까요?
저자들은 이를 위해 Focus Loss와 Cover Loss라는 두 가지 loss를 제안합니다
두 loss는 각각 attention이 올바른 객체 영역에 집중되도록 하고, 해당 객체 전체에 충분히 분포하도록 유도하는 역할을 합니다!
[ Focus Loss ]
먼저 Focus Loss는 예측한 attention map의 공간적인 분포가 실제 객체 mask와 일치하도록 유도하는 loss입니다
이를 위해 저자들은 예측한 attention map과 GT mask를 각각 확률분포로 정규화한 후, 두 분포 사이의 KL divergence를 최소화합니다!
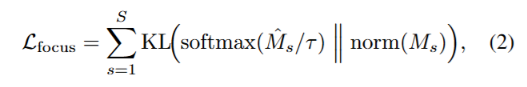
여기서 \hat{M}_s는 앞서 추출한 style attention map이고, M_s는 GT mask를 의미합니다
\tau는 softmax의 temperature로 attention 분포가 얼마나 뾰족하게 집중될지를 조절하는 값이며, \mathrm{norm}(M_s)는 mask의 전체 합이 1이 되도록 정규화한 것입니다
즉 attention이 객체 밖으로 퍼지지 않고 실제 객체 영역에 집중되도록 두 분포의 차이를 줄이는 것이죠!
[ Cover Loss ]
그런데 Focus Loss만으로는 한 가지 문제가 남아 있습니다
attention이 올바른 객체 영역에 집중되더라도 객체의 일부분에만 몰릴 수 있다는 것인데요!
예를 들어 고양이 전체에 스타일을 적용해야 하는데 attention이 얼굴에만 집중된다면 원하는 결과가 아니겠죠?!
이를 해결하기 위해 저자들은 객체 전체에 attention이 충분히 분포하도록 유도하는 Cover Loss를 추가합니다
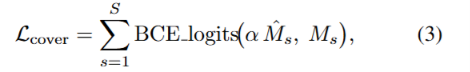
Cover Loss는 BCE(Binary Cross-Entropy)를 이용해 각 위치의 attention을 GT mask와 비교하는 방식입니다
여기서 M_s=1인 객체 내부에서는 높은 attention을 갖도록 유도하고, M_s=0인 객체 외부에서는 attention을 낮추도록 학습시킵니다
또한 \alpha는 attention 값의 크기를 증폭시켜 더 강한 gradient를 얻기 위한 contrast factor입니다!
즉 객체의 특정 부분에만 attention이 집중되지 않고 전체 영역을 충분히 커버하도록 만드는 것이죠!!
결국 두 loss를 함께 사용해서 Focus Loss는 attention이 올바른 객체 영역에 집중되도록 하고, Cover Loss는 해당 영역 전체에 attention이 분포하도록 유도하는 것입니다!
실제로 두 loss를 각각 사용했을 때와 함께 사용했을 때의 차이는 이후 Experiment의 Figure 4에서 확인할 수 있습니다!
3. LoRA-MoE Adaptation
이번에는 여러 스타일을 효율적으로 학습하기 위한 LoRA-MoE 구조를 살펴보겠습니다!
일반적으로 하나의 LoRA에 여러 스타일을 함께 학습시키면 스타일 간 간섭이 발생하거나 각 스타일의 표현력이 떨어질 수 있는데요
저자들은 이를 해결하기 위해 스타일별로 독립적인 LoRA expert를 두는 방식을 사용합니다!
예를 들어 pixel art, cyberpunk, expressionism 등의 스타일을 하나의 LoRA에 모두 학습시키는 것이 아니라 각각의 스타일을 담당하는 expert를 따로 두는 것이죠!!
이때 모든 expert는 동일한 diffusion backbone을 공유합니다
여기서 중요한 건 backbone과 LoRA expert의 역할을 구분했다는 점입니다!
앞서 attention supervision을 통해 학습한 backbone은 스타일을 어디에 적용할지(Where) 에 대한 공간적 정보를 담당하고, 각 LoRA expert는 해당 스타일을 어떻게 표현할지(How) 를 담당하도록 설계한 것이죠!
그럼 실제 학습은 어떻게 진행될까요?
학습 시에는 현재 스타일에 해당하는 expert만 활성화하고, 공통 backbone은 frozen 상태로 유지해 이전에 학습한 공간적 대응 관계가 변하지 않도록 합니다
추론 시에는 입력된 style token에 따라 적절한 expert를 선택하는 방식인데요
예를 들어 (Make the cat in pixel-art style)이라는 프롬프트가 들어오면 pixel art를 담당하는 expert를 선택하는 것이죠!
이렇게 하면 각 expert가 서로 다른 스타일에 특화될 수 있고, 새로운 스타일을 추가할 때도 전체 backbone을 다시 학습할 필요 없이 해당 스타일의 expert만 학습하면 됩니다
결국 공간적인 정보는 공통 backbone에서 유지하면서 스타일 표현은 각 LoRA expert가 담당하도록 분리한 구조라고 이해하면 될 것 같습니다!
(다만 논문에서는 expert를 선택하는 router의 구체적인 구현이나 backbone의 공간적 학습과 expert 학습을 어떻게 단계별로 진행했는지까지 자세히 설명하지는 않습니다!)
4. Training Objective
마지막으로 앞서 살펴본 loss들을 어떻게 결합해서 학습하는지 살펴보겠습니다!
저자들은 기존 diffusion model의 생성 목적을 유지하면서, attention이 올바른 객체 영역에 정렬되도록 두 가지 loss를 추가합니다
최종 학습 objective는 아래의 수식(4)와 같습니다!
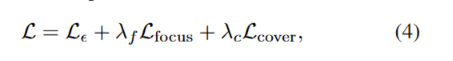
여기서 각 loss의 역할은 다음과 같습니다
- \mathcal{L}_{\epsilon} : 예측한 noise와 실제 noise의 차이를 최소화하는 기본 생성 loss
- \mathcal{L}_{\mathrm{focus}} : attention이 목표 객체 영역에 집중되도록 유도
- \mathcal{L}_{\mathrm{cover}} : 객체 전체에 attention이 충분히 분포하도록 유도
또한 \lambda_f와 \lambda_c는 두 attention loss의 영향력을 조절하는 가중치입니다!
즉 기존 이미지 생성 능력을 유지하면서 스타일이 적용될 위치까지 함께 학습하도록 설계한 것이죠!
이렇게 해서 RegionRoute의 전체 Method를 살펴보았슴다~!!
Regional Style Editing Score
이번에는 저자들이 새롭게 제안한 평가 지표인 Regional Style Editing Score (RSE-Score) 를 살펴보겠습니다!
기존의 FID나 CLIP-similarity 같은 지표들은 주로 이미지 전체의 품질이나 스타일 유사도를 평가하는데요
하지만 이 논문처럼 특정 객체에만 스타일을 적용하는 경우에는 이것만으로 충분하지 않습니다!
예를 들어 고양이만 pixel-art 스타일로 바꾸라고 했는데 배경까지 전부 pixel-art로 바뀌었다면 어떨까요?!! 스타일 자체는 잘 표현했을지 몰라도 원하는 편집 결과는 아니겠죠!
따라서 저자들은 스타일이 목표 영역에 잘 적용됐는지와 편집하지 않은 영역이 얼마나 잘 보존됐는지를 함께 평가하기 위해 RSE-Score를 제안합니다
평가는 크게 두 가지로 나뉩니다
- Regional Style Matching (RSM) : 목표 객체에 원하는 스타일이 얼마나 잘 적용됐는지 평가
- Identity Preservation : 편집하지 않은 배경 영역이 원본과 얼마나 유사하게 유지됐는지 평가
이때 원본 이미지는 x, 편집된 이미지는 \hat{x}, 목표 객체의 binary mask는 M으로 정의합니다
mask에서 M_p=1은 목표 객체 영역을, M_p=0은 배경 영역을 의미하며 배경은 1-M으로 나타냅니다
그럼 각각의 지표를 어떻게 계산하는지 살펴보겠습니다!
1. Regional Style Matching (RSM)
먼저 RSM은 목표 객체 영역에 원하는 스타일이 얼마나 잘 적용됐는지 평가하는 지표입니다!
저자들은 이를 위해 전체 이미지를 사용하는 대신 GT mask를 기준으로 목표 객체를 감싸는 최소 bounding box 영역을 crop합니다. 이때 객체 주변에 약간의 padding도 추가해 줍니다
이렇게 얻은 crop 이미지와 목표 스타일을 설명하는 text 사이의 유사도를 CLIP을 이용해 계산하는 것이죠!
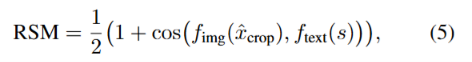
구체적인 수식은 위의 수식(5)와 같습니다
여기서
은 목표 객체를 crop한 이미지이고,
f_{img}와 f_{text}는 각각 CLIP의 image encoder와 text encoder를 의미합니다
또한 s는 목표 스타일을 설명하는 text이며, 두 embedding 사이의 cosine similarity를 계산한 후 latex/2[/latex]를 통해 0~1 범위로 변환합니다!
즉 전체 이미지가 아닌 목표 객체 영역만을 기준으로 원하는 스타일과 얼마나 유사한지 평가하는 방식입니다
이렇게 하면 배경의 영향을 줄이고 실제 편집 대상의 스타일 적용 정도에 집중해서 평가할 수 있겠죠!
2. Identity Preservation
앞서 RSM이 목표 객체에 스타일이 얼마나 잘 적용됐는지를 평가했다면, 이번에는 편집하지 않은 배경 영역이 얼마나 잘 보존됐는지 평가할 차례입니다!
저자들은 이를 위해 LPIPS와 MSE라는 두 가지 지표를 사용합니다
[ Perceptual Consistency (LPIPS) ]
먼저 LPIPS는 원본 이미지와 편집된 이미지 사이의 시각적인 차이를 측정하는 지표입니다
여기서는 일반적인 LPIPS와 달리 편집하지 않은 배경 영역에 대해서만 LPIPS를 계산합니다!
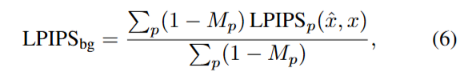
여기서 \mathrm{LPIPS}_p(\hat{x},x)는 편집된 이미지와 원본 이미지 사이의 픽셀 위치 p에 해당하는 perceptual difference를 의미합니다
또한 1-M_p를 곱해서 목표 객체 영역은 제외하고 배경 영역의 차이만 계산하는 것이죠!
즉 배경이 원본과 시각적으로 얼마나 유사하게 유지됐는지 평가하는 지표이며, 값이 낮을수록 좋습니다!
[ Pixel Consistency (MSE) ]
다음으로 MSE는 원본 이미지와 편집된 이미지 사이의 픽셀 값 차이를 측정하는 지표입니다
LPIPS가 시각적인 특징의 차이를 평가한다면 MSE는 실제 픽셀 값이 얼마나 달라졌는지를 평가한다는 차이가 있습니다!
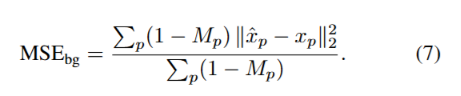
여기서 \hat{x}_p와 x_p는 각각 편집된 이미지와 원본 이미지의 픽셀 값을 의미합니다
두 픽셀 값의 차이를 제곱한 후 1-M_p를 이용해 배경 영역에서만 평균을 계산하는 방식입니다!
여기서도 마찬가지로 값이 낮을수록 원본 배경이 잘 유지됐다는 의미가 됩니다!!
결국 저자들은 RSM으로 목표 영역의 스타일 적용 정도를 평가하고, LPIPS와 MSE로 편집하지 않은 영역의 보존 정도를 평가하는 것이죠!
이렇게 세 가지 지표를 함께 사용하면 스타일이 잘 적용됐는지뿐만 아니라 원하지 않는 영역까지 변경되지는 않았는지도 확인할 수 있습니다!
EXPERIMENT
이제 제안하는 RegionRoute의 성능을 실험을 통해 확인해 보겠습니다!
1. Experimental Setup
먼저 저자들은 Grounded COCO 데이터셋에서 150개의 image-caption pair를 선택하고, 각 이미지에서 하나의 목표 객체와 해당 객체의 segmentation mask를 사용합니다
학습을 위한 GT 이미지는 기존 diffusion 기반 style transfer 모델로 스타일을 적용한 뒤, 이를 원본 이미지와 합성하는 방식으로 생성하는데요!
이렇게 만들어진 이미지를 pseudo-GT로 사용합니다!
스타일은 pixel art, cyberpunk, expressionism, line art 총 4가지를 사용하며 각 스타일당 150개씩 총 600개의 학습 샘플을 구성했습니다
학습 설정은 다음과 같습니다
- Backbone: Flux.1-Kontext
- Resolution: 1024 × 1024
- LoRA rank: 4
- Loss weights: Focus 0.1 / Cover 0.2
평가는 COCO, Pascal VOC, BIG 세 가지 데이터셋에서 진행하며, 앞서 설명한 RSM, LPIPS_bg, MSE_bg를 이용해 성능을 비교합니다!
그럼 실제 생성 결과와 정량적인 성능을 살펴보겠습니다!
2. Main Results
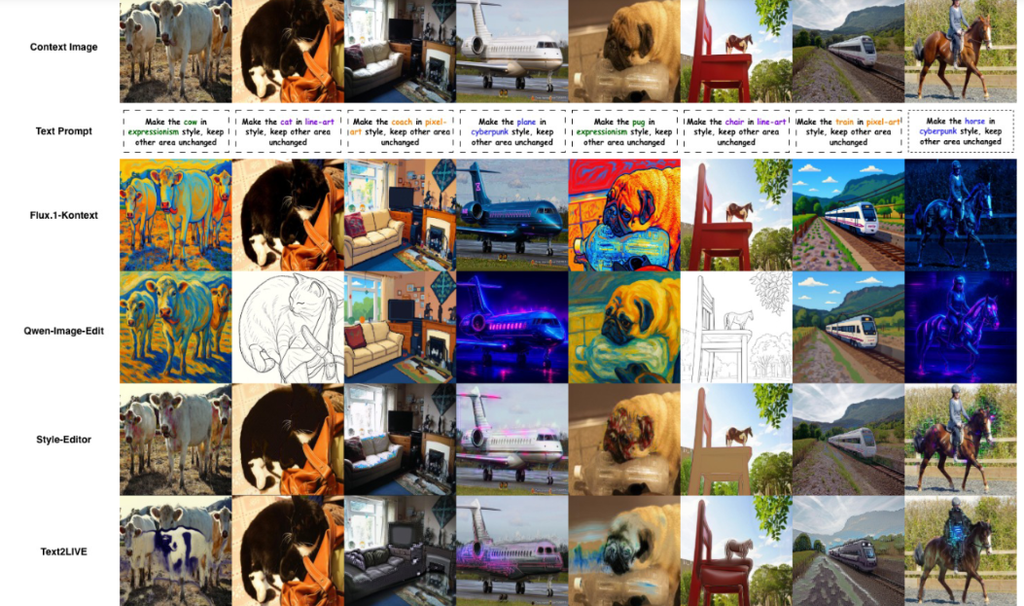
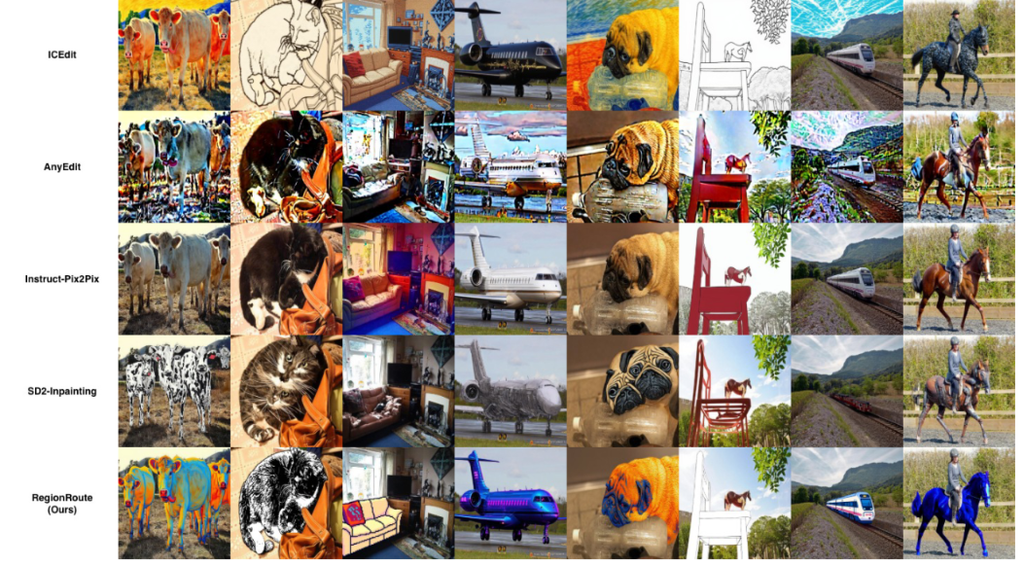
먼저 위의 fig.3 은 기존 모델들과 RegionRoute의 생성 결과를 비교한 실험입니다
기존 모델들은 목표 객체뿐만 아니라 배경까지 스타일이 적용되거나 변형되는 모습을 보이는데요
반면에 RegionRoute는 목표 객체에 스타일을 적용하면서 주변 배경은 비교적 잘 유지하는 모습을 보여줍니다!저자들은 이를 통해 RegionRoute가 불필요한 영역의 변형을 줄이면서 시각적인 일관성을 유지할 수 있다고 분석합니다
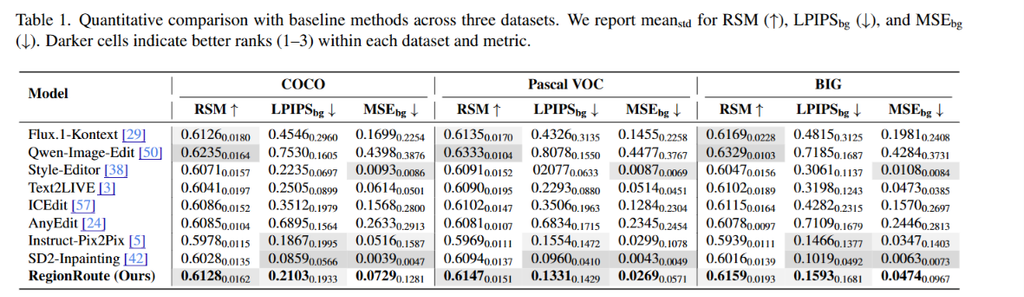
위의 Table 1은 COCO, Pascal VOC, BIG 데이터셋에서 RSM(↑), LPIPS_bg(↓), MSE_bg(↓)를 비교한 결과입니다RegionRoute가 모든 지표에서 가장 좋은 성능을 보이는 것은 아닌데요
예를 들어 COCO에서 Qwen-Image-Edit은 RSM이 0.6235로 RegionRoute(0.6128)보다 높지만, LPIPS_bg는 0.7530으로 RegionRoute(0.2103)보다 훨씬 높게 나타납니다
즉 스타일은 잘 표현하지만 배경까지 변형되는 문제가 크다는 것이죠!
저자들은 RegionRoute가 스타일 표현력을 유지하면서도 배경의 변형을 줄여 스타일 정확도와 배경 보존 사이에서 좋은 균형을 보여준다고 분석합니다
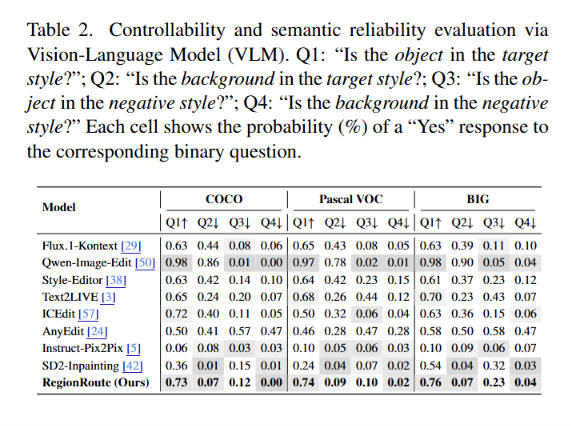
위의 Table 2는 Qwen2.5-VL-7B-를 이용해 스타일이 실제로 원하는 영역에만 적용됐는지 평가한 실험입니다!
총 4가지 질문을 사용하지만 여기서 중요한 건 Q1(목표 객체에 스타일이 적용됐는가?)과 Q2(배경에도 스타일이 적용됐는가?) 입니다
COCO에서 Qwen-Image-Edit은 Q1이 0.98, Q2가 0.86으로 목표 객체와 배경 모두에 스타일이 적용되는 경향을 보였습니다
반면 RegionRoute는 Q1이 0.73, Q2는 0.07로 목표 객체에 스타일을 적용하면서 배경으로의 style leakage를 크게 줄인 것을 확인할 수 있습니다!
저자들은 이를 통해 RegionRoute가 지역별 스타일 제어와 배경 보존을 함께 달성할 수 있다고 분석합니다
3. Ablation study
마지막으로 각 구성 요소들이 실제로 성능에 어떤 영향을 주는지 확인해 보겠습니다!
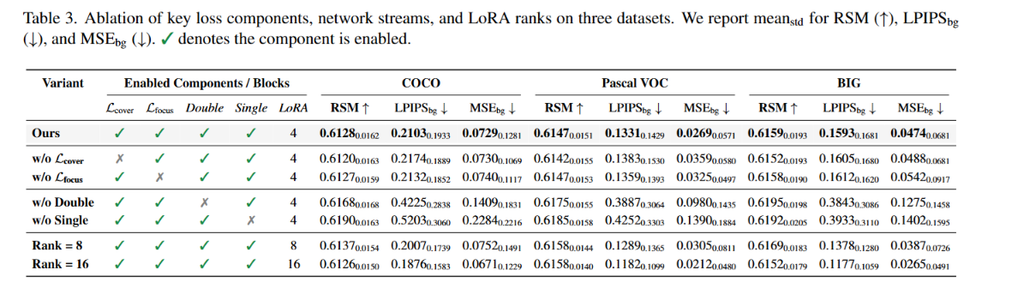
위의 table 3은 Focus/Cover Loss, transformer block에 적용된 LoRA, 그리고 LoRA rank를 변경하면서 성능을 비교한 실험입니다
먼저 Focus Loss나 Cover Loss 중 하나를 제거하면 전반적으로 성능이 저하되는 모습을 보이는데 요 결과는는 두 loss가 함께 사용될 때 더 정확한 영역 제어가 가능하다는 것을 보여준다고 합니다
또한 Flux.1-Kontext의 double stream이나 single stream 중 하나에서 LoRA를 제거하면 RSM은 소폭 증가하지만 LPIPS_bg와 MSE_bg가 크게 증가합니다. 저자들은 스타일 자체는 잘 표현하더라도 배경을 유지하는 능력은 떨어진다! 라고 해석합니다
마지막으로 LoRA rank를 4에서 8, 16으로 증가시키면 특히 배경 보존 지표가 개선되는 경향을 보입니다
저자들은 이를 통해 두 종류의 transformer block을 모두 활용하는 것이 중요하며, 낮은 rank에서도 비교적 효율적인 학습이 가능하다고 분석합니다!
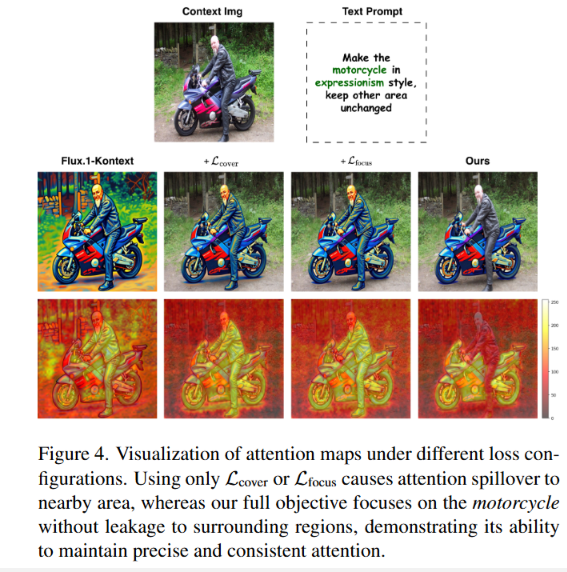
마지막의로 위의 fig.4는 Focus Loss와 Cover Loss의 유무에 따라 attention map이 어떻게 달라지는지 시각적으로 비교한 실험입니다!
그림을 보면 두 loss 중 하나만 사용했을 때는 목표 객체인 오토바이 주변으로 attention이 퍼지는 모습을 보이는데요! 반면에 두 loss를 함께 사용하면 attention이 오토바이 영역에 더 정확하게 집중되는 것을 확인할 수 있습니다!
저자들은 이를 통해 Focus Loss와 Cover Loss를 함께 사용하는 것이 attention leakage를 줄이고 정확한 공간적 제어를 가능하게 한다고 분석합니다
개인적으로 이번 논문은 attention을 활용해서 스타일이 적용될 위치를 직접 학습시킨다는 점이 흥미로웠습니다!
현재 진행 중인 정원 생성 과제에서도 특정 식물을 원하는 영역에 배치하면서 전체적인 조화를 유지하는 게 중요한데요
물론! 이 논문은 식물의 identity보다는 지역별 style transfer를 다루고 있어서 그대로 적용하기는 어렵겠지만 식재 영역의 mask를 활용해 attention을 지도학습하는 방식은 참고해 볼 만한 것 같습니다..!!
특히 기존에 고민하던 LoRA 간섭이나 공간적 제어 문제와도 연결되는 부분이 있어서 이후 실험에 활용할 수 있을지 검토해 보면 좋을 것 같네요!
이상으로 리뷰 마치겠습니다!
리뷰 잘 읽었습니다. 우선 기존 mask 기반 합성 방식은 객체와 배경의 경계에서 이질감이 발생할 수 있다는 점을 문제 삼은 것 같은데요. 그런데 학습에 사용한 pseudo-GT도 스타일이 적용된 이미지와 원본 이미지를 mask로 합성해 생성했다고 하셔서 조금 의문이 드는 것 같습니다. 그러니까 pseudo-GT에 존재할 수 있는 경계 artifact를 모델이 그대로 학습할 가능성도 있을 것 같은데, 논문에서 이런 문제를 어떻게 다뤘는지 언급한게 있나요?