안녕하세요, 오늘 소개할 논문은 CVPR 2025 논문인 MANTA입니다. 해당 연구는 제가 직전 엑스리뷰로 작성했고 랩세미나 때도 소개드린 Gated Temporal Diffusion 논문 저자들의 후속 연구로, generator에서 조금 더 시간적으로 먼 거리에 있는 시점 간의 정보도 잘 담을 수 있는 방법을 develop시킨 연구라고 보시면 되겠습니다. 사실 이 논문으로 dense anticipation이라는 task를 처음 접했었는데, 본 연구의 저자들이 Gated Temporal Diffuision에서 처음으로 본 task에 diffuision model을 적용하고, 자기들 연구의 문제를 자기들이 해결하면서 지금 소개할 MANTA, 이후 MixANT(ICCV 2025) 까지 다루면서 본인들만 하는 연구? 같긴 하다는 느낌은 들었네요.
Long-Term Dense Anticipation
이전에 리뷰했던 Ego4D의 Long-term Action Anticipation(LTA)에서는 1인칭 비디오를 보고, 이후에 어떤 행동들이 어떤 순서로 이어질지를 예측합니다. 예를 들면 (take, cup) → (pour, water) → (drink, water)처럼 미래에 이어질 행동을 (동사, 명사) 쌍의 시퀀스로 예측하는 것입니다.
이번 논문에서 다루는 dense anticipation에서는 앞으로 이어질 N개의 프레임 각각에 대해 action label을 예측합니다. 위 예시로 보면, ‘컵을 집는다’ 다음에 ‘물을 붓는다’가 온다는 순서에 더해, 몇 번째 프레임에서 물을 붓기 시작하고 그 행동이 몇 프레임 동안 이어질지까지 예측하는 셈입니다. 이렇게 같은 action label이 연속으로 나타나는 구간을 보면 각 행동의 지속시간(duration)도 알 수 있습니다.
또한 본 논문은 stochastic dense anticipation을 다루는데, stochastic은 같은 과거 영상에 대해 여러 개의 가능한 미래 행동 시퀀스를 예측한다는 뜻입니다. 예를 들어 컵을 집는 장면까지 봤다면, 이후에 컵에 물을 따를 수도 있고 컵을 씻을 수도 있겠죠. 이처럼 하나의 observation에서 여러 미래가 가능하다는 점을 반영해, 모델이 프레임별 action label로 이루어진 시퀀스를 여러 개 생성하는 setting입니다.
Intro
이전 연구인 GTDA에서는 과거에 어떤 행동이 일어났는지에 대한 불확실성까지 고려하기 위해, 하나의 diffusion 모델로 과거와 미래의 action label을 함께 예측했습니다. 이때 관찰한 프레임에서는 visual feature를 뽑고, 아직 볼 수 없는 미래 구간은 프레임 수만큼 0으로 채워서 diffusion의 condition으로 사용합니다. 궁금하신 분들은 제 이전 엑스리뷰를 참고하시면 되겠습니다. (GTDA) 여기서 이번 논문의 저자들이 주목한 부분은 “과거의 visual feature가 zero padding된 미래 구간의 끝까지 얼마나 잘 전달되는가”입니다.
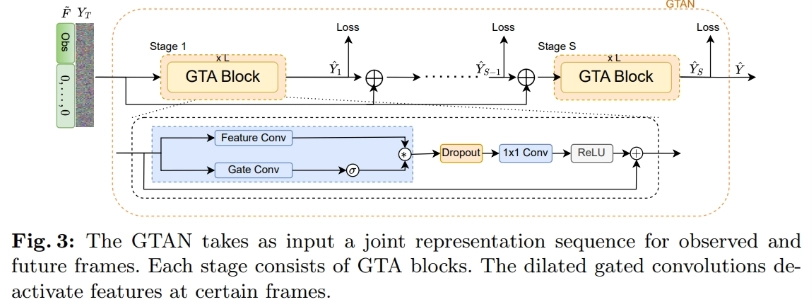
feature conv, gate conv에는 dilated conv가 적용됨
기존 GTDA의 generator인 GTAN은 dilated temporal convolution을 사용하여 정보를 정제하고 clean action vector를 추정합니다. 이때 GTAN 내부의 GTA Block이 위 그림처럼 여러 stage동안 반복되며 각 stage마다 clean action vector를 추정하는데, 각 stage의 초기 layer에서는 dilation이 작아 가까운 프레임만 볼 수 있습니다. 미래 구간의 맨 끝 프레임에서 보면, 주변의 visual feature가 전부 0이기 때문에 이 layer에서는 과거에 어떤 행동을 봤는지 알 수가 없는 것이죠. 뒤쪽 layer로 갈수록 receptive field가 넓어지긴 하지만, 작은 kernel이 멀리 떨어진 몇몇 위치만 띄엄띄엄 참조한다는 한계가 있습니다. GTAN은 여러 stage를 쌓아 이를 어느 정도 보완했는데, 예측 구간이 길수록 과거 정보를 전달하기 어렵고 stage를 쌓는 만큼 연산량도 늘어납니다.
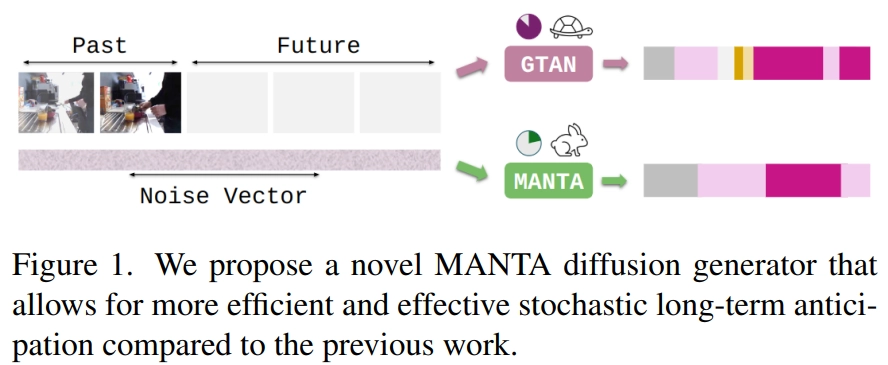
이에 저자들은 GTDA의 diffusion 설정은 그대로 두고, 기존 generator인 GTAN을 Mamba 기반의 MANTA(MAmba for ANTicipation)로 교체합니다. MANTA는 첫 layer부터 시퀀스 전체를 receptive field로 갖기 때문에, GTAN처럼 여러 stage를 쌓지 않아도 먼 미래의 프레임을 예측할 때 과거 프레임의 정보를 활용할 수 있습니다. 또한 Mamba의 gating을 통해 각 시점에서 어떤 정보를 전달할지 조절하며, 연산량은 시퀀스 길이에 비례해 증가합니다. MANTA는 Breakfast, 50Salads, Assembly101에서 SOTA를 달성했고, 추론 시간에서도 상당한 개선 폭을 보였습니다. 실제로 Breakfast에서 비디오 하나당 25개의 action sequence를 생성하는 데 GTDA는 평균 71.8초가 걸렸는데, MANTA는 이를 1.1초 만에 생성했다고 합니다.
Contributions
- Mamba 기반 diffusion generator인 MANTA를 제안하여 첫 layer부터 과거 프레임의 정보를 미래 구간 전체에 전달함.
- Single-stage 구조로 긴 시퀀스를 O(n)으로 처리하며, Breakfast에서 GTDA 대비 추론 속도 65.3배, 학습 속도 6.6배 향상.
- Breakfast, 50Salads, Assembly101에서 stochastic long-term dense anticipation SOTA 달성.
Related Work – Mamba
Mamba를 이해할 때는 LSTM에서 이전 시점의 기억을 다음 시점으로 넘겨주는 cell state/hidden state를 떠올리면 편합니다. 예를 들어 사람이 컵을 집은 뒤 잠시 손이 화면 밖으로 나갔다고 해보겠습니다. 다음 행동을 예측하려면 현재 프레임에 컵이 보이지 않더라도 조금 전에 컵을 집었다는 정보가 여전히 유용하겠죠. Mamba도 지금까지 본 정보를 hidden state에 요약해 두고, 새로운 입력이 들어올 때마다 어떤 정보를 남길지 조절하는 시퀀스 모델입니다. 이 역할을 하는 부분이 Mamba의 Selective State Space Model(SSM)입니다.
현재 시점의 입력 feature를 x_t, 이전 시점까지의 정보를 담은 state를 h_{t-1}이라고 하면, Mamba의 SSM은 다음과 같이 state를 갱신합니다.
h_t = \bar{A}_t h_{t-1} + \bar{B}_t x_t
쉽게 보면 첫 번째 항은 이전 state에서 가져올 정보, 두 번째 항은 현재 입력에서 새로 받아들일 정보입니다. S4와 같은 기존 SSM은 모든 시점에 같은 \bar{A}, \bar{B} 를 사용했는데, Mamba에서는 현재 입력 x_t에 따라 이 값들이 달라집니다. LSTM의 forget gate와 input gate를 생각하면 역할은 비슷하다고 볼 수 있는데, 다만 LSTM은 이전 hidden state와 현재 입력을 함께 보고 gate 값을 정하고, Mamba의 SSM은 현재 입력 feature로 갱신 계수를 정한 뒤 그 계수를 이전 state와 현재 입력에 각각 적용합니다. 어떤 정보를 오래 기억해야 하는지는 따로 지정해 주지 않고, MANTA의 경우 과거와 미래의 action label을 복원하는 과정에서 학습됩니다.
각 시점에서 고정된 크기의 state를 갱신하기 때문에 시퀀스 길이가 N이면 연산량은 (O(N))입니다. 또 학습할 때처럼 전체 입력이 주어지면 각 시점의 갱신 계수를 미리 구할 수 있어서, 여러 시점의 연산을 묶어 병렬로 계산 가능하다는 장점이 있습니다. 이를 Parallel Scan이라고 합니다.
Method
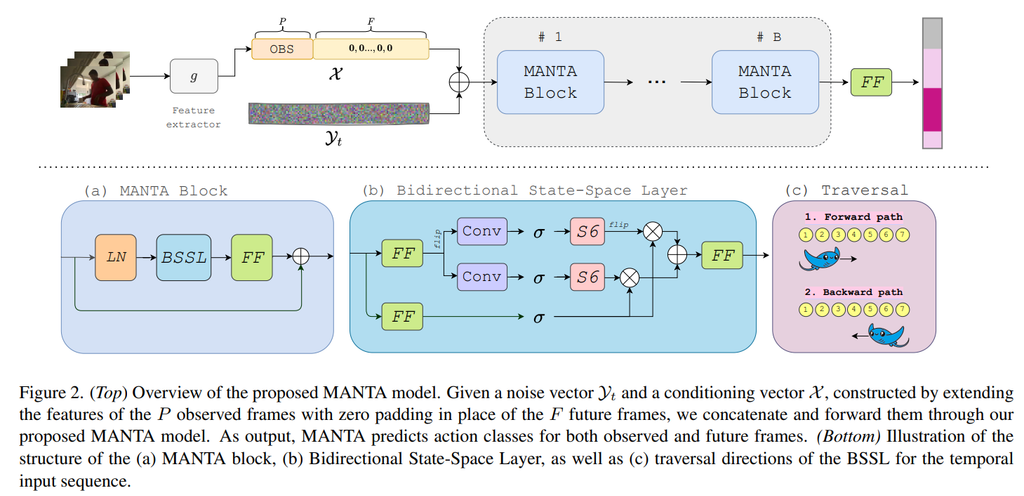
1. Diffusion for Dense Anticipation
본 파트는 dense anticipation task에 diffusion model을 적용하는 paradigm에 대한 파트로 이전 연구인 GTDA와 동일한 부분이지만 본 리뷰를 처음 보시는 분들을 위해 작성했습니다.
입력은 2가지입니다. 하나는 관찰한 비디오에서 뽑은 visual feature이고, 다른 하나는 diffusion 과정에서 복원할 noisy action sequence입니다. 이전에 리뷰했던 GTDA와 마찬가지로, 관찰한 영상은 condition으로 사용하고 과거와 미래의 프레임별 action label을 하나의 시퀀스로 묶어서 복원합니다.
관찰한 과거 프레임이 P 개이고 예측할 미래 프레임이 F 개라고 해보겠습니다. 우선 과거 프레임에서는 feature extractor g 를 통해 visual feature를 뽑습니다. 미래 프레임은 관찰할 수 없으니 해당 위치에는 zero padding을 넣어 다음과 같은 condition을 만듭니다.
\mathcal{X} = \big(g(x_1), \ldots, g(x_P), \underbrace{0, \ldots, 0}_{F}\big)
다른 입력인 \mathcal{Y}_t 는 과거와 미래 전체의 action label에 diffusion step t 만큼 noise가 섞인 시퀀스입니다. 두 입력은 길이가 P+F 로 같기 때문에, 같은 프레임에 해당하는 visual feature와 noisy action vector를 채널 방향으로 concat해서 generator에 넣습니다. 여기서 미래 구간을 확대해서 보면 visual feature 쪽은 0이지만, 그 옆에는 현재 denoising 중인 action vector가 들어 있습니다. 이 구분을 기억해 두시면 좋을 것 같습니다.
2. MANTA Generator
기본적으로 Generator는 입력(condition, noisy data)를 받아서 clean data를 복원/추정하는 모델입니다. 학습 땐 복원하도록, 추론(생성) 때는 추정하도록 설계됩니다. MANTA generator의 경우 먼저 큰 틀은 LayerNorm을 적용하고, Bidirectional State-Space Layer(BSSL)를 통해 프레임 사이의 정보를 주고받습니다. 이후 feed-forward layer가 각 프레임의 채널 정보를 섞어주는 흐름입니다. 저자들이 말하는 single-stage 구조는 여러 개의 MANTA Block으로 구성되며, 최종 모델에서는 15개의 block을 거친 뒤 마지막 Feed Forward layer가 현재 diffusion step 의 action sequence를 추정합니다. 마지막으로 과거와 미래 각 프레임의 action class별 score를 출력합니다. 참고로 action class는 (verb, noun) 쌍이 하나의 action class로 맵핑된 형태로써 일반적인 classfication task처럼 action class를 분류해낸다는 느낌을 가져가시면 되겠습니다.
다음은 본 논문의 핵심인 BSSL에 대해 다뤄보겠습니다. 예를 들어, 미래 구간의 5개의 프레임 중 세 번째 프레임의 action을 복원한다고 가정할 때 , 기본 Mamba처럼 시퀀스를 앞에서 뒤로 읽으면, 세 번째 위치까지 과거 영상 전체의 정보와 앞선 두 미래 위치의 정보가 전달됩니다. 즉, 세 번째 위치의 action을 복원할 때 네 번째와 다섯 번째 미래 위치의 정보는 이 경로를 통해 전달되지 않습니다. 하지만 4번째, 5번째 위치에도 현재 diffusion step에서 복원 중인 noisy action vector가 있고 이 미래의 정보가 현 시점 action을 예측에 영향을 줄 수 있습니다. 그래서 MANTA는 이 정보까지 활용하기 위해 Traversal, 같은 시퀀스를 역방향으로 읽는 경로를 추가합니다.
F_t^b 는 diffusion step t 에서 b 번째 block이 처리하는 feature sequence라고 할 때, 아래 식에서 화살표는 이 시퀀스를 프레임 순서대로 뒤집는 연산입니다.
W_t^b = \mathrm{S6}\big(\sigma(H^K * \mathrm{FF}(F_t^b))\big)
B_t^b = \mathrm{S6}\big(\sigma(H^K * \mathrm{FF}(\overleftarrow{F_t^b}))\big)
위 두 식은 각각 forward와 backward 경로에 해당합니다. 연산 순서는 같습니다. 먼저 linear projection을 거친 뒤, kernel size가 3인 depth-wise 1D convolution H^K 로 시간축에서 인접한 프레임의 정보를 채널별로 섞습니다. 이어서 SiLU activation \sigma 를 적용하고, Related Work에서 설명한 selective SSM인 S6로 시퀀스를 읽습니다. 즉 convolution은 가까운 프레임의 움직임을 반영하고, S6는 입력에 따라 어떤 정보를 state에 유지할지 조절하며 더 먼 위치까지 전달하는 식입니다. 이 과정을 원래 순서로 수행한 결과가 W_t^b 이고, 역순으로 수행한 결과가 B_t^b 입니다.
한편 아래쪽 residual branch에서는 원래 입력을 linear projection으로 채널 차원이 두 배가 되도록 확장한 뒤, SiLU를 적용해 R_t^b 를 만듭니다. 이 값은 두 경로에서 읽어온 정보를 각 프레임의 채널별로 얼마나 출력에 반영할지 조절하는 gate 역할을 합니다. 이후 forward 방향과 backward 방향의 결과를 합치기 전에, backward의 경우 프레임 순서가 아직 뱐대이기 때문에 다시 한 번 뒤집어 같은 프레임끼리 위치를 맞춥니다. 그다음 두 출력에 같은 R_t^b 를 각각 원소별로 곱하고, 두 결과를 더해 마지막 projection을 통과시킵니다.
O_t^b = \mathrm{FF}\big((W_t^b \odot R_t^b) + (\overleftarrow{B_t^b} \odot R_t^b)\big)
이를 통해 첫 BSSL부터 각 프레임의 action을 앞뒤 문맥 속에서 복원할 수 있고, 각 방향에서 시퀀스를 한 번씩 처리하므로 연산량도 시퀀스 길이에 대해 선형으로 유지됩니다.
3. Training & Inference
학습할 때는 과거와 미래 프레임의 GT action을 one-hot encoding해서 정답 시퀀스 \mathcal{Y}_0 를 만듭니다. 이후 diffusion step t 를 무작위로 뽑고, 해당 단계의 noise schedule에 따라 Gaussian noise를 섞어 \mathcal{Y}_t 를 얻습니다. Generator는 이 noisy sequence와 visual condition을 받아 noise를 섞기 전의 action sequence를 직접 추정합니다.
\widetilde{\mathcal{Y}}{0,t} = \mathcal{G}{\theta}(\mathcal{Y}_t, t, \mathcal{X})
학습에는 복원한 시퀀스 \widetilde{\mathcal{Y}}_{0,t} 와 정답 \mathcal{Y}_0 사이의 L_2 reconstruction loss를 사용합니다. 이때 loss를 과거와 미래 위치 모두에서 계산하기 때문에, 모델은 관찰 구간에서 어떤 행동이 일어났는지와 그 뒤에 어떤 행동이 이어지는지를 함께 학습하게 됩니다.
추론할 때는 관찰 영상으로 만든 condition을 고정하고, 과거와 미래 전체 길이의 Gaussian noise에서 시작합니다. 각 step에서 MANTA가 추정한 원본 action sequence를 이용해 다음 step의 입력을 갱신하며, DDIM sampling으로 학습 때보다 적은 step만 거쳐 최종 예측을 얻습니다. 여기서 같은 영상에 대해 시작 noise를 다르게 뽑으면 서로 다른 행동 시퀀스를 생성할 수 있다는 점이 stochastic anticipation과 연결됩니다. 실제 평가에서는 영상 하나당 25개의 시퀀스를 생성하고, 각 시퀀스의 미래 구간을 예측 결과로 사용합니다.
Experiments
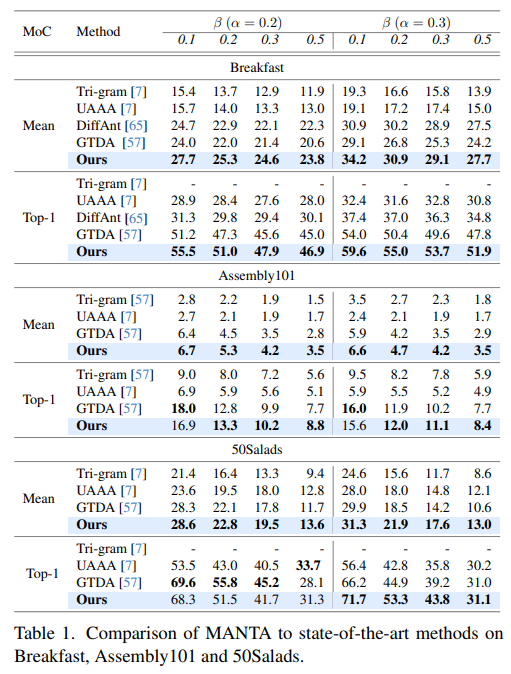
Table 1은 Breakfast, Assembly101, 50Salads에서 기존 방법들과 MANTA의 성능을 비교한 결과입니다. 먼저 표 위쪽의 \alpha 는 전체 영상에서 관찰하는 구간의 비율이고, \beta 는 전체 영상에서 미래 예측 구간이 차지하는 비율입니다. 예를 들어 가장 오른쪽 열인 \alpha=0.3,\ \beta=0.5 는 100초짜리 영상이라면 처음 30초를 보고 그 직후의 50초, 즉 30~80초 구간의 action을 예측하는 설정입니다.
평가 지표는 MoC(Mean over Classes)로, 각 action class에 대해 프레임 단위 정답률을 구하고, 이를 클래스별로 동일한 비중을 두어 평균한 값입니다. 여기서는 같은 영상을 보고 25개의 시퀀스를 생성하므로 Mean MoC와 Top-1 MoC를 함께 봅니다. Mean은 25개 예측이 평균적으로 얼마나 정확한지, Top-1은 그중 GT와 가장 잘 맞는 예측이 얼마나 정확한지를 보여줍니다. 따라서 Top-1을 보면 모델이 생성한 여러 후보 중 실제 미래에 가까운 시퀀스가 포함됐는지를 볼 수 있습니다. 두 지표 모두 높을수록 좋다고 보시면 됩니다.
먼저 Breakfast에서는 MANTA가 모든 관찰·예측 비율에서 Mean과 Top-1 모두 가장 높았습니다. 가장 오른쪽 열을 보면 GTDA 대비 Mean은 24.2→ 27.7, Top-1은 47.8→ 51.9로 올라갑니다. 다만 Assembly101에서는 가장 짧은 예측 구간인 \beta=0.1 에서 GTDA의 Top-1이 더 높습니다. 50Salads도 관찰 비율이 20%일 때는 MANTA가 Mean에서 앞서지만 Top-1에서는 기존 방법에 뒤집니다. 반면 관찰 비율을 30%로 늘리면 모든 예측 길이에서 두 지표 모두 MANTA가 가장 높습니다. 즉 세 데이터셋에서 가장 일관되게 개선된 쪽은 생성한 시퀀스들의 평균적인 정확도이고, 가장 잘 맞는 후보의 정확도는 관찰 구간의 길이에 따라서도 차이가 있었습니다.
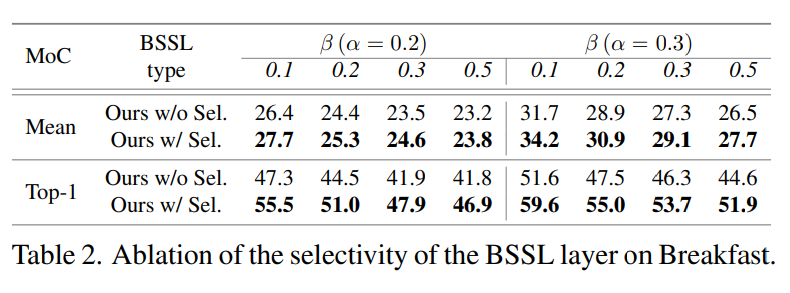
w/ Sel.은 앞서 설명한 selective SSM인 S6를 사용한 모델이고, w/o Sel.은 이를 S4로 교체한 모델입니다. S4도 학습되는 모델이지만, 한 시퀀스를 읽는 동안에는 모든 위치에 동일한 ‘상태 갱신 계수’를 사용합니다. 따라서 이 표에서는 현재 입력에 따라 이전 정보를 얼마나 남기고 새 정보를 얼마나 반영할지 조절하는 기능이 성능에 어떤 차이를 만드는지 확인해보고자 한 것입니다.
결과적으로 모든 setting에서 selectivity를 사용한 쪽의 성능이 높았고 top-1에서 특히 두드려졌습니다. 여기서 왜 이 task에서 selectivity가 중요한지 생각해 봤을 때, 결국 입력의 observation과 달리 미래 구간은 zero padding이 되어있기 때문에 저자들은 이 다른 성격의 두 구간을 하나의 시퀀스로 처리할 때 각 위치의 입력에 따라 정보의 반영 정도를 조절하는 것이 도움이 되었다고 해석했습니다.
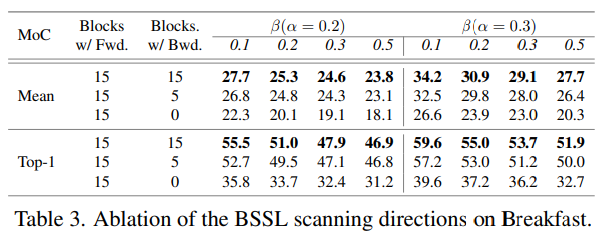
Table 3에서 Blocks w/ Fwd.는 forward 경로가 있는 block 수, Blocks w/ Bwd.는 backward 경로까지 있는 block 수입니다. 세 모델 모두 전체 block 수는 15개이고, 그중 몇 개를 양방향으로 처리하는지만 다릅니다. 위에서부터 15개 전부 양방향인 MANTA, 마지막 5개만 양방향인 모델, 15개 전부 forward로만 읽는 모델입니다.
이 table은 아래 행부터 위로 읽으면 차이가 잘 관찰되는데, \alpha=0.3,\ \beta=0.5 에서 forward만 사용하면 Top-1은 32.7인데, 마지막 5개 block에만 backward 경로를 추가해도 50.0까지 올라갑니다. 15개 모두 양방향으로 처리하면 51.9이고, Mean도 같은 순서로 20.3→26.4→ 27.7로 올라갑니다. 앞서 Method에서 정방향만으로도 과거 관찰 정보는 먼 미래 위치까지 전달될 수 있다고 했는데, 이 결과를 보면 뒤쪽 미래 위치에서 복원 중인 action 정보도 함께 참조하는 것이 예측에 상당히 도움이 됩니다. 특히 마지막 5개 block에 역방향 경로를 넣는 것만으로도 성능 차이의 상당 부분을 회복했다는 점이 인상적입니다.
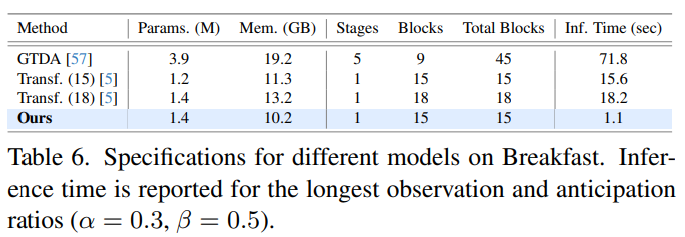
마지막으로 Table 6은 Breakfast에서 모델별 파라미터 수, 메모리 사용량, generator 구조, 추론 시간을 비교한 표입니다. GTDA와 MANTA를 비교하면 파라미터 수는 3.9M에서 1.4M으로, 메모리 사용량은 19.2GB에서 10.2GB로 줄었습니다. 가장 큰 차이는 추론 시간인데, 동일한 25개 예측을 생성하는 데 GTDA는 71.8초, MANTA는 1.1초가 걸려 약 65.3배 빨라졌습니다. 여기서 같이 볼 만한 행이 Transf. (15)입니다. MANTA와 동일하게 1개 stage에 15개 block을 쓰면서 block을 Transformer 기반으로 교체한 모델인데, 추론에는 15.6초가 걸렸습니다. 즉 stage와 block 수를 똑같이 맞춘 비교에서도 MANTA block을 사용한 쪽이 긴 프레임 시퀀스를 더 빠르게 처리했습니다.