오늘은 VLM 이 객체의 이름뿐 아니라 그 객체를 설명하는 속성(Attribute)까지 제대로 이해하고 있는가에 대한 분석을 다룬 논문입니다.
여기서 객체를 설명하는 속성을 이해한다는 뜻은 무엇일까요? 예를 들어 CLIP이 bear를 잘 인식한다고 해봅시다. 그렇다면 brown bear와 black bear도 제대로 구분할까요? 더 나아가 brown이라는 단어가 실제로 시각적 특징과 연결되어 있을까요? 이를 살펴본 논문입니다. 리뷰 시작하겠습니다.
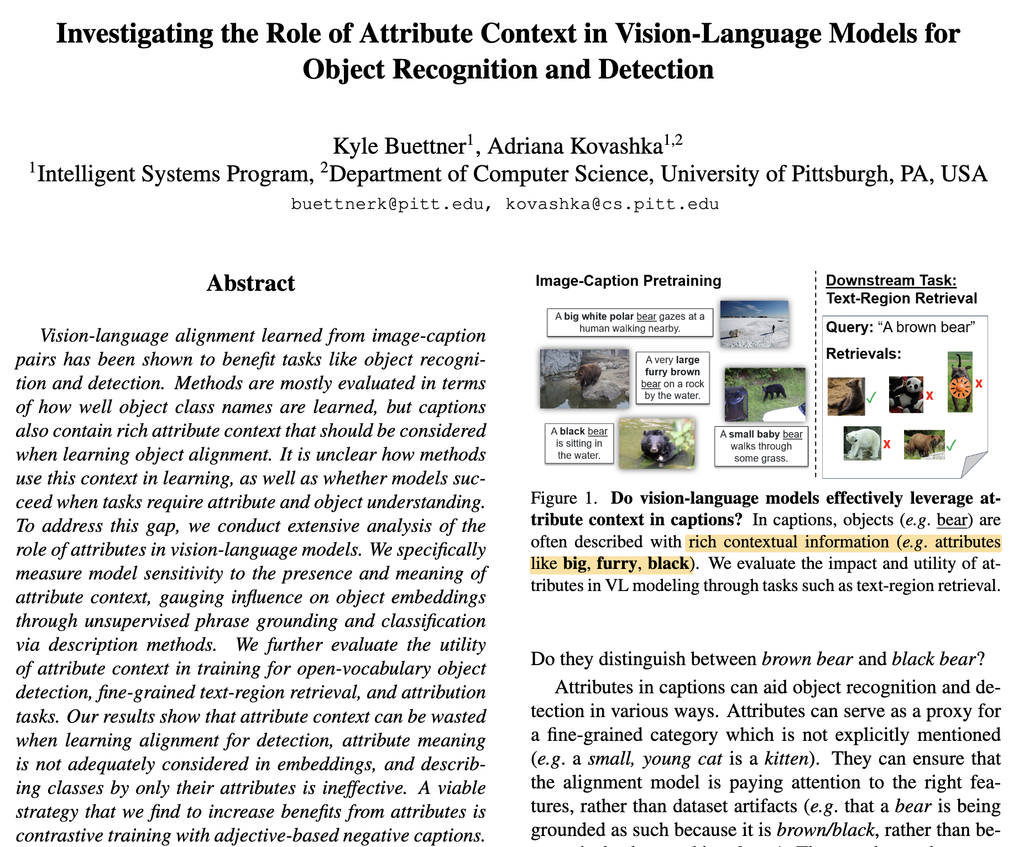
- Venue: WACV 2024
- Authors: Kyle Buettner, Adriana Kovashka
- Affiliation: Intelligent Systems Program
- Title: Investigating the Role of Attribute Context in Vision-Language Models for Object Recognition and Detection
0. Background
부제 – Attribute Context in Vision-Language Models
너무나도 익숙한 CLIP 같은 VLM들은 대규모 Image-Caption Pair를 통해 이미지와 텍스트 사이의 Alignment를 학습합니다. 이러한 모델은 bear라는 단어를 통해 곰을 잘 인식한다고 알려져 있죠. 그런데 실제 Caption에는 객체 이름뿐 아니라 색상, 크기, 질감과 같은 Attribute 정보도 포함되어 있습니다.
예를 들어, a large furry brown bear라는 Caption에는 객체인 bear와 함께 large, furry, brown이라는 속성이 담겨 있습니다. 그렇다면 모델은 bear를 학습하면서 이러한 속성까지 함께 이해하게 될까요?
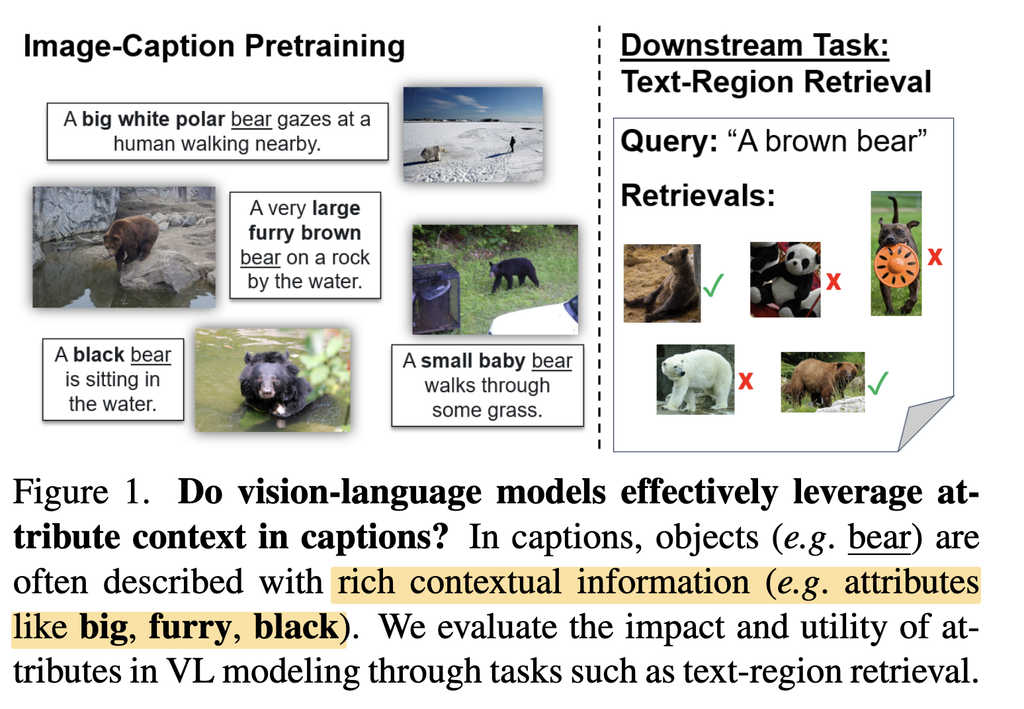
상단 Figure 1처럼 a brown bear를 검색한다면, 단순히 곰을 찾는 것을 넘어 검은 곰과 갈색 곰을 구별할 수 있어야 합니다. 즉, 객체를 인식하는 능력과 객체의 속성까지 이해하는 능력은 서로 다를 수 있습니다.
이 논문은 이러한 문제의식에서 출발해, VLM이 Caption에 포함된 Attribute Context를 실제로 얼마나 활용하고 있는지 살펴봅니다.
1. Introduction
부제 – Do VLMs Really Understand Attributes?
앞서 살펴본 것처럼 VLM이 객체를 잘 인식한다고 해서, 그 객체의 Attribute까지 제대로 이해한다고 단언하긴 어렵습니다. 그렇다면 VLM은 객체를 인식할 때 Attribute 정보를 실제로 활용하고 있을까요?
이를 확인하기 위해 저자들은 두 가지 모델을 사용해서 분석을 진행해보았습니다.
- OVR-CNN: Caption의 단어와 이미지 영역을 연결하는 Region-Word Alignment 모델 (BERT, ResNet)
- CLIP: 이미지와 텍스트의 유사도를 학습하는 Image-Text Alignment 모델
저자들은 먼저 Caption에서 Attribute를 제거하거나 다른 속성으로 변경했을 때, Object Detection과 Classification 성능이 어떻게 달라지는지 살펴보았습니다.
디테일한 내용은 다음 섹션에서 알아보겠지만.. 실험 결과, Attribute를 제거하거나 잘못된 속성으로 변경해도 모델의 성능은 크게 달라지지 않았다고 합니다. 반면 객체의 Class Name을 제거하면 CLIP의 분류 성능은 급격히 감소했죠.
이는 VLM이 객체를 인식하는 과정에서 Attribute보다 Class Name에 크게 의존할 가능성을 보여주는 결과라고 볼 수 있습니다. 이것말고도 저자들은 이를 해결하기 위한 간단한 해결책도 제안하였는데요, 자세한 내용에 대해 차근차근 알아보겠습니다.
2. Attribute Sensitivity Analysis
저자들은 VLM이 Attribute를 실제로 활용하는지 확인하기 위해, Caption에서 형용사를 제거하거나 변경했을 때 모델의 성능이 어떻게 달라지는지 살펴보았습니다.
2.1. Does Attribute Context Help Object Learning?
먼저 Attribute 정보가 객체 학습에 얼마나 기여하는지 살펴았습니다.
이를 위해 COCO Caption에서 객체를 수식하는 형용사를 제거한 데이터를 만들고, 원본 데이터로 학습한 OVR-CNN과 Object Detection 성능을 비교해보았습니다.
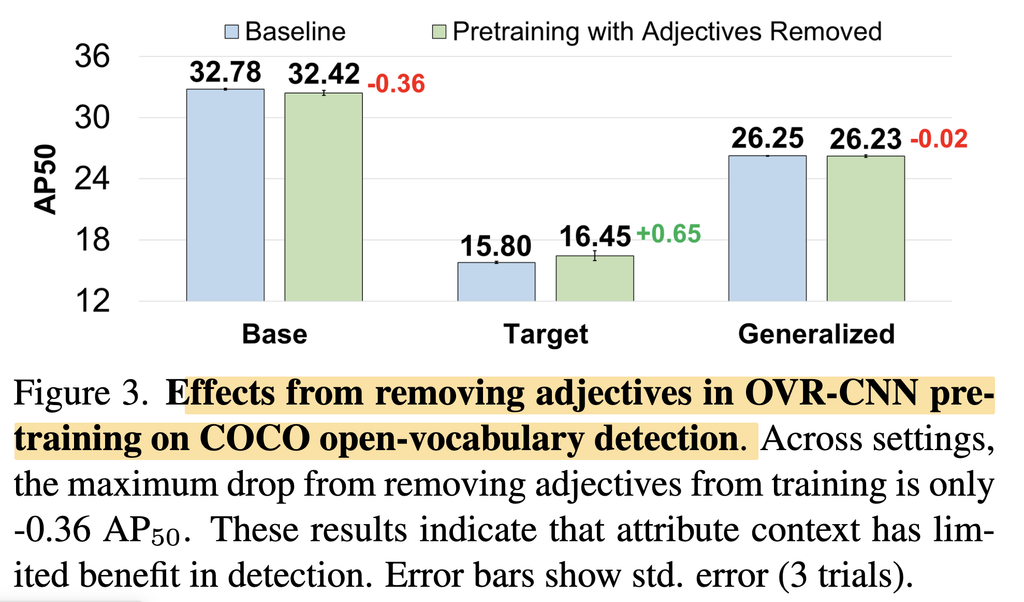
Figure 3을 보면 형용사를 제거해도 성능 변화가 거의 없습니다. Base Class에서는 AP50이 32.78에서 32.42로 조금 감소했고, Target Class에서는 오히려 15.80에서 16.45로 증가한 것을 알 수 있습니다.
다시말해, Caption에 Attribute 정보가 포함되어 있더라도, 이를 제거했을 때 객체 인식 성능에 미치는 영향은 제한적이었다는 결과였죠
2.2. Is OVR-CNN Sensitive to Attribute Meaning?
그렇다면 학습된 모델은 Attribute의 의미를 얼마나 구분할 수 있을까요?
저자들은 COCO Caption에서 객체를 수식하는 형용사를 추출하고, 다음 네 가지 평가 조건을 구성하였습니다.
(참고로 기존 OVR-CNN은 주변 단어의 영향을 받지 않는 Context-free Word Embedding을 사용하므로, 저자들은 이를 BERT의 Contextualized Embedding으로 변경하여 Attribute의 영향을 분석했습니다.)
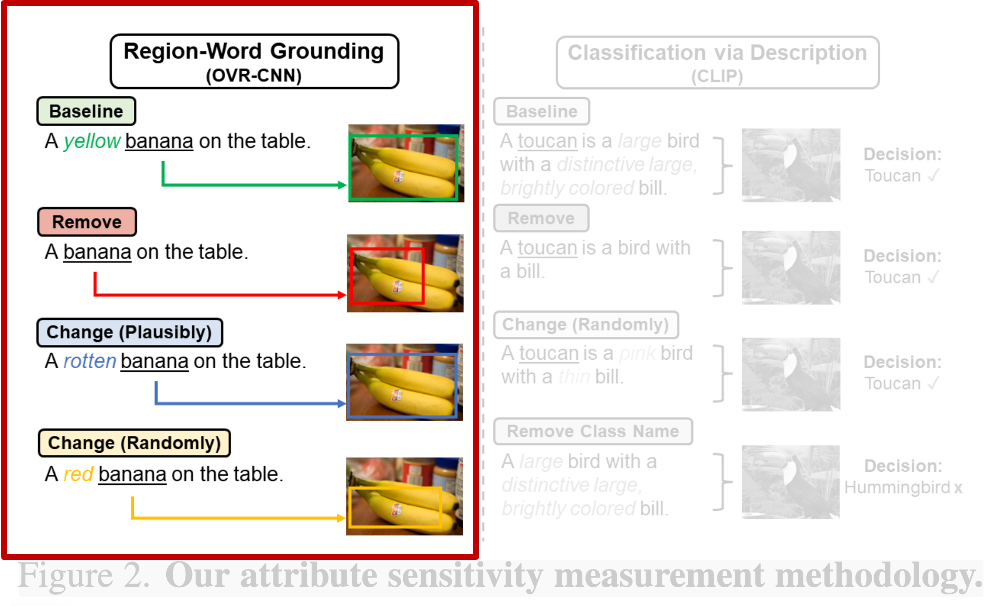
| 조건 | Caption 예시 |
|---|---|
| Baseline | a yellow banana |
| Remove | a banana |
| Plausible Change | a rotten banana |
| Random Change | a red banana |
Plausible(그럴싸한) Change는 데이터셋에서 동일 객체를 수식했던 형용사로 변경하고, Random Change는 전체 형용사 중 무작위로 선택합니다.
이후 동일한 이미지에 네 가지 Caption을 각각 입력하여 Phrase Grounding을 수행하고, 예측 Bounding Box와 GT의 일치도를 AP로 평가해보았다고 합니다.
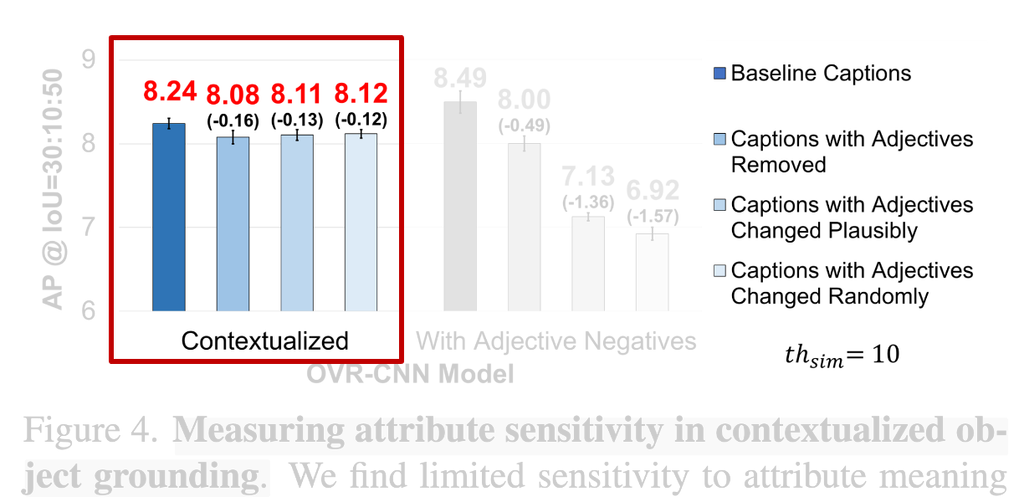
결과적으로 Baseline의 AP는 8.24였지만, Plausible Change와 Random Change에서도 각각 8.11, 8.12로 거의 동일했습니다.
이는 객체 단어의 Embedding이 주변 문맥을 반영하도록 구성되어 있더라도, Attribute가 달라졌다는 사실이 실제 Grounding 결과에는 충분히 반영되지 않음을 보여준다고 합니다.
2.3. Does CLIP Rely More on Class Names?
마지막으로 CLIP에서도 동일한 현상이 나타나는지 살펴봅니다.
이에 앞서, 저자들은 GPT-3를 이용해 ImageNetV2의 각 클래스에 대한 Attribute Description을 생성하엿습니다. 이후 형용사를 제거하거나 무작위로 변경하고, 추가로 Class Name을 object로 대체하여 Zero-shot Classification을 수행합니다.
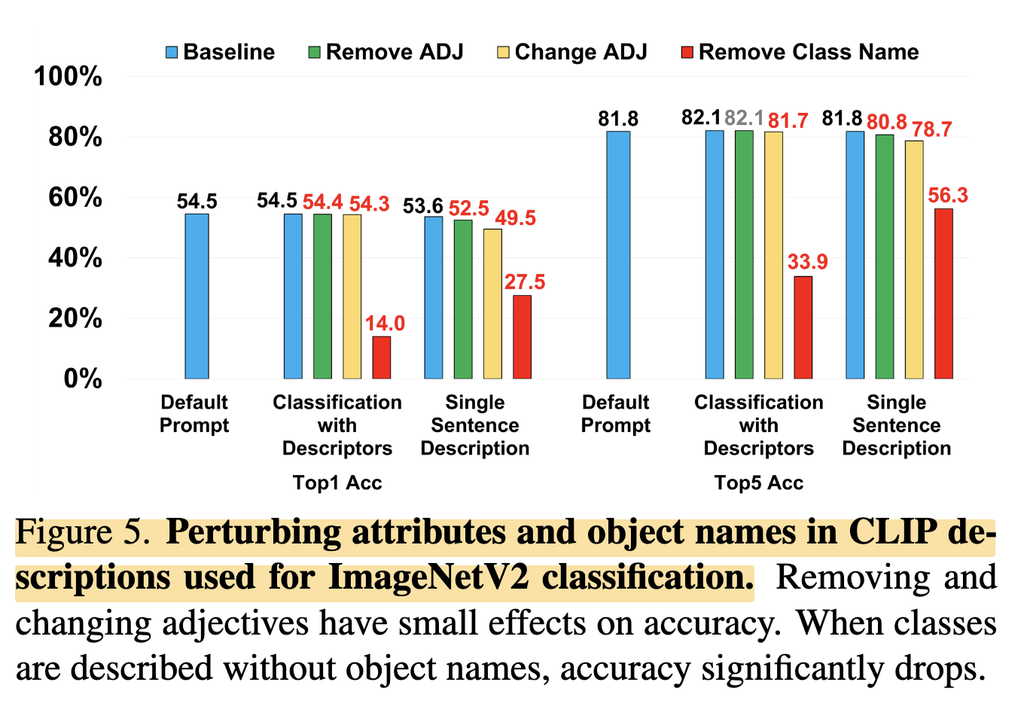
실험 결과 여러 Descriptor를 사용하는 설정에서 Baseline의 Top-1 Accuracy는 54.5%였습니다. 형용사를 제거하거나 변경해도 각각 54.4%, 54.3%로 거의 차이가 없었습니다.
반면 Class Name을 제거(remove class name, 빨간색 바)하자 정확도가 14.0%까지 급격히 감소했습니다.
즉, CLIP의 객체 분류는 Attribute Description보다 Class Name에 훨씬 크게 의존하는 것으로 나타났습니다.
지금까지 살펴본 세 가지 실험은 공통적으로 VLM이 Attribute 정보를 충분히 활용하지 않을 가능성을 보여주는 결과 같습니다. 다만… Attribute를 변경해도 성능이 유지된다는 사실만으로, 모델이 해당 속성을 이해하지 못한다고 단정하기는 조금 어렵지 않나 싶긴 합니다. 결과론적으로 간접적으로 그렇다는 것이지..
아무튼 모델이 attribute에 민감하지 않다는 결과를 본 것 같습니다. 그럼 이제 이걸 어떻게 극복해야할지가 궁금하겠죠? 이를 극복하고자 저자들은 Attribute의 차이를 더 적극적으로 구별하도록 학습시키는 방식을 사용했다고 합니다. 다음 장에서는 저자들이 제안한 Adjective-based Negative Contrastive Learning을 살펴보겠습니다.
3. Learning with Attribute-based Negatives
앞선 실험에서는 VLM이 Attribute를 제거하거나 변경해도 크게 영향을 받지 않는다는 사실을 확인했습니다. 그렇다면 Attribute의 차이를 구별하도록 학습시키면 이러한 문제를 개선할 수 있을까요?
3.1. Adjective-based Negative Contrastive Learning
저자들은 기존 Contrastive Learning에 Adjective-based Negative Caption을 추가하는 방법을 제안하였습니다. 객체 이름은 유지하면서 형용사만 변경해, 모델이 Attribute의 의미에도 주목하도록 유도하는 것이죠
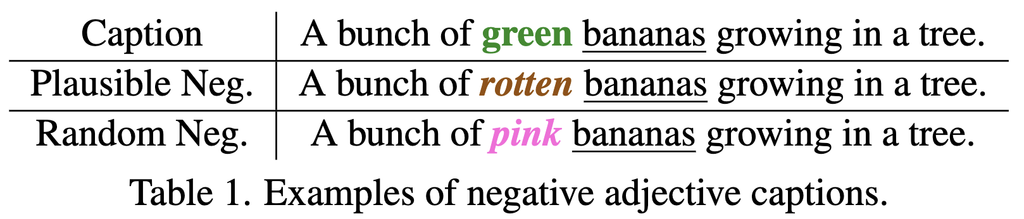
이를 위해 Negative Caption을 만들었는데, 두 가지 규칙을 기반으로 만들었습니다.
- Plausible Negative: 동일 객체에 대해 데이터셋에서 관찰된 속성으로 변경 (
green banana→rotten banana) - Random Negative: 전체 형용사 중 무작위로 변경 (
green banana→pink banana)
생성된 Negative Caption은 기존 Contrastive Loss의 Negative 후보에 추가됩니다. 즉, 모델이 올바른 Caption에는 높은 유사도를, 속성이 변경된 Caption에는 낮은 유사도를 부여하도록 학습하는 것입니다.
이러한 전략을 OVR-CNN의 Pretraining과 CLIP의 Fine-tuning에 각각 적용합니다. 특히 OVR-CNN에는 형용사만으로 문제를 해결하는 Shortcut을 방지하기 위해 Noun Negative도 함께 사용하였습니다.
3.2. Does Attribute-aware Learning Improve Detection?
먼저 Negative Caption 학습 이후 Attribute Sensitivity가 어떻게 달라졌는지 확인해보았습니다.
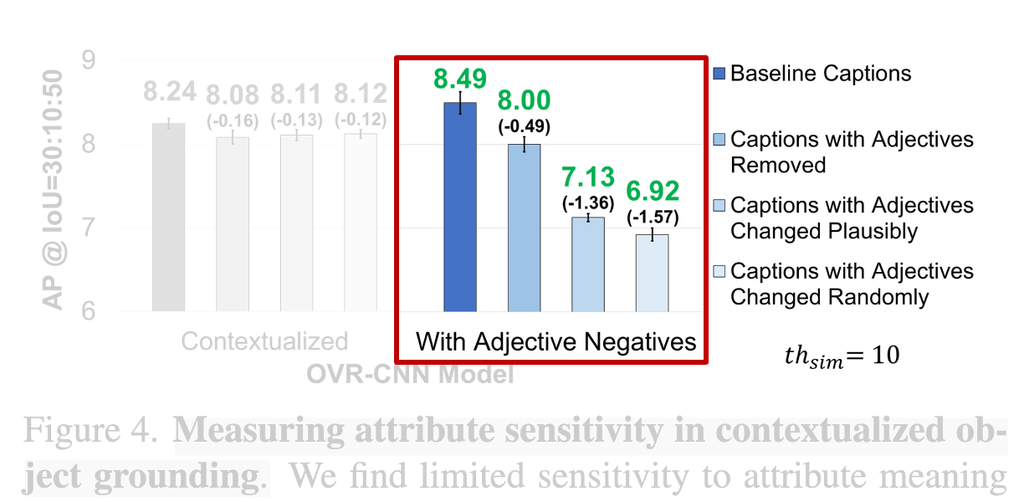
기존 OVR-CNN은 Attribute를 변경해도 AP 감소 폭이 0.2 미만이었습니다. 반면 Negative Caption으로 학습한 모델은 Plausible Change에서 −1.36, Random Change에서 −1.57의 감소가 나타났습니다. 즉, 잘못된 Attribute에 대한 Grounding 민감도가 높아진 것입니다.
그렇다면 실제 Detection 성능도 개선되었을까요?
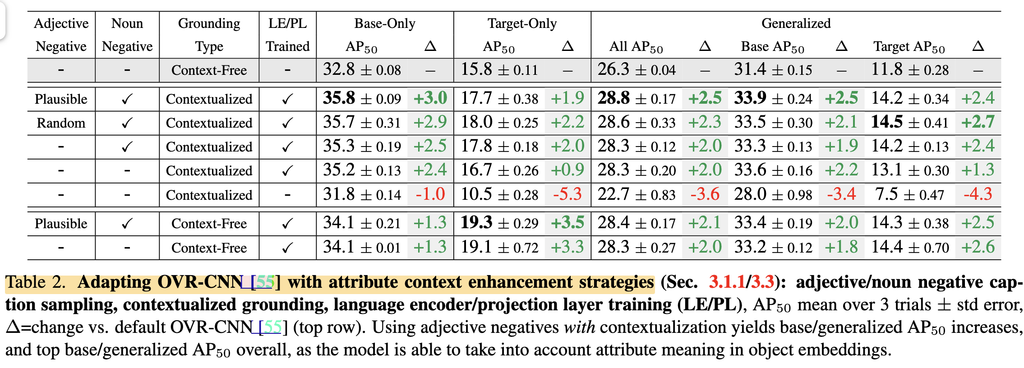
Table 2에서 Contextualized Grounding과 Noun Negative를 적용한 모델에 Adjective Negative를 추가하자, Generalized AP50이 28.3에서 28.8로 향상되었습니다.
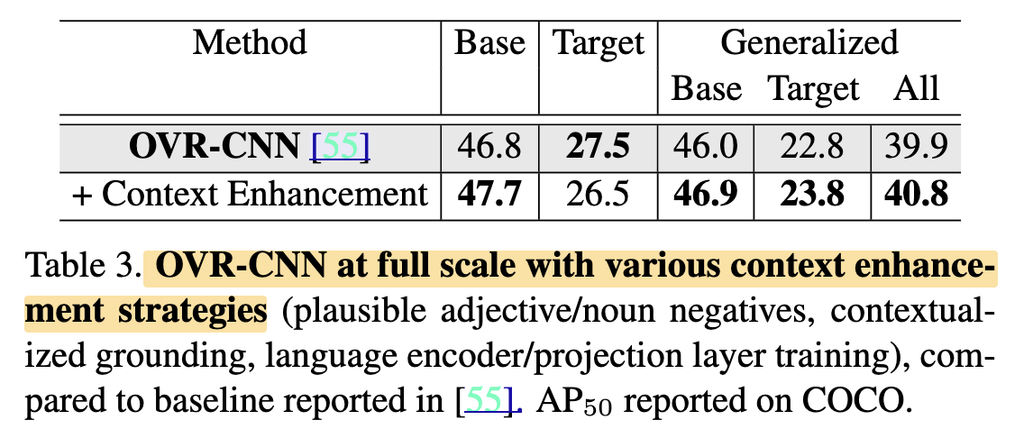
Table 3 인 Full-scale 실험에서도 Generalized AP50이 39.9에서 40.8로 증가했습니다. 다만 Target-only 성능은 27.5에서 26.5로 감소했죠
따라서 Attribute-aware Learning이 일부 Detection 설정에서는 도움이 되지만, 모든 클래스에 일관된 성능 향상을 보장하지는 않았습니다.
3.3. Does It Improve Fine-grained Understanding?
마지막으로 저자들은 Attribute를 실제로 구별해야 하는 Task에서도 개선 효과가 나타나는지 확인해보았습니다.
이를 위해 OVAD의 Attribute Annotation을 활용한 Text-Region Retrieval을 수행합니다. 예를 들어 red car라는 Query에 대해 단순히 자동차가 아닌, 실제 빨간 자동차 Region을 검색해야 합니다.
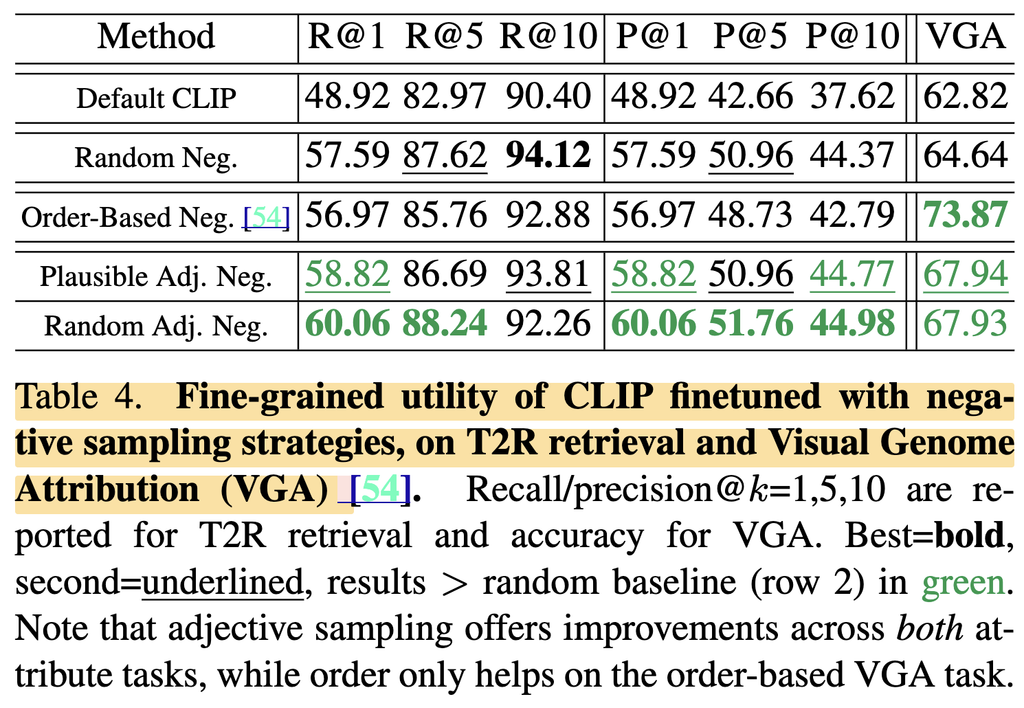
테이블 4를 보시면, CLIP의 Retrieval R@1은 다음과 같이 변화했습니다.
- Default CLIP : 48.92
- Random Caption Negative: 57.59
- Plausible Adjective Negative : 58.82
- Random Adjective Negative : 60.06
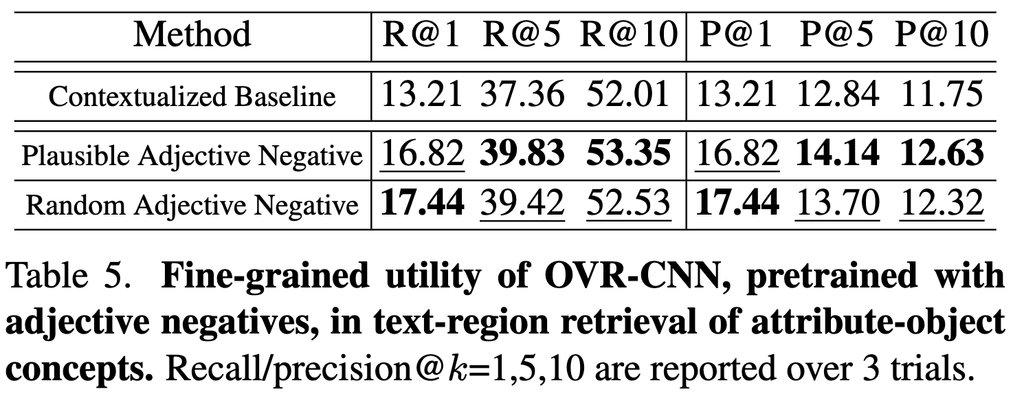
CLIP에서는 일반적인 Random Caption Negative보다 Adjective Negative를 활용했을 때 더 높은 성능을 보였습니다. OVR-CNN에서도 Contextualized Baseline 대비 Retrieval R@1이 13.21에서 17.44로 향상되었습니다.
이는 어떤 Negative Sample을 학습시키느냐에 따라 모델이 개선하는 세부 능력도 달라질 수 있음을 보여줍니다.
결국 저자들은 Attribute를 단순한 Caption의 부가 정보로 사용하는 것보다, Attribute의 차이를 직접 구별하도록 학습시키는 것이 Fine-grained Understanding에 도움이 될 수 있음을 확인한 결과라고 할 수 있겠네요!
4. Discussion & Conclusion
지금까지 VLM이 객체를 인식하는 과정에서 Attribute 정보를 얼마나 활용하는지 분석하고, Adjective-based Negative Learning을 통해 이를 개선할 수 있는지 살펴보았습니다.
실험 결과, Attribute를 제거하거나 변경해도 기존 모델의 Object Detection 및 Classification 성능은 거의 달라지지 않았습니다. 반면 Attribute Negative를 활용해 학습한 모델은 잘못된 속성에 더 민감하게 반응했으며, Fine-grained Retrieval에서도 성능이 향상되었습니다.
이는 VLM이 Attribute 정보를 충분히 활용하지 않을 수 있으며, 학습 과정에서 속성 간 차이를 명시적으로 구별하도록 유도하는 것이 도움이 될 수 있음을 보여준다고 정리할 수 있을 것 같습니다.
개인적으로 이 논문을 리뷰하게된 가장 재밌던 부분은 Attribute를 변경해도 모델의 예측 성능이 거의 달라지지 않는다는 결과였습니다. 그러나 이러한 결과를 Attribute Understanding의 부족으로 해석하는 것이 타당한지는 조금 의문이 남긴 합니다.
예를 들어 노란 바나나 이미지에 red banana라는 Caption을 입력하더라도, 모델이 바나나의 위치를 정확하게 찾았다면 Object Grounding 자체는 성공한 것입니다. Attribute를 이해하지 못한 것인지, Attribute를 활용하지 않아도 정답을 찾을 수 있었던 것인지 구분하기 어렵기 때문이죠
그리고 Negative Caption 학습의 효과 좀 아쉬운 부분이 있는데… 잘못된 Attribute에 대한 Grounding 성능이 감소했다는 사실만으로 모델의 Attribute Understanding이 개선되었다고 단정할 수 있을지 ?? 의문이긴 합니다.
또한 생성된 Negative Caption이 반드시 잘못된 설명이라는 보장도 없습니다. 실제로 존재 가능한 Attribute 조합까지 Negative로 학습시킨다면, 모델이 속성의 의미를 이해하기보다 특정 조합을 억제하도록 학습될 가능성도 있지 않을까요?
결국 이 논문은 Attribute 정보를 표현하지 못하는 것과, 표현된 정보를 예측에 활용하지 않는 것은 서로 다른 문제라는 점을 보여준 게 아닐까 싶긴 합니다. 두 현상을 명확히 구별할 수 있는 평가가 뒷받침된다면, VLM의 Attribute Understanding을 더욱 깊이 있게 분석할 수 있을 것 같습니다. 이상 리뷰 마치겠습니다.