안녕하세요. 이번에는 10월 아카이브에 올라온 Swarm Telepathy 라는 논문을 읽어보았습니다. MIT 논문이네요.
요즘의 LLM 기반 multi-agent system에서는 여러 agent가 역할을 나눠 문제를 해결하고, 서로의 결과를 주고받는 방식이 많이 사용되고 있습니다.
그런데 대부분의 시스템에서는 agent 간 communication이 여전히 text를 통해 이루어집니다. 한 모델이 자신의 결과를 text로 요약해서 전달하면, 다음 모델이 그 text를 다시 읽고 작업을 이어가는 방식입니다.
저자는 모델이 이미 계산한 latent state인 KV-cache 자체를 다른 모델에게 전달할 수 없을까?라는 문제를 다룹니다.
특히 같은 모델이나 같은 family가 아니라, 서로 다른 size와 architecture, model family 사이에서도 KV-cache를 변환해 전달하는 SwaT(Swarm Telepathy)를 제안합니다.
그럼 리뷰 시작하겠습니다.
Abstract
기존 LLM multi-agent system에서는 agent 간 정보를 주고받을 때 주로 text를 사용합니다.
하지만 이 방식은 두 가지 문제가 있습니다.
첫 번째는 information bottleneck입니다.
Sender model이 내부적으로 계산한 모든 정보를 text summary로 압축해야 하기 때문에, 실제 latent representation에 포함되어 있던 정보가 전달 과정에서 손실될 수 있습니다.
두 번째는 중복 computation입니다.
Sender는 전달할 내용을 autoregressive하게 text로 decoding해야 하고, receiver는 그 text를 다시 처음부터 읽으면서 prefill computation을 수행해야 합니다.
반면 LLM 내부에는 이미 현재 context에 대한 정보를 담고 있는 KV-cache가 존재합니다.
따라서 이 KV-cache를 직접 전달할 수 있다면 text generation과 receiver prefill을 모두 줄이면서 더 많은 정보를 전달할 수 있습니다.
기존에도 KV-cache transfer를 시도한 연구들은 있었지만, 대부분 같은 model family 내부에서만 동작하거나, 다른 family 사이에서는 receiver가 다시 text를 prefill해야 하는 한계가 있었습니다.
이를 해결하기 위해 저자들은 SwaT(Swarm Telepathy)를 제안합니다.
SwaT은 sender의 KV-cache를 receiver model이 사용할 수 있는 latent representation으로 변환하여, 서로 다른 model family 사이에서도 receiver가 원본 text를 다시 읽지 않고 바로 decoding을 이어갈 수 있도록 합니다.
또한 최근 KV-cache compaction 방법과 함께 사용할 경우, multi-agent communication에서 기존 text-to-text 방식보다 평균 40% 높은 accuracy와 약 4배 빠른 wall-clock time을 보였습니다.
Sender가 VLM인 경우, SwaT은 text-only receiver에게 visual information이 포함된 KV-cache를 전달할 수 있었고, SwaT 자체는 text-only data로 학습되었음에도 text communication보다 높은 성능을 보였습니다.
또한 sender와 receiver LLM 자체는 모두 frozen 상태로 유지하며, 별도의 mapping module만 학습한다고 합니다.
Introduction
최근 LLM 기반 Multi-Agent System(MAS)은 여러 agent가 서로 다른 역할을 맡고 결과를 공유하면서 single model보다 높은 성능을 보이는 방향으로 발전하고 있습니다.
하지만 대부분의 multi-agent system에서 agent 사이의 communication은 자연어 text를 기반으로 합니다.
한 agent가 자신의 context와 reasoning 결과를 text로 요약하고, 다음 agent가 이 text를 다시 입력으로 받아 처리하는 방식입니다.
이 방법은 단순하지만, 저자들은 text가 agent communication을 위한 좁은 communication channel이라고 지적합니다.
Sender가 알고 있는 정보 중 실제 text로 표현한 정보만 receiver에게 전달되고, receiver 역시 그 text를 기반으로 sender의 상태를 다시 복원해야 하기 때문입니다.
계산 측면에서도 비효율적입니다.
Sender는 전달을 위해 summary를 token-by-token으로 decoding해야 하고, receiver는 전달받은 summary를 다시 prefill해야 합니다.
하지만 sender는 이미 전체 context를 처리하면서 KV-cache라는 내부 representation을 계산해놓은 상태입니다. 참고로 KV-cache는 모델의 Transformer 각 layer에서 이전 token들의 key와 value를 저장하고 있으며, 이후 token을 생성하기 위해 필요한 현재 model state를 담고 있습니다.
따라서 저자들은 이 KV-cache를 agent communication channel로 직접 사용하는 것이 text보다 더 많은 정보를 전달하면서도 computation을 줄일 수 있다고 봅니다.
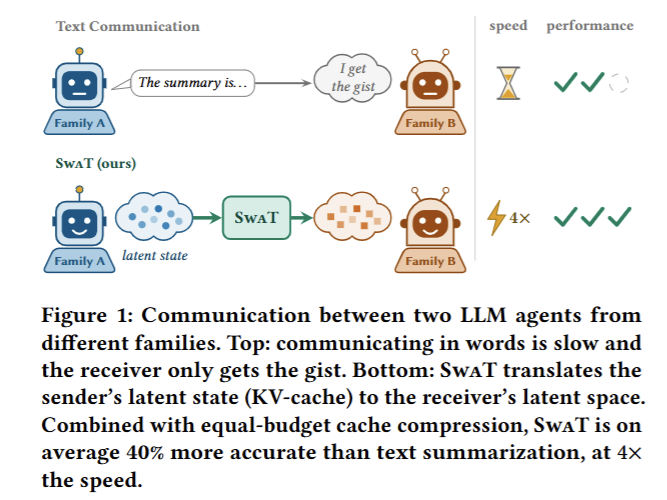

Figure 1에서 기존 text communication과 SwaT의 차이를 직관적으로 확인할 수 있습니다.
기존 방식에서는 Family A의 모델이 text summary를 생성하고, Family B의 모델이 다시 이를 읽습니다.
반면 SwaT에서는 Family A가 이미 계산한 latent state, 즉 KV-cache를 Family B의 latent space로 변환한 뒤 바로 전달합니다.
앞서 말했듯 이를 통해 receiver는 전달받은 내용을 다시 text로 prefill하지 않고 바로 다음 generation을 수행할 수 있습니다.
기존 연구에서도 latent communication이나 KV-cache transfer가 연구되어 왔습니다.
LatentMAS의 경우 agent들이 text 대신 latent state나 cache를 교환하면 더 높은 information density를 얻을 수 있음을 보였습니다.
하지만 이러한 방법은 동일한 backbone의 여러 agent 사이에서 communication하는 setting을 주로 다룹니다.
같은 모델끼리는 hidden dimension이나 layer 구조, representation geometry가 동일하기 때문에 KV-cache를 공유하기 비교적 쉽습니다.
이후에는 서로 다른 model size와 layer 수 사이의 KV-cache transfer도 연구되었습니다.
예를 들어 같은 Qwen family의 4B, 8B, 14B, 32B처럼 model size가 달라도 cache를 변환하는 방식입니다.
하지만 같은 family의 모델들은 일반적으로 비슷한 training pipeline과 data를 사용하고, 작은 모델이 큰 모델에서 distillation된 경우도 있기 때문에 representation이 어느 정도 정렬되어 있을 가능성이 높습니다.
SwaT은 여기서 더 어려운 문제를 다룹니다.
서로 다른 organization에서 학습되고 architecture와 size도 다른 model family 사이에서도 latent communication이 가능한가?? 라는 것입니다.
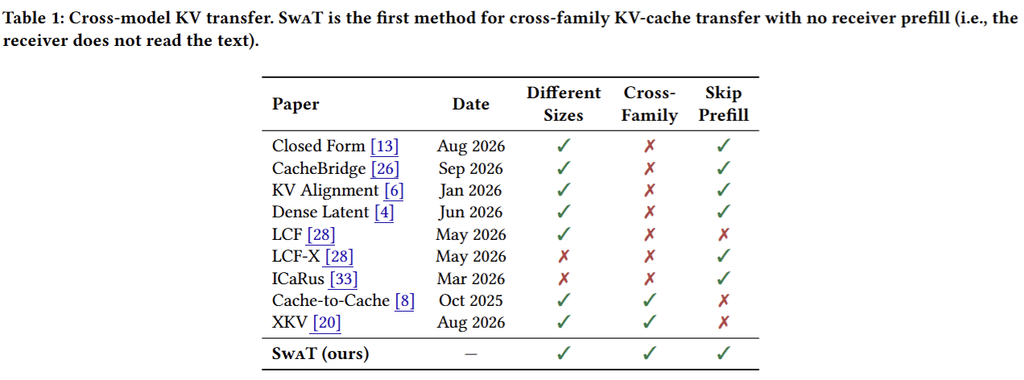
기존 방법 중에서는 different size나 cross-family transfer가 가능한 방법이 존재하지만, cross-family이면서 동시에 receiver prefill까지 완전히 생략할 수 있는 방법은 SwaT이 처음이라고 저자들은 주장합니다.
저자들은 서로 다른 model family 사이에서도 이러한 transfer가 가능할 수 있는 근거로 Platonic Representation Hypothesis를 언급합니다.
서로 다른 architecture와 training data를 사용하는 모델이라도 동일한 world를 학습하다 보면 내부적으로 표현하는 semantic information 자체는 점점 비슷해질 수 있다는 가설이라고 합니다.
이 경우 conversation 중간에 model을 변경하는 경우에도 새로운 모델이 전체 context를 다시 prefill하지 않고 이전 모델의 cache를 이어받을 수 있습니다.
Background
먼저 일반적인 LLM agent는 크게 Prefill과 Decode 두 단계로 동작합니다.
Prefill에서는 input sequence 전체를 읽으면서 각 layer의 Key와 Value를 계산해 KV-cache를 만들고, Decode에서는 이 KV-cache를 이용해 다음 token을 autoregressive하게 생성합니다.
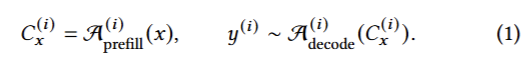
기존 text-based multi-agent communication에서는 sender가 자신의 결과를 text로 생성한 뒤, receiver가 그 text를 다시 처음부터 prefill합니다.
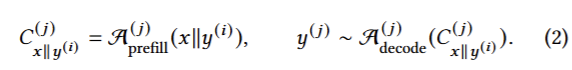
즉 sender가 이미 context에 대해 많은 computation을 수행했음에도 불구하고,
Sender에서 Context → KV-cache → Text 로 한번 변환한 뒤,
Receiver에서 Text → 다시 KV-cache 를 계산하는 과정을 거칩니다.
SwaT은 이 중간 text communication을 없애는 것이 목표입니다.
즉 전체적인 목표는
Sender KV-cache
→ SwaT Mapper
→ Receiver KV-cache
→ Receiver Decode
형태입니다.
Method
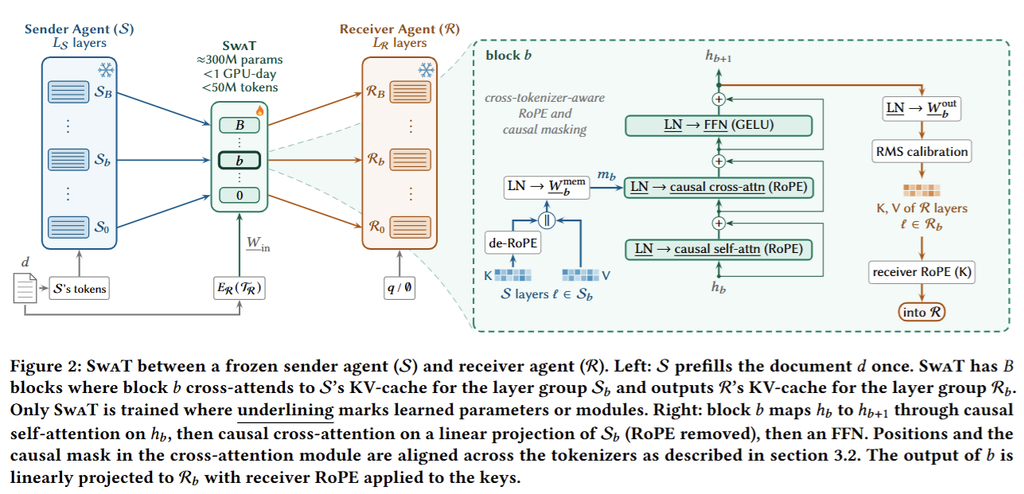
SwaT은 sender와 receiver 사이에 위치하는 Transformer 기반 mapper입니다.
Sender와 receiver LLM 자체는 모두 frozen 상태로 유지하고, 둘 사이에서 KV-cache를 변환하는 SwaT만 학습합니다.
문제는 서로 다른 model family라면 구조 자체가 상당히 다를 수 있다는 점입니다.
예를 들어 sender와 receiver는
- layer 개수
- attention head 개수
- head dimension
- hidden dimension
- tokenizer
가 모두 다를 수 있습니다.
따라서 sender KV-cache를 단순히 linear projection해서 receiver에 넣는 방식으로는 해결하기 어렵습니다.
SwaT은 이를 위해 sender와 receiver의 layer들을 여러 layer group으로 나누고, 각 group 사이의 KV-cache를 순차적으로 변환합니다.
Layer Groups
Sender와 receiver의 전체 KV layer를 각각 같은 수의 여러 block으로 나눕니다.
예를 들어 sender가 32 layer이고 receiver가 24 layer라고 하더라도, 둘을 동일하게 4개의 group으로 나눌 수 있습니다.
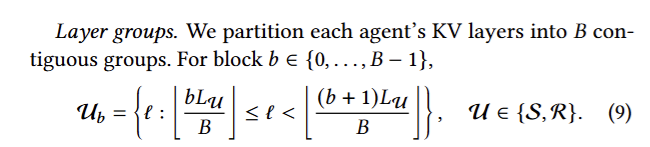
각 SwaT block은 sender의 특정 layer group에서 KV-cache를 받아, 이에 대응되는 receiver layer group의 KV-cache를 예측합니다.
즉 반드시
sender layer 1 → receiver layer 1
처럼 1:1로 mapping하는 것이 아니라,
여러 sender layer의 정보를 이용해 여러 receiver layer의 representation을 함께 생성하는 방식입니다.
이를 통해 서로 다른 layer depth를 가진 model 사이에서도 transfer가 가능하도록 합니다.
여기서 든 생각은 이런 방식이 효과적으로 동작하려면 서로 다른 모델의 얕은층, 중간층, 깊은층의 layer들끼리 비슷한 역할을 할거라는 가정이 있다고 생각합니다.
Mapper Input
여기서 재미있는 점이 하나 있습니다.
Sender와 receiver는 tokenizer가 다를 수 있기 때문에, 같은 document라도 token 개수가 서로 다릅니다.
SwaT은 receiver tokenizer로 동일한 document를 tokenize하고, receiver token embedding을 mapper의 초기 hidden state로 사용합니다.
하지만 여기서 receiver LLM이 document를 직접 prefill하는 것은 아닙니다.
Embedding table lookup만 사용하기 때문에 실제 Transformer prefill computation은 수행하지 않는다고 합니다.
반면 sender 쪽에서는 이미 계산된 KV-cache를 가져옵니다.
Sender의 여러 layer와 head에 존재하는 Key와 Value를 하나로 모아 projection하고, 이를 SwaT이 참고할 memory representation으로 만듭니다.
즉 SwaT에는 크게
- receiver의 token 위치와 구조를 알려주는 receiver token embedding
- sender가 이미 계산한 latent information인 KV-cache
두 종류의 정보가 입력됩니다.
SwaT Blocks
각 SwaT block은 크게 세 가지 연산으로 구성됩니다.
- Causal Self-Attention
- Sender KV-cache에 대한 Cross-Attention
- Feed-Forward Network
Self-attention은 현재 receiver-side representation끼리 정보를 교환하는 역할을 합니다.
그리고 핵심은 Cross-Attention입니다.
Receiver-side hidden representation이 sender의 KV-cache를 memory로 사용하여 필요한 정보를 가져옵니다.
즉
Receiver token representation
→ Cross-Attention
→ Sender KV information 참조
형태입니다.
이 과정을 여러 SwaT block에서 반복하면서 sender의 latent information을 receiver가 사용할 수 있는 representation으로 변환합니다.
Cache Output
각 block의 마지막에서는 변환된 hidden representation을 projection해서 해당 receiver layer group에 필요한 Key와 Value를 직접 생성합니다.
그리고 생성된 KV-cache의 scale을 receiver의 실제 KV-cache 통계에 맞게 조정합니다.
마지막으로 receiver가 사용하는 RoPE positional encoding까지 적용하면, receiver 입장에서는 자신의 prefill을 통해 생성한 것과 동일한 형태의 KV-cache가 만들어집니다.
이후 receiver는 이 cache 위에서 바로 새로운 query나 task prompt를 처리하고 답을 생성합니다.
Training Objectives
SwaT은 두 가지 objective를 이용해 학습합니다.
중요한 점은 sender와 receiver LLM은 계속 frozen 상태이고 SwaT mapper만 업데이트한다는 것입니다.
KV-cache Reconstruction
첫 번째 objective는 가장 직접적입니다.
같은 document를 receiver가 실제로 prefill했을 때 얻는 KV-cache를 ground truth로 두고, SwaT이 sender cache로부터 이를 얼마나 잘 복원하는지를 학습합니다.
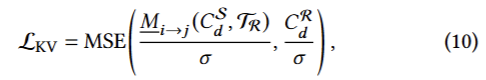
즉 SwaT(Sender Cache) ≈ Receiver Native Cache
가 되도록 MSE loss를 사용합니다.
각 layer와 head마다 KV-cache scale이 다르기 때문에 RMS normalization을 적용한 뒤 비교합니다.
이 loss를 통해 SwaT은 두 model의 latent space 사이의 기본적인 translation을 학습합니다.
Next-Token Prediction
하지만 receiver의 KV-cache와 단순히 numerical하게 비슷하다고 해서 실제 downstream generation까지 잘된다는 보장은 없습니다.
그래서 두 번째로 next-token prediction loss를 함께 사용합니다.
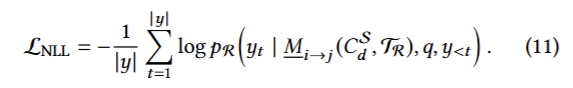
SwaT이 생성한 KV-cache를 frozen receiver에 직접 넣고, receiver가 정답이나 reasoning trace를 제대로 생성하도록 NLL loss를 계산합니다.
이때 gradient는 frozen receiver를 통과하지만 receiver parameter는 업데이트되지 않고, SwaT mapper에만 전달됩니다.
즉 두 objective의 역할은
- KV Reconstruction → receiver의 native latent space와 맞추기
- NLL → 실제 generation에 유용한 cache 만들기
로 나눌 수 있습니다.
이 때문에 SwaT이 반드시 receiver의 native cache를 완벽하게 복제할 필요는 없고, downstream task에 더 유용하다면 오히려 native cache보다 좋은 성능을 낼 수도 있습니다.
Cross-Family Tokenizers
Cross-family transfer에서 또 하나의 문제가 tokenizer mismatch입니다.
같은 문장을 입력하더라도 Qwen, Llama, Gemma는 문장을 서로 다른 token sequence로 분할할 수 있습니다.
따라서 sender의 10번째 token과 receiver의 10번째 token이 같은 text 위치를 의미한다는 보장이 없습니다.
SwaT은 이를 해결하기 위해 token index 자체가 아니라 원본 text의 character span을 기준으로 sender와 receiver token을 정렬합니다.
각 sender token과 receiver token이 원본 document의 몇 번째 character부터 몇 번째 character까지를 담당하는지를 확인한 뒤, 서로의 위치 관계를 계산합니다.
이를 이용해 sender token에 receiver 기준의 RoPE position을 새롭게 부여합니다.
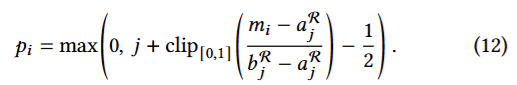
따라서 tokenizer가 다르더라도 동일한 text 위치를 나타내는 token들이 비슷한 positional information을 갖도록 만들 수 있습니다.
Experiments
실험에서는 크게 세 가지 질문을 확인합니다.
- Sender의 KV-cache를 SwaT으로 변환했을 때, receiver가 원래 text를 직접 읽었을 때의 성능을 얼마나 유지할 수 있는가?
- 실제 multi-agent communication에서 KV-cache transfer가 text-to-text communication보다 효과적인가?
- Sender가 가지고 있지만 receiver에게는 없는 capability까지 latent state를 통해 전달할 수 있는가?
이를 위해 6개의 model family에서 3B부터 32B까지 다양한 모델을 사용하고, 서로 다른 family로 구성된 10개의 sender–receiver pair를 평가합니다.
7개 pair는 small → large, 3개 pair는 large → small setting으로 구성합니다.
Training Setup
SwaT은 약 300M parameter 규모의 Transformer mapper이며, sender와 receiver LLM은 모두 frozen 상태로 유지합니다.
학습은 두 단계로 진행됩니다.
먼저 KV-cache reconstruction loss를 이용해 5,000 step 동안 sender cache를 receiver native cache로 변환하는 방법을 학습합니다.
이후 next-token prediction loss를 이용해 추가로 24,000 step 동안 실제 downstream generation에 유용한 cache를 생성하도록 학습합니다.
Training data는 모두 English text만 사용하며, 전체 약 44M unique token이라고 합니다.
중요한 점은 이후 vision이나 Chinese capability transfer 실험에서 사용하는 데이터는 SwaT training에 포함되지 않게 했다는 점입니다.
Retention Across Model Pairs
먼저 SwaT으로 변환된 cache가 receiver의 원래 성능을 얼마나 유지하는지 확인합니다.
비교 기준은 receiver가 document를 직접 읽고 문제를 푸는 경우입니다.
즉
Receiver 직접 Prefill → Answer
의 성능을 100%로 두고,
Sender Prefill → SwaT → Receiver Answer
가 어느 정도의 성능을 유지하는지를 측정합니다.
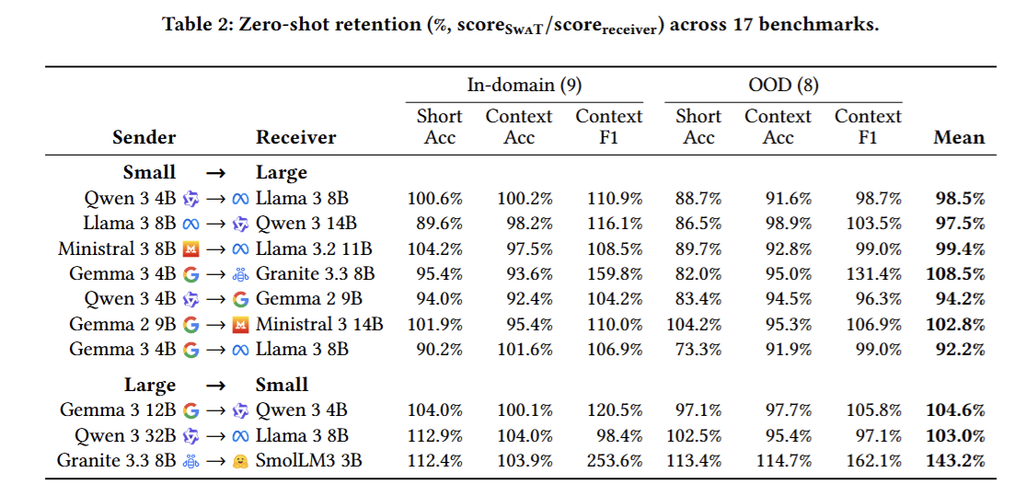
결과적으로 10개의 cross-family model pair와 17개의 benchmark에서, 대부분 receiver native performance에 가까운 성능을 유지했습니다.
특히 small → large setting에서도 가장 낮은 평균 retention이 90% 이상이었습니다.
이는 작은 sender model이 만든 KV-cache를 더 큰 receiver가 받아 사용하더라도, receiver가 직접 text를 읽었을 때의 성능 대부분을 유지할 수 있다는 것을 의미합니다.
더 흥미로운 것은 large → small setting입니다.
이 경우 모든 pair에서 평균 retention이 100% 이상으로 나타났습니다.
예를 들어 Qwen 3 32B의 cache를 Llama 3 8B로 전달했을 때 receiver 자신의 native cache를 사용하는 것보다 높은 성능을 보였습니다.
즉 작은 receiver가 자신의 representation만 사용하는 대신, 더 큰 sender가 이미 계산해놓은 richer representation을 받아 사용하면서 오히려 자신의 native performance를 넘어설 수 있었습니다.
이 결과는 SwaT이 단순히 receiver cache를 근사하는 것뿐 아니라, sender가 가진 stronger representation까지 receiver에게 전달할 수 있음을 보여줍니다.
Cache Transfer vs Text Communication
다음으로 실제 multi-agent communication 관점에서 SwaT과 기존 text-to-text communication을 비교합니다.
기존 T2T에서는 sender가 document를 읽고 text summary를 생성한 뒤, receiver가 해당 summary를 다시 prefill하고 질문에 답합니다.
반면 SwaT에서는 sender의 KV-cache를 전달하고, receiver는 document나 summary를 다시 읽지 않고 question만 prefill합니다.
이때 비교를 공정하게 하기 위해 SwaT의 KV-cache에도 Attention Matching(AM) 기반 compression을 적용하고, text summary와 비슷한 communication budget으로 맞춥니다.
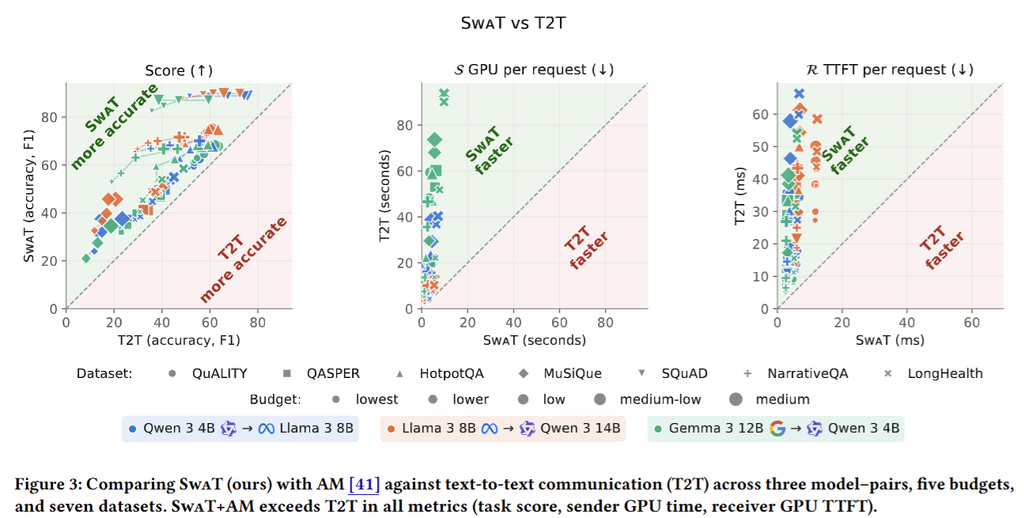
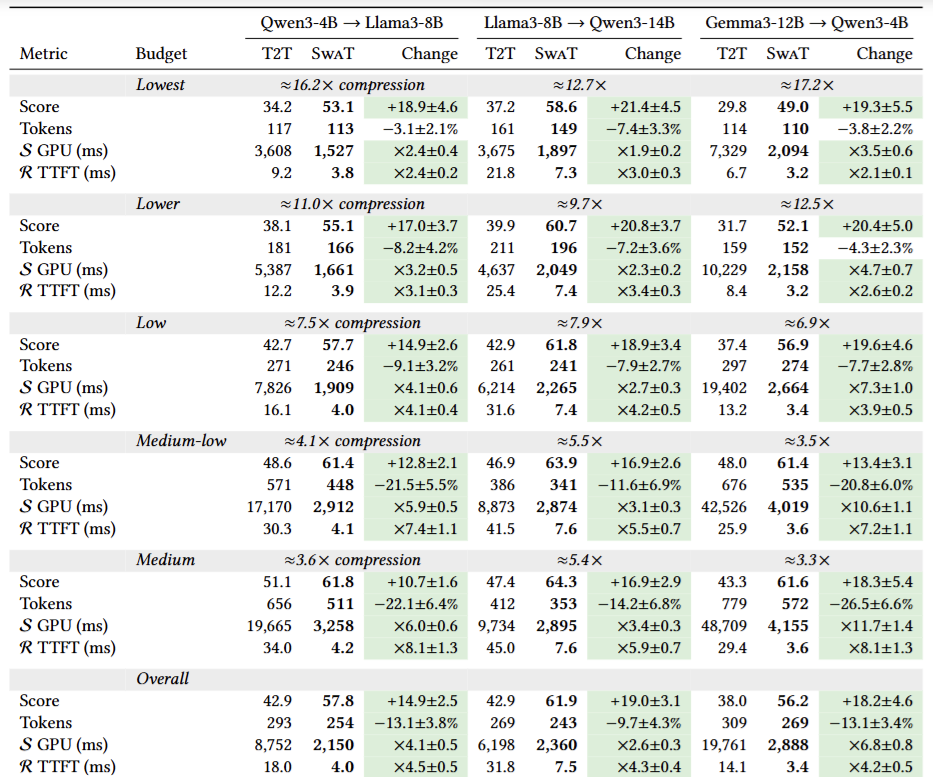

실험은 3개의 sender–receiver pair, 7개의 dataset, 5개의 communication budget에서 진행됩니다.
모든 budget에서 SwaT+AM이 T2T보다 높은 task score를 보입니다.
즉 동일하거나 더 적은 communication budget에서도 text summary보다 latent cache를 직접 전달하는 방식이 훨씬 많은 task-relevant information을 보존합니다.
성능뿐 아니라 computation 측면에서도 큰 차이가 있습니다.
T2T에서는 sender가 summary를 autoregressive하게 생성해야 하기 때문에 sender-side GPU time이 큽니다.
반면 SwaT은 이미 존재하는 KV-cache를 변환하기 때문에 sender generation이 필요하지 않습니다.
전체 평균 기준으로 sender GPU time은 model pair에 따라 약 2.6× ~ 6.8× 감소합니다.
Receiver 역시 summary 전체를 prefill할 필요가 없기 때문에 Time-To-First-Token(TTFT)이 약 4배 이상 빠르게 나타납니다.
즉 SwaT은 단순히 accuracy를 개선하는 것이 아니라,
더 많은 정보를 전달하면서도 sender decoding과 receiver prefill을 동시에 줄이는 방식이라고 볼 수 있습니다.
Zero-Shot Capability Transfer
여기서 가장 흥미로운 실험은 SwaT이 단순히 같은 text information을 전달하는 것을 넘어, receiver가 원래 가지고 있지 않던 capability까지 전달할 수 있는가를 확인하는 실험입니다.
SwaT은 오직 English text로만 학습되었지만, 저자들은 vision과 Chinese capability에서도 zero-shot transfer가 가능한지를 확인합니다.
Vision → Text-only LLM
먼저 VLM을 sender로 사용하고 text-only LLM을 receiver로 사용합니다.
Sender VLM은 image와 question을 보고 짧은 caption을 생성합니다.
기존 T2T에서는 이 caption만 receiver에게 전달합니다.
하지만 SwaT에서는 sender VLM이 image와 caption을 함께 처리하면서 생성한 KV-cache 중 caption 부분의 cache를 가져옵니다.
중요한 점은 이 cache가 단순히 caption text만 포함하는 것이 아니라, VLM이 image를 본 상태에서 생성된 representation이기 때문에 visual information이 latent state에 함께 반영되어 있다는 것입니다.
이 KV-cache를 SwaT을 통해 text-only receiver에게 전달합니다.
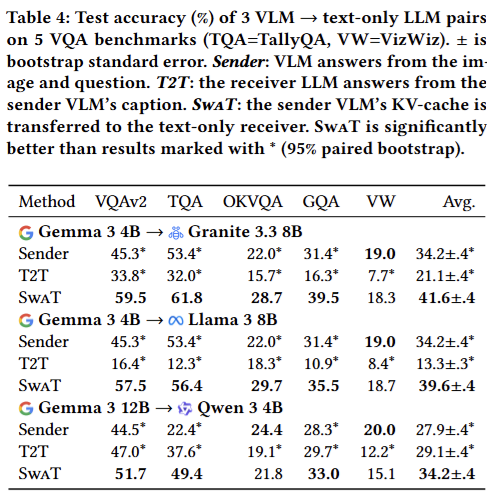
결과적으로 모든 model pair에서 SwaT이 T2T보다 큰 폭으로 높은 성능을 보였습니다.
즉 text-only receiver가 image를 직접 본 적이 없음에도, VLM sender의 KV-cache를 통해 상당한 visual information을 사용할 수 있다고 해석합니다.
일부 setting에서는 SwaT receiver가 sender VLM 자체보다도 높은 성능을 기록한다는 것이 신기하네요.
이는 sender가 visual perception을 담당하고 receiver가 stronger language reasoning을 수행하면서 서로의 장점을 결합할 수 있기 때문으로 저자는 해석합니다.
다만 저자들도 detailed visual information이 중요한 일부 benchmark에서는 항상 sender VLM보다 좋은 것은 아니라고 언급하긴 합니다.
Specialized Knowledge Transfer
다음으로 language capability transfer를 확인합니다.
Qwen 3 4B는 Chinese benchmark에서 Llama 3 8B보다 훨씬 높은 성능을 가지고 있습니다.
하지만 SwaT training data에는 Chinese text가 전혀 포함되지 않았습니다.
저자들은 Qwen이 Chinese question을 읽은 뒤 KV-cache를 SwaT을 통해 Llama에게 전달하고, Llama가 이를 기반으로 답하도록 합니다.
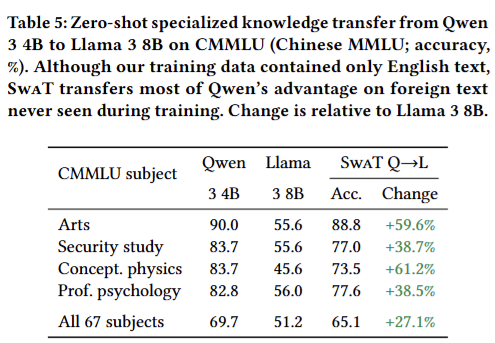
CMMLU 전체 67개 subject에서
Qwen 3 4B: 69.7
Llama 3 8B: 51.2
SwaT: 65.1
을 기록합니다.
즉 Llama가 단독으로 풀었을 때보다 크게 향상되며, Qwen과 Llama 사이의 성능 gap 중 상당 부분을 SwaT이 전달합니다.
특히 SwaT은 English-only data로 학습되었기 때문에, 이 결과는 mapper가 특정 English token이나 task pattern을 외운 것이 아니라 sender와 receiver latent representation 사이의 보다 일반적인 mapping을 학습했을 가능성을 보여줍니다.
전체 실험에서 가장 흥미로운 결과는 SwaT이 단순한 cache reconstruction method에 그치지 않는다는 점입니다.
Small → Large에서는 receiver native performance의 대부분을 유지하고,
Large → Small에서는 오히려 receiver의 native performance를 넘어서는 경우가 나타나며,
Vision → Text-only LLM이나 Chinese capability에서도 training distribution 밖의 정보를 zero-shot으로 전달합니다.
즉 이 논문에서 주장하는 cross-family latent communication은 단순히
서로 다른 모델의 KV-cache shape을 맞출 수 있다 정도의 결과라기보다는, sender가 가지고 있는 task-relevant representation과 capability 자체를 다른 model family의 receiver가 활용할 수 있도록 translation할 수 있다 는 것이 핵심 결과라고 볼 수 있습니다.
Comparison with Existing Methods
기존에도 서로 다른 model 사이에서 KV-cache를 transfer하려는 연구들은 존재하지만, 대부분 같은 model family 내부에서 동작하거나 cross-family setting에서는 receiver가 다시 text를 prefill해야 하는 한계가 있었습니다.
저자들은 기존 방법 중 Closed Form과 Dense Latent를 cross-tokenizer setting에 맞게 확장한 뒤 SwaT과 비교합니다.
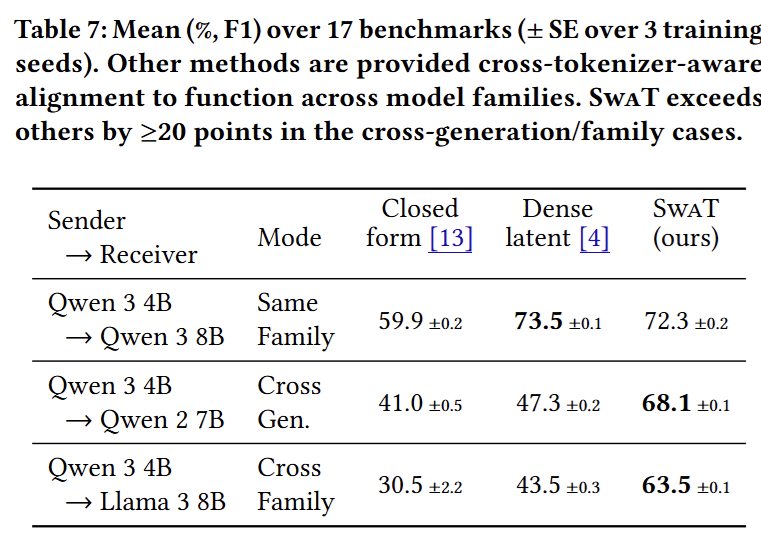
같은 Qwen family 내에서는 Dense Latent가 SwaT과 비슷하거나 조금 높은 성능을 보이지만, model generation이나 family가 달라지면 차이가 크게 벌어집니다.
즉 기존 방법들은 representation이 비교적 가까운 same-family setting에서는 동작하지만, architecture와 training pipeline이 달라지는 cross-generation / cross-family setting에서는 성능이 크게 감소합니다.
반면 SwaT은 이러한 차이를 명시적으로 고려한 Transformer mapper와 tokenizer alignment를 사용하면서 cross-family transfer에서도 높은 성능을 유지합니다.
Discussion
SwaT의 가장 큰 limitation은 sender–receiver pair마다 별도의 mapper를 학습해야 한다는 점입니다.
Model family가 n개라면 방향까지 고려해 최대 n(n−1)개의 mapper가 필요하기 때문에, agent 수가 많아질수록 scalability 문제가 발생합니다.
저자들은 향후 모든 model이 공유하는 latent space를 만들고,
각 model → shared latent space
shared latent space → 각 model
형태로 mapping하면 필요한 mapper 수를 약 2n개로 줄일 수 있다고 제안합니다.
또한 현재 실험은 한 번의 message handoff를 중심으로 다루고 있습니다.
KV-cache는 text와 달리 여러 message를 반복적으로 합치거나 composition하기 어렵고, transfer가 반복될수록 representation이 degrade될 가능성이 있기 때문에 multi-hop communication은 아직 해결되지 않은 문제입니다.
그리고 하나의 trade off인 부분은 safety 측면입니다.
KV-cache에는 sender가 실제 text로 표현하지 않은 정보까지 포함될 수 있기 때문에, text communication보다 더 많은 정보를 전달할 수 있다는 장점이 있는 동시에 어떤 정보가 전달되었는지 사람이 직접 확인하기 어렵다는 auditability 문제도 발생합니다.
감사합니다.