안녕하세요. 이번에는 Harnessing Large Language Models for Training-free Video Anomaly Detection 논문을 읽어보았습니다. CVPR 2024에 발표된 논문이고, 방법론 이름은 LAVAD입니다. 앞서 읽었던 EventVAD에서 주요 비교 대상으로 등장했던 방법이기도 한데요. 비디오에서 이상 상황을 찾는 문제를, 별도의 탐지 모델을 학습하는 대신 영상을 말로 설명하고 그 설명을 LLM이 판단하게 하는 방식으로 풀어봅니다.
1. Introduction
Video Anomaly Detection(VAD)은 비디오에서 이상 상황이 발생하는 시간 구간을 찾는 문제입니다. CCTV에 폭행이나 교통사고가 등장했다면, 영상 전체가 이상하다고 답하는 것에서 끝나는 것이 아니라 실제 사건이 발생한 프레임들에 높은 이상 점수를 주어야 하는 것이죠.
문제는 무엇이 이상한지를 미리 전부 정의하기 어렵다는 점입니다. 같은 행동도 장소와 상황에 따라 의미가 달라질 수 있고, 실제 이상 사건은 자주 발생하지도 않습니다. 그러니 다양한 이상 상황의 데이터를 충분히 모아 학습시키는 것부터 쉽지 않습니다.
기존 연구들은 4가지 방법으로 분류할 수 있었는데요. 프레임마다 정답을 제공하는 fully-supervised 방법, 영상 단위의 라벨만 사용하는 weakly-supervised 방법, 정상 영상만 학습하는 one-class 방법, 라벨 없이 학습하는 unsupervised 방법 등이 있습니다. 다만 이들 모두 대상 데이터로 모델을 학습하는 과정을 필요로 합니다. 물론, 환경이 바뀌면 데이터를 다시 모으고 모델을 조정해야 하구요.
여기서 저자들이 던지는 질문은 간단합니다. 이미 많은 시각 정보와 언어 지식을 학습한 모델들이 있다면, 그 모델들을 그대로 사용해서 VAD를 수행할 수는 없을까요?
기본 아이디어는 프레임을 캡션으로 바꾼 뒤 LLM에 이상 정도를 물어보는 것입니다. 예를 들어 사람이 다른 사람을 공격하고 있다는 설명이 정확하게 주어진다면, LLM이 가진 상식으로 그 상황이 이상하다고 판단할 수 있다는 것이죠. 다만 여기에는 중요한 전제가 있습니다. LLM이 읽는 설명이 실제 영상의 내용을 제대로 담고 있어야 합니다.
저자들은 단순한 프레임별 캡션 접근의 문제를 두 가지로 짚습니다. 첫째, 캡션이 틀리거나 불완전할 수 있습니다. 둘째, 한 프레임의 설명만으로는 앞뒤 상황과 사건의 흐름을 알기 어렵습니다. 본 논문에서 제안한 LAVAD는 이 두 문제를 보완하고, 마지막에는 언어로 얻은 점수를 다시 시각 정보에 맞춰 정제합니다.
Contribution을 정리하면 다음과 같습니다.
- 사전학습된 VLM과 LLM만으로 추가 학습 없이 VAD를 수행하는 LAVAD를 제안함.
- Image-Text Caption Cleaning, LLM-based Anomaly Scoring, Video-Text Score Refinement를 결합해 캡션의 노이즈와 시간 정보 부족을 보완함.
- UCF-Crime과 XD-Violence에서 training-free 방식의 가능성을 보이고, 논문에서 비교한 unsupervised 및 one-class 방법들보다 높은 성능을 확인함.
2. Are LLMs Good for VAD?
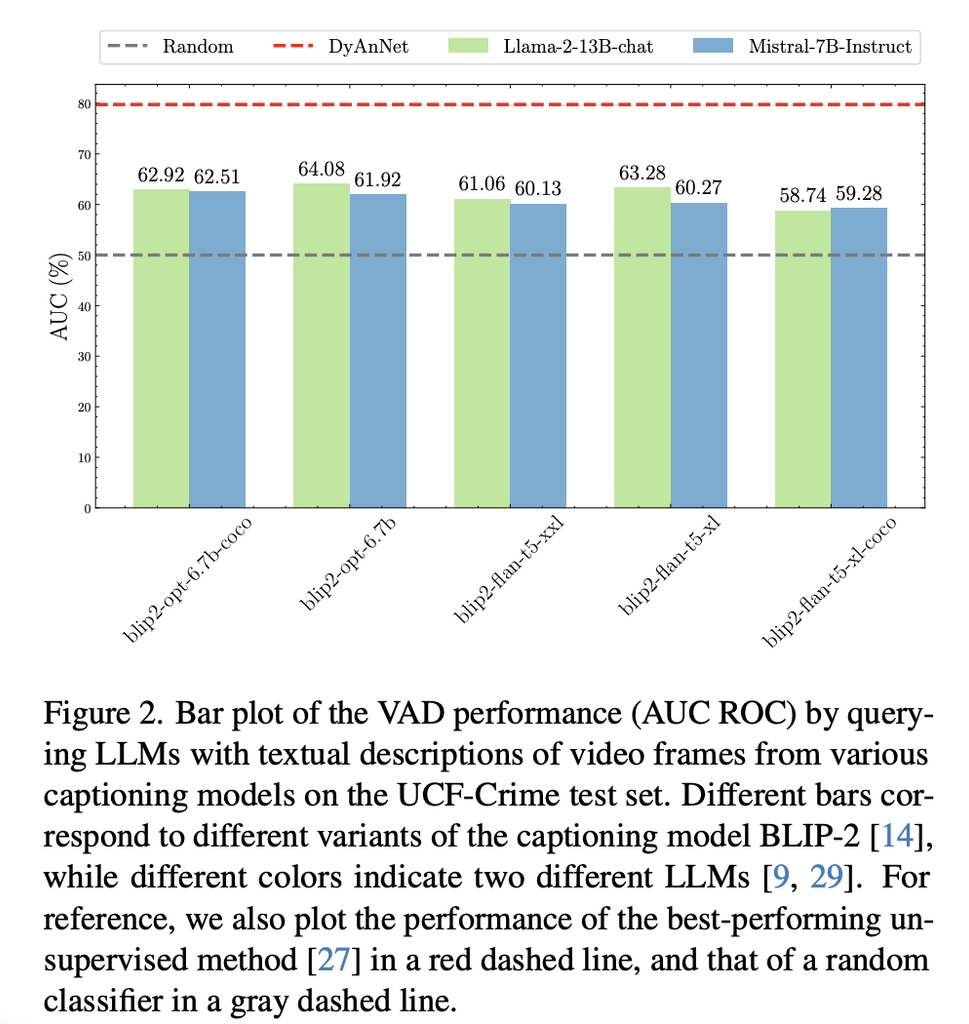
본격적인 방법론에 앞서, 저자들은 정말 LLM이 캡션만 보고 이상 상황을 판단할 수 있는지부터 확인합니다.
BLIP-2로 각 프레임의 설명을 생성하고, Llama-2로 해당 장면의 이상 점수를 묻습니다. 점수는 0부터 1까지 0.1 간격으로 나눈 11개 값 중 하나를 선택하게 합니다. 0은 정상, 1은 이상 상황에 해당합니다.
프롬프트에는 상황을 판단하는 관점도 넣습니다. 예를 들어 법 집행 기관의 입장에서 해당 장면에 얼마나 수상한 활동이 있는지 평가하도록 하는 식입니다. 이 설정은 이후 ablation에서 따로 확인합니다.
Figure 2를 보면, 단순히 프레임 캡션을 읽고 점수를 매기는 방식도 UCF-Crime에서 무작위 예측보다는 좋은 결과를 보입니다. 하지만 기존 방법들과 경쟁할 만큼 충분하지는 않습니다.
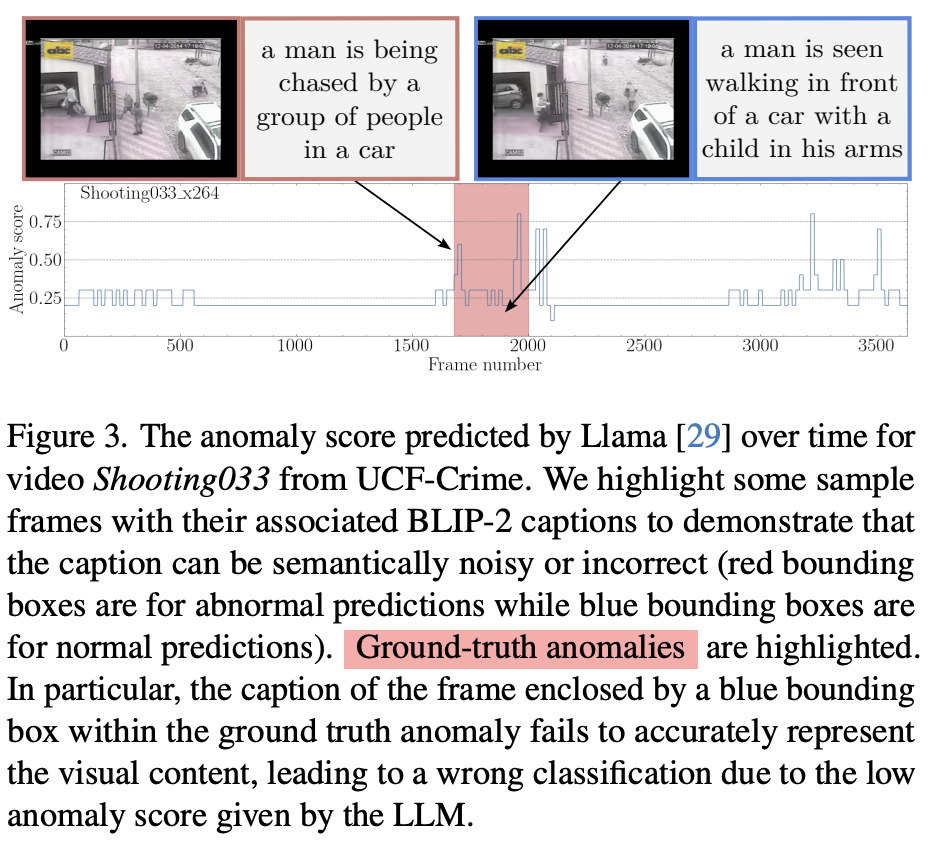
왜 그럴까요? LLM이 설명을 합리적으로 해석해도, 그 설명 자체가 영상과 다르면 결과는 틀릴 수 있기 때문입니다. 논문의 Figure 3은 실제 이상 구간에서도 캡션이 사건을 제대로 묘사하지 못하면 낮은 이상 점수가 나올 수 있음을 보여줍니다. 이에 LAVAD는 판단에 들어가는 설명과 판단 후의 점수를 함께 보정하는 구조를 만들어 이러한 현상을 방지하고자 합니다.
3. Method
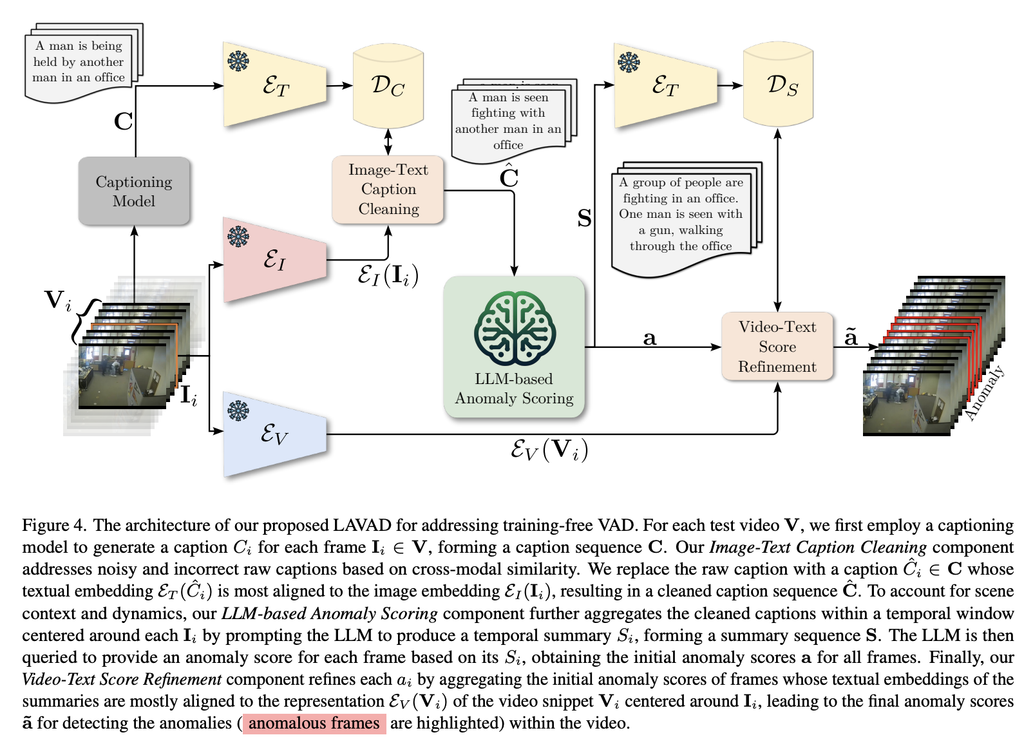
전체 흐름은 다음과 같습니다.
- 프레임별 캡션 생성 -> 2) 이미지와 맞는 캡션 검색 -> 3) 주변 캡션의 시간적 요약 -> 4) LLM의 이상 점수 추정 -> 5) 비디오-텍스트 유사도에 따른 점수 정제
역할을 먼저 나누어두면 이해하기 쉬운데요. BLIP-2는 프레임을 말로 설명하고, Llama 2는 설명들을 요약하고 이상 정도를 판단합니다. ImageBind는 비디오와 텍스트가 얼마나 잘 맞는지 비교하는 역할입니다. 그럼 각 과정이 구체적으로 어떻게 진행되는지 설명드리겠습니다.
3.1 Image-Text Caption Cleaning
첫 단계는 프레임마다 생성된 캡션을 정리하는 것입니다. 이름에 cleaning이 들어가지만, LLM에게 문장을 고쳐 쓰게 하는 방식은 아니구요. 같은 비디오에서 생성된 캡션들 중 현재 프레임과 가장 잘 맞는 것을 찾아 교체합니다.
비디오의 프레임들을 $I_1,\ldots,I_M$, 각 프레임에서 얻은 캡션들을 $\mathcal{C}=\{C_1,\ldots,C_M\}$으로 둡니다. 이미지 encoder를 $E_I$, 텍스트 encoder를 $E_T$라고 하면, 프레임 $I_i4에 사용할 캡션은 다음과 같습니다.
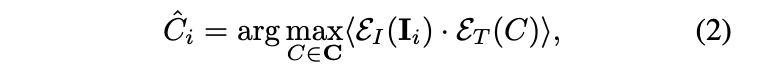
여기서 $\operatorname{sim}$은 cosine similarity입니다! 현재 프레임과 모든 후보 캡션을 공통 embedding 공간에서 비교하고, 가장 유사한 문장을 고르는 것이죠.
예를 들어 어떤 프레임의 캡션이 사람의 행동을 잘못 설명했더라도, 같은 영상의 다른 프레임에서 더 적절한 설명이 나왔다면 그 캡션을 가져올 수 있습니다.
3.2 LLM-based Anomaly Scoring
캡션을 정리했더라도 여전히 각 문장은 개별 프레임에 대한 설명입니다. 사람이 서 있다는 설명과 사람이 쓰러졌다는 설명을 따로 보는 것과, 서 있던 사람이 쓰러지는 흐름으로 읽는 것은 다르겠죠.
그래서 각 프레임 I_i를 중심으로 T초의 temporal window를 잡고, 그 안에서 N개 프레임을 균일하게 선택합니다. 해당 프레임들의 정제된 캡션을 시간 순서대로 LLM에 넣고, 무슨 일이 있었는지 몇 문장으로 요약하도록 합니다.
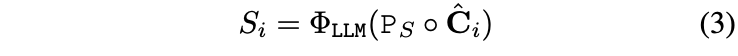
P_S는 요약 지시문, $\circ$는 텍스트를 이어 붙이는 연산입니다. 요약 프롬프트는 다음과 같습니다.
Please summarize what happened in few sentences, based on the following temporal description of a scene. Do not include any unnecessary details or descriptions.
이렇게 만든 temporal summary $S_i$를 다시 LLM에 넣어 이상 점수 a_i를 받습니다.
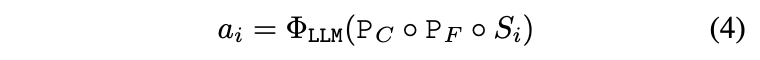
P_C는 어떤 관점에서 이상 정도를 판단할지 알려주는 context prompt이고, P_F는 출력 형식을 지정합니다. 점수는 {0,0.1,$\ldots$,1.0} 중 하나를 고르고, 추가 설명 없이 [0.8] 같은 Python list 형태로 출력하도록 합니다.
3.3 Video-Text Score Refinement
이제 프레임별 이상 점수를 얻었습니다. 그런데 이 점수는 어디까지나 텍스트 요약을 읽고 나온 값입니다. 요약이 시각적으로 잘 맞는지, 같은 비디오의 비슷한 장면들이 어떤 점수를 받았는지는 아직 반영하지 않았습니다.
마지막 단계에서는 현재 프레임 주변의 비디오 snippet $V_i$를 ImageBind의 video encoder로 인코딩합니다. 그리고 같은 비디오의 모든 temporal summary와 비교해 가장 유사한 K개를 찾습니다. 그 요약들의 인덱스 집합을 $\mathcal K_i$라고 하면, 최종 점수는 다음과 같습니다.
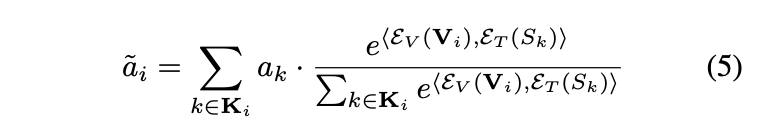
해당 수식을 통해, 현재 비디오 구간과 잘 맞는 설명들을 찾고, 그 설명들이 받은 이상 점수를 유사도에 따라 가중평균합니다.
4. Experiments
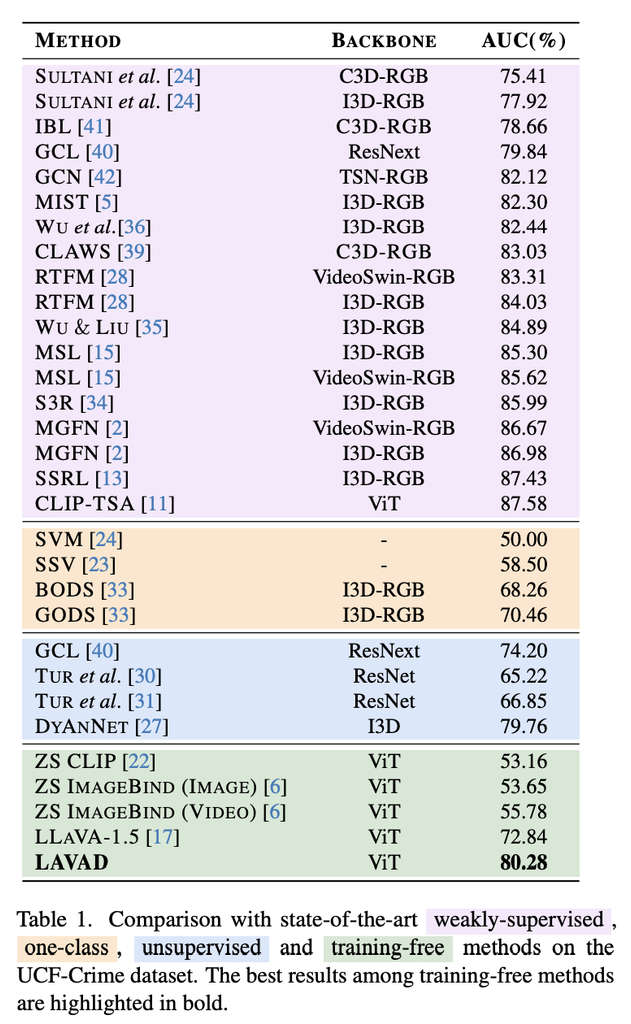
VAD 도메인에서 많이 사용되는 UCF-Crime 벤치마크에서의 성능을 Table 1에서 확인하실 수 있습니다.
LAVAD는 AUC 80.28로, 비교된 unsupervised 방법 중 높은 성능을 보였던 DyAnNet보다 0.52% 정도 성능이 높은 것을 확인할 수 있습니다. 다만 wekly-supervised 방법론의 CLIP-TSA의 87.58보다는 낮은 모습을 보이는데요.
추가 학습 없이도 일부 학습 기반 방법론들과 경쟁할 수 있다는 것이 LAVAD의 핵심이라고 보시면 되겠습니다.
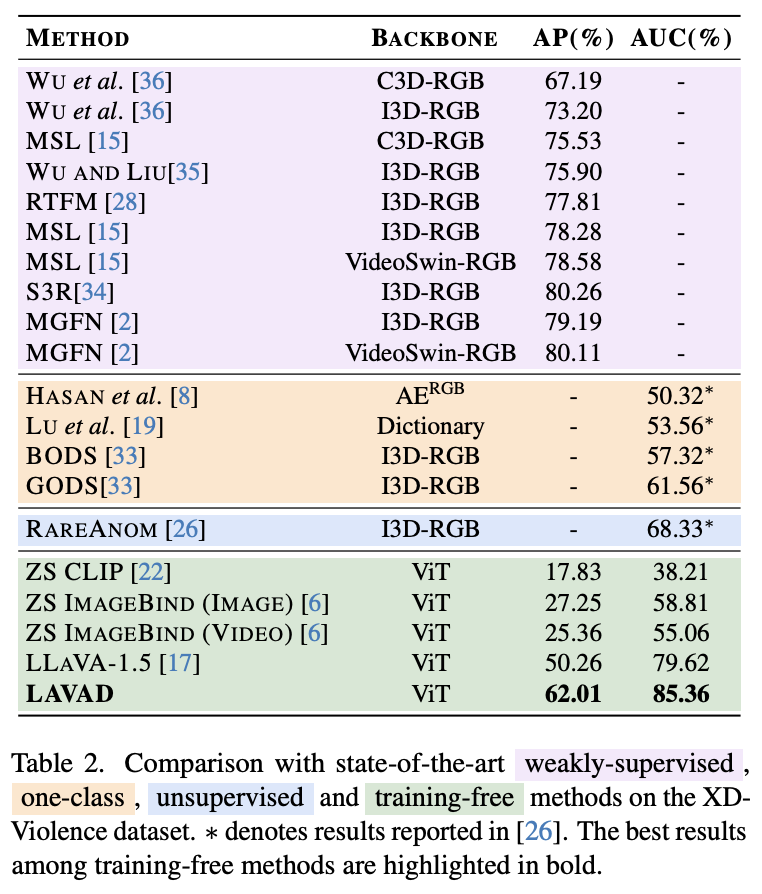
Table 2도 마찬가지로 VAD 도메인에서 많이 리포팅되는 XD-Violence 벤치에서의 성능 리포팅입니다. 여기서도, 전체 VAD 성능의 최상단을 대체하지 못했지만… training-free 설정의 가능성을 보인 결과로 볼 수 있겠습니다.
그렇다면 실제로 어떤 단계가 도움이 되었을까요? 본문 Table 3은 UCF-Crime에서 구성 요소를 하나씩 제외한 결과입니다.
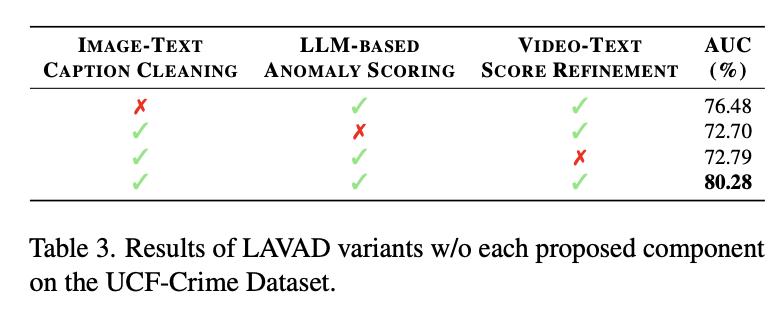
결과를 보면 시간적 요약과 마지막 점수 정제를 뺐을 때 각각 7%p 이상 떨어집니다. 캡션을 다듬는 것만으로는 충분하지 않고, 사건의 흐름을 묶어 읽는 과정과 언어 점수를 시각 정보에 맞추는 과정이 모두 중요하다는 것이죠.
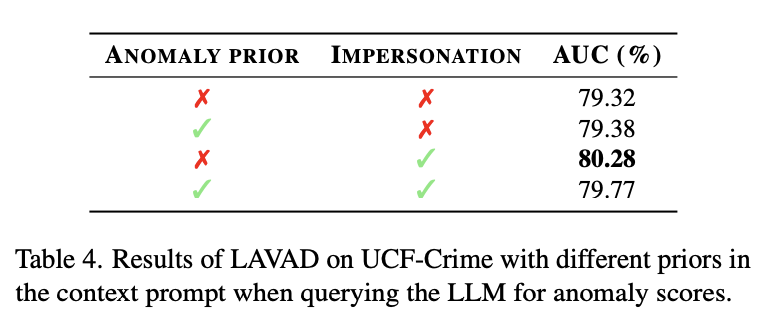
프롬프트에 어떤 맥락을 넣는지도 확인합니다. UCF-Crime의 기본 프롬프트는 AUC 79.32이고, 법 집행 기관의 입장에서 판단하도록 하는 impersonation을 추가하면 80.28로 올라갑니다.
반면 의심스러운 활동뿐 아니라 잠재적인 범죄 활동도 고려하라는 anomaly prior만 넣으면 79.38입니다. 두 조건을 모두 넣었을 때는 79.77이고요. 정보를 더 많이 넣는다고 계속 좋아지는 것은 아닙니다.