안녕하세요. 이번에는 논문 리뷰가 아니라 최근 참가했던 IROS 2026 Earth Rover Challenge 후기를 한번 적어보고자 합니다. 이번 글에서 원래 후기글 느김으로 단순히 느낀점 위주로 적으려다가 뭔가 의식의 흐름대로 작성하다보니 실패했습니다. 그래서 그냥 개인 기록용으로 적는 느낌으로 적었는데, 제가 어떤 문제를 마주했고, 이를 해결하기 위해 어떤 방법들을 시도했고, 최종적으로 챌린지에는 어떤 파이프라인을 들고 갔는지 위주로 설명드리겠습니다. 후기글 치고 글이 길어져서 핵심만 보고 싶으시면 전체 내비게이션 파이프라인쪽으로 바로 넘어가서 읽어도 괜찮을 것 같습니다.
Earth Rover Challenge 소개
먼저 Earth Rover Challenge가 어떤 대회인지 간단하게 소개드리겠습니다.
이 대회는 FrodoBots에서 제작한 저가형 소형 이동 로봇인 Earth Rover Mini+를 이용해서 여러 지역에 배치된 로봇을 원격으로 제어하면서 주어진 내비게이션 미션을 수행하는 대회입니다. 참가자는 로봇이 제공하는 센서 데이터를 제공하는 SDK 서버를 통해서 받아오고, 자체적으로 개발한 알고리즘을 실행하고 해당 알고리즘의 output에 따라 원격으로 로봇을 제어하는식으로 진행합니다. 대회는 크게 Urban Navigation, Indoor Navigation, Off-road Navigation, Marathon의 4개 트랙으로 구성되어 있습니다.
자세한 내용은 Earth Rover Challenge 공식 홈페이지를 참고하시면 좋을 것 같습니다.
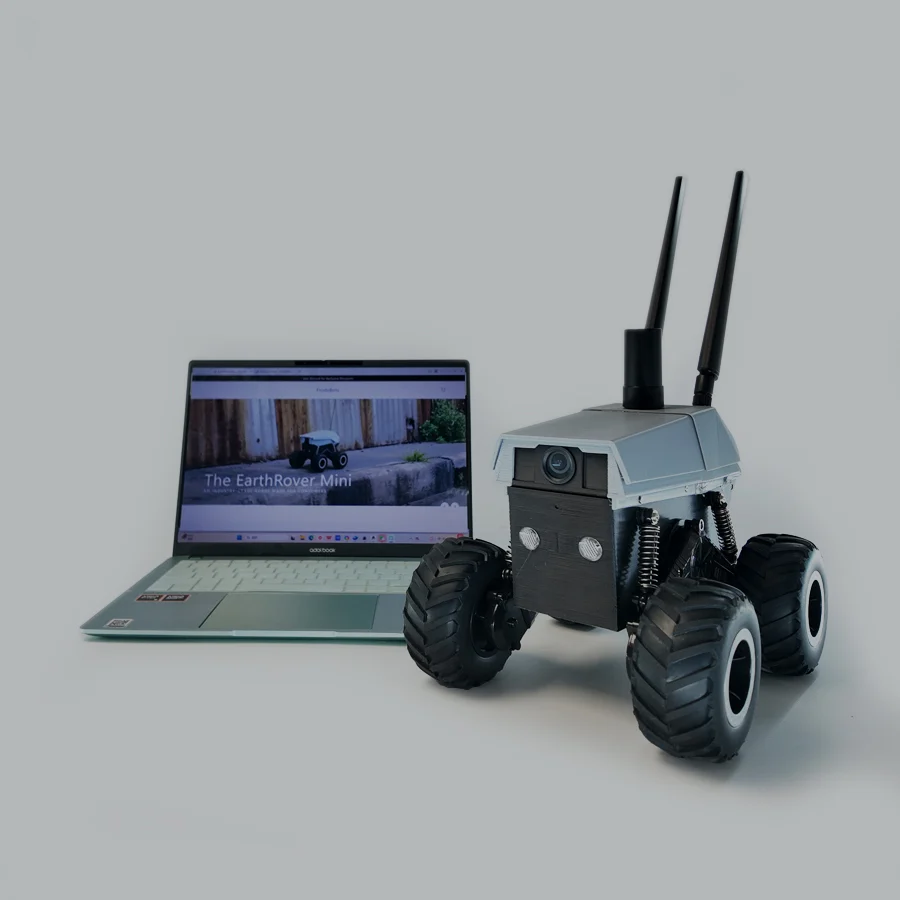
로봇의 크기는 위 사진처럼 노트북 정도의 크기로 굉장히 작습니다. 처음에는 로봇이 작으면 오히려 움직이기 편하지 않을까 싶었는데, 실제로 대회를 준비하면서 느낀 점은 이렇게 작은 로봇이라는 사실 자체가 생각보다 큰 제약으로 작용한다는 점입니다. 가장 큰 문제는 카메라의 시점입니다. 카메라가 지면과 굉장히 가까운 위치에 있다 보니, 입력 영상에서 바닥이 차지하는 비율이 매우 높았습니다. 실제로 로봇이 제공하는 영상을 보면 절반 가까이가 바닥이라고 보시면 됩니다.
일반적인 높이에 설치된 카메라를 기준으로 개발된 비전 알고리즘을 그대로 적용하기에는 생각보다 불리한 조건이고, 또 소형 저가형 플랫폼이다 보니 센서 정보의 정확도나 잔고장 측면에서도 아쉬운 부분이 있었습니다. 센서가 아예 없는 것은 아니지만, 제공되는 값을 무조건 신뢰할 수가 없었습니다. 여기에 원격 테스트 환경도 예약제로 운영되었는데, 한국 시간 기준으로 대부분 새벽에 테스트해야 했고 예약 자체도 쉽지 않았습니다. 따라서 실제 대회 환경에서 충분한 검증을 진행하기 어렵다는 문제가 있었습니다.
암튼 이런 여러 제약 속에서 대회를 준비하게 되었습니다. 저희 팀은 대회 초반에는 다 같이 Urban Navigation을 목표로 준비하다가, 중간부터 트랙을 나눠서 개발을 진행했습니다. Urban Navigation은 정우님이 메인으로 담당하셨고, 저는 Indoor Navigation과 Off-road Navigation을 메인으로 준비했습니다. 따라서 이번 글에서는 제가 담당했던 Indoor와 Off-road를 중심으로 설명드리겠습니다. Urban Navigation에 대한 내용은 정우님의 후기글을 참고하시면 좋을 것 같습니다.
Indoor Navigation — 일단 SLAM부터 해보자
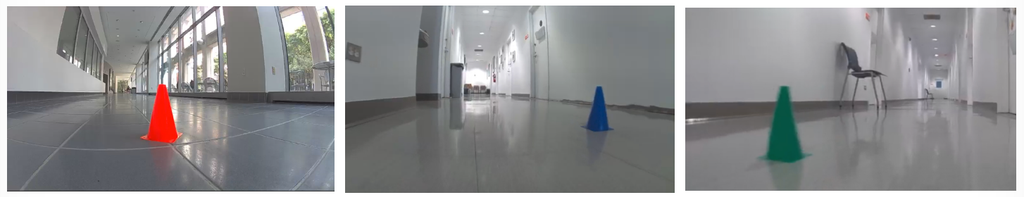
먼저 Indoor Navigation입니다. 저희가 참가했던 Indoor 미션은 NYU 대학교 건물 내부를 주행하면서 숨겨진 교통 콘 4개를 찾아 방문하는 것이었습니다.
주행 환경은 아래와 같습니다.
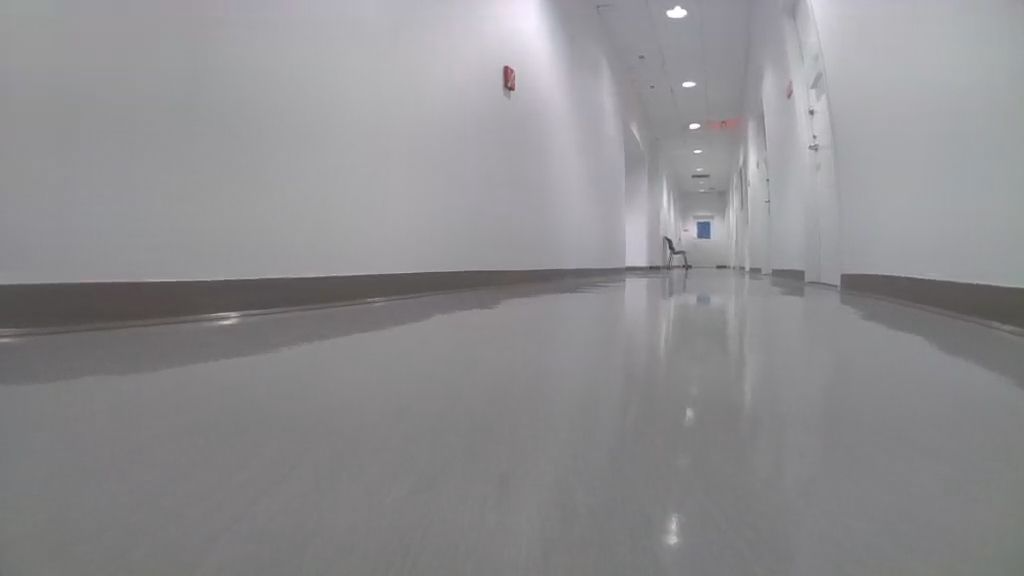
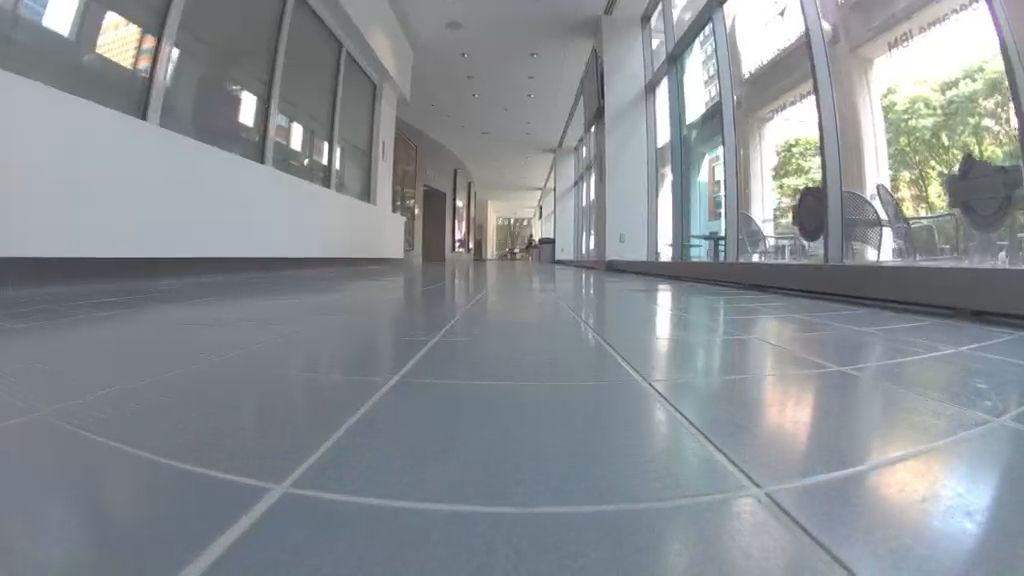
보시면 아시겠지만 전형적인 대학혹은 회사 기관과 같은 특징점이 많이 없는 건물의 복도 구조입니다. 공간 자체는 꽤 넓었는데, 체감상 저희 AI 센터 4층의 3~4배 정도 되는 규모였던 것 같습니다. 참고로 NYU 팀도 해당 대회에 참가했는데, 아무래도 실제 주행 환경에 익숙하고 별도의 예약 없이 바로바로 테스트 해볼 수 있다는 점에서 너무 유리하지 않나 싶습니다.
암튼 제가 처음 생각했던 접근은 굉장히 단순했습니다. 어차피 고정된 실내 환경에서 콘을 찾는 문제면 처음부터 해당 환경을 예약해서 미리 SLAM으로 매핑해버리면 되지 않을까 였고 그래서 원격 테스트 시간을 한번 확보한 뒤, 로봇을 이용해서 NYU 내부를 최대한 돌아다니고 그 과정에서 전체 지도를 구축해놓자는 계획이었습니다.
이렇게 만들어둔 지도가 있다면 이후에는 로봇의 위치를 추정하면서 탐색하지 않은 영역을 찾아가는 방식으로 문제를 해결할 수 있을 것이라고 생각했습니다.
Visual SLAM 적용
일반적으로 SLAM은 로봇의 위치를 추정하는 Localization과 주변 환경의 지도를 구축하는 Mapping을 동시에 수행하는 기술입니다. 이를 조금 더 구체적으로 설명하면, 로봇이 움직이면서 연속된 관측 정보를 이용해 자신의 상대적인 움직임을 추정하고, 해당 관측들을 일관된 좌표계에 정합하면서 지도를 구축하는 방식입니다.
그런데 이런 상대적인 움직임을 계속 누적하다 보면 작은 오차들이 쌓이게 됩니다. 그래서 이전에 방문했던 장소를 다시 인식했을 때, 해당 장소가 이전 지도상의 위치와 일치하도록 제약을 추가하고, 그동안 누적된 위치 및 지도 오차를 최적화하는 과정을 수행합니다. 이것이 어떻게 보면 Loop Closure의 개념인데 암튼 SLAM에서 중요한 것은 서로 다른 시점에서 관측한 장면들이 기하학적으로 어떻게 연결되는지를 안정적으로 추정하는 것이라고 보시면 됩니다.
근데 앞서 말씀드렸듯이 Rover Mini+에서 저희가 사용할 수 있는 센서 정보만으로는 안정적인 외부 Odometry를 확보하기가 쉽지 않았습니다. 물론 SLAM이 반드시 외부 Odometry를 입력받아야 하는 것은 아닙니다. LiDAR기반 SLAM 같은 경우에는 Depth 정보를 통해서 odometry를 구해서 SLAM을 진행할 수 있고, Visual SLAM 같은 경우(예를 들어 ORB SLAM)은 이미지 자체에서 카메라의 상대적인 움직임을 추정해서 이걸 바탕으로 SLAM을 수행할 수 있습니다. 그래서 생각했던 것이 RGB 이미지 시퀀스만으로 카메라의 Pose와 3D 구조를 추정하는 방법을 활용해보자는 것이었습니다.
이 과정에서 시도한 방법이 MASt3R-SLAM과 VGGT-SLAM입니다. 두 방법 모두 최근의 3D Vision Foundation Model을 활용하는 SLAM 방법론입니다. 간단하게 설명드리면, MASt3R은 두 이미지 사이의 기하학적 관계를 예측하는 Two-view 기반 모델이고, VGGT는 여러 이미지를 함께 입력받아 카메라 Pose와 장면의 3D 구조를 추정하는 Multi-view 기반 모델입니다. 물론 이것 이외에도 디테일한 부분의 차이는 있는데 아래에서 디테일한 부분은 설명하도록 하겠습니다. 암튼 이런 모델들은 3D 기하학 예측 결과를 가지고 기존의 외부 Odometry정보에 의존하지 않고도 이미지 기반의 SLAM을 구성할 수 있습니다. 다만 해당 모델에서 예측한 3D 구조는 실제 거리 스케일이 정확하다고 보장할 수 없기 때문에, 로봇 내비게이션에 활용하려면 별도의 스케일 보정이 필요합니다. 그래서 이 부분은 사전에 알고 있는 카메라 높이와 지면 추정을 통해 보정을 하고자 했습니다.
MASt3R-SLAM 적용
일단 가장 먼저 적용했던 방법은 MASt3R-SLAM입니다. MASt3R-SLAM을 먼저 선택한 이유는 RANGER: A Monocular Zero-Shot Semantic Navigation Framework through Visual Contextual Adaptation라는 논문에서 MASt3R-SLAM과 VGGT-SLAM을 이용한 3D 재구성 결과를 비교했는데 저자들이 사용한 환경에서는 MASt3R-SLAM이 더 안정적인 지도 재구성 결과를 보여주었습니다. 그래서 그럼 여기서도 MASt3R-SLAM이 더 좋을 확률이 높지 않을까 하는 마음에 적용을 먼저 했습니다. 아래는 실제 해당 논문에서 비교한 결과입니다.
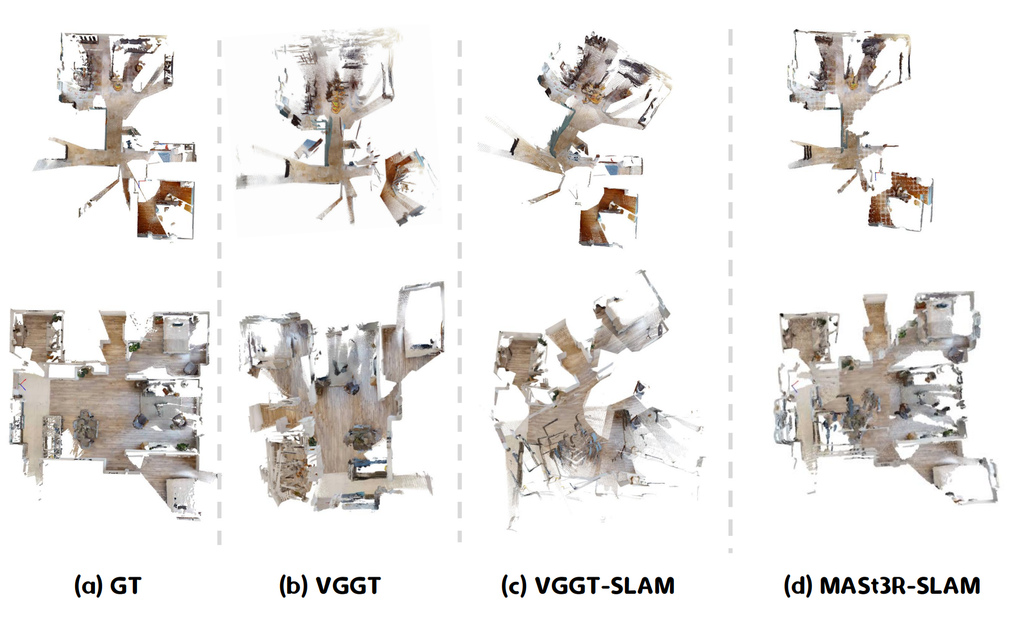
MASt3R-SLAM의 동작 방식을 간단하게 설명하면 MASt3R에서 예측한 Pointmap과 대응 관계를 이용해 카메라의 움직임을 추정하고, 이를 기반으로 3D 지도를 점진적으로 구축하는 방식입니다. 새로운 프레임이 들어오면 기존 키프레임간 명시적인 대응점을 찾고 이 대응 관계를 이용해 두 프레임간 기하학적 관계를 추정하고, 필요에 따라 새로운 키프레임을 추가하면서 구한 pose를 누적시키면서 3D 지도를 구축합니다. 그리고 나서 Loop Closure와 전역 최적화를 통해 odomerty와 전체 3D 지도를 보정합니다.
그래서 먼저 NYU 테스트를 예약하고 해당 환경에서 구석구석 돌아다니는 영상을 가져오고 해당 데이터를 기반으로 Mast3r-SLAM을 적용했습니다. 근데 실제로 적용해보니 생각보다 잘 동작하지 않았습니다.
앞서 보여드렸던 이미지를 다시 보시면 Rover Mini의 카메라 시점에서는 화면의 상당 부분이 바닥으로 채워져 있습니다. 근데 이 바닥은 시각적으로 구분할 수 있는 특징이 거의 없거나 비슷한 패턴이 계속 반복되는 영역일 뿐더러 게다가 바닥을 제외하고 보더라도 복도 구조 자체가 단순하고 반복적이어서 서로 다른 위치의 영상이 상당히 비슷하게 보였습니다. 이런 환경에서는 두 이미지에서 동일한 3D 지점을 안정적으로 대응시키기가 어려워집니다.
MASt3R-SLAM같은 경우에는 명시적으로 이미지 간 대응 관계를 이용해 Tracking을 수행하기 때문에 NYU환경에서 실제로 대응 관계가 부족하거나 신뢰도가 떨어지면 Localization자체를 실패하는 경우가 계속 생겼습니다. 저희가 테스트했던 영상에서는 Tracking이 자주 실패하면서 연속적인 카메라 Pose 추정이 제대로 이루어지지 않았고 결과적으로 지도 구축이 중간에 아예 진행되지 않는 결과를 보였습니다.
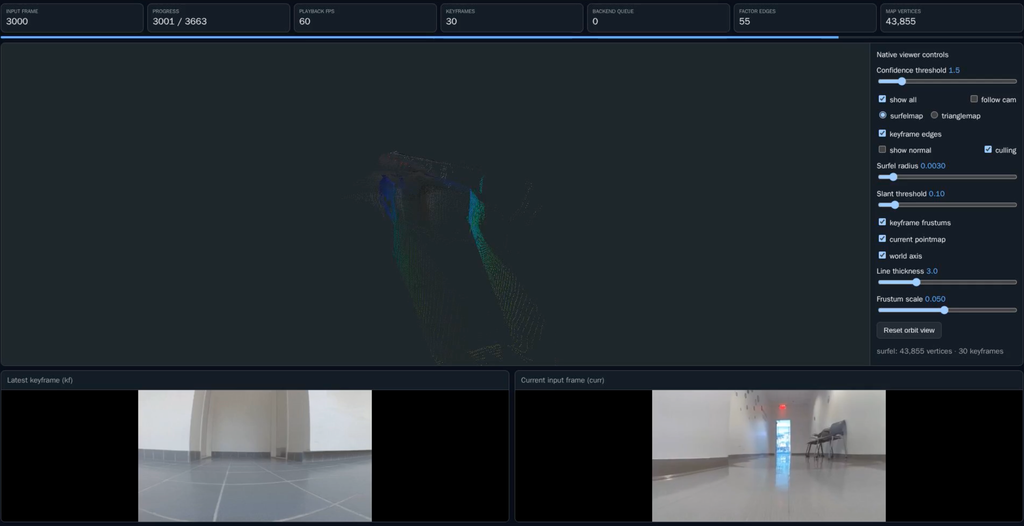
위는 전체 녹화한 영상에서 끝부분에 해당하는 부분을 캡쳐한건데, 실제로 키프레임을 정하고 이 키프레임 기준으로 현재 프레임은 어느정도 상대적인 움직임였는지를 추정하고 그걸 누적하면서 map을 구축해야하는데 초반에 키프레임과 현재 프레임간 대응관계를 구하지 못하고 키프레임이 업데이트가 되지못하면서 이게 결국 localization 실패로 이어져 그 뒤로 부터 맵을 구축하지 못하는 모습을 보입니다.
VGGT-SLAM 적용
VGGT-SLAM은 MASt3R-SLAM과 조금 다른 방식으로 SLAM을 구성하는데 가장 큰 차이는 여러 이미지를 하나의 Submap 단위로 처리하는 것이고 MASt3R-SLAM처럼 매번 연속 이미지 사이에서 명시적으로 대응점 매칭을 통해 대응관계를 구하는 구조는 아니라는 점에서 차이가 있습니다.
MASt3R-SLAM은 Two-view 기반의 기하학적 대응 관계를 중심으로 Tracking과 Mapping을 누적 수행하는 반면, VGGT-SLAM은 일정한 이미지 시퀀스를 한번에 VGGT에 입력해서 Submap을 재구성하고, 이렇게 생성된 Submap들을 점진적으로 정합하는 방식입니다. 물론 VGGT-SLAM에도 이미지 검색이나 기하학적 정합 과정이 존재하기 때문에 특징점이나 대응 관계가 전혀 필요 없는 방법은 아닙니다 다만 MASt3R-SLAM처럼 매번 두 이미지 사이의 명시적인 포인트맵 매칭에 의존하는 구조는 아니다 정도로 이해하시면 좋을 것 같습니다.
그런데 생각보다 VGGT-SLAM이 MASt3R-SLAM보다 초기 매핑을 더 안정적으로 진행하는 모습을 보이긴 했습니다. MASt3R-SLAM에서는 이런 명시적인 특징점 매칭의 실패로 인한 Tracking 문제 때문에 초반부터 제대로 진행되지 않는 경우가 많았는데 VGGT-SLAM은 그래도 두이미지가 아닌 여러 이미지 시퀀스를 한번에 보기 때문문이서 그런가 그래도 적어도 일정 구간에 대해서는 그럴듯한 지도를 구축했습니다.
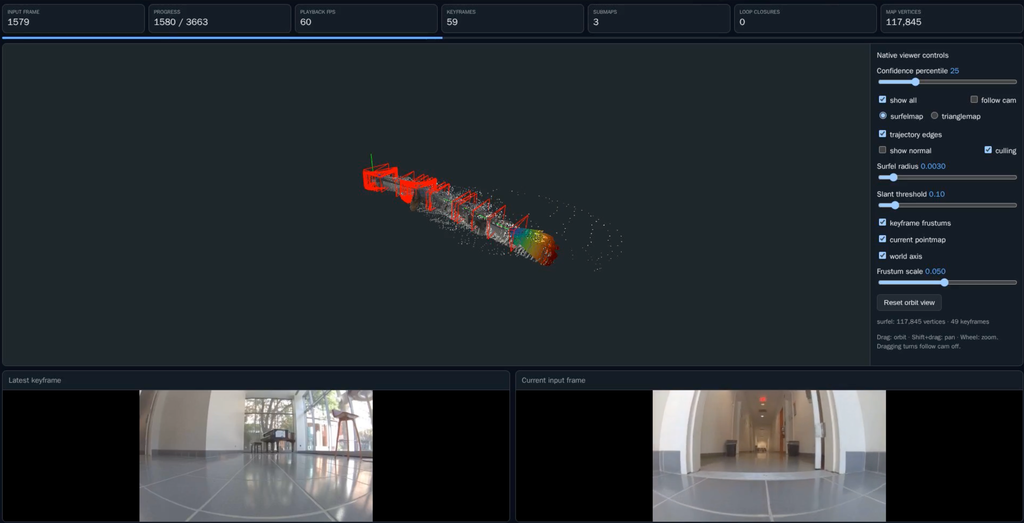
근데 Loop Closure나 이전 submap과 현재 구축한 submap을 정합하는 과정에서 지도가 정합이 깨지는 결과를 보였습니다. 처음에는 나름 괜찮게 지도를 구축하는 것처럼 보이다가 이전 영역을 다시 연결하고 전역 정합을 수행하는 과정에서 아래처럼 전체 지도의 구조가 망가지는 경우가 생겼습니다.
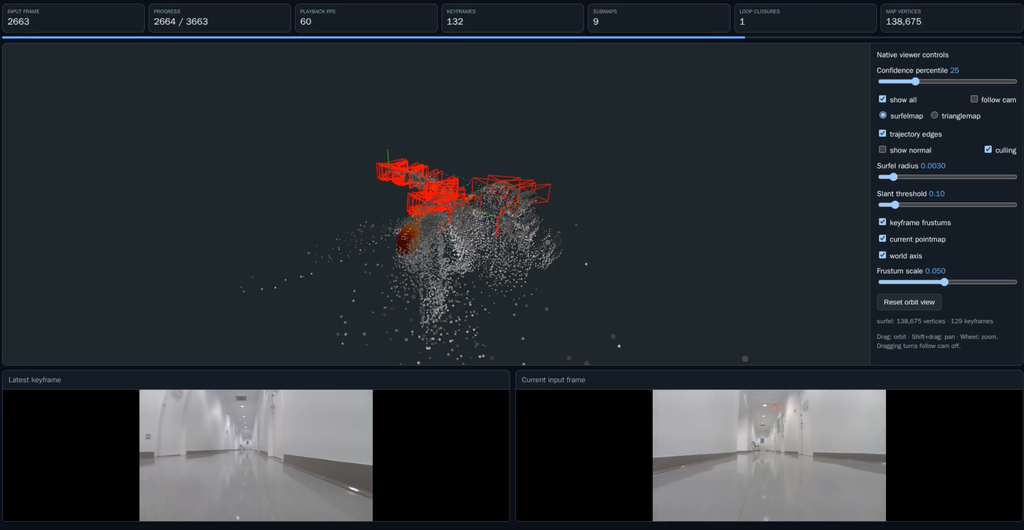
우선 MASt3R-SLAM에서 문제가 되었던 저시점 영상과 반복적인 바닥 패턴이 VGGT에도 영향을 주었을 가능성이 있습니다.
VGGT가 다양한 이미지에서 3D 구조를 예측할 수 있는 Foundation Model이라고 하더라도 Rover Mini+처럼 극단적으로 낮은 카메라 시점과 단순한 바닥 텍스처로 구성된 이미지가 학습 데이터에 얼마나 포함되어 있었을지 충분히 이런 상황에도 강인하게 대응할 수 있는 모델인지는 모르겠으나,, 실제로 비슷한 환경에서 DA3와 같은 다른 Geometry Foundation Model을 테스트했을 때에도 바닥 영역의 예측 결과가 좋지 않았었는데 이런이유도 한몫하지 않았을까하는 제 개인적인 생각입니다. 실제로 아닐 수도 있습니다.하하 뭐 SLAM 모델 자체의 잘못된 장소 인식, 부정확한 Submap 간 기하학적 제약이라던가, 전역 최적화 과정에서의 오차 등 여러 원인이 있을 수도 있습니다. 그래서 실제 4층에서도 시점 높였을 때랑 낮췄을 때 두 방법론 mast3r, vggt slam 한번 비교했었는데 결과적으로 시점 높이면 잘되고 낮추면 여전히 안되는 문제를 보였습니다.
시점 높였을 때 (위: mat3r slam, 아래: vggt slam)
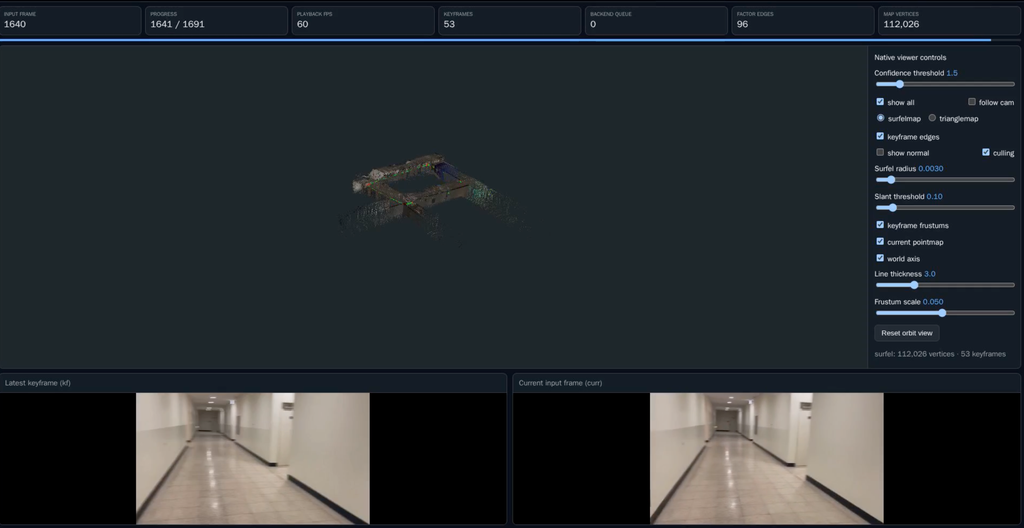
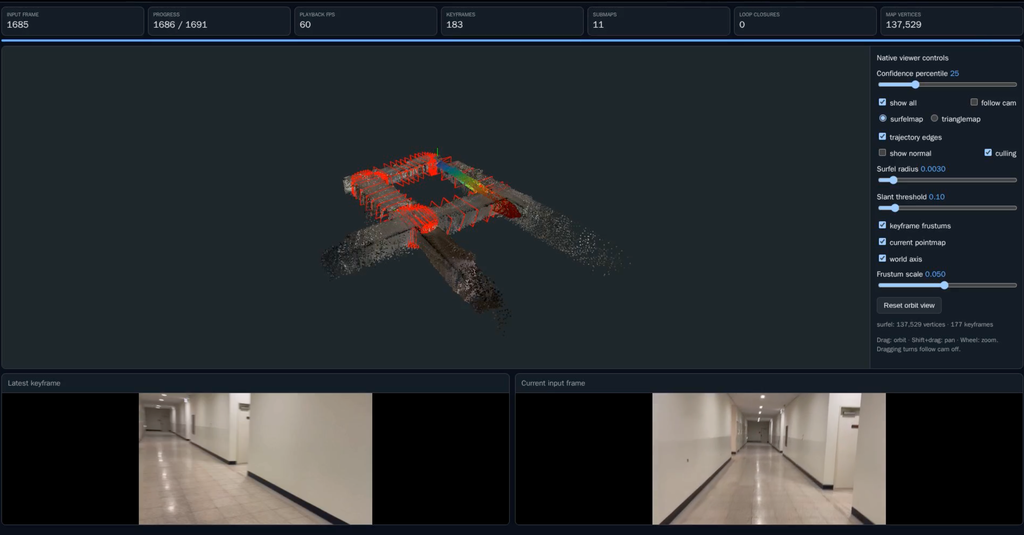
시점 낮춰서 진행한 시각화 결과는 따로 저장을 안한건지 안보이네요,, 암튼 시점 낮췄을 때 두 방법론 모두 잘 동작하지 않아서결과적으로 일단 바닥뷰 시점에다가 특징점이 부족한 단순한 환경에서 동작이 어렵다 정도로 마무리하고 깔끔하게 SLAM은 포기했습니다.
그리고 뭔가 결론이 그래도 mast3r가 못했던걸 vggt slam은 했네 정도로 끝난 느낌이라 다시한번 정리하면 여기서 VGGT모델이 MASt3R모델보다 GFM 모델로써 성능이 좋다고 이를 기반으로 한 SLAM이 반드시 더 정확하거나 안정적이지는 않다고 보시는 게 좋을 것 같습니다. 앞선 부분에는 제 개인적인 생각이 들어가 있는 부분도 많고 사실 SLAM 관점에서 실제 성능은 여기에 사용되는 파운데이션 모델의의 기하학 예측 능력뿐 아니라 Tracking, 대응점 처리, 최적화 제약, Loop Closure 설계에 크게 좌우되기 때문에 백본의 방법론이 좋은 성능을 보인다라고 해서 SLAM을 잘한다라고 보시지 않았으면 좋겠습니다.
암튼 사전 맵구축은 포기하고 대신 글로벌 맵 없이도 현재 카메라에서 관측되는 로컬맵을 최대한 잘 활용하자 라는 방향으로 접근을 바꾸게 되었습니다.
BEV Local Costmap 구축
여기서 먼저 설명드려야 할 부분이 있는데,저는 이번 문제를 E2E 기반의 Planning이 아니라 Modular 방식으로 해결하고자 했습니다. 모델이 이미지 하나를 입력받아서 곧바로 planning을 하기보다는, 각 구성 요소의 역할을 분리해서 별도의 planning 모듈을 따로 두는 식으로 접근하고자 했습니다.먼저 BEV Local Costmap을 구축하기 위해서는 주변 환경의 3D 정보가 필요합니다. 그래서 RGB 이미지에서 Depth를 추정할 수 있는 모델이 필요했고 이때 MoGe2를 사용했습니다.
MoGe2를 활용한 Metric Depth 추정
MoGe2를 선택한 이유는 실시간성 측면과 depth 예측 결과가 비교적 괜찮았습니다. 일단 MoGe2는 단일 이미지로부터 Depth를 예측하는 모델이고 별도의 Metric Scale factor도 같이 예측해서 실제로 metric depth를 추정하는 모델입니다. 근데 이렇게 MoGe2가 metric depth를 예측한다고는 하지만 0~1 사이의 값만 아닐 뿐 사시상 relative나 다름 없는 결과를 보입니다. 실제로 모델을 돌려보면 가까이에서 실제 거리와 1m 이상 차이가 나는 값을 예측하는 경우가 많습니다. 실제 센서과제를 하면서도 GT가 있는 데이터를 가지고 정량적으로 보았을 때에도 이 moge라는 모델 혹은 depth pro와 같은 metric scale을 예측하는 scale factor 예측하는 헤드가 그렇게 그에 맞는 정확한 스케일 값을 예측하지는 못합니다. 물론 목표 방향만 선택하는 경우에는 상대적인 거리나 구조 정보만으로도 어느 정도 판단이 가능할 수 있지만, 실제 로봇이 장애물 회피 관점에서 안전하게 이동시키려면 거리 스케일의 정확도는 중요합니다.
그래서 이를 보정하고자 먼저 MoGe2가 예측한 Depth를 기반으로 RANSAC을 이용해 지면 평면을 추정하고 해당 지면을 (z=0)인 평면으로 가정하고, 사전에 알고 있는 Rover Mini의 카메라 설치 높이를 이용해서 실제 카메라와 지면 사이의 depth를 구합니다. 그리고 이 값을 Reference로 삼아 MoGe2가 예측한 카메라와 지면 사이의 depth의 scale을 보정하는 식으로 Moge2의 metric scale을 보정하였습니다.
실제로 해당 방식을 적용하고 나서 2m 이내의 가까운 객체들을 기준으로 간단하게 비교했을 때 대략 10cm 미만 수준의 오차를 보이는 경우를 확인할 수 있었습니다. 물론 지면이 평평하다라는 가정이 깔려있는 방식이고 indoor씬은 oudoor보다 상대적으로 바닥이 평평하기 때문에 해당 방식을 적용하는데에 큰 무리가 없다라고 판단했습니다.
BEV Local Costmap 생성
이렇게 얻은 Depth를 기반으로 BEV Local Costmap을 구축했습니다. 먼저 Depth와 카메라 파라미터를 이용해 이미지 픽셀을 3D 공간으로 복원하고 로봇이 작아서 그냥 그대로 카메라 기준 3D 좌표계로 진행을 했고 이후 지면에서 일정 높이 이상 돌출된 영역을 장애물로 판단해서 BEV Occupancy Map을 구성했습니다.그리고 로봇의 크기와 안전 여유 거리를 고려해 장애물 주변 영역을 추가로 확장하는 방식으로 Costmap을 생성했습니다.
이렇게 만들어진 Local Costmap 위에서 목표 지점까지의 경로를 A* 알고리즘으로 계산하는식의 planning 모듈을 설계 했습니다. 여기서 중요한건 저희는 Odometry가 없기 때문에 A*로 계산한 경로 전체를 정밀하게 추종하는 방식으로 주행하지 않았고 대신 매번 현재 프레임을 기준으로 Local Costmap을 다시 구성하고, 그 안에서 짧은 구간의 경로를 계획한 뒤, 로봇이 이동해야 할 방향을 결정하고 현재 위치와 goal까지의의 방향과 거리에 따라 움직일 시간과 속도를 그때 그때 정하는 방식으로 구현했습니다.(이 부분은 기존 NoMaD를 활용하면서 사용했던 코드의 PD Controller 일부를 참고해 구성했습니다.) 그래서 사실 이 관점에서 Metric scale의 오차가 그리 엄청 중요하지 않을 수 있습니다. 근데 나중에 백그라운드에서 돌릴 safety check 모듈도 넣는데 여기서는 중요하기 때문에 앞선 metric scale 보정을 진행하는 것이 중요합니다.
전체 Navigation 파이프라인
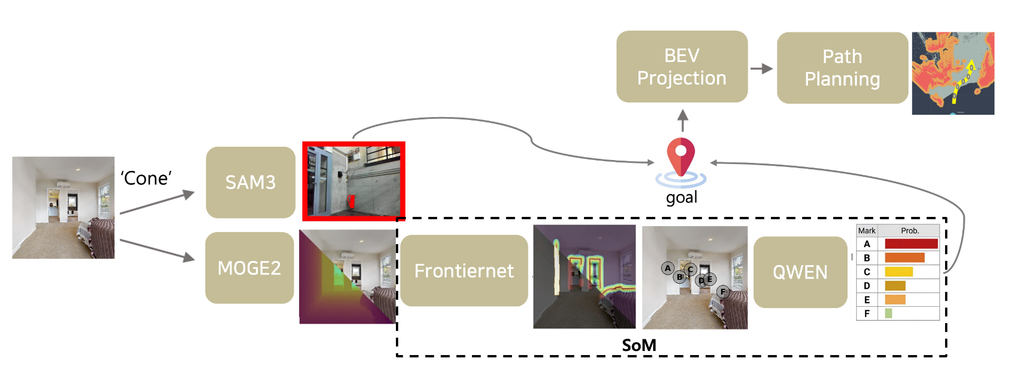
위 그림은 처음에 구성했던 아키텍처입니다. 최종 대회에서는 그림의 점선 박스에 해당하는 FrontierNet + Qwen 부분을 GPT-6 Astra 기반으로 대채한 걸 사용했습니다.
왜 이렇게 변경했는지 설명드리려면 초기 파이프라인에서 어떤 문제가 있었는지를 먼저 말씀드리는 것이 좋을 것 같아서 들고 왔습니다.일단 전체 흐름에서 보면 크게 찾고자하는 object가 보이냐 안보이냐를 기준으로 동작하는 방식이 달라지는 구조라고 보시면 좋을 것 같습니다.
Cone이 보이는 경우: object goal navigation
우선 항상 sam3는 돌아가면서 현재 이미지에서 Cone이 보이는지 안보이는지를 체크합니다. SAM 3에는 cone이라는 텍스트 프롬프트를 사용했고, 해당 객체가 탐지되면 MoGe2의 Depth 정보를 이용해 Cone의 3D 위치를 추정합니다. 이후 앞서 설명드린 방식으로 구축한 BEV Local Costmap 위에 Cone의 목표 위치를 투영하고, A* 알고리즘으로 해당 위치까지의 Local Path를 계산하도록 했습니다. 그리고 local path의 일부 waypoint를 목표점으로 해서 현재 위치와 목표점의 위치까지의 거리와 방향을 고려해서 그에 맞는 선속도 각속도 명령을 뱉도록하였습니다. 그리고 Cone은 색상별로 구분되어 있었기 때문에, 이미 방문한 Cone을 다시 목표로 선택하지 않도록 색상 정보를 이용한 ID 관리도 추가했습니다.
Cone이 보이지 않는 경우: FrontierNet 기반 Exploration
목표 객체가 보이지 않는 상황에서는 어느 방향으로 이동해야 새로운 영역을 탐색할 수 있는지를 판단하는지가 중요한데 이를 위해 활용했던 모델이 FrontierNet입니다. FrontierNet은 RGB 이미지와 이에 대응되는 Depth 정보를 활용해 탐색할 만한 Frontier 후보를 예측하는 모델입니다.여기서 Frontier는 일반적으로 이미 관측한 자유 공간과 아직 탐색하지 않은 공간의 경계를 의미합니다. 큰 의미에서는 affordance 영역이라고 봐도 좋을 것 같습니다.
저희는 FrontierNet이 예측한 후보들을 open frontier라는 방법론을 참고해서 SetOfMark (SoM) 방식으로 시각화하고, 해당 이미지를 Qwen 모델에 판단해서 여러 후보중 가장 적합한 후보를 고르도록 했습니다. 적절한 프롬프트를 통해서 Qwen Cone이 있을 법하거나 다음으로 탐색하면 좋을 영역을 선택하도록 했습니다. 이렇게 선택된 후보 위치는 마찬가지로 다시 MoGe2 Depth를 이용해 Local Costmap에 투영하고, 해당 지점까지 A* 기반 Local Planning을 수행하는 방식이었습니다.
정리하면 초기 파이프라인은 아래처럼
Cone이 보이는 경우: SAM 3 기반 Object Goal Navigation
Cone이 보이지 않는 경우: FrontierNet + Qwen 기반 Exploration
그리고 두 경우 모두 동일한 BEV Local Costmap 및 Local Planning 구조를 사용했습니다. 또 상위 모델이 목표를 선택하는 주기와는 별개로, MoGe2에서 얻은 Depth를 이용해 가까운 장애물을 확인하고 위험한 이동 명령을 제한하는 Safety Check도 추가했습니다. 처음에는 나름 합리적인 구조라고 생각했는데 실제로 테스트해보니 문제가 생각보다 많았습니다.
FrontierNet + Qwen 에서 발생했던 문제
FrontierNet이 예측한 후보가 항상 적절하지는 않는문제
첫 번째 문제는 FrontierNet의 예측 결과입니다. FrontierNet은 탐색할 만한 Frontier 후보를 제안하는 모델이지만, 저희 환경에서는 실제로 이동했을 때 의미 있는 탐색이 이루어질 수 있는 후보와 그렇지 않은 후보가 섞여 나왔습니다.
예를 들어 연구실 436호에서 나가는 길에 스카웃미니 한대가 주차되어있는데 이 스카웃미니의 테두리나 경계영역을 계속 탐색 후보로 예측하는 결과를 보입니다. 뭔가 해당 모델이 주행가능한 영역을 찾는 것아 아니라 단순히 경계를 탐색가능한 영역으로 예측하는 경우가 많았습니다. 물론 해당 모델 자체는 habitat과 같은 시뮬레이션 위에서 가정집데이터로 학습이 이뤄졌기 때문에 문과 같은 테두리 영역을 탐지 하는데 오버피팅이 되어있을 수 있을 것 같습니다. 그래서 암튼 탐색할 만한 일부 영역만 선택되기를 기대했는데 거의 반듯한 테두리처럼 보이는 영역을 예측하는 경우가 꽤 많았습니다. 물론 이때 Qwen이 이미지의 Semantic 정보를 활용해서 여러 후보 중 적절한 위치를 선택해주기 때문에 괜찮은 후보가 섞여있다면 크리티컬하게 문제되지 않았는데, FrontierNet에서 예측한 후보들이 모두 적절하지 않은 상황에서는 아예 이상하게 움직이게 되버립니다.
특정 환경에서는 Frontier 후보가 아예 나오지 않는 문제
두 번째 문제는 반대 상황인데, 예를 들어 로봇이 정면의 벽을 마주하고 있고, 좌우 방향으로는 이동할 수 있는 복도가 있는 상황을 생각해보면 저는 이때 FrontierNet이 좌우 방향으로 이어지는 공간을 탐색 후보로 예측해주기를 기대했습니다. 근데데 실제로는 아무런 유효한 Frontier 후보를 반환하지 않습니다. 이런 상황에서는 Qwen도 애초에 선택할 후보가 없기 때문에 뭘 할수가 없습니다. 그래서 처음에는 이런 상황을 휴리스틱하게 처리하고자 했습니다. 전방에 벽이 있고 Frontier 후보가 없다면 회전하도록 하고, 회전한 이후에도 후보가 없다면 다른 방향을 확인하도록 하는 식으로 이렇게 예외 상황을 하나하나 해결하려고 했는데 하다보니 약간 밑빠진 독에 물 붓는 느낌이었씁니다. 구멍난 밑을 보완하면 다른 밑이 금가고 약간 이런 느낌이었습니다. 물론 이런 방식으로 어느정도 해결할 수 있는 문제도 있었지만 예외 상황을 방어하기 위한 나타날 때마다 조건을 추가하다보면 추가한 조건 때문에 밣생하는 또 다른 예외사항도 생기게되는 문제가 있어서 그냥 이 NYU 데이터 셋을 가지고 이 frontiernet을 파인튜닝을 해볼까 생각도 했는데 데이터 어노테이션부터 학습까지 코스트가 클거 같아서 하지는 않았습니다.
탐색 Memory 문제
사실 앞의 두 문제보다 더 크게 느껴졌던 부분은 메모리 문제였습니다. 현재 파이프라인은 사실상 모델이 직전에 어디를 탐색했는지를 모르고 새롭게 예측을 합니다. 예를 들어 모델이 복도를 따라 이동하면서 주변 영역을 탐색하는 상황이라고 했을 때, 복도 중간에는 옆으로 빠질 수 있는 길이 있는데, 현재 이미지만 보고 판단하는 모델은 해당 길을 이미 지나쳤는지, 혹은 아직 확인하지 않은 공간인지 메모리가 없기 때문에 구분할 수가 없습니다.그러다 보니 로봇이 비슷한 복도 구간을 계속 왔다 갔다 하면서 같은 영역을 반복적으로 탐색하는 문제가 발생했습니다. 새로운 영역을 탐색해야 하는데 이전 행동에 대한 정보가 부족하다 보니 탐색이 특정 구간에 갇혀버리는 것입니다. 이런 문제를 일종의 탐색 루프 혹은 Local Minima 빠지는 문제라고 navigation에서 정의되는것 같습니다.
그래서 이걸 해결해보고자 Qwen에 이전 행동들을 Text History로 누적해서 전달하는 방식도 시도해봤습니다.그런데 생각보다 잘 동작하지 않았습니다. 단순히 이전 행동을 텍스트로 전달한다고 해서, 모델이 현재 이미지와 과거 행동을 항상 일관되게 연결해주는 것은 아닌것 같습니다.
암튼 결과적으로 이 부분도 폐기하였습니다.
GPT-6 Astra 기반 판단
그러던 중 정민님께서 Isaac Sim에서 비슷한 Object Goal Navigation 문제를 풀고 계셨는데 GPT-6 Astra를 활용한 결과를 보여주셨습니다. 그런데 해당 결과가 생각보다 잘 동작했고 앞서 언급했던 메모리 문제 측면에서 ASTRA 모델은 단순히 현재 화면을 보고 어디로 이동할지를 결정하는 것이 아니라, 이전에 어떤 방향을 확인했는지, 어떤 행동을 수행했는지에 대한 정보를 다음 행동에 반영하는 식으로 예측을합니다. 예를 들어 이전에 왼쪽을 확인하지 않았다면, 이후 관측에서 그 사실을 고려해 왼쪽을 추가로 확인하는 식이었습니다.
FrontierNet + Qwen 구조에서 가장 크게 느꼈던 문제가 바로 이러한 탐색 메모리였기 때문에 이방식은 현재 상황에서 적합한 접근이라고 생각했습니다. 그래서 바로 기존 FrontierNet + Qwen 구조를 GPT-6 Astra 기반 에이전트로 대체했습니다.
또 하나 괜찮았던 부분은 Astra의 Pixel Grounding 능력이었습니다. 이미지에서 단순히 왼쪽이나 오른쪽을 선택하는 것이 아니라, 실제로 이동하고 싶은 지점을 이미지상의 픽셀 좌표로 지정하도록 했는데, 저희가 테스트했던 환경에서는 꽤 적절한 위치를 선택하는 모습을 보였습니다. 기존에는 FrontierNet이 후보를 생성하고 Qwen이 후보 중 하나를 선택했다면, 변경한 구조에서는 Astra가 현재 이미지와 탐색 이력을 기반으로 다음에 이동할 픽셀을 직접 선택하도록 했다고 보시면 좋을 것 같습니다.여기서 Astra의 역할은 어디로 이동할지 2D 이미지위서 픽셀 좌표만 output으로 내뱉고, 실제 해당 지점까지 안전하게 이동하는 과정은 기존 BEV Local Planner가 담당하도록 했습니다.
그리고 좀더 디테일한 과정을 설명드리면, Indoor Navigation에서 Astra가 그때 그때 매번 상황에 맡게 이미지 를 받아오는 코드, 픽셀 그라운딩하는 코드를 그때 그때 생성하고 그때 마다 코딩 과정도 매번 달라질 수 있고 이 과정 때문에 추론이 느려질 수 있는데 좀더 indoor navigation에 최적화 할 수 있도록 이에 맞춰 동작할 수 있도록 도구를 설계를 하였고 총 4개 도구(observe, point, turn, stop)를 설계하였습니다.
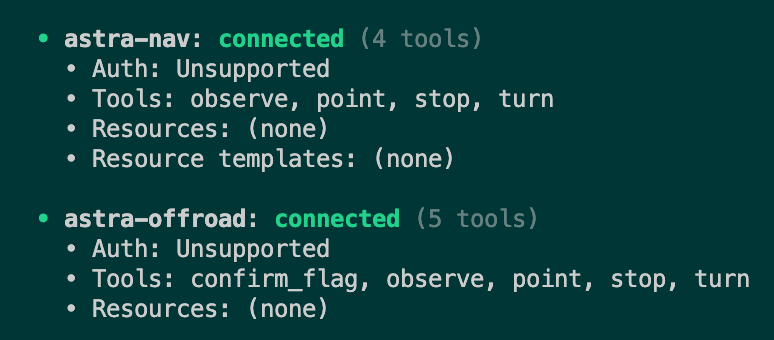
먼저 observe는 현재 카메라 이미지와 로봇의 실행 상태를 반환하는 도구라고 보시면 좋을 것 같습니다. 현재 이미지뿐 아니라 방문한 Cone 목록, 회전이 허용된 상태인지 등의 정보를 함께 확인할 수 있도록 했습니다.
다음으로 point는 실제 이동하고 싶은 이미지상의 픽셀 좌표 (u, v)를 지정하는 도구입니다. Astra가 픽셀 좌표를 선택하면, 실행기(astra 말고 별도의 moge, sam3, planning 모듈)에서는 해당 위치의 Depth와 지면 여부, 주변 장애물 등을 확인하고, 안전하게 이동할 수 있는 지점이라고 판단되면 Local Planning을 수행합니다.
이후 해당 목표를 향해 짧게 이동하고, 실행 결과와 새로운 카메라 관측을 다시 반환하도록 했습니다. point에는 memory_note라는 인자를 통해서 이전에 탐색했던 방향이나 아직 확인하지 않은 공간, 앞으로 확인해야 할 목표 등을 기록할 수 있도록 했습니다.
turn은 제자리 회전을 수행하는 도구인데, 다만 Astra가 아무 상황에서나 회전하도록 허용한 것은 아니고, 너무 벽에 붙어서 땅바닥 지면 인식에 실패하거나 반복적으로 Safety Stop이 발생하는 등 시야를 회복해야 하는 상황에서 회전을 수행하도록 제한했습니다.
마지막으로 stop은 탐색을 종료하는 도구라고 보시면 좋을 것 같습니다.
이런 식의 도구를 설계하면 모델이 전체 코드를 이해하고 구체적인 프롬프트와 매번 해당 작업을 위한 코드 생성 없이 사전에 정의된 도구를 불러오는 식으로 문제를 해결할 수 있게 됩니다.
현재 이미지 관측 -> 이동할 픽셀 선택 -> Local Planner를 이용한 이동 ->실행 결과 확인 -> 다음 행동 결정
이 과정을 반복하면서 필요할 때만 turn을 이용해 시야확보를 하는 방식이고, 또 Cone을 방문했는지 여부는 Astra의 판단에만 맡기지 않고 기존처럼 실제 실행기에서 ID 조건으로 확인하도록 했습니다. 물론 마찬가지로 이 astra개입하는 위 부분은 SAM3가 콘을 찾지 않은 경우에만 사용됩니다. 그리고 Astra가 하나의 행동을 판단하는 데 걸리는 시간은 평균적으로 약 2초 정도 걸렸고 FrontierNet + Qwen 을 Astra 로 대체한 파이프라인을 최종 챌린지에 들고 갔습니다.
실제 Indoor Challenge 결과
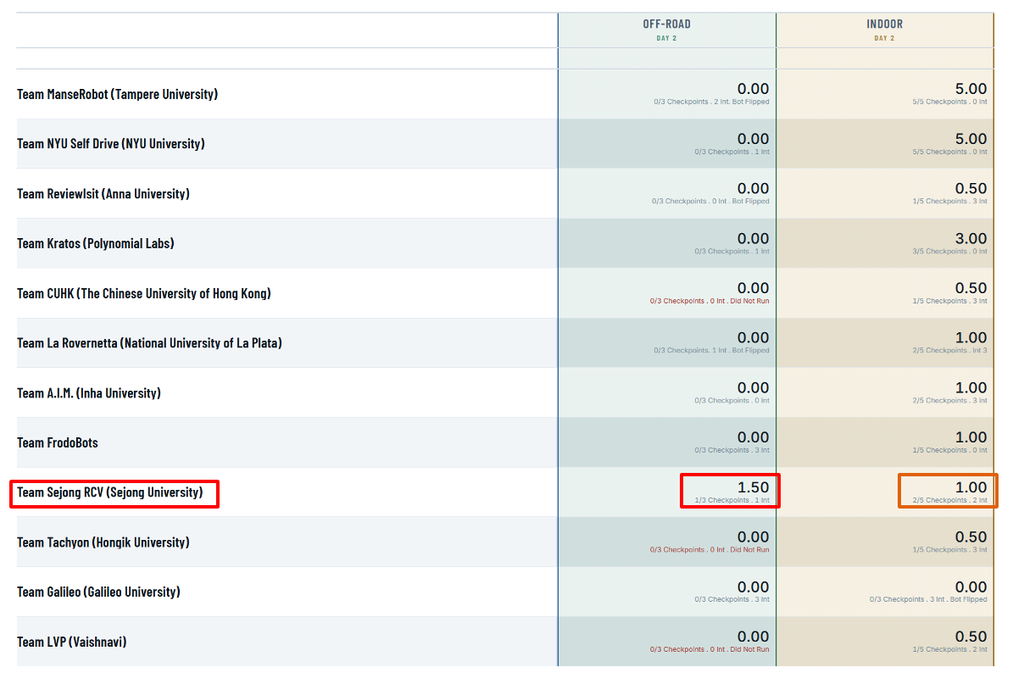
결과부터 말씀드리면, 총 Cone 2개를 찾았고, 개입은 2번 했습니다.
첫 번째 개입은 모델이 새로운 센서 입력을 기다리고 있었지만 데이터가 들어오지 않아 정상적으로 동작하지 못했고, 결국 SDK를 다시 껏다가 실행하는 과정에서 개입이 필요했습니다.
두 번째 개입은 로봇이 모서리 부근을 지나가다가 바퀴가 걸리면서 발생했습니다.당시 로봇이 거의 뒤집힐 뻔한 상황이어서 사람이 직접 개입해야 했습니다. 그래도 뒤집히지는 않고 뒤로 후진하면 바로 앞으로 돌아오는 상황이라 다행이었습니다. 너무 시간내에 찾아야한다는 생각에 공격적으로 디폴트 속도를 올린 문제도 있엇고, safety Check를 구성하긴했지만 해당 모서리가 카메라의 관측 범위에 들어오지 않았던 것 일 수 도 있습니다.
아래는 실제 챌린지 중 Astra가 이전 탐색 이력을 활용하면서 다음 행동을 결정했던 로그입니다.
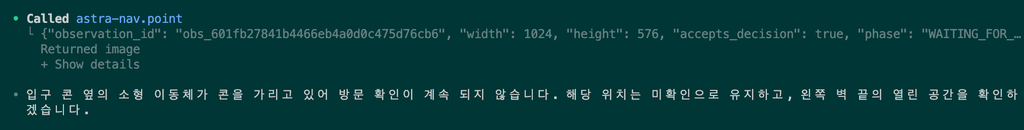
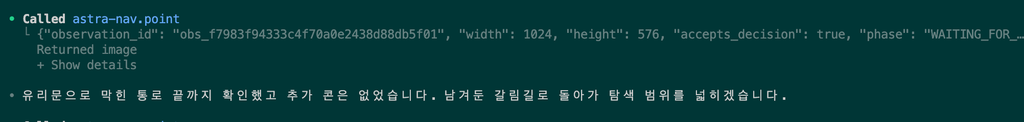
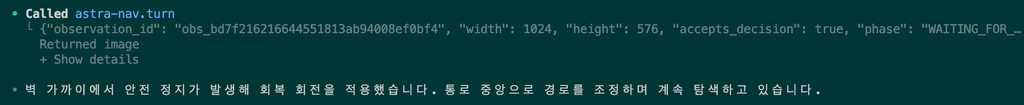
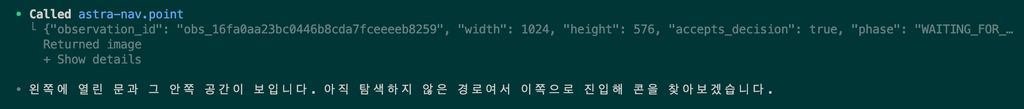
실제로 로그를 보면 단순히 현재 이미지 하나만 보고 행동을 결정하는 것이 아니라, 이전에 어떤 방향을 확인했고 어떤 목표를 탐색했는지를 함께 고려하면서 다음 행동을 선택하는 모습을 확인할 수 있었습니다.
근데 결과적으로 아쉬운 점이 모델 자체가 굳이 안가도 될 영역까지 탐색을 하는 경우도 있어서 여기에 시간을 좀 많이 썼습니다. 그래서 전체 구간에서 반절 정도 탐색했을 때에 시간 오바로 끝났습니다.
Off-road Navigation
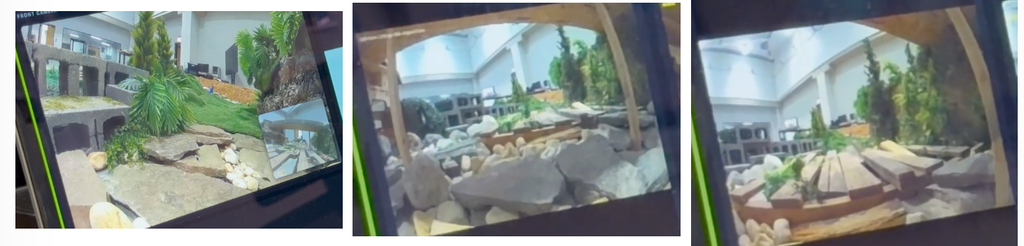
다음은 Off-road Navigation입니다. Off-road에서는 Indoor와 완전히 다른 아키텍처를 사용한 것은 아닙니다.
기본적인 접근은 동일했습니다. 마찬가지로 cone대신 깃발을 찾게 했고 sam3가 깃발을 못찾는 경우에는 Astra가 다음으로 이동할 목표를 결정하고 기존 파이프라인처럼 움직이는 방식입니다.
다만 Off-road에서는 지면 자체가 울퉁불퉁하고, 장애물의 형태나 로봇이 주행할 수 있는 조건이 실내와 크게 다르기 때문에 몇 가지 중요한 부분을 수정했습니다. 특히 크게 바꾼 부분은 지면 판단 방식, Depth Scale 처리, 주행 속도 및 Safety Check입니다.
평평한 지면을 가정할 수 없다는 문제
indoor에서는 지면이 거의 평평하다는 가정이 어느 정도 성립해서 moge2의 depth scale을 보정할 수 있었는데Off-road에서는지면 자체가 오르막이나 내리막일 수도 있고, 자갈이나 돌처럼 불규칙한 구조로 이루어져 있을 수도 있어서 오히려 depth scale이 망가질 수 도 있을 것 같았습니다. 그래서 Off-road에서는 단일 지면 평면을 기준으로 판단하는 방식 대신, 주변 지형의 상대적인 높이 차이를 이용하는 방식으로 변경했습니다. 구체적으로는 각 위치 주변의 약 60cm 범위에서 지형 높이의 기준을 만들고, 해당 기준보다 크게 돌출된 영역을 장애물로 처리하도록 했고 당시 구현에서는 주변 지형보다 약 15cm 이상 높게 나타나는 점이 하나의 Cell에서 3개 이상 확인되면 장애물로 판단하는 방식으로 구성했습니다. 단순히 절대적인 높이가 높은 영역을 전부 장애물로 판단하는 것이 아니라 주변 지형과 비교했을 때 갑자기 높이가 변하는 영역을 장애물로 판단하도록 했습니다. 그리고 Off-road에서는 RANSAC 지면 평면과 카메라 높이를 이용한 추가적인 Metric Scale 보정을 제거하고, MoGe-2가 자체적으로 예측한 거리 스케일을 사용했습니다. 오히려 거리 정확도에 대한 불확실성은 남아 있지만, 신뢰하기 어려운 단일 지면 평면을 이용해 스케일을 강제로 보정했을 때 발생할 수 있는 문제를 피하고자 한 설계였습니다.
Astra에 RGB와 Depth를 함께 제공
다음으로 변경했던 부분은 Astra에 제공하는 입력 정보인데, Indoor에서는 Astra가 주로 RGB 이미지와 탐색 상태를 이용해 이동할 목표 픽셀을 선택하고, Depth는 실행기 내부에서 Local Planning과 Safety Check에 사용했습니다. 반면 Off-road에서는 Astra가 RGB 이미지와 이에 대응되는 Depth 시각화 결과를 함께 확인할 수 있도록 했습니다. 그래서 Astra가 단순히 이미지의 Semantic 정보뿐 아니라 depth map을 통한 주변 지형의 대략적인 거리 구조까지 함께 고려해서 목표를 선택할 수 있도록 구성했습니다.
주행 속도와 Safety Check도 더 보수적으로 변경
Off-road에서는 로봇이 지나치게 빠르게 움직이거나 급격하게 회전할 경우, 바퀴가 미끄러지거나 차체가 뒤집힐 가능성이 높았습니다. 그래서 Indoor보다 전반적인 이동 명령을 보수적으로 설정했습니다. Indoor에서 사용했던 탐색 선속도 명령 범위가 0.15~0.40이었다면, Off-road에서는 이를 0.08~0.15 수준으로 낮췄습니다. 또한 Safety Check에서 사용하는 경로 주변 검사 반폭도 0.10m에서 0.15m로 넓혔습니다.
실제 Off-road Challenge 결과
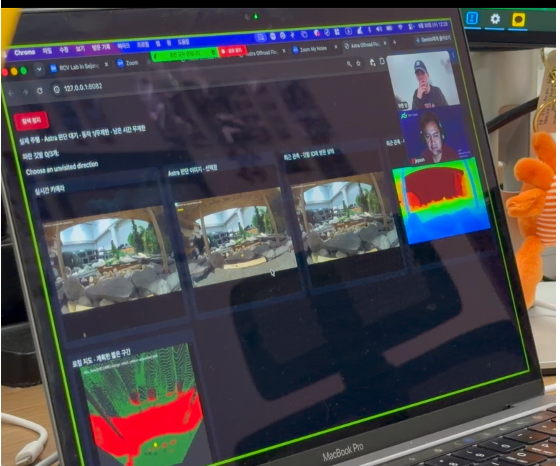
사실 Off-road는 크게 힘써서 준비하지는 않았습니다. 왜냐면 검증할 수 있는 환경이 없었고 너무 환경 자체도 특수하고 난이도도 어렵기도 해서 굳이 뭔가 시간 투자대비 좋은 결과를 얻을 수 있을 거 같지 않았습니다. 그래서 현실적으로는 Indoor에서 기본적인 Navigation 구조가 잘 동작한다는 것을 확인한 뒤, Off-road의 특성을 반영한 부분만 수정해서 바로 챌린지에 적용하게 되었습니다.
결과적으로는 총 3개의 깃발 중 1개를 찾았고, 사람의 개입은 1번 있었습니다.
개입이 발생했던 이유는 중간에 로봇의 일부가 돌 위에 걸리면서 차체가 살짝 들린 상태가 되었는데, 당시 설정해둔 낮은 주행 명령으로는 해당 돌을 벗어나기 어려운 상황이었습니다. 그래서 개입해서 일시적으로 주행 명령을 높여 해당 구간을 벗어나게 했고, 이후 다시 자율주행을 진행했습니다. 그렇게 주행을 이어간 끝에 깃발 하나를 찾는 데 성공했습니다.
근데 뭔가 이 환경에서 나머지 남은 깃발 두 개를 추가로 찾을 수 있을까 싶기도 하고 게다가 무리하게 탐색을 계속하다가 로봇이 뒤집히거나 추가 개입이 발생하면 오히려 점수가 깎일 가능성도 생각해서 고민 끝에 일단 깃발 하나를 찾은 상태에서 탐색을 종료하기로 했습니다.
근데 운이 좋게도 깃발을 하나라도 찾은 팀이 저희 밖에 없어서 저희팀이 off road 부문에서 수상을 할 수 있었습니다. 우하하
대회를 마치면서 느낀 점
이번 챌린지를 준비하면서 개인적으로 가장 크게 느꼈던 것은 문제를 바라보는 시야가 좀 넓어질 수 있는 계기가 되지 않았나 싶었습니다. 사실 저는 기존에 E2E 기반의 방법론을 중심으로 공부했는데 그러다 보니 새로운 내비게이션 문제를 마주했을 때에도 자연스럽게 기존에 알고 있던 E2E 방법론이나 비슷한 계열의 논문을 먼저 떠올리게 되었고 생각의 사고가 그 방식에 머무르는 느낌이었습니다. 그런데 이번 대회에서는 그런 방식만으로 문제를 해결하기 어려웠습니다. 지금까지 익숙했던 방법론에서 벗어나 다른 방식으로도 문제를 해결할 수 있다는 것을 경험했다는 점에서 개인적으로 의미가 컸다고 생각하고 예전에 진행했던 우편 배달 프로젝트를 다시 하게 된다면 그때보다 훨씬 다양한 접근을 시도할 수 있겠다는 생각이 듭니다.
한편으로는 대회 자체에 대한 아쉬움도 있었습니다. 이번 챌린지는 일반적이지 않은 저가형의 소형 로봇을 사용했고 이에 맞는 학습 데이터도 그렇고 신뢰할 수 있는 센서 정보도 제한적이었습니다. 그러다 보니 일반화 가능한 새로운 내비게이션 알고리즘을 개발하기보다는 주어진 로봇과 환경에서 어떻게든 미션을 수행할 수 있도록 세부적인 부분을 조정하는 엔지니어링에 많은 시간을 사용하게 되었던 것 같고 물론 실제 로봇을 다루는 연구에서도 이러한 과정은 중요하다고 생각합니다. 근데 대회에서 좋은 성능을 보이는 방식이 반드시 다른 로봇이나 환경에서도 잘 동작하는 일반적인 내비게이션 방법론이라고 보기는 어렵기 때문에 이 부분은 조금 아쉽게 느껴졌습니다. 또 대회 운영 과정에서 일부 평가 기준이나 점수 처리 방식이 명확하지 않게 느껴지는 상황도 있었고, 중간에 평가자분들끼리도 기준이 달라서 점수가 이랬다 저랬다 하는 상황도 있었습니다.
그래도 챌린지를 준비하는 과정에서 이론적으로는 잘 동작할 것 같았던 방법이 실제로는 전혀 동작하지 않기도 하고, 반대로 처음에는 단순하다고 생각했던 접근이 오히려 더 효과적으로 동작하는 모습도 보였던걸 경험할 수 있었고 단기간에 다양한 방법론들을 로봇에 deploy해서 운영해보는 것도 많은 경험이 되었던 것 같습니다. 물론 urban, Indoor와 Off-road 모두 목표를 전부 달성했다면 더 좋았겠지만, 그래도 대회를 준비하면서 시도했던 여러 방법과 그 과정에서 얻은 경험들이 앞으로 연구를 진행하는 데 많은 도움이 되었으면 좋겠습니다.
마지막으로 indoor, offroad 챌린지 할 때가 새벽이었는데 정우님이 옆에서 자리 지켜주시면서 통역도와주셔서 감사합니다 하하 정우님 없었으면 아마 의사소통하는 과정에서부터 막혀서 모델을 제대로 돌리지도 못했을 것 같습니다.
실제로 주행하면서 observation과 그에 대응하는 occupancy map이랑, 모델이 예측하는 affordance 영역, 시각화 그림이 있으면 좋았을텐데 제가 어디에 저장했는지 찾지를 못해서 나중에 찾으면 업로드 하겠습니다. IROS 2026 Earth Rover Challenge 후기를 마치도록 하겠습니다. 감사합니다.