오늘 소개드릴 논문은 multi agent debate(MAD) 시스템의 정확한 평가를 위한 벤치마크인 M3MAD-Bench에 대해 다루고 있습니다. 이는 기존의 MAD 연구는 평가가 텍스트 전용 시나리에 국한되어있는 등 충분히 탐구되지 않았다는 점을 지적하면서, 문제를 해결하기 위해 다중 도메인, 멀티모달 입력 등 MAD 시스템을 정확히 분석하기 위한 확장된 벤치마크를 제안합니다. 해당 벤치마크를 활용하여 논문은 특정 시나리오에서 효과적이였던 MAD가 통합적인 세팅에서 언제나 효과적이지는 않으며 연산 효율성을 고려했을때 오히려 비효율의 결과를 보이기도 함을 보였습니다. 정리하면, 본 연구는 MAD 시스템의 표준화된 평가를 위한 리소스를 마련하기 위해 도메인과 테스크를 확장한 벤치마크를 제시하였습니다. 해당 벤치마크를 통해 대표적인 MAD 전략에 대해 분석하여 실질적인 인사이트를 제공하였고, MAD 연구의 신뢰할 수 있는 기반을 마련하였습니다.
[Background]
먼저, 연구의 시작점을 알기위해 기존 MAD 연구의 평가방식에 한계를 알아보겠습니다. 이전 연구는 데이터셋이 통일되지 않았거나, multi agent 시스템의 구성이 하나의 모델(homogeneous), 이종 모델(heterogeneous)인지에 대한 고려가 없기도 했습니다. 이처럼 표준화되지 않은 평가 환경에서 분석이 진행되었습니다. 특히 표준화되지는 않았지만 보통의 연구에서 평가는 수학연산/논리와 같이 단일 모달인 텍스트 전용 데이터셋에서 이루어졌다는 한계도 있었습니다. 이러한 평가의 맹점을 개선하기 위해 본 연구는 확장된 벤치마크를 제시합니다. 지식/수학/의학/자연과학/복합 추론이라는 멀티 도메인을 커버할 뿐만 아니라 7개의 텍스트 전용 및 6개의 멀티모달 데이터셋으로 구성되어 MAD 시스템의 일반화 성능을 평가할 수 있으며, 정확로를 넘어 토큰 소비량 및 추론 시간과 같은 지표를 통한 평가를 통해 성능과 비용관의 trade-off 관계를 고려한 실용적인 인사이트를 제시합니다.
[Summary]
본 연구는 MAD의 파편화된 평가를 통합하는 벤치마크를 제시하여 해당 시스템의 평가의 기틀을 마련하고자 했습니다. 특히 기존 연구는 멀티모달 시나리오에서 MAD의 효과에 대해 제한적으로 탐구하였는데, 이러한 한계를 개선하기 위해 멀티도메인, 멀티모달 입력, 다차원적 지표로 확장한 벤치마크인 M3MAD-Bench를 제시합니다. 또한 체계적 실험을 통해 MAD 시스템에 대한 9가지 통찰을 정리하였습니다. 특히 모든 환경에서 MAD가 언제나 효과적이지는 않으며, 에이전트의 stubbornness(고집), MAD의 높은 토큰 비용, 상호 오류를 고집하는 경향과 같은 문제가 발생할 수 있음을 확인하였습니다.
[M3MAD-Bench]
M3MAD-Bench는 어떻게 확장했을까요? 본 연구에서는 프로토콜, 데이터셋, 평가지표을 모두 확장했습니다. 가장 먼저 프로토콜의 관점에서 특정 MAD 방식이 아닌 3종류의 시스템을 다양하게 평가하였으며 반복적인 토론을 기반으로 표준적으로 합의를 하는 LLM Debate 방식, 독특한 추론을 통해 사고의 다양성을 키운 후 중복성을 이용해 합의하는 DMAD, 반대하는 페르소나를 이용하는 적대적 토론 방식 Div-MAD를 단일 모델 추론 기반의 Chain-of-thought(cot), Self-consistency(SC, 독립 추론 5회 후 다수결), Input-output prompting(IO, 단일 모델의 직접 응답, 가장 기본)와 갘은 바업론과 함께 비교하여 MAD와 일반 단일 모델의 추론의 이점을 분리하여 리포팅하였습니다.
둘째로 도메인을 확장하기 위해 지식(MMLU, MMLU-Pro), 수학(MATH, GSM-Hard), 의학(MedMCQA, Med), 자연과학(GPQA), 멀티모달 지식(MME), 멀티모달 수학(MathVista, MathVision), 멀티모달 의학(PathVQA), 멀티모달 추론(MME-Reasoning, VisualPuzzles)과 같이 다양한 데이터셋에 대하 평가를 수행했습니다.
마지막으로 평가지표에 대해서는 성능 뿐만 아니라, 토큰 소비량과 추론 시간도 추적하여 평가했습니다. 성능 향상이 세분화된 비용까지 고려했을때 정당한지(충분히 효율적인지) 분석하여 MAD의 실용성 또한 평가하였습니다.
이렇게 확장된 벤치마크를 통해 논문은 MAD에 대한 일반화된 분석을 수행하였으며, 9가지 인사이트로 결과를 정리하였습니다.
[Main results]
※insight 1: MAD는 항상 성능을 개선하지는 않는다
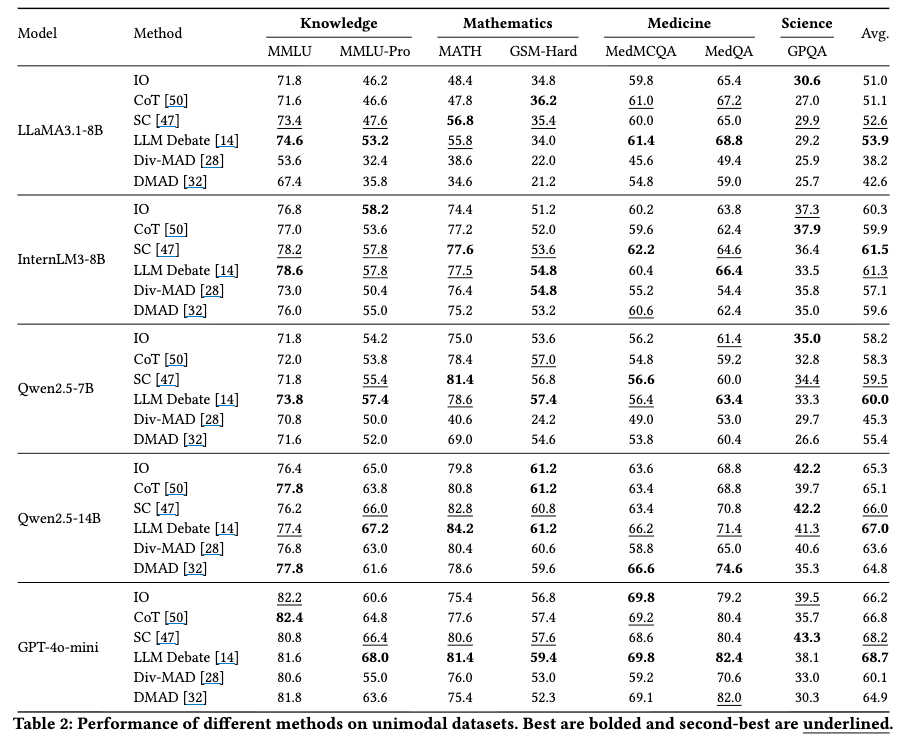
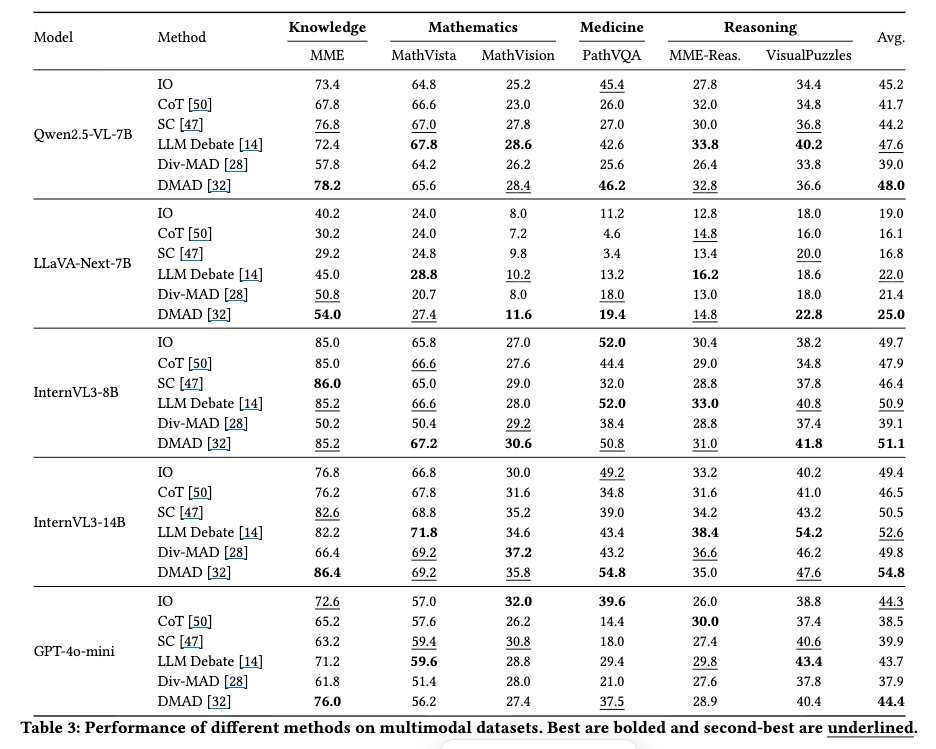
저자들은 반대역할의 페르소나를 도입하지 않는 협력적 토론 방식인 LLM Debate, DMAD, 적대적 토론 방식인 Div-MAD를 비교하였습니다. 텍스토 도메인(table2)에서 뿐 만 아니라 멀티모달 도메인(table3)에 대해 분석을 수행하였으며 LLM Debate의 경우 안정적으로 단일 에이전트 베이스라인(IO, CoT) 대비 성능을 향상시켰으나, 그 외의 MAD 알고리즘은 그렇지 못했음을 확인할 수 있습니다. 특히 LLaMA3.1-8B와 같은 약한 베이스라인 모델에서 Div-MAD, DMAD의 경우 특히 잘 동작하지 않았습니다.
Table 2,3에서 확인할 수 있듯이 에이전트가 서로 다른 에이전트의 답변을 참고하고 토론으로 합의를 도출하는 협력형 토론 방식(DMAD, LLM Debate)의 경우가 서로 반대되는 페르소나를 도입해 추론을 반박하는 대립형 토론 방식(Div-MAD)에 비해 일률적으로 성능이 우수했습니다. 저자들은 이러한 현상에 대해서 대립형 토론이 불필요한 노이즈를 발생시켜, 약한 모델에서는 해당 노이즈가 추론을 오히려 왜곡하고 있다고 설명하였습니다.
※ insight 3: MAD는 지식 관련 도메인보다 추론 관련 도메인에 도입되었을 때 효과적이다
Table2,3에서 위와같은 현상도 발견하였다고 합니다. 예를들어 Qwen2.5-14B에서 LLM Devate는 추론이 필요한 수학 벤치마크인 MATH에서는 4.4의 성능 개선이 있었지만 단순 지식을 묻는 벤치마크인 MMLU에서는 1.0정도의 개선만 있었습니다. 이를통해 MAD가 효과적으로 동작하는 상황에서 지식 관련 도메인보다는 추론 관련 도메인에서 성능 개선을 이룸을 확인했습니다. 이러한 현상은 InternVL3-14B의 LLM Debate 결과에서 VisualPuzzles이 높은 성능 개선을 보였다는 것에서도 확인할 수 있습니다.
※ insight 4: 다양한 추론 전략을 통한 MAD 구성(DMAD)는 멀티모달에서 더 효과적이다
단일모달 작업은 비교적 단순한 작업으로 multi turn 반복으로 구성된 가장 기본적인 형태인 LLM debate면 충분했습니다. 추론 전략을 다양화하는 DMAD 까지 필요하지 않았던 것입니다. insight 3과 마찬가지로 DMAD의 추론전략이 제시하는 다양한 관점이 풍부화를 넘어서서 노이즈가 될 수 있기 때문입니다.
※insight 5: Best model이 MAD의 효과를 좌우한다
Table2, 3의 실험 결과 더 강력한 모델일수록 더 나은 MAD 성능을 이끌어냈습니다. 특히 협력적 토론 방식(DMAD, LLM Debate)에서 이를 관찰할 수 있으며, 적대적 토론방식에서도 기반 모델이 약할때는 IO(기본 추론) 대비 MAD 성능이 크게 낮았으나, 강력한 모델에서는 그렇지 않았음을 확인할 수 있습니다.
※insight 6: MAD의 계산 비용은 크지만 정확도의 개선은 제한적이다
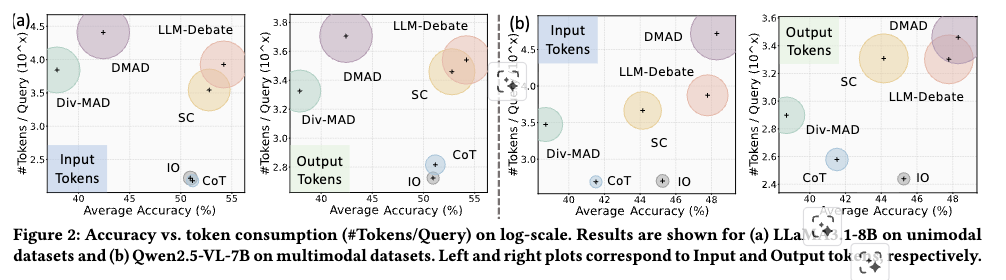
figure2는 (a)LLaMA3.1-8B와 (b)Qwen2.5-VL-7B에 대해 단일 모델과 멀티모델간의 토큰 사용량과 정확도를 보여줍니다. input token은 초기입력과 이전토큰을 읽는 비용, output token은 에이전트가 새로운 응답을 생성하는 비용에 해당합니다. MAD의 라운드가 진행될수록 history가 쌓이기 때문에 input token은 증가하며, 여러 에이전트가 응답하기 때문에 점점 증가합니다. figure2에서는 MAD는 3개 이하의 에이전트가 2~3회정도의 라운드를 거친 후, 그 평균을 리포팅한 것이나, 멀티 에이전트 시스템이 더욱 커질경우 비효율의 격차는 더욱 커질 수 있습니다. 현재의 결과에서 역시 토큰수의 증가에 비하여 IO/CoT 보다 성능 개선이 드라마틱하지는 않음을 확인할 수 있습니다.
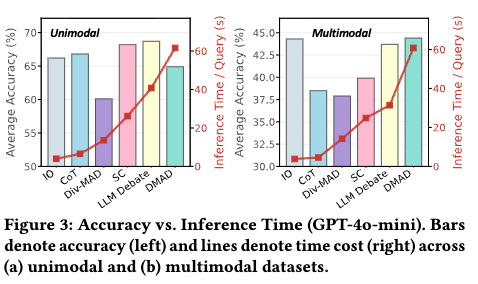
유사한 의미로 Figure 3을 통해 unimodal, multimodal 모두에서 정확도는 Io/Cot/SC 등의 방법론과 비등비등한 반면, inference time(붉은색)은 기하급수적으로 증가하고 있음을 확인할 수 있습니다.
※insight 7: 서로 다른 모델을 결합한다고 반드시 성능이 향상되지는 않는다
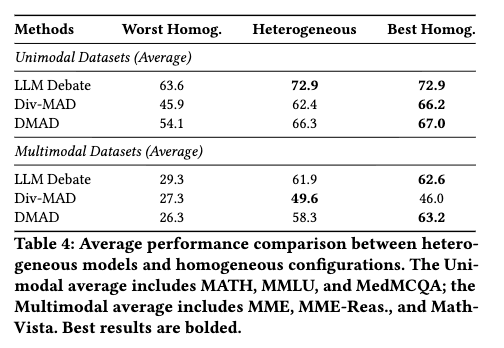
앞서서 다수의 기존 MAD의 경우, 본 연구의 table2, 3과 같이 동일한 모델로 구성된 에이전트 군집에 대해 분석되었습니다. 본 연구에서는 이러한 평가방식의 한계를 극복하기 위해 이종 모델 세팅에 대해서도 집중하였으며 table2,3에 사용된 모델 풀을 사용하여 MAD를 구축해 평가하였습니다. 그 결과 이종의 모델을 사용한 heterogenous 성능이 항상 동일한 모델 3개로 토론하는 homogenous 세팅보다 항상 좋지는 않았으며 오히려 모든 에이전트가 동일한 모델을 사요할 때 달성한 최악과 최고의 성능의 중간에 보통 위치하였음을 통해 이질적 모델의 도입이 성능을 크게 변화시키지는 않았음을 확인할 수 있습니다.
※ insight 8: 토론 라운드 증가보다 에이전트 수 증가가 더 효과적인 경향을 보인다
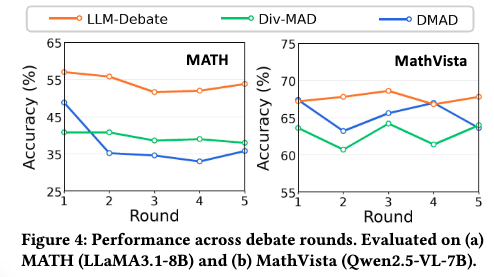
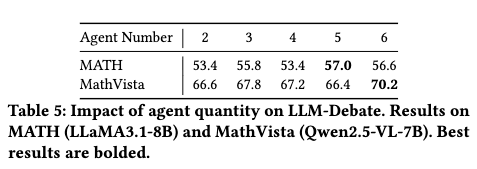
figure4에서 볼 수 있듯이 MAD에서 round 증가에 따러 성능이 지속적으로 개선되기보다는 정체되는 경향이 있습니다. 즉, 신뢰할 수 있는 추가 정보가 제공되지 않는 한 단순히 에이전트간의 상호작용(토론)으로는 성능 개선을 기대할 수 없음을 의미합니다. 한편 Table5에서는 에이전트를 추가함에 따라 성능이 지속적으로 개선되는 추세를 보임을 확인할 수 있으므로 라운드 수의 증가보다는 에이전트 수를 증가하는것이 효율적임을 해당 논문에서는 주장하고 있습니다. (하지만 앞서 세미나에서 다루었던 논문과 같이 에이전트의 수를 증가시키는것과 엄격한 verfier를 추가하는것에 효율성 측면에 특이점이 있었던것처럼 에이전트의 추가가 언제나 MAD 시스템을 개선하는 안정적인 해결책임은 아닙니다)
※ insight 9: 에이전트들은 오류를 수정하기보다 강화하기도 하며, 정답이 이미 등장했어도 최종 선택에 실패한다
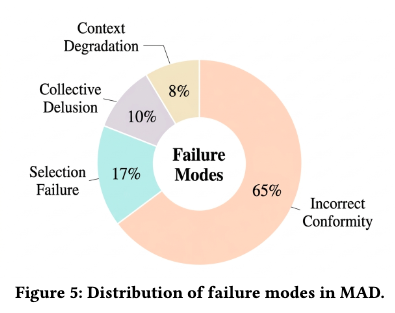
마지막으로 논문은 MAD에서 에이전트들이 서로 오류를 강화하는 현상을 확인했다고 합니다. 논문에서는 Figure 5와 같이 MAD가 정답 추론에 실패하는 경우를 5가지로 분류했음, 잘못된 동조(incorrect conformity-정답을 맞춘 에이전트가 동료 압박으로 인해 답변을 포기하는 경우)가 가장 많았다고 합니다. (그 외, collective delusion-에이전트들이 잘못된 가정을 강화해 환각루프를 형성, context degradation-라운드 진행될수록 토론의 질 저하, selection failure-토론 중 답변이 제시되나 메커니즘에서 누락)
[Sum up]
insight 1: MAD는 항상 성능을 개선하지는 않는다 insight 2: 합의적 토론 세팅인 LLM debate와 DMAD가 적대적 토론보다 일반적으로 우수하다 insight 3: MAD는 지식 관련 도메인보다 추론 관련 도메인에 도입되었을 때 효과적이다 insight 4: 다양한 추론 전략을 통한 MAD 구성(DMAD)는 멀티모달에서 더 효과적이다 insight 5: Best model이 MAD의 효과를 좌우한다 insight 6: MAD의 계산 비용은 크지만 정확도으 개선은 제한적이다 insight 7: 서로 다른 모델을 결합한다고 반드시 성능이 향상되지는 않는다 insight 8: 토론 라운드 증가보다 에이전트 수 증가가 더 효과적인 경향을 보인다 insight 9: 에이전트들은 오류를 수정하기보다 강화하기도 하며, 정답이 이미 등장했어도 최종 선택에 실패한다
본 논문은 MAD 연구의 발전에 필요한 편향되지 않은 평가 시스템을 제시하였으며, 특히 기존의 MAD 연구가 언제나 효과적이지 않음을 확인하며, 확장된 벤치마크를 고려한 일반화된 MAD 시스템을 구축해야함을 확인할 수 있었습니다. 실험의 디테일이 일부 아쉬웠지만 다양한 테스크, 도메인에서 MAD의 효과를 확인할 수 있었다는 점에서 재미있는 논문이였습니다.
2 thoughts on “[ACM MM2026] M3MAD-Bench: Multi-Dimensional Evaluation ofMulti-Agent Debate Across Domains and Modalities”
리뷰 잘읽었습니다! 한 가지 궁금한 점이 있는데요, 멀티모달 MAD에서는 여러 에이전트가 토론할 때 각자 원본 이미지에 계속 접근하는지, 아니면 이전 에이전트들이 생성한 텍스트 추론을 주로 참고하는지 궁금하네요! 후자라면 초기 visual perception error가 토론을 거치면서 더욱 강화될 가능성도 있을 것 같아서요!

리뷰 잘읽었습니다! 한 가지 궁금한 점이 있는데요, 멀티모달 MAD에서는 여러 에이전트가 토론할 때 각자 원본 이미지에 계속 접근하는지, 아니면 이전 에이전트들이 생성한 텍스트 추론을 주로 참고하는지 궁금하네요! 후자라면 초기 visual perception error가 토론을 거치면서 더욱 강화될 가능성도 있을 것 같아서요!
좋은 질문 감사합니다!
말씀하신것처럼 agent가 원본 이미지 접속 가능한지 여부에 따라 MAD에서 발생할 수 있는 오류누적 정도가 달라집니다. 우선 본 논문에는 구현 디테일이 나와있지는 않으나, LLM_debate 에 관한 공개된 구현(https://github.com/liaolea/M3MAD-Bench/blob/2fda5090870f52893838d880a0f85b2d15cf6599/methods/llm_debate/llm_debate_main.py#L144)으로 보아 원문에 접근하고 있는것 같기는 합니다.
하지만 텍스트 추론을 참고한다면 error 누적이 더욱 강화되겠네요!