안녕하세요. 이번에는 EventVAD: Training-Free Event-Aware Video Anomaly Detection 논문을 읽어보았습니다. 비디오에서 이상 상황을 찾아내는 Video Anomaly Detection(VAD)을 추가 학습 없이 풀어보려는 논문입니다. 그럼 시작하겠습니다.
1. Introduction
VAD는 비디오에 이상 상황이 있는지를 판단하고, 그 상황이 어느 시간 구간에서 발생했는지를 찾는 문제입니다. 예를 들어 CCTV 영상에서 범죄가 발생했다면, 영상 전체에 이상이라는 라벨을 붙이는 것뿐 아니라 실제 사건이 벌어진 프레임들을 찾아야 하는 것이죠.
기존 학습 기반 방법들은 특정 데이터셋에서 좋은 성능을 보여주지만, 새로운 환경이나 처음 보는 이상 상황으로 넘어갔을 때도 잘 동작하지 못했다고 합니다. 새로운 환경에 맞춰 다시 학습하려면 추가적인 데이터와 비용이 필요했고요. 그래서 사전학습된 모델이 가진 지식을 그대로 활용하는 training-free 방법들이 등장했습니다.
본 논문이 주로 비교하는 방법은 training free 방법론인 LAVAD인데요. 프레임에서 캡션을 만들고, 그 텍스트를 바탕으로 언어 모델이 상황을 해석하고 이상 점수를 매기는 방식입니다. 해당 방법론에서 저자들이 지적하는 부분은 이런 접근이 프레임 사이의 변화와 사건의 흐름을 충분히 담아내기 어렵다는 점입니다. 여러 단계의 캡션 생성과 추론을 거치면서 처리 비용도 커지고요.
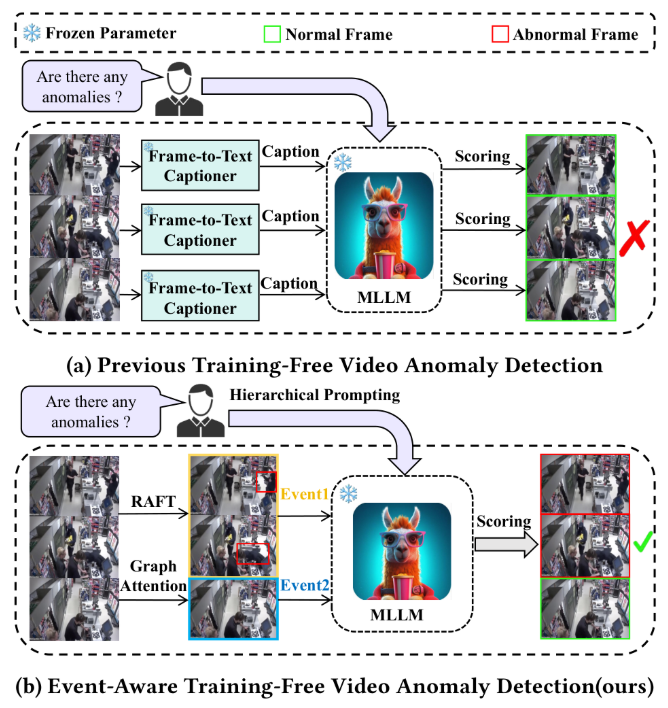
Figure 1이 기존 방식과 EventVAD의 차이를 보여줍니다. 기존 방식이 프레임을 텍스트로 바꿔 판단하는 데 초점이 있다면, EventVAD는 먼저 프레임 사이의 관계를 분석해 사건을 나눈 뒤 MLLM에 넣습니다.
예를 들어 계산대 앞에 사람이 서 있는 한 장면만으로는 물건을 사는 것인지, 직원을 위협하는 것인지 구분하기 어려울 수 있습니다. 앞뒤 행동을 함께 봐야 하는 것이죠. 그렇다고 긴 영상을 통째로 보여주면 중요한 장면이 다른 프레임들 사이에 묻힐 수 있습니다. 저자들은 이 사이에서 하나의 사건으로 이어지는 구간을 판단 단위로 쓰자고 제안합니다.
Contribution을 정리하면 다음과 같습니다.
- 긴 비디오를 사건 단위로 나누고 각 사건의 이상 정도를 판단하는 training-free 프레임워크 EventVAD를 제안함.
- CLIP의 의미 feature와 RAFT의 optical flow를 결합하고, temporal decay를 반영한 그래프와 graph attention으로 사건 경계 탐지를 지원.
- UCF-Crime과 XD-Violence에서 논문이 비교한 training-free 방법들보다 SOTA를 달성하고, 모듈별 ablation으로 각 구성 요소의 효과를 확인.
2. Method
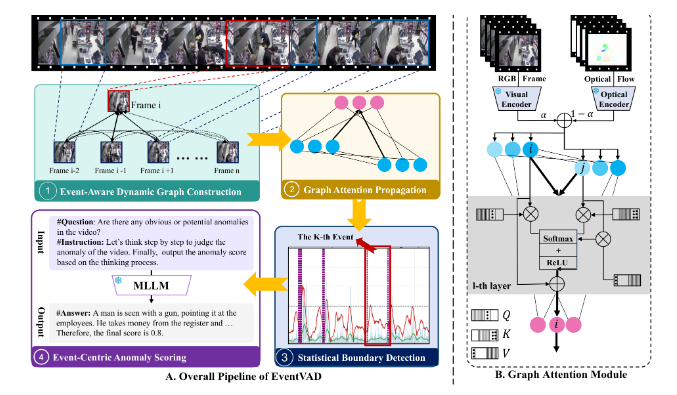
Figure 2가 전체 파이프라인입니다. 크게 네 단계인데요. 프레임들을 노드로 하는 그래프를 만들고, graph attention으로 feature를 갱신한 뒤, 프레임 사이의 변화가 큰 지점을 찾아 사건을 나눕니다. 마지막으로 나누어진 사건을 MLLM에 보여주고 이상 점수를 받습니다.
여기서 미리 구분해두면 좋은 있는데요. 앞의 그래프와 경계 탐지 모듈은 어디에서 사건을 나눌지를 정하고, 마지막 MLLM은 그 사건이 이상한지를 판단합니다. 다만, 변화가 큰 장면이라고 바로 이상으로 판정하는 것은 아닙니다. 장면이 바뀌거나 사람이 움직이는 정상적인 상황에서도 경계는 생길 수 있으니까요.
2.1 Event-Aware Dynamic Graph Construction
첫 단계는 프레임마다 두 종류의 정보를 뽑는 것입니다. 하나는 CLIP이 추출한 의미 정보이고, 다른 하나는 RAFT optical flow로 얻은 움직임 정보입니다.
CLIP feature는 L2 정규화한 512차원 벡터를 사용하고, optical flow 쪽은 projector를 거쳐 128차원 feature로 만듭니다. 이를 결합한 노드 feature는 다음과 같습니다.
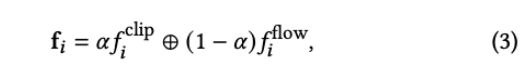
여기서 $\alpha$는 의미 정보와 움직임 정보의 비중을 조절하는데, 실험에서는 0.75를 사용했다고 합니다.
그다음은 어떤 프레임끼리 연결할 것인지입니다. 의미가 비슷하거나 움직임이 비슷한 프레임 사이에 높은 가중치를 주되, 시간적으로 멀리 떨어져 있으면 연결을 약하게 만듭니다.
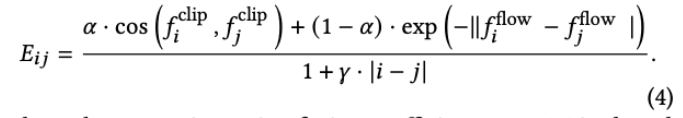
$\gamma$는 시간 temporal decay의 강도이고, 기본값은 0.6입니다. 두 프레임의 간격 $|i-j|$가 커질수록 연결 가중치가 줄어드는 구조입니다.
2.2 Graph Attention Networks Propagation
두 번째는 그래프에서 연결된 프레임들의 정보를 모아 각 노드 feature를 갱신하는 단계입니다. 논문에서는 이를 Graph Attention Networks Propagation, 줄여서 GANP라고 부릅니다.
일반적인 attention과 달리, 여기서는 orthogonal feature projection에 기반한 training-free attention mechanism을 사용합니다. 식 (5)처럼 표준정규분포에서 생성한 행렬에 QR decomposition을 적용해 고정된 투영 행렬 Q,K,V를 구성하는데요. 각 행렬의 열벡터는 orthonormal하며, Q와 K의 projected dimension은 64입니다
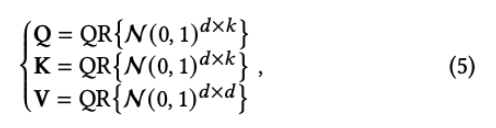
이후 query와 key로 attention을 계산하고, 그래프의 연결 관계를 반영해 이웃 프레임의 value를 모읍니다. 모은 정보는 원래 feature에 더하고, 전체 노드 feature의 평균을 빼는 centering을 수행합니다.
2.3 Statistical Boundary Detection
이제 갱신된 feature를 가지고 사건 경계를 찾습니다. 먼저 인접한 두 프레임 사이의 차이를 계산합니다.
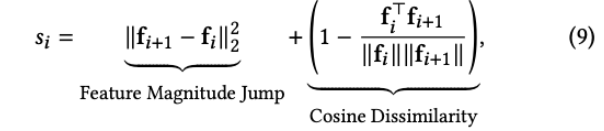
첫 번째 항은 feature 사이의 거리를, 두 번째 항은 방향의 차이를 봅니다. 두 프레임의 표현이 크게 달라지는 지점을 경계 후보로 삼는 것이죠.
그런데 이 값을 그대로 쓰면 작은 움직임이나 카메라 흔들림까지 경계로 잡을 수 있습니다. 그래서 Savitzky–Golay filter로 신호를 스무딩합니다.
이후에 주변 구간의 이동평균 $\mu_i$에 대한 비율을 계산합니다.
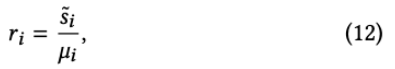
이렇게 하면 단순히 변화량이 큰지를 보는 것이 아니라, 주변에서 평소 발생하는 변화에 비해 지금의 변화가 얼마나 큰지를 보게 됩니다. 원래 움직임이 많은 영상과 거의 정적인 영상에 같은 절댓값 기준을 적용하는 문제를 줄이려는 설계로 이해할 수 있습니다.
마지막으로 중앙값과 MAD(median absolute deviation)를 이용해 적응형 임계값을 정합니다.
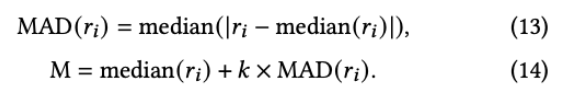
$r_i$가 M보다 큰 지점을 경계로 보고, 가까이 몰린 경계 후보들은 병합해서 지나치게 잘게 나누어지는 것을 막습니다.
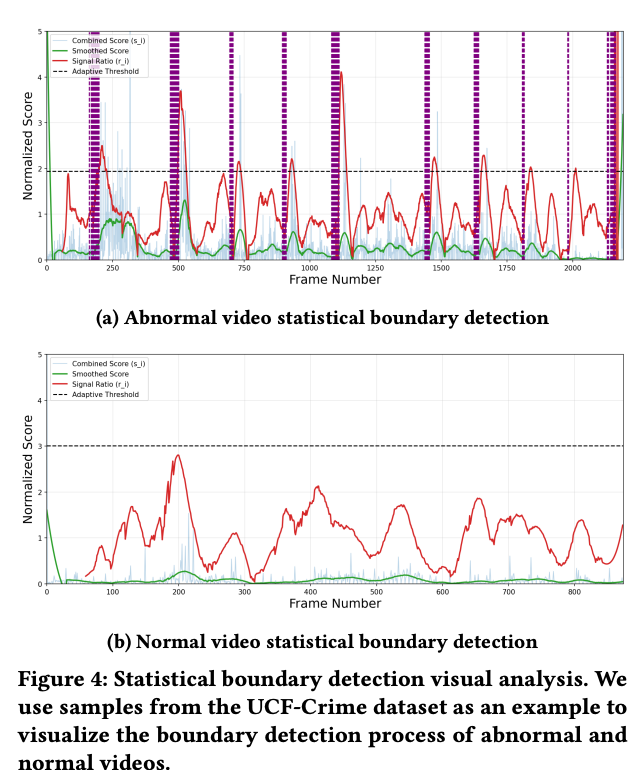
Figure 4가 이 과정의 시각화입니다. 연한 파란색이 원래 신호, 초록색이 평활화한 신호, 빨간색이 주변 평균에 대한 비율입니다. 검은 점선은 임계값이고 보라색 세로 표시가 탐지한 경계입니다.
위의 이상 영상 사례에서는 여러 경계가 잡히고, 아래의 정상 영상 사례에서는 하나의 일관된 구간으로 남습니다.
2.4 Event-Centric Anomaly Scoring
마지막은 나누어진 사건을 MLLM에 보여주고 이상 정도를 판단하는 단계입니다.
프롬프트는 복잡하지 않습니다. 영상에 명백하거나 잠재적인 이상이 있는지를 묻고, 내용을 단계적으로 살핀 뒤 최종 이상 점수를 출력하도록 합니다. 즉 바로 숫자부터 답하게 하는 것이 아니라, 먼저 영상 내용을 설명하고 그 설명을 바탕으로 점수를 내도록 하는 것입니다.
Figure 2의 예시에서는 사람이 총을 들고 직원을 겨누며 계산대에서 돈을 가져간다는 설명을 만든 뒤, 최종 점수로 0.8을 출력합니다.
저자들은 이를 hierarchical prompting이라고 부릅니다. 별도의 학습된 추론 모듈을 추가하는 것이 아니라, 관찰한 내용과 최종 판단이 순서대로 나오도록 출력 구조를 잡아주는 방식이라고 보시면 되겠습니다. 물론 먼저 설명하게 했다는 것만으로 설명이 정확하다거나 환각이 사라진다고 보장할 수는 없습니다. 여기서는 이 출력 방식이 탐지 성능에 도움이 되는지를 실험으로 확인합니다.
3. Experiments
실험은 UCF-Crime과 XD-Violence에서 진행합니다. UCF-Crime은 frame-level AUC-ROC로 평가하고, XD-Violence는 AP를 주요 지표로 사용하면서 AUC도 함께 보고합니다.
3.1 Main Results
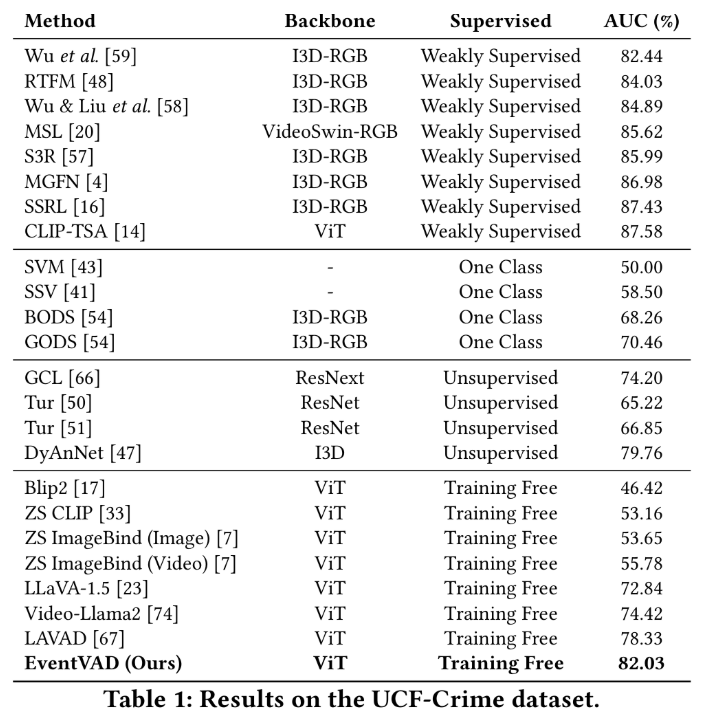
Table 1이 UCF-Crime 결과입니다. EventVAD는 AUC 82.03으로, LAVAD의 78.33보다 3.7 정도 높습니다. 논문에서 비교한 training-free 방법들 중 가장 높고, unsupervised와 one-class 방법들보다도 좋은 결과입니다.
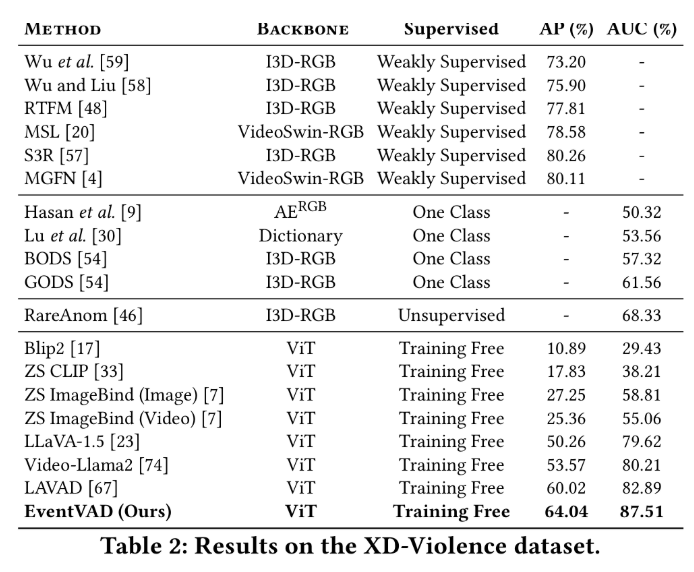
Table 2는 XD-Violence 결과입니다. LAVAD 대비 AP는 60.02에서 64.04로, AUC는 82.89에서 87.51로 성능이 오른 것을 볼 수 있습니다.
3.2 Backbone Comparison
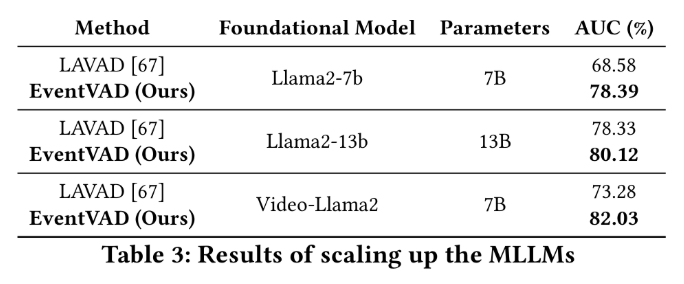
Table 3을 통해 백본의 영향이 어느정도인지를 살펴볼 수 있습니다. 같은 Video-Llama2 7B 백본을 사용했을 때 LAVAD는 73.28, EventVAD는 82.03으로 8.75% 차이가 납니다. Llama2-7B 조건에서도 68.58에서 78.39로 올라가고요. 적어도 성능 차이를 백본 교체만으로 설명하기는 어렵다는 것을 보여줍니다.
3.3 Ablation Study
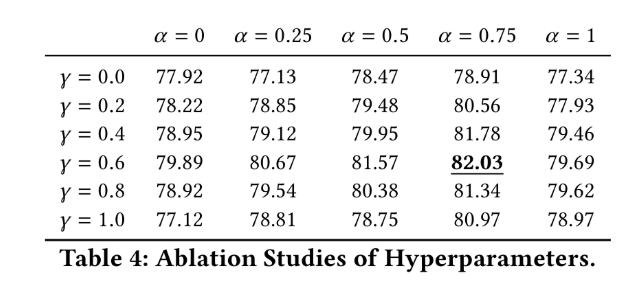
Table 4는 semantic-motion fusion coefficient $\alpha$, time decay 계수 $\gamma$를 바꾼 결과입니다. 가장 높은 값은 $\alpha=0.75$, $\gamma=0.6$에서 나온 82.03입니다.
같은 $\gamma=0.6$에서 의미 정보만 쓰는 $\alpha=1$은 79.69, 움직임 정보만 쓰는 $\alpha=0$은 79.89입니다. 둘을 적절히 섞는 편이 낫다는 것이죠. 또 $\alpha=0.75$를 고정하면 time decay가 없을 때는 78.91인데, $\gamma=0.6$에서는 82.03까지 올라갑니다. 시간적으로 먼 프레임의 연결을 줄이는 것이 실제 성능에도 영향을 준다고 볼 수 있습니다.
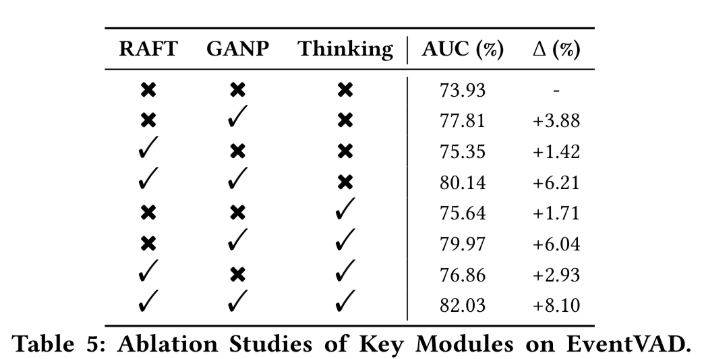
Table 5는 ablation 입니다. Thinking은 앞서 설명한, 내용을 먼저 서술한 뒤 이상 점수를 내는 출력 방식입니다.
세 가지를 모두 사용하지 않았을 때의 조건은 73.93이고, 모두 사용하면 82.03으로 약 8%가 상승합니다.
재밌는 부분은 RAFT와 GANP를 함께 썼을 때인데요. RAFT만 추가하면 1.42% 오르지만, GANP가 있는 상태에서는 77.81에서 80.14로 2.33% 올라갑니다. 움직임 정보가 그래프 전파와 함께 쓰일 때 더 도움이 되는 것을 볼 수 있습니다. 움직임 feature를 만들고 그 관계를 이용한다는 전체 설계와도 맞아떨어지는 결과라고 볼 수 있겠습니다.
지금까지 EventVAD 논문 리뷰를 마쳐봤습니다. 한 줄로 정리하면, 이상 상황을 더 잘 판단하게 하려면 먼저 무엇을 하나의 사건으로 보여줄 것인지부터 정해야 한다는 논문이라고 볼 수 있겠습니다. training-free 방법이 꼭 프롬프트나 디코딩을 바꾸는 방식에만 머물 필요는 없고, 모델 앞단에서 비디오를 구성하는 방식도 중요한 설계 대상이라는 점이 인상적이었습니다. 지금까지 읽어주셔서 감사합니다.