이번에 소개드릴 논문은 LLM 기반 멀티 에이전트 시스템의 확장성을 분석한 연구입니다. 기존 연구가 성능 향상에 초점을 맞췄던 것과 달리, 에이전트 간 협업이 어떤 조건에서 성능 향상으로 이어지는지 분석한 논문이라 할 수 있습니다.
1. Introduction
최근 LLM 기반 Agent는 단순한 질문 응답을 넘어, 스스로 추론하고 계획하며 외부 환경과 상호작용하는 방향으로 발전하고 있습니다. 코드 생성이나 웹 브라우징뿐 아니라 금융 분석, 소프트웨어 개발 등 다양한 분야에서 활용되고 있는데, 특히 복잡한 작업을 여러 단계에 걸쳐 수행해야 하는 환경에서는 여러 에이전트가 협업하는 Multi-Agent System(MAS)이 주목받고 있습니다.
MAS는 하나의 에이전트가 모든 작업을 수행하는 Single-Agent System(SAS)과 달리, 여러 에이전트가 역할을 나누거나 서로 다른 접근 방식으로 문제를 해결할 수 있다는 장점이 있습니다. 그런데 최근 연구들을 살펴보면, 에이전트의 수를 늘린다고 해서 반드시 성능이 향상되는 것은 아닙니다. 오히려 하나의 강력한 에이전트가 여러 에이전트로 구성된 시스템보다 더 좋은 성능을 보이는 경우도 있습니다.
저자는 이러한 현상에 주목하며, 기존 MAS 연구에서 충분히 다루어지지 않았던 두 가지 핵심 질문을 제시합니다.
- 어떤 태스크에서 Multi-Agent가 Single-Agent보다 효과적인가?
- 모델의 성능과 에이전트 간 협업 구조는 전체 시스템의 성능에 어떤 영향을 미치는가?
먼저 첫 번째 질문과 관련해 저자는 기존 MAS 연구들의 평가 방식에 문제가 있다고 지적합니다. 지금까지 많은 연구들이 여러 에이전트를 사용하는 것이 효과적이라는 근거를 제시해 왔지만, 정작 이러한 실험들이 실제 Agent의 특성을 충분히 반영하고 있는지는 생각해 볼 필요가 있다는 것입니다.
이를 설명하기 위해 저자는 Agentic Task와 Non-Agentic Task를 구분합니다. 전자는 외부 환경과 지속적으로 상호작용하면서 필요한 정보를 수집하고, 환경의 변화에 따라 자신의 행동을 수정해야 하는 태스크입니다. 반면 후자는 주어진 정보만을 활용해 한 번의 추론으로 정답을 도출할 수 있는 정적인 태스크를 의미합니다.
예를 들어 HumanEval과 같은 코드 생성 벤치마크에서는 주어진 요구사항에 맞는 코드를 생성하면 됩니다. 하지만 실제 소프트웨어 개발에서는 repository를 탐색하고, 코드를 수정한 뒤 테스트 결과에 따라 다시 디버깅하는 과정이 필요합니다. 두 경우 모두 코드를 작성한다는 점에서는 비슷하지만, 후자는 이전 행동의 결과가 다음 행동에 영향을 미친다는 점에서 차이가 있습니다.
기존 연구에서는 HumanEval에서 에이전트를 5개까지 늘렸을 때 정확도가 89%에 도달하는 등 에이전트 수에 따른 성능 향상이 확인되었습니다. 하지만 저자는 이러한 결과가 실제 Agentic Task에서도 동일하게 나타난다고 보기 어렵다고 주장합니다. 단순히 여러 에이전트가 독립적으로 정답을 생성하는 것과, 서로의 작업 결과를 공유하며 복잡한 환경에서 협업하는 것은 전혀 다른 문제이기 때문입니다.
그렇다면 실제 Agentic Task에서 MAS가 기대만큼 좋은 성능을 보이지 못하는 이유는 무엇일까요?
저자는 그 원인을 Context Integration과 Diversity 사이의 Trade-off에서 찾습니다. SAS는 하나의 에이전트가 모든 작업을 처리하기 때문에 이전 추론 과정과 환경에서 얻은 정보를 동일한 문맥 안에서 유지할 수 있습니다. 반면 MAS는 여러 에이전트가 서로 다른 방향으로 문제를 탐색할 수 있지만, 각 에이전트가 가진 정보를 공유하기 위해 별도의 통신 과정이 필요합니다. 쉽게 말하면, 하나의 에이전트는 자신이 지금까지 어떤 작업을 수행했는지 알고 있지만, 여러 에이전트가 협업하려면 각자가 수행한 작업과 현재 상황을 서로에게 설명해야 한다는 이야기입니다. 이때 전체 문맥을 그대로 전달하기 어려워 정보를 압축하게 되고, 그 과정에서 일부 정보가 손실될 수 있습니다.
저자는 이러한 현상을 Information Fragmentation이라고 설명하며, 에이전트 간 정보를 공유하고 작업을 조정하는 데 필요한 추가 비용을 Coordination Tax라고 정의합니다.
특히 여러 단계에 걸친 상호작용이 필요한 태스크에서는 이러한 문제가 더욱 심각해질 수 있습니다. 각 에이전트가 서로 다른 환경 상태를 기반으로 작업을 수행할 수 있고, 한 에이전트가 잘못된 정보를 전달하면 그 오류가 이후 단계까지 이어질 수 있기 때문입니다. 단순히 여러 에이전트의 답변을 모아 다수결로 결정하는 것만으로는 이러한 문제를 해결하기 어렵다는 주장이죠. 여기에 최근 LLM 자체의 성능이 빠르게 발전하고 있다는 점도 고려해야 합니다. 모델이 더 긴 context를 처리하고 복잡한 tool을 활용할 수 있게 되면서, 굳이 여러 에이전트로 작업을 나누어야 하는 이유도 점차 불분명해지고 있습니다. 결국 MAS가 효과적인지는 에이전트의 수보다 태스크의 특성과 협업 방식에 따라 달라질 수 있다는 것입니다.
다음으로 두 번째 질문과 관련해 저자는 기존 연구들이 MAS의 성능을 비교하는 방식에도 두 가지 한계가 있다고 지적합니다.
먼저 기존 연구들은 서로 다른 MAS 아키텍처를 비교하면서 prompt나 tool, compute budget을 동일하게 통제하지 않는 경우가 많았습니다. 예를 들어 에이전트의 수를 늘리면서 전체 연산량까지 증가시켰다면, 성능이 향상되더라도 이것이 협업 구조의 효과인지 단순히 더 많은 자원을 사용한 결과인지 구분하기 어렵습니다.
또 다른 문제는 대부분의 연구들이 최종 Accuracy에만 집중한다는 점입니다. 물론 최종적으로 문제를 얼마나 잘 해결했는지는 중요하지만, 이러한 결과만으로는 에이전트들이 얼마나 효율적으로 협업했는지 알 수 없습니다. 특히 불필요한 메시지를 얼마나 주고받았는지, 개별 에이전트의 오류가 다른 에이전트로 어떻게 전파되었는지와 같은 과정은 최종 성능만으로 설명하기 어렵습니다.
저자는 이러한 이유로 MAS를 평가할 때 단순한 정확도뿐 아니라 Coordination Overhead, Error Propagation, Information Flow와 같은 협업 과정의 특성도 함께 고려해야 한다고 주장합니다.
이러한 두 한계를 해결하기 위해 저자는 에이전트 시스템의 성능을 정량적으로 분석하는 새로운 Scaling Framework를 제안합니다. 핵심은 동일한 실험 조건에서 에이전트의 협업 구조와 기반 LLM의 성능이 전체 시스템에 미치는 영향을 분리하여 분석하는 것입니다.
먼저 저자는 SAS를 기준으로 Independent, Centralized, Decentralized, Hybrid의 네 가지 MAS 아키텍처를 비교합니다. 그리고 OpenAI, Google, Anthropic의 서로 다른 LLM 계열을 사용하되, prompt와 tool, compute budget을 동일하게 설정하여 아키텍처 자체의 영향을 확인하고자 합니다.
실험은 BrowseCompPlus, Finance-Agent, PlanCraft, Workbench, SWE-bench Verified, Terminal-Bench의 총 6개 Agentic Benchmark에서 수행하며, 전체 260개의 설정을 비교합니다.
여기서 저자가 주목하는 것은 단순히 어떤 아키텍처의 성능이 가장 높은지가 아닙니다. 에이전트의 추론 능력을 나타내는 Intelligence Index와 함께 협업 효율, 오류 증폭, 메시지 중복도 등을 측정하여 어떤 조건에서 특정 협업 구조가 유리해지는지를 설명하고자 합니다.
이를 위해 저자는 Mixed-Effects Regression Model을 활용한 성능 예측 모델을 구축합니다. 실험 결과, 6개 벤치마크에서 교차 검증 기준 R²=0.373을 달성했으며, 태스크 특성을 반영한 모델 능력 지표를 사용했을 때는 R²=0.413으로 향상되었습니다. 수치 자체만 보면 모든 성능 변화를 충분히 설명한다고 보기는 어렵지만, 저자는 학습에 사용하지 않은 설정에서도 87%의 비율로 가장 좋은 아키텍처를 식별했다는 점을 강조합니다.
이러한 분석을 통해 저자는 MAS의 성능을 결정하는 세 가지 주요 현상을 발견합니다.
첫 번째는 Tool-Coordination Trade-off입니다. 복잡한 tool 사용이 필요한 태스크에서는 여러 에이전트가 작업을 나누는 과정에서 오히려 성능이 저하될 수 있다는 것입니다. 특히 전체 compute budget이 고정되어 있다면 에이전트마다 사용할 수 있는 token budget이 줄어들고, 정보를 공유하는 데에도 추가 비용이 발생합니다. 결국 작업을 분담하면서 얻는 이득보다 협업에 필요한 비용이 더 커질 수 있다는 이야기입니다.
두 번째는 Capability Ceiling입니다. 단일 에이전트가 이미 높은 성능을 보이는 경우에는 추가적인 에이전트로 얻을 수 있는 이득이 점차 줄어듭니다. 실제로 저자는 SAS의 정확도가 45%를 초과하는 태스크에서 MAS의 성능이 오히려 저하되는 경향을 확인했습니다. 이미 충분히 강력한 모델이라면 다른 에이전트의 도움을 받는 것보다 혼자 문제를 해결하는 편이 더 효율적일 수 있다는 주장입니다.
세 번째는 Architecture-Dependent Error Amplification입니다. 에이전트 간 협업 구조에 따라 오류가 전파되는 정도도 크게 달라진다는 것입니다. 저자의 실험에서는 별도의 중앙 검증 과정이 없는 Independent 구조에서 오류 증폭이 17.2배로 나타난 반면, Centralized 구조에서는 4.4배로 감소했습니다. 이는 여러 에이전트를 사용하는 것뿐 아니라, 각 에이전트가 생성한 정보가 올바른지 검증하는 과정도 중요하다는 점을 보여줍니다.
이러한 차이는 실제 성능에서도 확인됩니다. 여러 하위 작업으로 분해할 수 있는 금융 추론 태스크에서는 Centralized 구조가 SAS보다 80.8% 높은 상대적 성능을 보였습니다. 반면 순차적으로 제약조건을 만족해야 하는 Planning 태스크에서는 Independent 구조의 성능이 70.0%나 감소했습니다.
웹 브라우징처럼 다양한 경로를 동시에 탐색해야 하는 태스크에서는 Decentralized 구조가 효과적이었지만, 이전 단계의 결과를 계속 유지해야 하는 순차적 계획 수립에서는 모든 MAS 구조가 성능을 저하시켰습니다.
결국 여러 에이전트가 서로 다른 문제를 동시에 해결할 수 있는 태스크와, 하나의 연속적인 문맥 안에서 문제를 해결해야 하는 태스크는 적합한 아키텍처가 다르다는 이야기입니다.
저자는 이러한 결과를 바탕으로 MAS의 성능이 단순히 에이전트의 수에 따라 결정되는 것이 아니라, 모델의 추론 능력과 태스크의 구조, 그리고 에이전트 간 협업 방식이 얼마나 잘 맞는지에 따라 달라진다고 주장합니다.
기존 연구들이 여러 에이전트를 어떻게 구성하여 성능을 향상시킬 것인지에 집중했다면, 본 연구는 한 단계 더 나아가 어떤 상황에서 여러 에이전트를 사용하는 것이 효과적이고, 어떤 협업 구조를 선택해야 하는지를 정량적으로 설명하고자 한다는 점에서 의미가 있습니다.
각 아키텍처의 구체적인 구성과 Scaling Framework의 분석 방법은 이후 방법론 파트에서 더욱 자세히 알아보겠습니다.
2. Agent Systems and Tasks
앞서 Introduction에서는 에이전트의 수를 늘리는 것이 항상 성능 향상으로 이어지지 않으며, 태스크의 특성과 협업 구조에 따라 결과가 달라질 수 있다는 문제를 제기했습니다. 이를 분석하려면 먼저 Single-Agent와 Multi-Agent를 어떤 기준으로 구분할 것인지, 그리고 어떤 태스크를 Agentic Task로 볼 것인지 명확하게 정의할 필요가 있습니다.
2.1. System Definition
먼저 저자는 Agent System을 네 가지 구성 요소로 정의합니다.
S = (A, E, C, Ω)
여기서 A는 시스템에 포함된 에이전트들의 집합이고, E는 에이전트들이 상호작용하는 환경을 의미합니다. C는 에이전트 간 정보가 전달되는 구조인 Communication Topology, Ω는 여러 에이전트의 작업을 조정하는 Orchestration Policy입니다.
쉽게 말하면, 어떤 에이전트들이 어떤 환경에서 작업하고, 서로 어떤 방식으로 정보를 주고받으며, 최종적으로 어떻게 협업할 것인지를 정의한 것입니다.
이때 에이전트가 하나라면 Single-Agent System(SAS), 두 개 이상이라면 Multi-Agent System(MAS)으로 구분합니다.
각 에이전트 역시 네 가지 요소로 구성됩니다.
Sᵢ = (Φᵢ, Aᵢ, Mᵢ, πᵢ)
Φᵢ는 에이전트의 추론을 담당하는 Reasoning Policy로, 일반적으로 LLM이 사용됩니다. Aᵢ는 웹 검색이나 코드 실행처럼 에이전트가 수행할 수 있는 Action Space이며, Mᵢ는 이전 작업과 관찰 결과를 저장하는 Internal Memory입니다. 마지막으로 πᵢ는 지금까지의 관찰 기록을 바탕으로 다음 행동을 결정하는 Decision Function입니다.
에이전트는 이러한 구성 요소를 이용해 반복적인 Action-Observation 과정을 수행합니다.
예를 들어 에이전트가 웹 검색을 수행했다면, 검색 결과를 확인한 뒤 다음에 어떤 정보를 탐색할지 결정하게 됩니다. 이때 이전에 실행한 검색 명령과 그 결과는 History에 저장되며, 이후 행동을 결정하는 데 사용됩니다.
저자는 이를 다음과 같이 정의합니다.
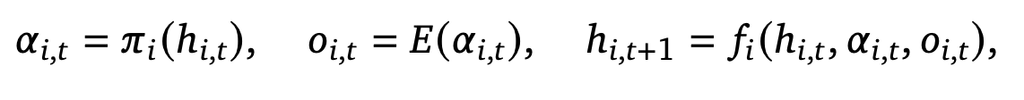
먼저 에이전트는 현재까지의 History를 기반으로 행동 α를 결정합니다. 이후 환경 E에서 해당 행동을 실행하여 관찰 결과 o를 얻고, 이를 기존 History에 추가합니다. 여기서 History는 이전 행동과 관찰 결과를 순서대로 저장한 것입니다. 다만 LLM의 Context Window에는 제한이 있기 때문에, 기록이 최대 token 수를 초과하면 일부 정보를 잘라내야 합니다.
이러한 과정은 SAS와 MAS에 동일하게 적용됩니다. 두 시스템의 차이는 개별 에이전트가 행동하는 방식이 아니라, 여러 에이전트가 서로 어떻게 연결되고 협업하는지에 있습니다.
먼저 SAS는 하나의 에이전트가 모든 추론과 행동을 순차적으로 수행합니다. 따라서 에이전트 간 정보를 전달하는 과정이 필요하지 않으며, k번의 추론을 수행할 때 계산 복잡도는 O(k)로 표현됩니다.
하나의 에이전트가 모든 작업을 처리하기 때문에 Communication Overhead가 없고, Memory Complexity도 O(k) 수준으로 유지됩니다. 반면 여러 작업을 병렬적으로 수행하거나, 다른 에이전트가 결과를 독립적으로 검증하는 데에는 한계가 있습니다.
다음으로 MAS는 여러 에이전트가 동일한 환경에서 작업하면서 서로 정보를 주고받는 구조입니다. 저자는 이러한 협업 방식을 구분하기 위해 Independent, Centralized, Decentralized, Hybrid의 네 가지 아키텍처를 정의합니다.
각 아키텍처의 차이는 에이전트의 수보다는 정보가 전달되는 경로와 작업을 조정하는 방식에 있습니다.
1. Independent MAS
먼저 Independent 구조는 여러 에이전트가 서로 통신하지 않고 독립적으로 작업을 수행하는 방식입니다.
각 에이전트는 동일한 문제에 대해 개별적으로 추론한 뒤 자신의 결과를 Aggregator에 전달합니다. 이때 에이전트들 사이에는 직접적인 정보 교환이 발생하지 않습니다.
여기서 중요한 점은 저자가 Aggregator에 별도의 검증 기능을 부여하지 않았다는 것입니다. 일반적인 Ensemble 방식에서는 여러 결과를 비교하거나 Majority Voting을 통해 최종 답변을 결정할 수 있지만, 본 연구의 Independent 구조에서는 이러한 과정을 사용하지 않습니다.
대신 각 에이전트의 결과를 단순히 결합하는 Synthesis-Only Policy를 적용합니다.
이는 여러 에이전트가 독립적으로 문제를 탐색했을 때 발생하는 효과만 확인하기 위한 설계입니다. 만약 Aggregator가 결과를 비교하고 오류까지 수정한다면, 성능 향상이 병렬적인 탐색 덕분인지 검증 과정 덕분인지 구분하기 어려워지기 때문입니다.
결국 Independent 구조는 에이전트 간 협업 없이 Parallel Exploration 자체가 얼마나 효과적인지를 확인하기 위한 아키텍처라고 볼 수 있습니다.
2. Centralized MAS
다음으로 Centralized 구조는 하나의 Orchestrator가 여러 Sub-Agent를 관리하는 방식입니다.
Independent 구조에서는 각 에이전트가 독립적으로 작업을 수행했다면, Centralized 구조에서는 Orchestrator가 작업을 분배하고 진행 상황을 확인하며 결과를 통합합니다.
쉽게 말하면, 여러 에이전트 위에 전체 작업을 관리하는 하나의 관리자 에이전트를 추가한 구조입니다.
이때 Orchestrator는 작업을 여러 하위 태스크로 분해하거나, 각 에이전트가 생성한 결과를 검증하는 역할을 수행할 수 있습니다. 따라서 개별 에이전트가 잘못된 결과를 생성하더라도 이를 최종 결과에 반영하기 전에 확인할 수 있다는 장점이 있습니다.
다만 모든 작업을 Orchestrator를 통해 관리하기 때문에, 중앙에 작업이 집중되는 Bottleneck이 발생할 수 있습니다. 저자는 n개의 Sub-Agent가 r번의 Coordination Round를 수행하고, 각 에이전트가 k번의 추론을 수행할 때 계산 복잡도를 O(rnk)로 정의합니다. 즉, 중앙에서 작업을 통제하고 검증할 수 있다는 장점이 있지만, 그만큼 추가적인 Coordination Cost가 발생하는 구조입니다.
3. Decentralized MAS
세 번째는 Decentralized 구조입니다.
Centralized 구조와 달리 별도의 Orchestrator를 두지 않고, 모든 에이전트가 서로 직접 정보를 주고받는 방식입니다. 각 에이전트는 자신의 추론 결과를 다른 에이전트와 공유하고, 여러 차례의 Debate Round를 거치면서 최종적으로 Consensus를 형성합니다.
예를 들어 한 에이전트가 특정 해결 방법을 제안하면 다른 에이전트가 이를 검토하거나 대안을 제시할 수 있습니다. 이후 서로의 의견을 반영해 해결 방향을 수정하는 구조입니다.
이 방식은 중앙에서 모든 작업을 관리하지 않기 때문에, 각 에이전트가 다양한 관점에서 문제를 탐색하고 정보를 공유할 수 있다는 장점이 있습니다.
반면 에이전트 수가 많아질수록 서로 주고받아야 하는 메시지도 증가하게 됩니다. 특히 여러 차례의 Debate Round를 수행한다면 각 에이전트가 다른 에이전트의 정보를 처리해야 하므로 Communication Overhead가 커질 수 있습니다. 저자는 d번의 Debate Round를 수행할 때 계산 복잡도를 O(dnk)로 정의하며, 각 에이전트가 자신의 토론 기록을 저장하기 때문에 Memory Complexity 역시 O(dnk)로 표현합니다.
결국 Decentralized 구조는 에이전트 간 자유로운 정보 교환과 합의를 통해 문제를 해결하는 방식이지만, 그 과정에서 발생하는 통신 비용을 고려해야 합니다.
4. Hybrid MAS
마지막은 Hybrid 구조입니다.
Hybrid는 Centralized와 Decentralized의 특징을 결합한 방식으로, 하나의 Orchestrator가 전체 작업을 관리하면서도 일부 에이전트들 사이에는 직접적인 통신을 허용합니다. 즉, 중앙에서 작업을 분배하고 결과를 검증하는 구조를 유지하되, 필요한 경우 Sub-Agent들이 서로 정보를 공유할 수 있도록 설계한 것입니다.
다만 두 방식을 함께 사용하기 때문에 Orchestrator와의 통신뿐 아니라 에이전트 간 직접적인 통신에도 비용이 발생합니다. 저자는 Orchestrator와의 Coordination Round를 r, 에이전트 간 Peer Communication Round를 p라고 정의하고, 전체 계산 복잡도를 O((r+p)nk)로 표현합니다.
결국 Hybrid 구조는 중앙의 검증 기능을 유지하면서 에이전트 간 협업의 유연성을 확보하려는 방식입니다.
여기까지 살펴보면 네 가지 MAS 구조는 각각 서로 다른 협업 특성을 가지고 있습니다.
Independent는 병렬적인 탐색에 집중하고, Centralized는 중앙의 작업 관리와 검증을 강조합니다. Decentralized는 에이전트 간 자유로운 정보 교환을 통해 합의를 형성하며, Hybrid는 두 가지 협업 방식을 함께 활용합니다.
여기서 저자는 Communication과 Coordination을 구분해야 한다고 강조합니다.
Communication은 에이전트 간 메시지를 주고받는 행위 자체를 의미합니다. 반면 Coordination은 각 에이전트가 어떤 작업을 수행할지 결정하고, 전체 문제 해결 과정을 조정하는 것을 의미합니다.
Centralized 구조에서는 Orchestrator가 작업을 분배하고 진행 상황을 관리하는 것이 Coordination에 해당하며, Orchestrator와 Sub-Agent 사이에서 결과를 전달하는 것은 Communication입니다.
반면 Decentralized 구조에서는 여러 에이전트가 토론을 통해 정보를 공유하면서 동시에 문제 해결 방향도 결정하기 때문에, 두 과정이 서로 밀접하게 연결되어 있습니다.
결국 에이전트들이 많은 메시지를 주고받는다고 해서 반드시 효과적으로 협업하고 있다고 볼 수는 없다는 이야기입니다.
또한 본 연구의 아키텍처 구분은 MAS를 설계하는 모든 요소를 포함하는 것은 아닙니다. 저자는 에이전트의 전문화 방식이나 Memory Architecture, Aggregation Strategy 등도 중요한 설계 요소이지만, 이번 연구에서는 그중 Communication Topology를 중심으로 분석합니다.
이어서 저자는 MAS에서 발생하는 오류를 정량적으로 분석하기 위해 Error Amplification Factor를 정의합니다.
먼저 태스크의 성공률을 P라고 할 때 Error Rate는 다음과 같습니다.
E = 1 – P
그리고 MAS의 Error Rate를 SAS의 Error Rate로 나누어 Task-Level Error Amplification을 계산합니다.
Aₑ(task) = E_MAS / E_SAS
이때 Aₑ(task)가 1보다 크다면 MAS의 오류율이 SAS보다 높다는 의미입니다. 반대로 1보다 작다면 MAS가 SAS보다 오류를 효과적으로 줄였다고 해석할 수 있습니다.
쉽게 말하면, 여러 에이전트가 협업하면서 실제로 오류를 줄였는지, 아니면 오히려 새로운 오류를 만들어냈는지 확인하기 위한 지표입니다.
여기에 저자는 Trace-Level Error Amplification도 별도로 정의합니다. 이는 최종 정답의 오류율을 비교하는 것이 아니라, 에이전트 간 협업 실패로 인해 얼마나 많은 추가 계산 작업이 발생했는지를 Execution Trace의 Token 분석을 통해 측정합니다.
저자는 이러한 지표들을 활용하여 어떤 아키텍처가 에이전트 간 오류를 효과적으로 억제하고, 어떤 아키텍처에서는 오류가 더욱 크게 증폭되는지 분석하고자 합니다.
2.2. Agentic Tasks and Benchmarks
앞에서는 실험에 사용되는 다섯 가지 Agent System의 구조를 정의했습니다. 다음으로 저자는 이러한 아키텍처들을 어떤 태스크에서 평가할 것인지 설명합니다.
여기서 중요한 것은 단순히 여러 벤치마크를 사용하는 것이 아니라, 에이전트가 실제로 환경과 상호작용해야 하는 태스크를 선택하는 것입니다.
앞서 Introduction에서도 설명했듯이, 저자는 기존 MAS 연구들이 주로 정적인 벤치마크에서 성능을 평가했다는 점을 문제로 지적했습니다. 따라서 본 연구에서는 단순한 추론만으로 해결할 수 있는 태스크와, 환경으로부터 얻은 정보를 바탕으로 행동을 수정해야 하는 태스크를 구분합니다. 저자는 이를 위해 Agentic Task를 반복적인 환경 상호작용이 단일 추론보다 실질적인 이득을 제공하는 태스크로 정의합니다. 구체적으로는 에이전트가 여러 단계에 걸쳐 환경과 상호작용하면서 얻은 보상이, 한 번의 Forward Pass로 문제를 해결했을 때 얻을 수 있는 보상보다 충분히 높아야 한다는 것입니다.
이를 정량화하기 위해 저자는 Interactive Policy와 Single-Shot Function의 기대 보상 차이를 비교합니다. 이때 상호작용을 통해 얻는 상대적인 성능 이득이 태스크별 임계값 δ를 초과하면 Agentic Task로 판단합니다.
여기서 Interactive Policy는 환경에서 관찰한 결과에 따라 다음 행동을 수정할 수 있는 정책이고, Single-Shot Function은 추가적인 환경 피드백 없이 주어진 입력으로 결과를 생성하는 방식입니다.
저자는 이러한 정의를 바탕으로 Agentic Benchmark가 갖춰야 할 세 가지 조건을 제시합니다.
첫 번째는 Sequential Interdependence입니다.
에이전트의 다음 행동이 이전 행동의 결과에 영향을 받아야 한다는 의미입니다. 예를 들어 소프트웨어 개발 과정에서는 코드를 수정한 뒤 테스트를 수행하고, 테스트 결과에 따라 다음 수정 방향을 결정해야 합니다. 따라서 각 단계가 독립적으로 수행되는 것이 아니라 이전 단계의 결과와 연결되어 있습니다.
두 번째는 Partial Observability입니다.
문제를 해결하는 데 필요한 모든 정보를 처음부터 알 수 없어야 한다는 것입니다. 에이전트는 외부 환경을 탐색하거나 Tool을 사용하면서 부족한 정보를 직접 수집해야 합니다. 웹 브라우징을 예로 들면, 처음부터 필요한 정보가 어느 웹페이지에 있는지 알 수 없기 때문에 검색과 탐색 과정을 반복해야 합니다.
세 번째는 Adaptive Strategy Formation입니다.
에이전트가 환경에서 새롭게 얻은 정보를 바탕으로 기존 전략을 수정할 수 있어야 한다는 의미입니다. 예를 들어 특정 웹페이지에서 원하는 정보를 찾지 못했다면 다른 검색어를 사용하거나 탐색 경로를 변경해야 합니다. 즉, 처음 수립한 계획을 그대로 실행하는 것이 아니라 상황에 따라 행동을 조정할 수 있어야 합니다.
저자는 이러한 세 가지 조건을 바탕으로 GSM8K나 MMLU와 같은 정적인 추론 벤치마크를 일반적인 Agentic Benchmark와 구분합니다.
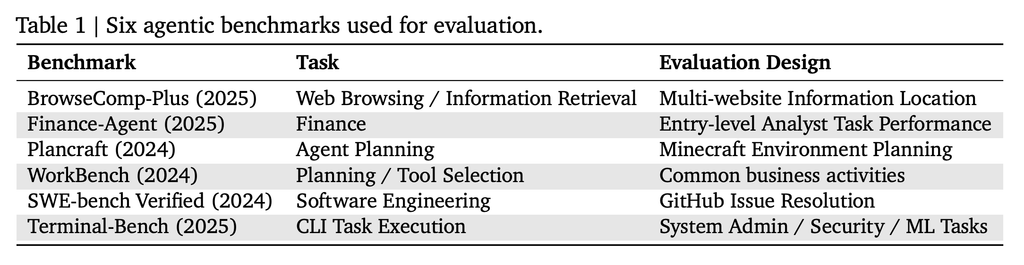
각 벤치마크는 서로 다른 유형의 작업을 평가하지만, 공통적으로 외부 환경과의 상호작용을 요구한다는 특징이 있습니다. 예를 들어 BrowseComp-Plus에서는 여러 웹사이트를 탐색하면서 필요한 정보를 수집해야 하고, SWE-bench Verified에서는 실제 코드베이스를 확인한 뒤 문제를 수정해야 합니다. Terminal-Bench 역시 명령어를 실행하고 그 결과를 확인하면서 작업을 진행해야 합니다.
저자는 이러한 벤치마크들이 단순히 LLM의 지식이나 추론 능력만을 평가하는 것이 아니라, 환경을 탐색하고 피드백에 적응하며 작업을 수행하는 능력까지 평가할 수 있다고 설명합니다.
마지막으로 저자는 서로 다른 Agent Architecture를 공정하게 비교하기 위해 네 가지 실험 설계 원칙을 제시합니다.
먼저 Controlled Tool Interface입니다. 모든 아키텍처가 동일한 Tool API와 Observation Structure를 사용하도록 설정합니다. 이를 통해 특정 아키텍처가 더 좋은 도구를 사용했기 때문에 높은 성능을 달성하는 상황을 방지합니다.
다음으로 Controlled for Parametric Knowledge입니다. 모델마다 사전에 학습한 지식이 다를 수 있기 때문에, 단순히 더 많은 정보를 알고 있는 모델이 유리해지는 상황을 고려해야 합니다. 저자는 동일한 LLM 계열 안에서는 암기된 지식보다 적응적인 추론 능력을 중심으로 평가하며, 서로 다른 모델 계열을 비교할 때는 Baseline Normalization을 활용합니다.
세 번째는 Action-Observation Loop Length입니다. 저자는 각 벤치마크에서 상호작용 경로의 길이가 3을 초과하도록 설정합니다. 즉, 한두 번의 행동만으로 문제를 해결하는 것이 아니라 여러 단계에 걸친 추론과 환경 피드백이 필요하도록 구성합니다.
마지막은 Comparative Normalization입니다. 서로 다른 아키텍처의 성능을 비교할 때 가장 좋은 Single-Agent Baseline을 기준으로 정규화합니다. 이를 통해 MAS가 SAS보다 얼마나 성능을 향상시켰는지, 반대로 얼마나 저하시켰는지를 상대적으로 분석할 수 있습니다.
3. Experiments & Results
이번 실험에서는 총 260개의 설정을 통해 MAS의 성능이 태스크와 협업 구조에 따라 어떻게 달라지는지 분석합니다. 실험 내용이 상당히 많아서 이번 리뷰에서는 MAS가 효과적인 태스크와 그렇지 않은 태스크의 차이, 모델의 성능과 협업 비용 사이의 관계, 그리고 이러한 결과를 바탕으로 적절한 아키텍처를 예측할 수 있는지에 대해서만 다뤄보겠습니다.
3.1. Experimental Setup
앞서 설명한 다섯 가지 Agent Architecture를 대상으로 OpenAI, Google, Anthropic의 LLM들을 사용하여 실험을 진행합니다. 평가에는 Finance-Agent, PlanCraft, BrowseComp-Plus, Workbench, SWE-bench Verified, Terminal-Bench의 총 6개 벤치마크를 사용하며, 전체 260개의 설정을 비교합니다.
여기서 중요한 점은 MAS와 SAS의 전체 Reasoning Budget을 동일하게 설정했다는 것입니다. MAS는 여러 에이전트가 연산 자원을 나누어 사용하고, SAS는 그만큼 더 많은 추론 단계를 수행할 수 있도록 설정합니다. 따라서 MAS가 더 많은 에이전트를 사용했다는 이유만으로 추가적인 연산 자원을 얻는 상황을 방지합니다.
성능은 각 태스크의 Success Rate를 기준으로 평가하며, SAS를 Baseline으로 설정하여 MAS의 상대적인 성능 변화를 측정합니다. 이와 함께 에이전트 간 통신 비용과 추론 효율, 오류 전파 정도를 분석하여 성능 차이가 발생하는 원인을 살펴봅니다.
3.2. Main Results
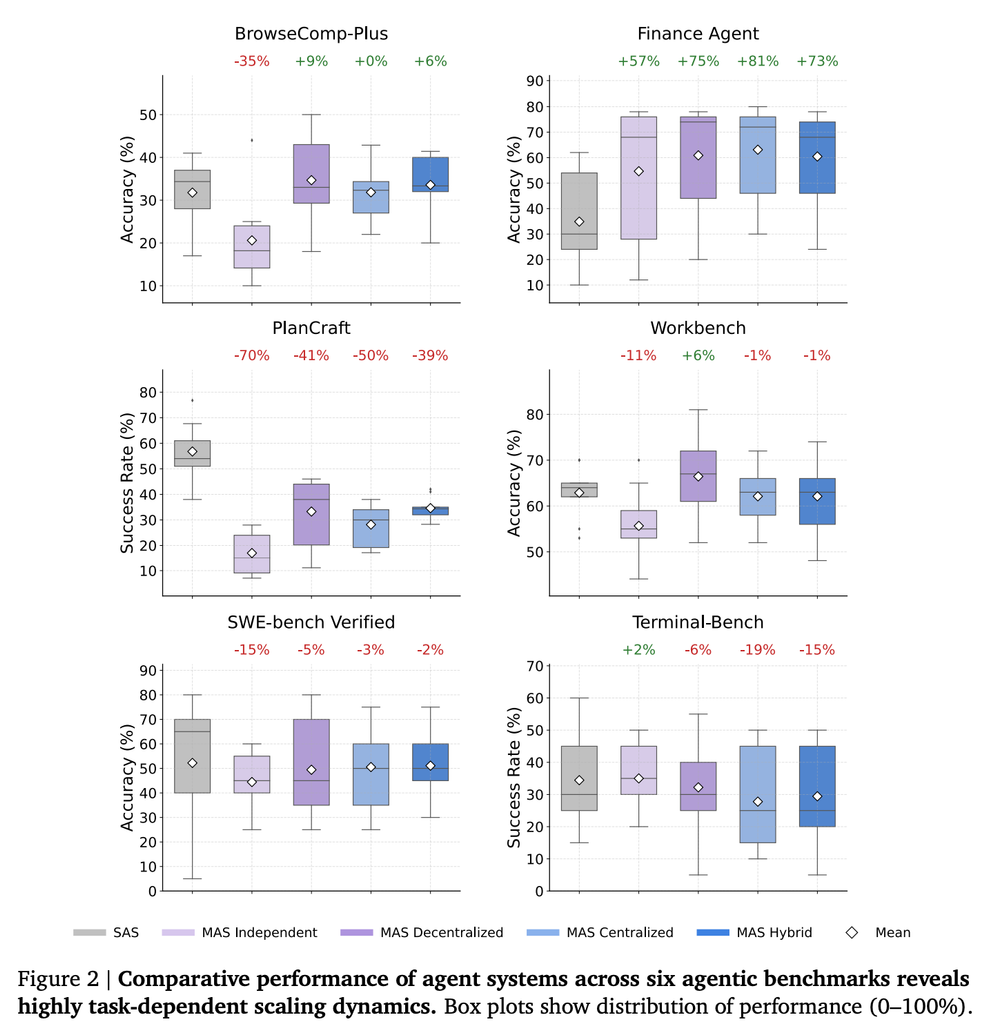
먼저 Figure 2는 여섯 가지 Agentic Benchmark에서 SAS와 네 가지 MAS 아키텍처의 성능을 비교한 결과입니다.
전체적으로 살펴보면, MAS가 항상 SAS보다 좋은 성능을 보이는 것은 아닙니다. 특히 태스크를 여러 하위 문제로 나눌 수 있는지, 아니면 이전 단계의 결과를 유지하면서 순차적으로 해결해야 하는지에 따라 성능 차이가 크게 나타났습니다.
이러한 특징을 가장 잘 보여주는 것은 Finance-Agent와 PlanCraft의 비교입니다.
먼저 Finance-Agent에서는 MAS가 상당한 성능 향상을 보였습니다. SAS의 평균 Success Rate는 34.9%였지만, Centralized 구조에서는 63.1%로 증가하여 80.8%의 상대적 성능 향상을 달성했습니다. Decentralized와 Hybrid 역시 각각 74.5%, 73.1%의 상대적 성능 향상을 보였습니다.
저자는 이러한 결과가 금융 분석이라는 태스크의 특성에서 비롯된다고 설명합니다.
예를 들어 특정 기업의 인수합병을 분석한다고 가정해 보겠습니다. 하나의 에이전트가 모든 작업을 처리한다면 관련 뉴스를 검색한 뒤 SEC 공시 자료를 확인하고, 이후 기업의 재무 상태와 사업적 영향을 순차적으로 분석해야 합니다.
반면 MAS에서는 각 에이전트가 서로 다른 분석을 동시에 수행할 수 있습니다. 하나는 관련 뉴스와 규제 정보를 조사하고, 다른 하나는 SEC 공시 자료를 분석하며, 나머지 에이전트는 기업 운영에 미치는 영향을 평가하는 방식입니다. 이후 Orchestrator가 각 결과를 종합하여 최종 답변을 생성합니다. 즉, 서로 독립적으로 수행할 수 있는 하위 작업들이 존재하기 때문에 여러 에이전트를 사용하는 것이 효과적이라는 이야기입니다.
반대로 PlanCraft에서는 완전히 다른 결과가 나타났습니다.
PlanCraft는 Minecraft 환경에서 주어진 재료와 제약조건을 바탕으로 특정 아이템을 제작하는 계획 수립 태스크입니다. 실험 결과, SAS의 평균 Success Rate는 56.8%였지만 Independent 구조에서는 17.0%까지 감소하여 70.0%의 상대적 성능 저하가 발생했습니다. Centralized와 Decentralized, Hybrid 역시 모두 SAS보다 낮은 성능을 보였습니다.
저자는 이러한 차이를 실제 Agent Execution Trace를 통해 설명합니다.
예를 들어 특정 아이템을 제작해야 한다면, SAS는 먼저 제작법을 검색하고 필요한 재료를 배치한 뒤 제작을 완료할 수 있습니다. 각 단계가 이전 단계의 결과에 의존하기 때문에 순서대로 실행하면 되는 작업입니다.
그런데 Centralized 구조에서는 이를 여러 에이전트에게 분배합니다. 한 에이전트는 제작법을 조사하고, 다른 에이전트는 재료를 확인하며, 마지막 에이전트가 실제 제작을 수행하는 방식입니다.
문제는 이러한 작업 분해가 반드시 필요한 것은 아니라는 점입니다. 제작법 검색은 간단한 Tool Call로 해결할 수 있고, 재료 상태 역시 이미 환경에서 확인할 수 있습니다. 오히려 여러 에이전트가 서로 작업 결과를 공유하는 과정에서 불필요한 Coordination Overhead가 발생하게 됩니다.
저자는 이러한 현상이 태스크 자체의 복잡도보다 협업 과정의 복잡도가 더 커졌기 때문이라고 설명합니다. 이를 통해 모든 태스크에 적합한 하나의 MAS 아키텍처가 존재하는 것이 아니라, 태스크의 구조에 따라 적합한 협업 방식이 달라진다는 것을 알 수 있습니다.
3.3. Scaling Principles
앞선 실험에서는 MAS의 성능이 태스크와 아키텍처에 따라 크게 달라진다는 점을 확인했습니다. 그렇다면 이러한 차이를 단순한 실험 결과로만 받아들이는 것이 아니라, 어떤 조건에서 MAS가 효과적인지 정량적으로 예측할 수 있을까요?
저자는 이를 위해 모델의 Intelligence Index와 Agent Count, Tool Count, Single-Agent Baseline Performance를 함께 고려하는 Scaling Model을 제안합니다. 여기에 Coordination Efficiency와 Overhead, Error Amplification 등의 지표를 추가하여 에이전트 시스템의 성능이 어떤 요인에 의해 결정되는지 분석합니다.
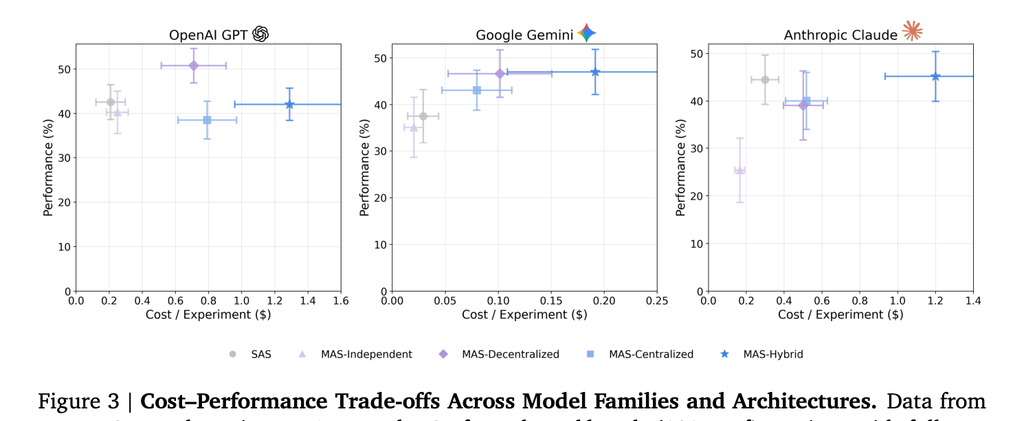
먼저 Figure 3은 모델 계열과 아키텍처에 따른 Cost-Performance Trade-off를 보여줍니다. OpenAI, Google, Anthropic의 LLM들을 대상으로 성능과 실행 비용을 비교한 결과, MAS의 성능 향상이 반드시 비용 효율적인 것은 아니었습니다. 특히 Centralized나 Hybrid 구조는 높은 성능을 보이는 경우에도 추가적인 Coordination Cost가 발생했으며, 이러한 비용 대비 성능의 관계는 모델 계열에 따라서도 차이가 나타났습니다.
즉, 여러 에이전트를 사용해 성능을 높이는 것뿐 아니라 그 성능 향상을 얻기 위해 얼마나 많은 비용을 지불해야 하는지도 함께 고려해야 한다는 이야기입니다.
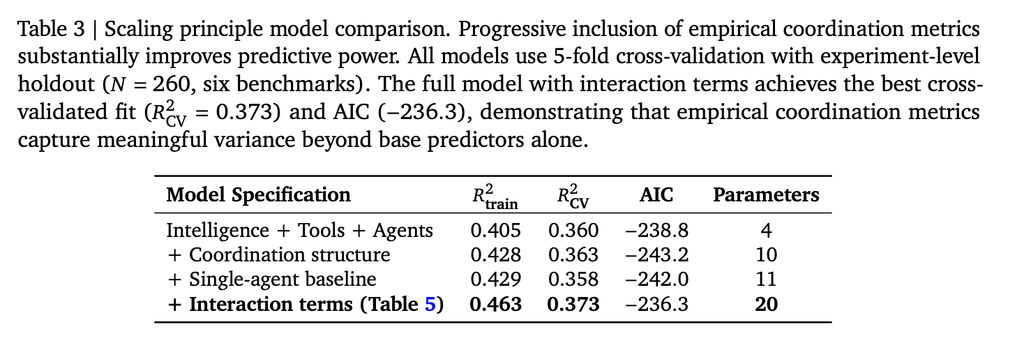
이어서 저자는 이러한 관계를 정량적으로 설명하기 위해 Mixed-Effects Regression Model을 구축합니다. Table 3을 보면 Intelligence Index와 Tool Count, Agent Count만을 사용한 모델은 교차 검증 R²=0.360을 기록했습니다. 여기에 Coordination Structure와 각종 Interaction Term을 추가한 최종 모델은 R²=0.373을 달성했으며, 일반적인 Intelligence Index 대신 실제 Agentic Task에서 측정한 Agentic Capability Index(ACI)를 사용하면 R²=0.413까지 향상되었습니다.
이는 에이전트 시스템의 성능을 예측할 때 모델 자체의 추론 능력뿐 아니라, 협업 과정에서 발생하는 특성을 함께 고려하는 것이 도움이 된다는 것을 보여줍니다. 다만 예측력의 향상 폭이 크지는 않기 때문에, 제안한 모델이 모든 성능 변화를 충분히 설명한다고 보기는 어렵습니다.
그렇다면 실제로 어떤 요인들이 성능에 영향을 미쳤을까요?
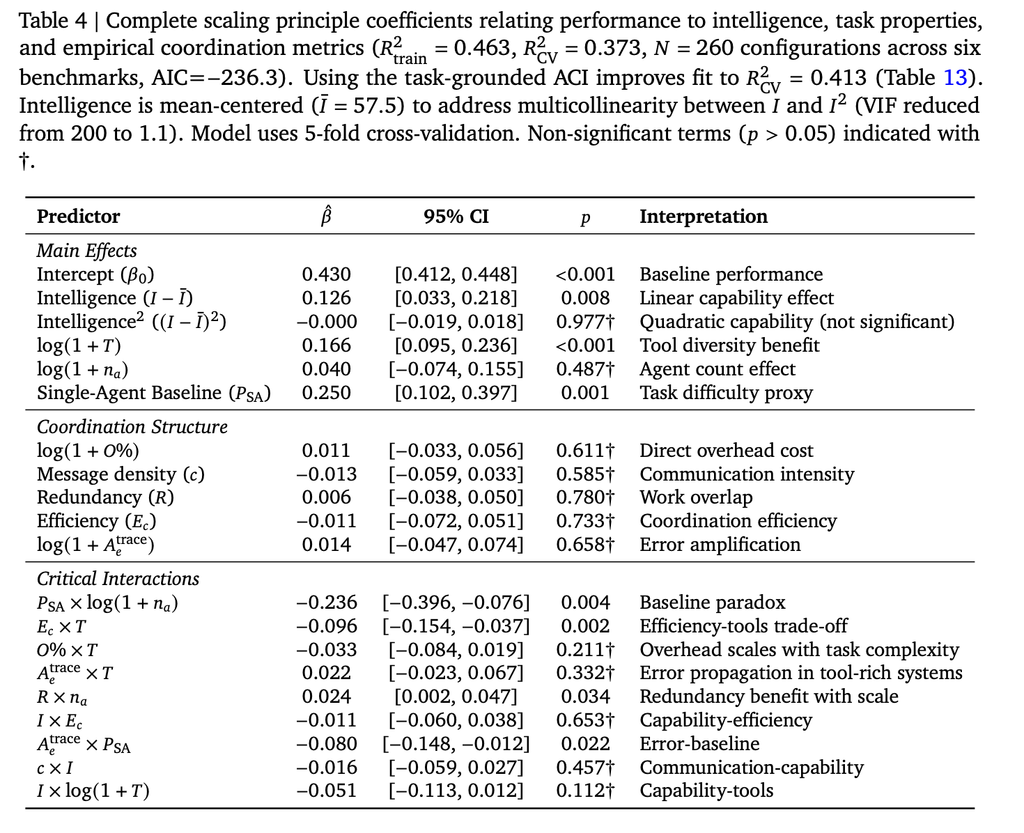
저자는 Table 4에서 Scaling Model의 회귀 계수를 제시하며, 그중 세 가지 주요 현상에 주목합니다.
첫 번째는 Capability Saturation입니다.
Table 4에서 Single-Agent Baseline과 Agent Count 사이의 Interaction은 β=-0.236, p=0.004로 나타났습니다. 이는 SAS의 성능이 높아질수록 에이전트를 추가했을 때 얻을 수 있는 이득이 감소하는 경향을 의미합니다.
특히 저자는 SAS의 정확도가 약 45%를 초과하면 MAS가 오히려 성능을 저하시키는 경향을 확인했습니다. 이미 하나의 에이전트가 충분히 높은 성능을 보인다면, 추가적인 에이전트로 얻을 수 있는 이득보다 협업에 필요한 비용이 더 커질 수 있다는 것이죠.
이러한 결과는 앞서 SWE-bench Verified에서 모든 MAS 구조가 SAS보다 낮은 성능을 보였던 현상과도 연결됩니다. 다만 45%라는 수치는 이번 실험에서 도출된 경험적인 기준으로, 모든 태스크에 동일하게 적용할 수 있는 절대적인 임계값은 아닙니다.
두 번째는 Efficiency-Tools Trade-off입니다.
Table 4에서 Coordination Efficiency와 Tool Count의 Interaction은 β=-0.096, p=0.002로 나타났습니다. 저자는 이를 Tool이 많은 환경에서 MAS의 협업 비용이 성능에 더 불리하게 작용하는 경향으로 해석합니다.
예를 들어 Workbench처럼 다양한 Tool을 사용하는 태스크에서는 각 에이전트가 Tool을 실행하는 것뿐 아니라, 그 결과를 다른 에이전트와 공유하고 이후 작업을 조정하는 과정이 필요합니다. 전체 Compute Budget이 고정되어 있다면 이러한 협업 과정에 사용하는 자원만큼 실제 추론에 사용할 수 있는 자원도 줄어들게 됩니다.
결국 태스크가 복잡하다고 해서 여러 에이전트를 사용하는 것이 반드시 유리한 것은 아니라는 이야기입니다. 다만 Finance-Agent처럼 여러 하위 작업으로 분해할 수 있는 경우에는 MAS가 큰 성능 향상을 보였기 때문에, Tool의 수와 함께 태스크의 Decomposability도 고려해야 합니다.
세 번째는 Coordination Overhead와 Error Amplification입니다.
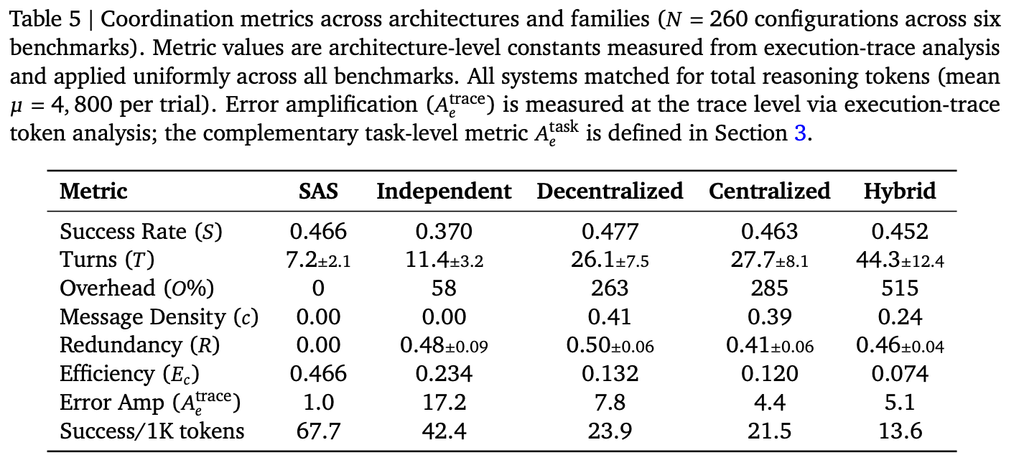
이 부분은 Table 5에서 아키텍처별 Coordination Metric을 비교하면 쉽게 이해할 수 있습니다.
먼저 SAS의 평균 Reasoning Turn은 7.2회였지만, Centralized와 Decentralized에서는 각각 27.7회와 26.1회로 증가했습니다. 특히 Hybrid는 평균 44.3회로, SAS보다 약 6.2배 많은 Turn을 사용했습니다.
그런데 이렇게 많은 상호작용이 반드시 성능 향상으로 이어지는 것은 아니었습니다. 실제로 Hybrid는 가장 높은 Overhead인 515%를 기록했지만, Coordination Efficiency는 0.074로 가장 낮았습니다.
오류 전파에서도 아키텍처에 따른 차이가 나타났습니다. Independent의 Trace-Level Error Amplification은 17.2배였지만, Centralized에서는 4.4배로 감소했습니다. 저자는 이를 Orchestrator의 검증 과정이 개별 에이전트의 오류가 다른 에이전트로 전파되는 것을 줄여주기 때문이라고 설명합니다.
다만 Table 4의 회귀 분석에서는 Error Amplification 자체의 독립적인 효과가 통계적으로 유의하지 않았습니다. 따라서 오류 증폭이 아키텍처마다 다르다는 것은 확인할 수 있지만, 이것만으로 전체 성능 차이를 설명하기는 어렵습니다.
결국 저자가 강조하는 것은 MAS에서 중요한 것은 얼마나 많은 에이전트가 협업하는지가 아니라, 협업을 통해 얻는 이득이 추가적인 비용보다 큰지라는 점입니다.
3.4. Architecture Selection and Robustness
앞에서는 모델의 능력과 태스크의 특성, 협업 비용이 MAS의 성능에 어떤 영향을 미치는지 살펴봤습니다. 그렇다면 이러한 Scaling Principle을 실제로 활용하여 주어진 태스크에 가장 적합한 아키텍처를 선택할 수 있을까요?
저자는 Table 4의 회귀 모델과 Table 5의 아키텍처별 Coordination Metric을 이용하여 각 구조의 예상 성능을 계산합니다.
예를 들어 Single-Agent Baseline이 높고 순차적인 추론이 필요한 Planning Task에서는 SAS가 유리한 반면, 여러 하위 문제로 분해할 수 있는 Analysis Task에서는 Centralized 구조가 효과적일 수 있습니다. 또한 Tool이 많은 환경에서도 작업의 병렬화 가능성과 협업 효율에 따라 Decentralized 구조가 더 좋은 선택이 될 수 있습니다.
저자는 이러한 방식으로 학습에 사용하지 않은 설정에서 87%의 비율로 가장 높은 성능을 보이는 아키텍처를 예측했습니다. 이는 무작위 선택의 20%나 모델의 추론 능력만을 활용한 방식의 54%보다 높은 결과입니다.
여기서 중요한 점은 제안한 Scaling Model이 단순히 성능 변화를 설명하는 데 그치지 않고, 어떤 아키텍처를 선택해야 하는지 판단하는 데에도 활용될 수 있다는 것입니다.
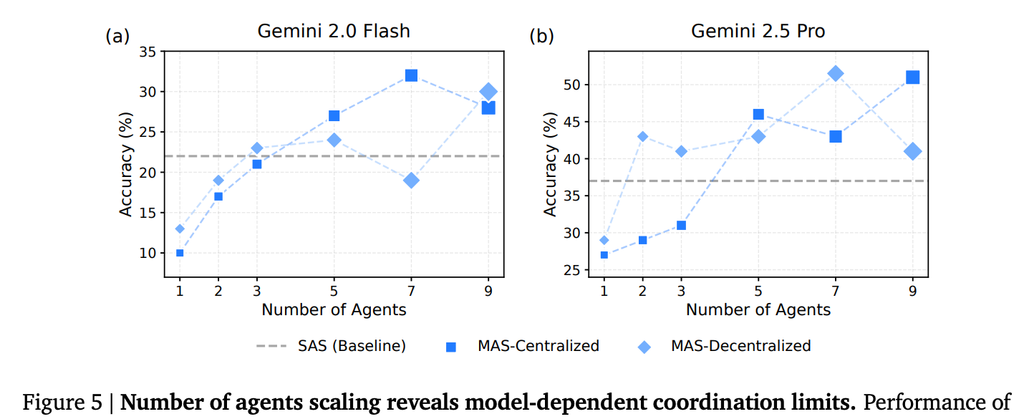
이와 관련해 Figure 5에서는 에이전트 수에 따른 성능 변화를 추가로 보여줍니다. Gemini 2.0 Flash와 Gemini 2.5 Pro를 대상으로 에이전트 수를 1개에서 9개까지 늘리며 비교한 결과, 초기에는 MAS의 성능이 향상되지만 일정 수준을 넘어서면 오히려 감소하는 경향이 나타났습니다.
특히 Gemini 2.0 Flash는 7개 에이전트 부근에서 가장 좋은 성능을 보인 반면, Gemini 2.5 Pro는 Decentralized 구조에서 더 적은 수의 에이전트로 성능이 포화되는 경향을 보였습니다.
이는 최적의 에이전트 수 역시 모델의 능력과 Coordination Structure에 따라 달라질 수 있다는 점을 보여줍니다. 단순히 에이전트를 많이 추가하는 것보다 적절한 수를 선택하는 것이 중요하다는 이야기입니다.
마지막으로 저자는 제안한 Scaling Principle이 얼마나 안정적인지 확인하기 위해 추가적인 Robustness Analysis를 수행합니다.
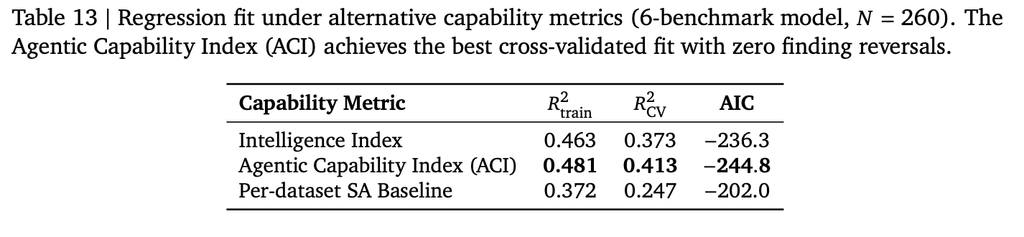
먼저 Table 13에서는 Intelligence Index 대신 실제 Agentic Task의 SAS 성능을 기반으로 정의한 ACI를 사용했을 때의 결과를 비교합니다. 두 지표의 상관계수는 r=0.45로 나타났으며, ACI를 사용했을 때 교차 검증 R²가 0.373에서 0.413으로 증가했습니다. 이는 일반적인 LLM Benchmark에서 높은 성능을 보이는 모델이 실제 Agentic Task에서도 반드시 동일한 수준의 능력을 발휘하는 것은 아니라는 점을 보여줍니다. 저자는 이러한 이유로 에이전트 시스템의 성능을 예측할 때 ACI가 더 적합한 지표라고 주장합니다.
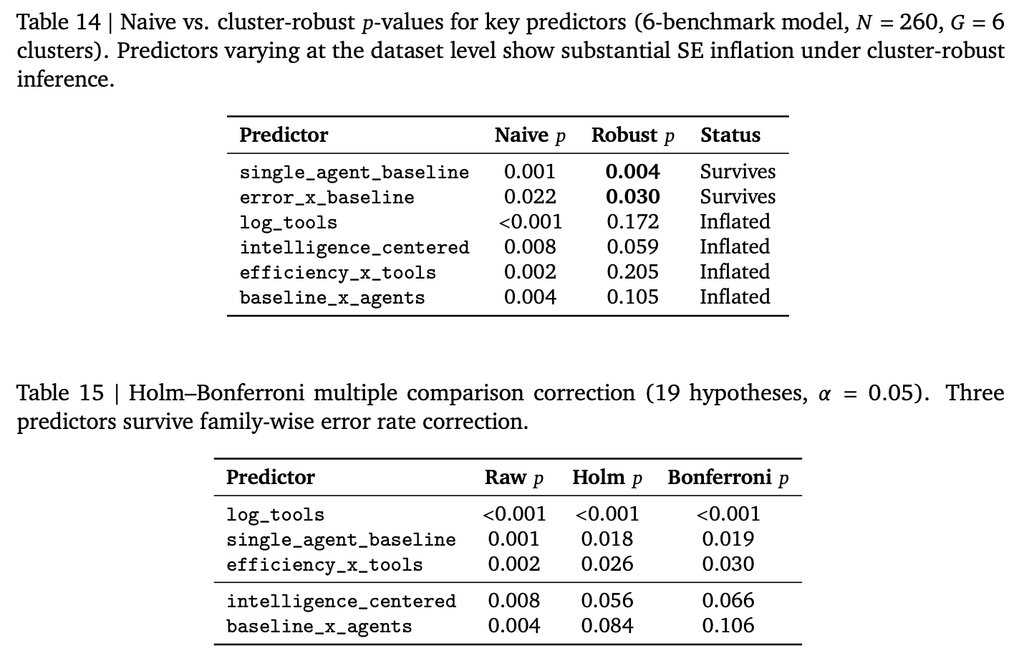
다음으로 Table 14와 Table 15에서는 통계적 검증 방법을 변경했을 때도 주요 Scaling Pattern이 유지되는지 분석합니다.
그 결과, 여러 검증 조건에서 가장 안정적으로 확인된 것은 Single-Agent의 성능이 높아질수록 MAS의 추가적인 이득이 감소한다는 Capability Saturation 현상이었습니다.
반면 Efficiency-Tools Trade-off와 같은 일부 결과는 다중 비교 보정에서는 유의했지만, 데이터셋 단위의 의존성을 고려한 Cluster-Robust Analysis에서는 통계적 유의성이 약해졌습니다.
따라서 모든 Scaling Pattern을 보편적인 법칙으로 받아들이기보다는, 실험에서 확인된 경향과 통계적으로 강하게 뒷받침되는 결과를 구분해서 이해할 필요가 있습니다.
또한 앞서 보고한 87%의 아키텍처 선택 정확도 역시 기존 벤치마크 내에서 검증한 결과이기 때문에, 완전히 새로운 도메인에서도 동일한 예측 성능을 보장한다고 보기는 어렵습니다.
결국 이번 실험에서 저자가 보여주고자 하는 것은 에이전트 시스템을 설계할 때 반드시 MAS를 사용해야 하는 것은 아니며, 태스크의 특성과 모델의 성능에 따라 적절한 구조를 선택해야 한다는 점입니다.
특히 이번 연구에서 가장 설득력 있게 확인된 것은 Capability Saturation이며, 이를 바탕으로 MAS의 필요성을 먼저 판단하고 협업 구조를 선택하는 접근이 중요하다고 볼 수 있습니다.
기존 MAS 연구들이 주로 새로운 협업 구조를 설계하여 성능을 향상시키는 데 집중했다면, 이 연구는 어떤 상황에서 협업이 실제로 필요한지 정량적으로 분석하고, 그 결과를 아키텍처 선택으로 연결했다는 점에서 의미가 있다는 생각이 드네요.
감사합니다.