안녕하세요 강희승입니다.
오늘 소개드릴 논문은 CLIP의 text/visual encoder가 각각 first mentioned object, larger object에 대해 bias를 가지고 있고, 해당 bias가 어디서 기원한 것인지 연구한 논문입니다.
Compositionality를 주제로 보조 연구에 참여 중인데, 각 encoder에 bias가 있다는 분석이 흥미로워 읽게 되었습니다.
Motivation
CLIP의 성공
CLIP의 성공으로 image retrieval, VQA, text-to-image generation 등 다양한 application, task에 적용되기 시작하였습니다. 더 나아가 MLLM과 같은 Multimodal understanding이 필요한 application에도 주로 활용됩니다.
CLIP의 한계
하지만, 이런 VLM의 성공에도 여러 다양한 객체들과 그들의 관계들을 나타내는 복잡한 scene을 이해하고 reasoning하는 것을 어려워 합니다. 특히 caption에 동일한 객체지만 다른 관계를 가지고 있는 경우, 모델이 서로 다른 객체 간의 관계를 정확하게 인지하는 것을 잘 못합니다. 최근에는 이러한 현상을 Compositional Binding, Compositionality 등으로 부르며, 객체들의 세밀한 관계를 필요로 합니다.
대부분의 Compositionality 연구에서 모델이 다중 객체 시나리오에서 잘 작동하지 않는다는 점을 다루며, 성능을 향상시키기 위해 negative sample들을 기반한 fine-tuning과 같은 end-to-end 기법들을 소개하곤 하였습니다. 해당 접근들은 최소한의 구조적 조정만으로 의미적으로 차이를 보이는 Negative sample들을 생성하였습니다. 예를 들어, Caption내의 Object, Attribute 등을 다른 것으로 대체하거나, 순서를 바꾸는 등 완전히 다른 의미를 가지는 Caption을 생성하는 것이 아닌, 작은 변화를 통해 Negative sample을 생성합니다.
분석 방향성
하지만 이러한 접근들은 Positive caption과 의미적으로 동일하지만 구조적으로 다른 caption에 모델이 취약한 문제를 해결하지 못합니다. 따라서 저자들은 CLIP의 한계점을 의미적으로 다른 caption을 구분하는 것에 초점으로 두지 않고, 의미적으로 동일하나 구조적으로 다른 caption들에 대해 분석하고자 하였습니다. 저자들은 특히 모델이 언어적, 시각적 변화에 취약하며 특정 bias를 보인다는 점을 주목하고, 이에 대한 근본적인 원인을 분석하고자 하였습니다. 이러한 접근은 모델의 잠재된 language, visual bias가 모델 시스템적 원인을 깊게 분석할 수 있게 하였습니다.
Contribution
저자들은 5가지 findings & contribution을 해당 논문을 통해 보였습니다.
- Development of Novel Dataset 저자들은 분석을 위해 다중 객체 시나리오를 보이는 합성 데이터셋을 구성하였습니다. 이를 통해 VLM의 Compositionality에 대한 취약점을 주변 변수들과 분리하여 분석할 수 있도록 하였습니다.
- Encoder Analysis 다중 객체 시나리오에 대해 CLIP의 각 visual,text encoder에 대해 in-depth examination을 수행하여 VLM이 어떤 지점에서 Compositional information이 손실되는지 분석하고자 하였습니다.
- Bias Identification CLIP의 image encoder는 larger object를, text encoder는 first-mentioned object를 선호하는 경향을 있음을 보였습니다.
- Investigation of Bias Origins 저자들은 위 bias를 단순히 관찰한 것이 아닌, 어디서 기원한 것인지 분석하고자 하였으며, Lager object들의 대부분은 CLIP의 training caption에서 first-mentioned 된다는 것을 보였습니다. 또한, 구조적으로 Lager object가 많은 visual token에 나타남을 보였습니다.
- Practical impact 합성 데이터에서 뿐 아니라 COCO와 같은 Natural data에서도 동일한 현상이 나타남을 보였으며, 더 나아가 text-to-image model 까지 영향이 확산된다는 것을 보였습니다.
Methodology
1. Dataset Design
간단하게 ComCO 합성 데이터셋을 어떻게 구성했는지 짚고 넘어가겠습니다. 앞서 설명한 것처럼, 저자가 확인하고자 하는 주장을 보이기 위해 조건들을 통제하였고 이와 같은 데이터셋을 구성했다고 합니다.
저자들은 Blender software(3D 모델링, 그래픽 제작 등을 가능하게 하는 오픈소스 소프트웨어)를 활용하여 Object의 수, 위치, 차원을 완벽히 통제할 수 있었다고 합니다. Object는 COCO dataset의 72가지 objects를 활용하였으며, 한 이미지 내에는 2~5개의 object를 포함합니다.
T2I model을 활용해서 충분히 데이터셋을 구축할 수 있었는데, 굳이 이와 같이 구축한 이유를 두가지 제시합니다. 첫번째, 생성 모델은 조건들을 완벽히 통제한 다중 객체 이미지의 quality의 일관성을 보장하지 않기 때문입니다. 두번째, 생성 모델의 대부분이 CLIP을 사용하기 때문에, 의도치 않은 bias가 섞여 공정하지 못한 평가로 이어질 수 있다고 판단했기 때문입니다.
2. Experimental Framework for Encoder Analysis
이 실험에서 주요 목표는 text 와 image encoder를 다중 객체 시나리오 대해 완벽히 분리해서 성능을 평가하는 것입니다. 즉, 결과론적 관점에서의 bias를 분석하는 것이 아닌 encoder-side에서 분석하고자 한 것입니다.
TOR ; Text-based Object Retrieval
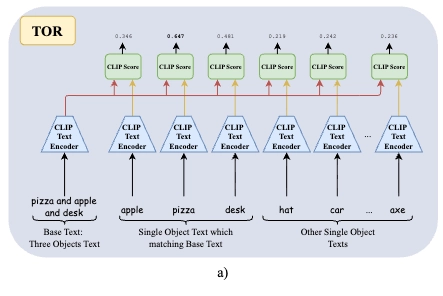
다중 객체 caption과 단일 객체 caption에 대해 각각 encoding합니다. 이때 단일 객체 caption이란, 다중 객체 caption 내의 단일 객체를 뜻하는 caption을 의미합니다. (e.g. 다중 객체 – There are triangles, Squares and Circles, 단일 객체 – triangles , circles , squares ) 이후 Embedding 간 유사도를 계산하여, 가장 높은 유사도 값을 가지는 single-object를 ‘retrieved-object’로 간주합니다. Object Position(e.g. first, last)에 따른 bias를 분석하기 위해, Caption 내에서 single-object의 위치에 따른 retrieval accuracy를 계산합니다.
IOR ; Image-based Object Retrieval
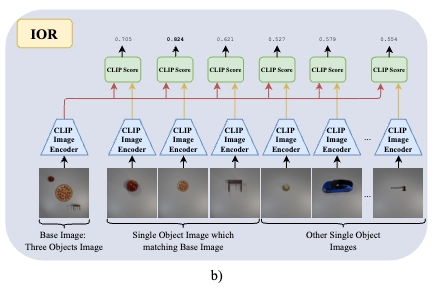
TOR과 동일하게, image에 대해서도 다중 객체를 포함하는 전체 이미지와, 단일 객체를 crop하여 각각을 encoding합니다. 이후 유사도를 계산하고, 가장 높은 유사도 값을 가지는 single-object를 ‘retrieved-object’로 간주합니다. 다만, IOR의 경우 object size(e.g. large, small)에 따른 bias를 분석하기 위해 객체 크기를 기준으로 rertrieval accuracy를 계산합니다.
Results and Analysis
Text Encoder Biases
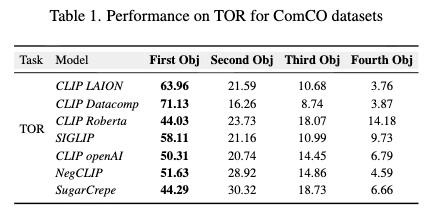
Table 1에서 볼 수 있듯, First Object를 Retrieval할 때는 높은 성능을 보이는 반면, 이후의 object를 retrieval할 시 급격한 성능 drop을 보입니다. 저자는 text encoder가 초기 객체에 biased 되어있고 이는 전체 text representation에 영향을 주고 있다고 해석합니다. 즉, 첫번째 object의 신호가 전체 representation에 지배적인 영향을 주고 있기 때문에, 다른 객체들을 retrieval을 할 시 명확한 신호를 포착하지 못하다는 것입니다.
Image Encoder Biases
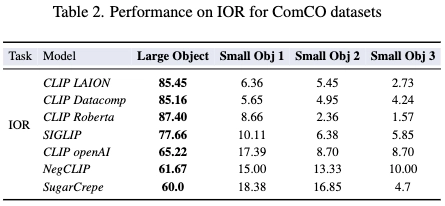
객체 크기에 따른 image encoder bias gap은 text encoder보다 더 큽니다. Table2에서 볼 수 있듯, Large object를 retrieval할 시 높은 성능을 보이는 반면, 작은 객체를 retrieval할 시 급격한 성능 drop을 보이며, 성능 차이는 text encoder 보다 더 큽니다. 저자들은 이에 대해 image encoder가 객체 크기에 따라 visual representation 형성에 미치는 신호가 불균혀적으로 large object에 강조 되어 있다고 해석합니다.
COCO dataset Experiments
Image,text encoder의 bias를 일반화 하기 위해 naturalistic setting에서도 동일한 bias가 나타나는지 COCO 데이터셋을 통해 보고자 하였습니다. 다만, IOR의 경우 단일 객체에 대한 이미지가 COCO 데이터셋에 없기 때문에, 두가지 방식을 통해 Retrieval을 수행하였습니다.
첫번째, DomainNet dataset의 단일 객체 이미지를 retrieval target으로 사용하였습니다.
두번째, Image-to-Text Object Retrieval(I2TOR), 즉 image 내의 object name을 통해 retrieval을 하였습니다.
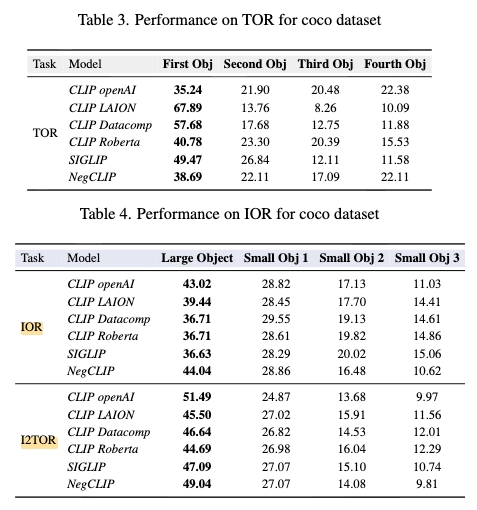
Tabel 3,4의 결과는 성능 gap이 어느정도 존재하지만, ComCO의 결과와 동일한 경향을 보입니다. 결과적으로 image, text encoder에서 보이는 bias는 비단, 조작된 조건에서만 보이는 현상이 아니라는 것을 알 수 있습니다.
Origin of Bias
Bias in the Image Encoder
저자들은 Image Encoder의 Large Object에 대한 bias가 ViT의 구조적인 특성에서 기인한다고 주장합니다. ViT는 image input에 대해 patch token으로 나누어 표현합니다. 따라서, 객체의 크기가 클수록 여러 patch token에서 나타날 것입니다. 이에 저자는 CLS representation에 더 많은 영향을 주었을 것이라고 주장합니다.
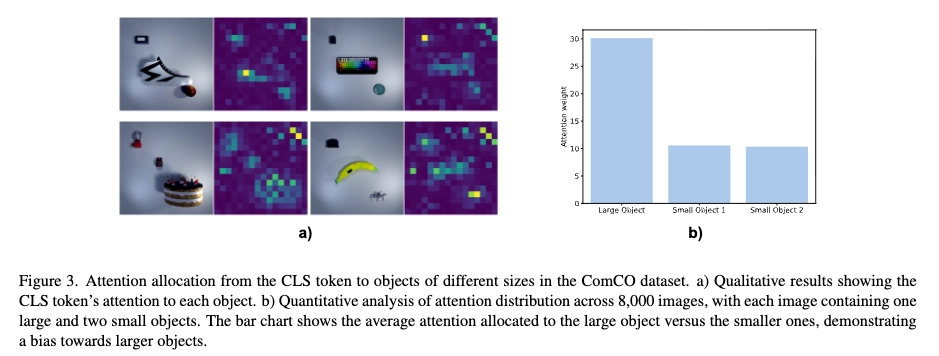
주장을 뒷받침하기 위해 Image CLS에 의한 Attention 위치를 시각화 하였고, CLS에 영향을 준 patch token의 수를 객체 크기 별로 집계하였습니다. Figure3에서 볼 수 있듯, 저자의 주장은 유효함을 알 수 있습니다.
Bias in the Text encoder
Text Encoder에 대해서 저자는 Attention mechanism과 Training Method로 분리하여 분석하였습니다.
Impact of Attention Mechanism
Text encoder의 Mechanism은 Uni-directional (causal) attention과 Bi-directional attention으로 크게 두가지로 나눌 수 있습니다. 단방향의 경우 현재 token 이전의 token만 참조할 수 있고, 양방향의 경우 모든 token을 참조할 수 있다는 차이가 있습니다.
CLIP의 경우 causal attention을 적용하였기 때문에, 만약 단방향 attention이 모든 token을 참조할 수 없기 때문에 생기는 bias인지 확인하고자 하였습니다. 하지만, Table1에서 양방향 text encoder를 적용한 CLIP XLM-Roberta 모델에도 동일한 bias를 보이기 때문에, 저자는 Attention Mechanism에서 기인한 문제가 아니라고 해석합니다.
Role of Training Method
그렇다면, 해당 bias가 CLIP의 variation의 차이가 아니라 CLIP 자체의 문제일 수 있으니, image와 공유하는 공간이 아닌 text 고유의 semantic space로 embed하는 모델과 비교 하였습니다. (SBERT, SimCSE)
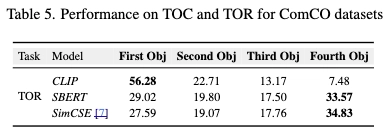
Table 5의 결과는 기존과 완전히 반대되는 경향을 보였습니다. 이에 저자는 CLIP의 training method;Contrastive learning 이 image와 text를 shared embedding space로 정렬하는 과정에서 생기는 bias라고 해석합니다.
Hypothesized Origin of Text-Side Bias in CLIP
저자는 text-side의 bias가 image side의 bias에서 전이되었다고 가설을 세웁니다. 해당 가설은 두가지 주요 주장과 분석으로 증명합니다.
Claim 1 : 큰 객체일 수록 text embedding에 더 큰 영향을 준다.
저자의 Text embedding이 Contrastive learning을 통해 학습하는 과정에서 Image 내의 큰 객체에 영향을 받았을 것이라고 주장합니다.
이를 확인하기 위해 먼저 객체 크기의 기준을 정합니다.
- Large — 자동차 크기보다 큰 경우
- Medium — 자동차보단 작고 책가방보다 큰 경우
- Small — 책가방보다 작은 경우
이후, 4개의 object를 포함하는 2가지 그룹의 caption을 구성합니다.
- Group 1 — Large Object를 가장 먼저 언급하고 Medium Object 3개를 언급
- Group 2 — Small Object를 가장 먼저 언급하고 Medium Object 3개를 언급
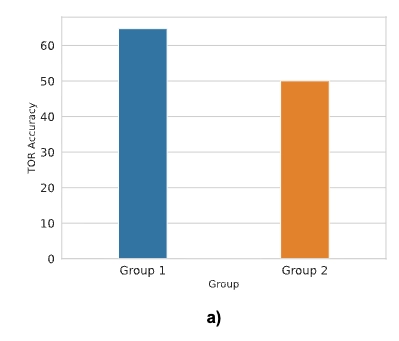
해당 결과를 통해 large object가 먼저 언급되었을 때, 더 높은 성능을 보이는 것을 알 수 있습니다. 즉, Larger Object가 text embedding 구축에 더 큰 영향을 준다고 해석할 수 있습니다.
Claim 2 : Training Dataset에 존재하는 Caption Bias
학습 데이터에 존재하는 잠재 bias를 조사하기 위해, COCO와 LAION 데이터를 모두 분석하였습니다. LLaMA3 model을 활용하여, Caption 내의 Object를 추출하였습니다. 이후 Language Segment Anything tool을 통해 image mask를 생성하여 영역을 계산하였습니다.
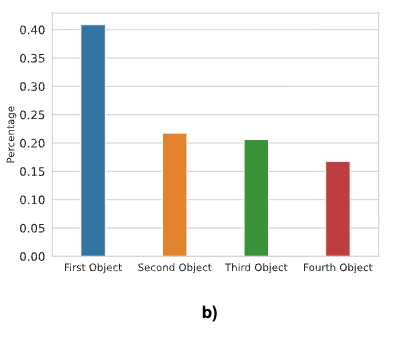
해당 결과는 Large object가 나타나는 caption 상 위치를 집계한 것입니다. First Object에 Large Object가 약 40% 정도의 caption에서 나타나는 것을 확인할 수 있습니다. 결과적으로 Large Object에 대한 bias는 시각적인 도드라짐(크기가 커서)뿐 아니라, text annotation의 위치 상 가장 먼저 나타났기 때문에 발생했다고 할 수 있습니다.
Bias Development During Training
더 나아가 저자는 해당 text-side bias가 언제 발생하는지 조사하였습니다. CLIP의 [2,4,6,8,10] stage checkpoint를 활용하여 각 step에서의 TOR를 측정하였습니다.
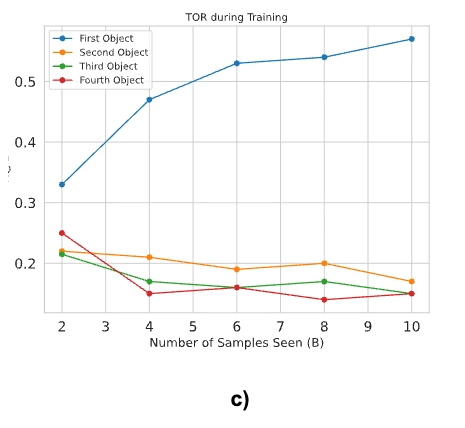
학습을 점차 거치면서, text-side의 First Object Bias가 강해지는 것을 확인할 수 있습니다. 이를 image-side bias가 contrastive learning을 통해 학습하는 과정에서 text-side로 전이되고, 해당 영향들이 누적된 결과라고 저자는 해석합니다.
Practical Impact of Encoder Biases
저자들이 관측한 Bias들은 CLIP에서만의 문제는 아니라고 보고합니다. CLIP은 다양한 application에서 활용되기 때문에 Bias가 전이 되어 application에 상당한 영향을 미칠 것이라고 주장합니다.
Image-Text Matching
저자들은 Image-Text Matching에서 이론적 bias가 실제 한계로 어떻게 이어지는지 구체적인 뒷받침 근거를 확인하고자 하였습니다.
이때, ComCO와 COCO dataset을 활용하였으며, 두가지 시나리오를 caption으로 구성하여 iamge-to-text matching caption 후보를 생성하였습니다. COCO의 경우 GPT-4O 모델을 활용하여 caption을 재작성하였습니다.
First Scenario
첫번째 시나리오에서는 Bias가 모델의 구분 능력에 도움을 줍니다. Correct caption의 경우 Largest Object가 가장 먼저 언급되며, 이는 모델의 bias와 잘 맞는 경우 입니다. 또한, incorrect caption의 경우 존재하지 않는 객체를 의도적으로 가장 먼저 언급하여, 모델로 하여금 Correct과 Incorrect를 잘 구분할 수 있도록 설계하였습니다.
Second Scenario
두번째 시나리오는 Bias가 모델이 error를 내도록 유도합니다. Correct caption의 경우 Largest Object가 가장 마지막에 나타나며, 이는 bias와 맞지 않는 경우입니다. Incorrect caption의 경우 존재하지 않는 객체를 가장 마지막에 언급하여 모델이 쉽게 인지하지 못하도록 설계하였습니다.
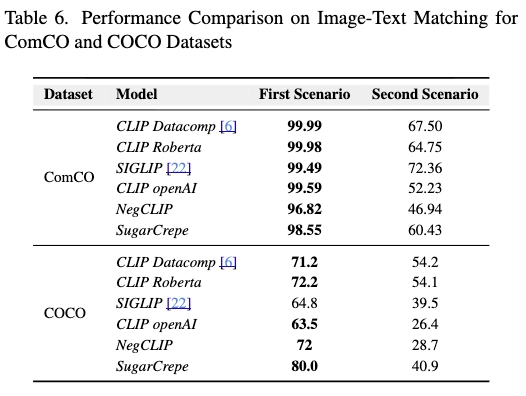
First Scenario에서는 안정적으로 높은 성능을 보이는 것을 활인할 수 있지만, Second Scenario에서는 안정적인 성능을 보이지 못하며, COCO의 경우 대부분 랜덤 성능(50%) 이하의 성능을 보입니다.
결과적으로 관측된 bias는 모델의 성능에 도움이 될 수도, 해가 될 수도 있음을 암시합니다. 이는 비단 합성 데이터뿐 아니라, COCO에서도 보이는 경향으로 real-world scenario에서 강건한 성능을 위해 반드시 다뤄야할 문제라고 저자는 주장합니다.
Conclusion
저자들은 기존의 Negative Sample 들을 만들어 학습시키는 방법들에서 벗어나, Text Encoder는 First Mentioned Object에, Vision Encoder는 Large Object에 Bias를 가진다는 것을 보였습니다.
최근 Naive하게 Text Representation이 Compositionality에 미치는 영향들이 어떤지 생각하던 와중, 해당 논문을 접하게 되어 흥미롭게 읽었습니다. 해당 논문의 분석처럼, ‘Compositionality’ 관점에서 ‘text embedding이 Attribute보다 Object에 Bias되어 있을 수도 있지 않을까’ 등 여러 생각들이 들었습니다.
다만, 최근 MLLM의 기술적 도약으로 인해, CLIP의 weakness를 MLLM에서는 극복하는 모습을 종종 관찰할 수 있습니다. 해당 논문의 ‘Practical Impact section’에서 MLLM에서의 경향도 보여줬으면 더 좋았지 않을까라는 생각도 들긴합니다. 이런 관점에서 이제는 CLIP의 취약점을 분석하는 것에 그치지 않고, 해당 논문의 CLIP encoder의 bias나, 보조 연구 주제 ‘Compositionality’가 MLLM에 어떤 영향을 미치는 지 고려하는 것도 중요할 것 같습니다.
읽어주셔서 감사합니다.


