- Venue: COLM 2026
- Authors: Akshay Paruchuri, Ishan Chatterjee, Henry Fuchs, Ehsan Adeli, Piotr Didyk
- Affiliation: Universit`a della Svizzera italiana, University of Washington, UNC Chapel Hill, Stanford University
- Title: The Cost of Language: Centroid Erasure Exposes and Exploits Modal Competition in Multimodal Language Models
1. MLLM은 이미지를 얼마나 보고 있을까?
다들 아시겠지만, MLLM은 이미지와 텍스트를 함께 입력받아 질문에 답합니다. 그런데 이미지를 입력받는다는 것이, 시각 정보를 충분히 활용한다는 뜻일까요?
기존 연구에서는 문제를 푸는 데 필요한 정보가 vision encoder에 존재해도, LLM backbone이 이를 충분히 활용하지 못할 수 있다 알려졌는데요. 저자들은 이러한 현상을 텍스트에 대한 높은 의존성과 연결하며 이런 의문을 가졌습니다: 시각 토큰과 텍스트 토큰의 세부 정보를 각각 지워보면, 어느 쪽에서 성능이 더 크게 떨어질까?
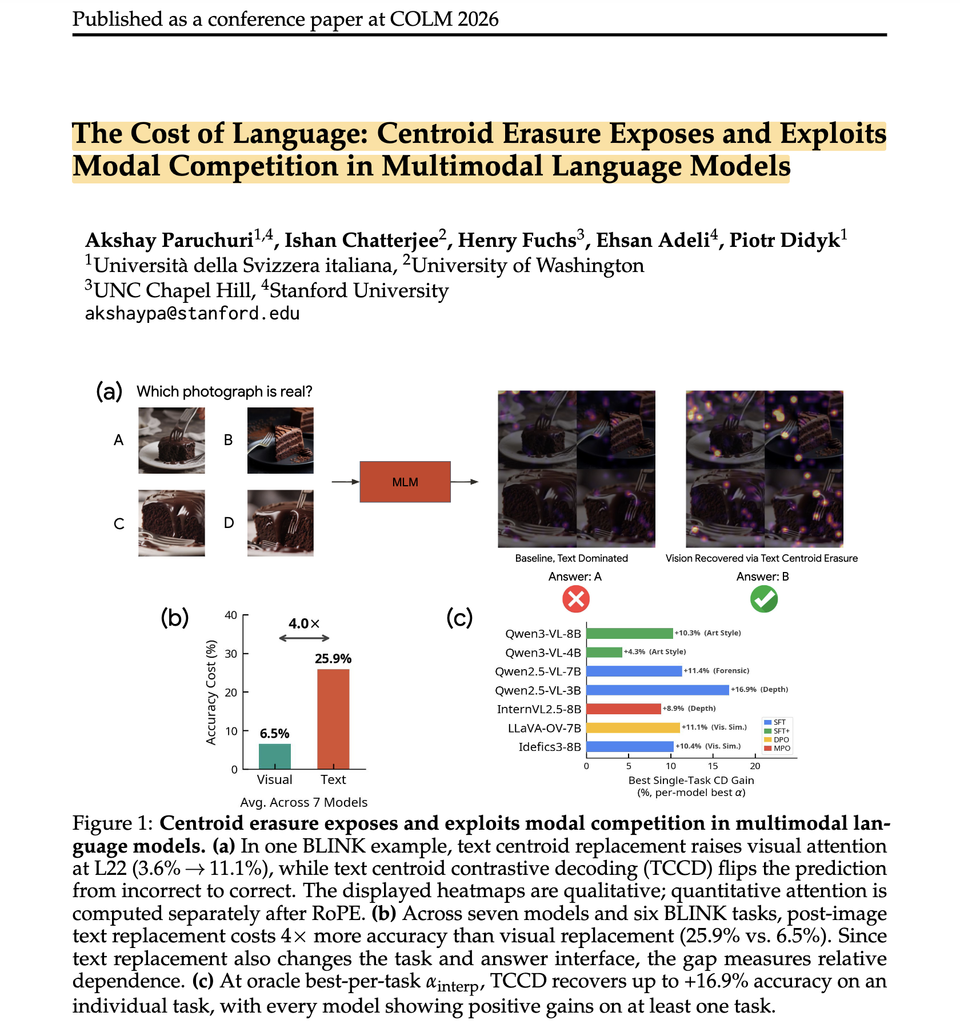
이를 확인하기 위해 저자들은 centroid replacement를 제안했습니다. K-means 같이 비슷한 토큰들을 묶고 각 토큰을 그룹의 대표값으로 바꾸어, 대략적인 구조는 남기면서 세부 차이를 지우는 방식입니다.
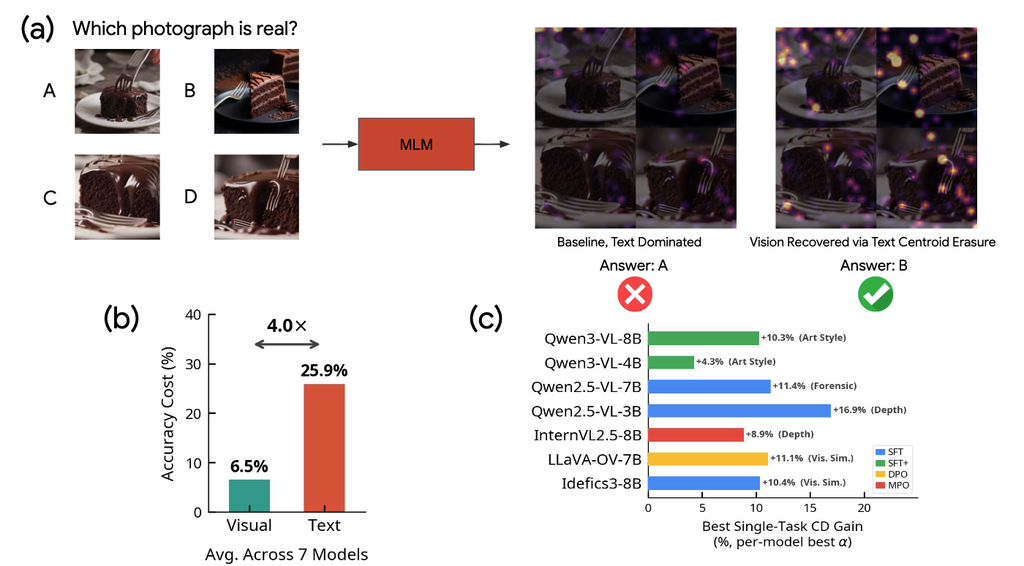
그 결과, 상단 그림 중 (b)를 보면 7개 모델에서 시각 표현을 교체했을 때는 평균 6.5%p, 텍스트 표현을 교체했을 때는 25.9%p의 정확도 하락이 보였습니다. 약 4배의 차이죠.
다만 텍스트에는 질문과 선택지도 포함되므로, 이 차이를 곧바로 해로운 언어 편향의 증거라고 단정할 수는 없습니다. 이 논문은 이러한 모달리티 의존도 차이를 측정하고, 이를 재학습 없는 성능 개선에 활용할 수 있는지 살펴봅니다. 다음 장에서는 centroid replacement를 구체적으로 알아보겠습니다.
2. 토큰의 세부 정보를 지운다?
앞서 visual 표현과 text 표현을 각각 훼손했을 때, 모델의 성능이 얼마나 달라지는지 비교한다고 했죠. 그런데 토큰을 통째로 제거하면 입력 구조까지 바뀌기 때문에, centroid replacement라는 방법을 사용합니다.
먼저 모델의 중간 layer에서 hidden state를 추출하고, K-means로 비슷한 토큰들을 256개 그룹으로 묶습니다. 이때 centroid는 각 그룹을 대표하는 벡터입니다. Centroid를 만드는 데는 MS-COCO 이미지 2,000장을 사용하며, 평가 대상인 BLINK의 정답이나 평가 프롬프트는 사용하지 않습니다.
이제 각 토큰을 다음과 같이 나눌 수 잇습니다: x=\mu_k+(x-\mu_k)
여기서 \mu_k는 토큰과 가장 가까운 centroid이고, x-\mu_k는 해당 토큰이 대표값과 얼마나 다른지를 나타내는 residual입니다. 같은 그룹에 속한 토큰이라도 서로 다른 표현을 갖게 만드는 부분이겠죠? 이 residual을 줄이는 방식으로 토큰을 바꾸는 것입니다
- \alpha_{\mathrm{interp}}=1: 원래 토큰을 그대로 유지
- \alpha_{\mathrm{interp}}=0: centroid로 완전히 교체하여 그룹 내부 차이를 지움
- 0과 1 사이: 세부 정보를 일부만 남김
즉, 여기서 erasure는 이미지나 텍스트 전체를 삭제한다는 뜻이 아닙니다. 어느 그룹에 속하는지는 유지하면서, 그룹 안에서 각 토큰을 구분하는 차이를 제거하는 것입니다. 다만 centroid가 특정 객체나 의미에 정확히 대응한다고 보장되는 것은 아닙니다.
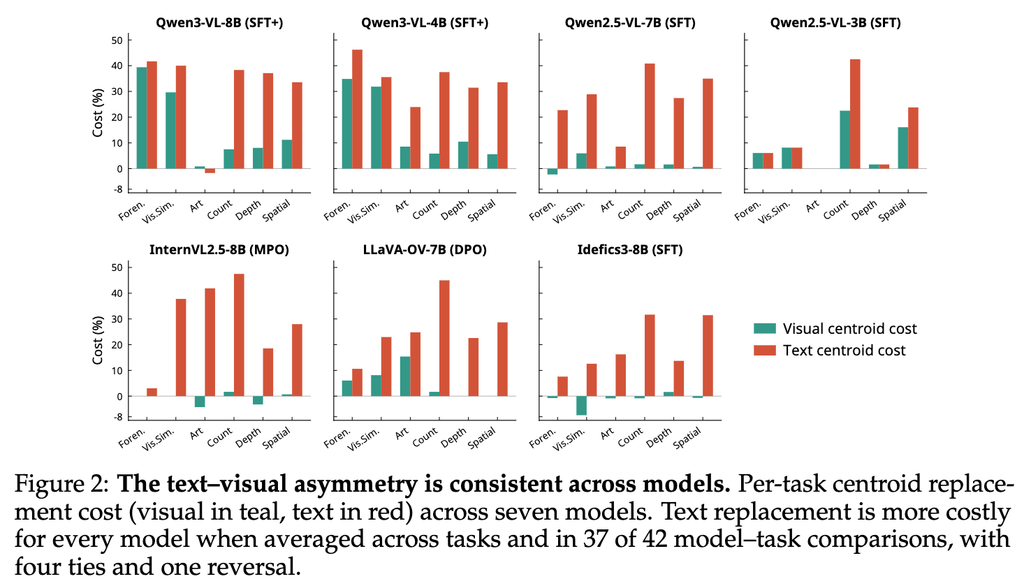
결과적으로 7개 모델 모두 텍스트 교체했을 때 영향이 더 컸고, 전체 42개 모델 중 37개에서도 같은 경향이 나타났습니다. 특히 Qwen2.5-VL-7B는 visual 토큰 교체 시 정확도가 1.4%만 떨어졌지만, 텍스트 교체 시에는 27.2% 씩이나 떨어졌습니다.
이 결과는 해당 중간층에서 모델의 판단이 visual 표현의 세부 차이보다 text 표현의 세부 차이에 더 민감하다는 것을 보여줍니다. (다만 교체한 layer가 서로 다르고, 텍스트에는 문제를 이해하는 데 필요한 정보도 포함되므로, 두 모달리티의 중요도를 완전히 공정하게 비교한 실험으로 보기는 어려워 보이긴 하네요)
그렇다면 이 의존도 차이를 분석하는 데서 그치지 않고, 실제 정답을 더 잘 고르는 데 활용할 수도 있을까요? 다음 장에서는 저자들이 제안한 Text Centroid Contrastive Decoding(TCCD)을 살펴보겠습니다.
3. Proposed Method: TCCD
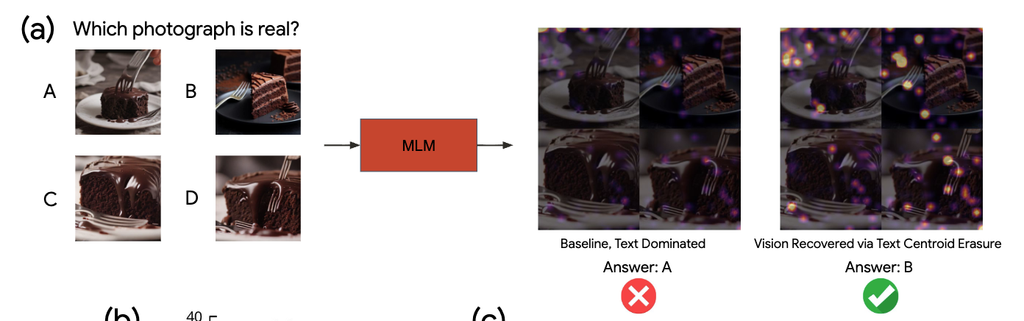
앞선 실험에서는 텍스트 표현의 세부 정보를 지웠을 때 성능이 크게 떨어졌습니다. 그런데 저자들은 이 훼손된 출력을 원래 출력과 비교하는 대조군으로 활용해보자고 제안합니다. 이것이 Text Centroid Contrastive Decoding(TCCD)입니다.
여기서 중요한 점은, 텍스트를 훼손한 모델의 답을 그대로 사용하는 것이 아니라는 겁니다. 원본 입력으로 얻은 예측과, 텍스트 표현을 일부 훼손해서 얻은 예측의 차이를 최종 판단에 반영하는 것이죠.
3.1 두 번의 Forward Pass
TCCD는 같은 이미지와 텍스트에 대해 두 번의 forward pass를 수행합니다.
- Original pass: 표현을 바꾸지 않고 원래 logits를 얻습니다.
- Replaced pass: L12에서 이미지 뒤의 텍스트 토큰을 centroid 방향으로 이동시킨 뒤, 별도의 logits를 얻습니다.
두 번째 pass에서도 visual 토큰은 직접 교체하지 않습니다. 또한 고정 설정에서는 \alpha_{\mathrm{interp}}=0.4를 사용하므로, 텍스트 residual을 완전히 지우지 않고 40% 남겨둡니다.
3.2 예측의 차이를 강조하기
이렇게 얻은 두 logits를 다음과 같이 결합합니다: z_{\mathrm{orig}} + \alpha_{\mathrm{cd}} \left(z_{\mathrm{orig}}-z_{\mathrm{replaced}}\right)
이렇게되면 논문의 주 설정인 \alpha_{\mathrm{cd}}=1 에서는 아래와 같이 단순해집니다.
z_{\mathrm{TCCD}}=2z_{\mathrm{orig}}-z_{\mathrm{replaced}} 즉, 텍스트를 훼손했을 때보다 원본에서 더 강하게 지지되는 답변을 강조하게 되죠
예를 들어 원본에서 선택지 A와 B의 점수가 각각 5와 4이고, 훼손된 pass에서는 둘 다 4라면, 최종 점수는 6과 4가 됩니다. 원본 표현을 유지했을 때 A를 더 지지했던 차이가 확대되게 됩니다
다만 이 차이가 곧바로 ‘순수한 visual 증거’를 의미하는 것은 아니라고 합니다. 텍스트 교체는 질문 이해와 이후의 멀티모달 처리에도 영향을 주기 때문에, TCCD가 무엇을 보정하는지는 실험으로 확인할 필요가 있죠
3.3 두 파라미터의 역할
다만 여기서 이름이 비슷해서 헷갈릴 수 있지만, 두 파라미터의 역할은 다릅니다.
- \alpha_{\mathrm{interp}} 대조군에 원래 텍스트 residual을 얼마나 남길지: 0.4
- \alpha_{\mathrm{cd}} 원본과 대조군의 예측 차이를 얼마나 강조할지: 1
조금 어렵게 설명한 것 같은데.. 정리하면 TCCD는 모델 가중치를 재학습하지 않고, 추론 단계에서 두 출력의 차이를 이용해 답변을 보정하는 방법입니다. (다만 centroid를 미리 만들어야 하고, 두 번의 forward pass가 필요하죠)
그렇다면 이 보정은 어떤 visual 문제에서 효과가 있을까요?
4. Experiments
저자들은 TCCD를 BLINK의 6개 visual understanding task에서 평가했습니다. 먼저 Qwen2.5-VL-7B의 결과를 살펴보겠습니다.
4.1 모든 visual task 에서 좋아질까?
결과를 보기 전에 두 가지 설정을 구분해야 합니다. Best-per-task는 평가 결과를 보고 각 task에서 가장 좋은 \alpha_{\mathrm{interp}}를 고른 oracle 결과입니다. 반면 Fixed는 모든 task에 동일하게 0.4를 적용한 결과입니다.
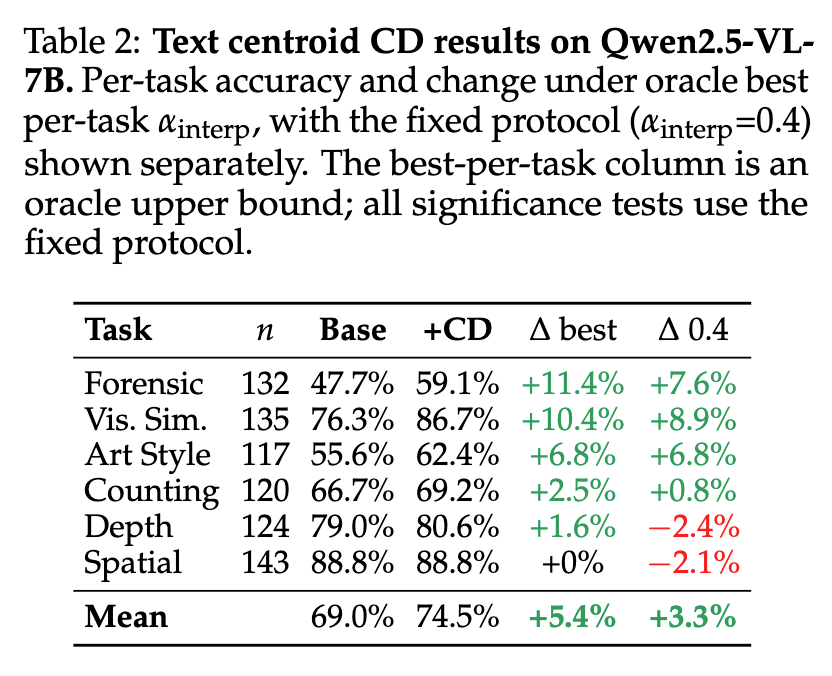
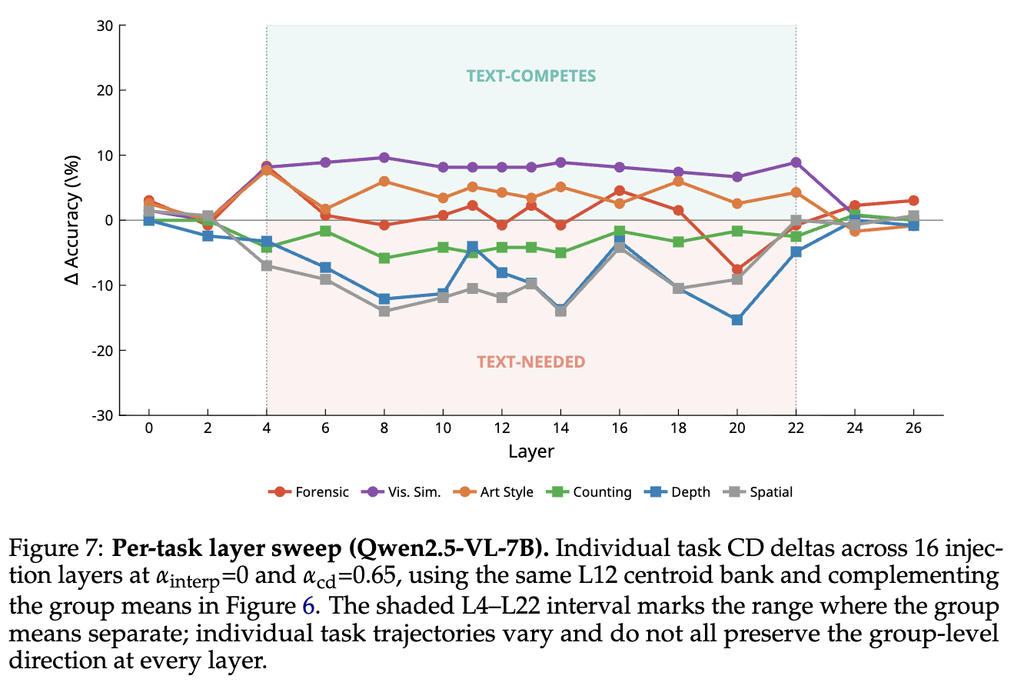
visual 유사성이나 예술 스타일 판단에서는 비교적 큰 향상을 가졌습니다. 반면 Counting에서는 효과가 작았고, 깊이와 공간 관계에서는 고정 설정으로 오히려 성능이 하락했습니다. Mean은 task 최적 설정에서 +5.4%, 고정 설정에서 +3.3%였습니다.
저자들은 앞의 세 과제를 text-competes, 뒤의 세 과제를 text-needed라고 부릅니다. 텍스트의 영향이 시각적 판단과 경쟁하는 경우와, 문제를 풀기 위해 텍스트 구조가 필요한 경우를 구분하려는 해석이죠.
4.2 단순히 출력을 바꾼 효과일까?
그렇다면 centroid 방향으로 표현을 바꾸는 것이 중요할까요? 아니면 아무 방향으로나 표현을 변경해도 비슷한 개선이 생길까요?
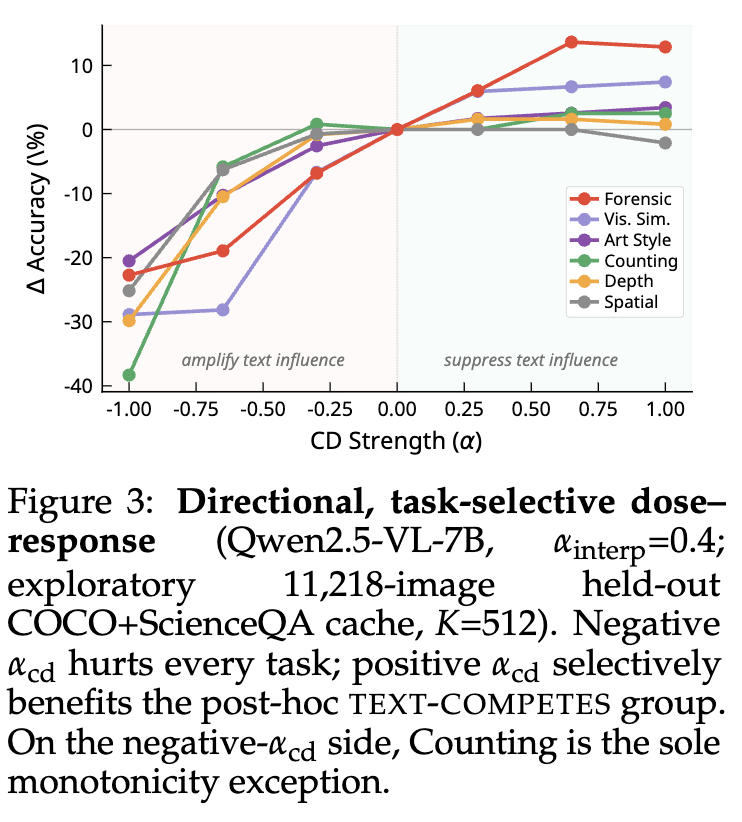
저자들은 이동 크기는 같지만 방향은 무작위인 대조군과 비교해보았습니다. 6개 task 에서 centroid 기반 TCCD는 +3.27%, 무작위 방향은 +0.4%의 개선을 보였습니다. 적어도 이 실험에서는 단순한 perturbation 크기만으로 TCCD의 효과를 설명하기 어려운 것이죠.
특히 상단 Figure 3에서는 대조군을 더 강조하는 음의 \alpha_{\mathrm{cd}}가 모든 과제의 성능을 떨어뜨리는 반면, 원본과 대조군의 차이를 강조하는 양의 방향은 일부 과제에 선택적으로 도움을 줍니다. 이는 방향에 따라 다른 효과가 나타난다는 근거지만, 정확한 보정 원리까지 증명하는 결과는 아닙니다.
4.3 기존 방법보다 좋은가?
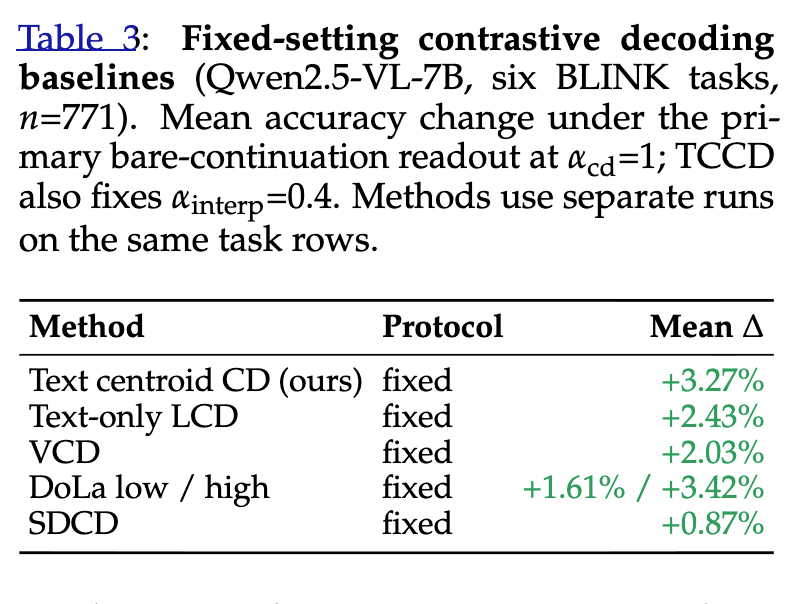
TCCD의 평균 개선은 +3.27%로, LCD(+2.43%), VCD(+2.03%), SDCD(+0.87%)보다 높았습니다. 다만 DoLa-high는 +3.42%로 조금 더 높았으므로, TCCD가 모든 비교 방법을 이겼다고 보기는 어려울 것 같습니다.
결국 실험에서 확인되는 것은 텍스트 표현을 교체한 대조군이 일부 visual task 에서 유용한 보정 신호를 제공한다는 점입니다. 모든 과제에 동일하게 적용할 수 있는 해결책이라기보다는, 어떤 모델과 문제에서 효과가 나타나는지를 함께 살펴봐야 하는 방법이겠네요.
5. Analysis
앞선 실험에서 TCCD는 일부 과제에 효과를 보였습니다. 그렇다면 이 결과는 특정 layer를 선택했기 때문에 나타난 것일까요? 개입 위치와 모델을 바꾸며 효과가 유지되는지 살펴보겠습니다
5.1 특정 Layer에서만 효과가 있을까?
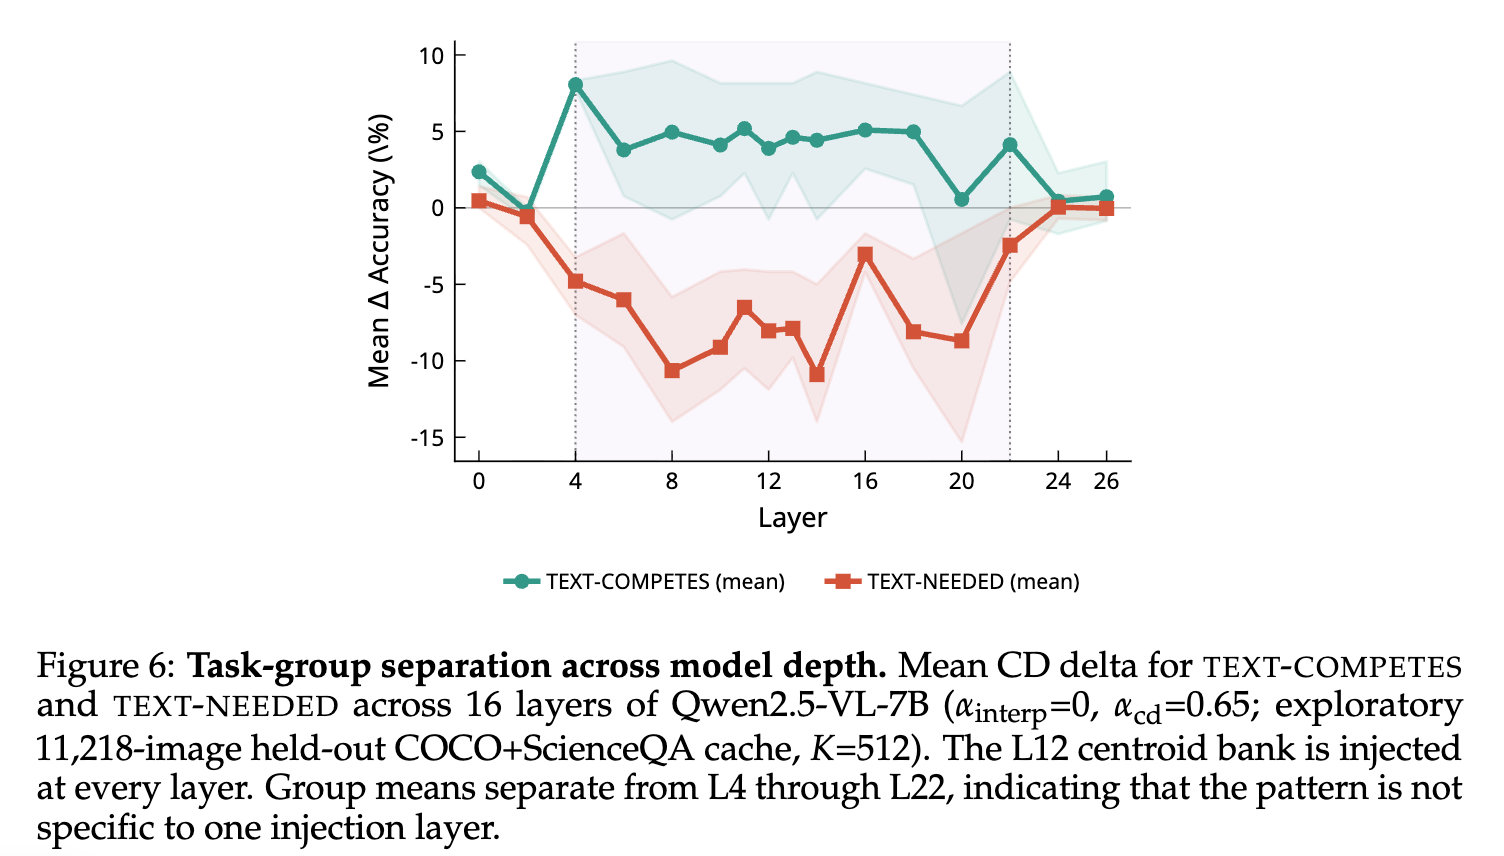
Qwen2.5-VL-7B의 16개 layer에서 TCCD를 적용한 결과, text-competes 과제는 L4부터 L22까지 비교적 넓은 구간에서 개선되었습니다. 반면 text-needed 과제는 같은 구간의 상당 부분에서 성능이 하락했습니다.
즉, 효과가 L12 하나에만 국한되지는 않습니다. 다만 같은 위치의 개입도 과제에 따라 도움을 주거나 방해할 수 있다는 것이죠.
5.2 visual 표현의 세부 정보는 언제 덜 중요해질까?
visual 토큰의 교체 위치도 바꿔보았습니다. Qwen2.5-VL-7B에서 정확도 하락은 다음과 같았습니다.
같은 centroid 교체라도 초기에는 영향이 크지만, LLM 중간층에서는 영향이 작아집니다. 이는 중간층에 도달한 시각 표현이 centroid만으로도 판단에 필요한 정보를 상당 부분 유지할 수 있음을 나타낸다고 합니다.
하지만 이를 “시각 정보가 LLM에서 사라졌다”고 단정하기는 어렵긴 합니다. 정보가 다른 토큰으로 전달되었을 가능성도 있으며, 단계별 centroid를 만드는 표본에도 일부 차이가 있기 때문입니다.
5.3 모델이 다를땐?
7개 모델 중 평균 성능이 개선된 모델은 고정 설정에서 4개, 교차검증으로 강도를 선택했을 때는 5개였습니다. 모델마다 적절한 개입 강도가 달랐고, 일부에서는 성능이 악화되었습니다
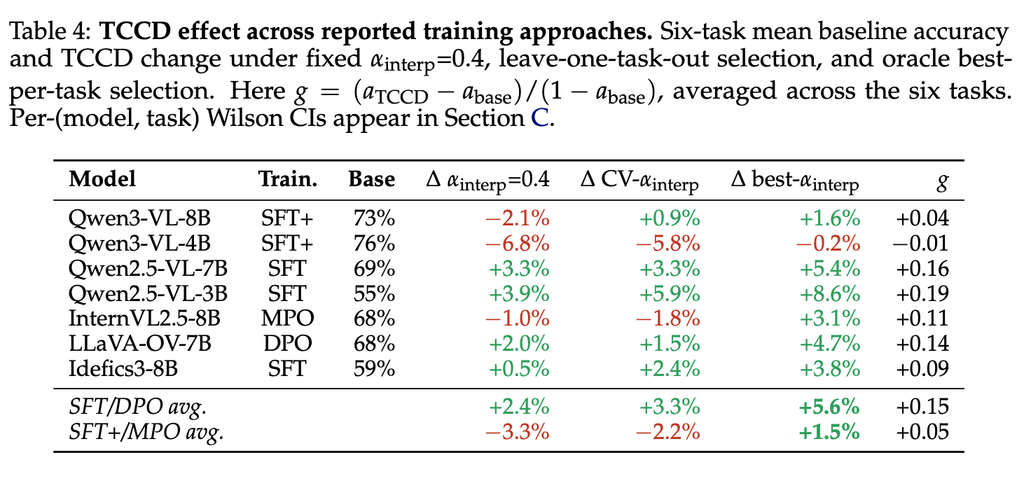
따라서 모달리티 의존도 차이가 관찰된다는 것과, TCCD로 그 모델의 성능을 개선할 수 있다는 것은 별개의 결과입니다. 저자들도 전자는 의존도 측정, 후자는 해당 개입으로 얼마나 개선 가능한지를 나타내는 correctability로 구분합니다.
6. Conclusion
이제 마무리 해보겠습니다. 이 논문을 한 줄로 정리하면, 모델이 정답을 잘 맞힌다는 것과, 시각 정보를 충분히 활용한다는 것은 다른 문제다 인 것 같습니다.
이를 검증하기 위해, 저자들은 centroid replacement로 토큰의 세부 정보를 제거하고, 시각 표현보다 텍스트 표현을 훼손했을 때 정확도가 더 크게 떨어지는 현상을 확인했습니다. 또한 이 차이를 활용하는 TCCD를 통해, 일부 시각 과제에서는 재학습 없이 성능을 개선할 수 있었죠
개인적으로 이 논문의 의미는 성능 개선 자체보다, 모델이 어떤 표현에 의존하는지를 직접 개입하여 살펴봤다는 점에 있다고 생각합니다. 정확도만으로 드러나지 않는 모델의 특성을 분석할 수 있다는 것이죠.
다만… 텍스트 교체는 언어 편향뿐 아니라 질문과 선택지를 이해하는 데 필요한 정보도 훼손할 수 있을 것 같습니다. 특히 visual 및 text 개입 layer도 다르므로, 정확도 하락의 차이를 곧바로 ‘언어가 시각 정보를 방해한 정도’ 라고 보기는 어렵지 않을까 하네요
어찌되었든, 이 논문은 MLLM을 평가할 때 ‘얼마나 잘 맞히는가?’에 더해, ‘무엇에 의존해서 맞히는가?’ 도 물어볼 필요가 있다는 관점을 제시하였다는 점에서 인상적이지 않나 싶네요. 이상 리뷰 마치겠습니다!