‘CLIP이 Object-Attribute Binding을 잘하지 못하는 이유는 모델 구조의 한계일까, 아니면 학습 데이터가 애초에 Binding을 배울 필요가 없도록 구성되어 있기 때문일까?’ 에 대한 의문을 던진 논문을 리뷰해보려고 합니다
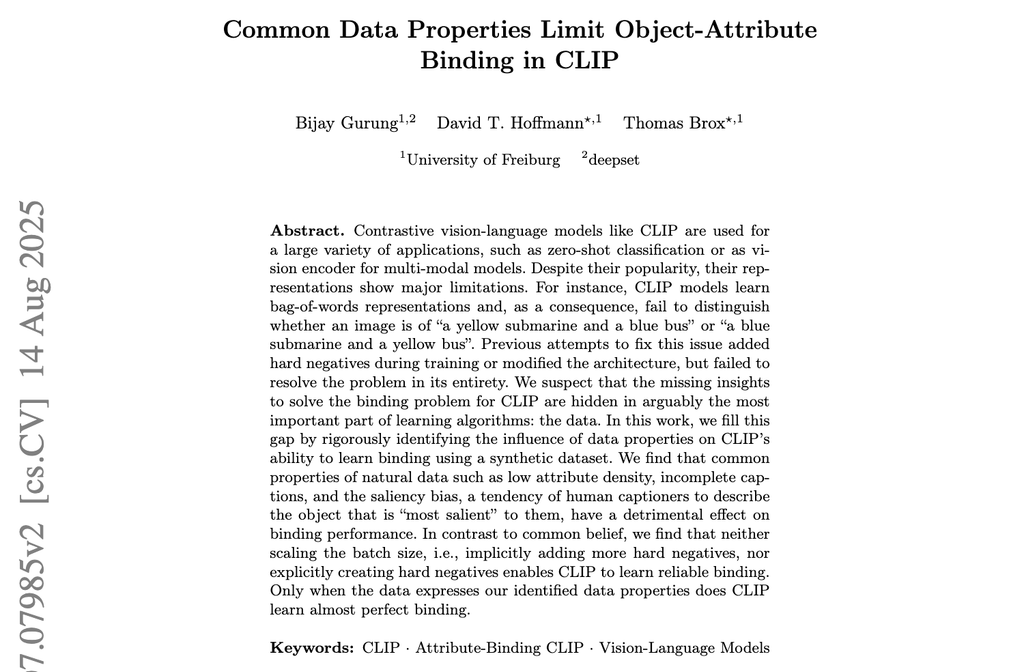
- Venue: DAGM GCPR 2025
- Authors: Bijay Gurung, David T. Hoffmann, Thomas Brox
- Affiliation: University of Freiburg, deepset
- Title: Common Data Properties Limit Object-Attribute Binding in CLIP
1. Object-Attribute Binding 문제
CLIP과 같은 Contrastive Vision-Language Model은 대규모 이미지-텍스트 쌍을 학습하여 Zero-shot Classification, Image-Text Retrieval 등 다양한 작업에서 높은 성능을 보여왔습니다. 하지만 이러한 성과에도 불구하고, CLIP은 이미지에 등장하는 객체와 속성을 올바르게 연결하는 Object-Attribute Binding 능력에 한계를 보입니다.
예를 들어, 이미지에 노란색 잠수함과 파란색 버스가 등장한다고 가정해 봅시다. CLIP은 “a yellow submarine and a blue bus“와 속성이 뒤바뀐 “a blue submarine and a yellow bus“를 제대로 구별하지 못하는 경우가 있습니다. 두 문장에 포함된 객체와 색상은 동일하지만, 어떤 색상이 어떤 객체에 해당하는지는 완전히 다르죠
이러한 현상은 CLIP이 Bag-of-Words(BOW) 특성을 가지기 때문이라고 하는데요. CLIP이 이미지와 텍스트를 개별 개념들의 집합처럼 처리하면서, 마치 개념 사이의 결합 관계를 충분히 반영하지 못한다는 것입니다. 즉, CLIP이 ‘잠수함’, ‘버스’, ‘노란색’, ‘파란색’이라는 개념을 인식하더라도, 어떤 객체가 어떤 색상을 갖는지는 정확하게 구분하지 못할 수 있죠
기존 접근법의 한계? 이러한 Binding 문제를 해결하기 위해 기존 연구들은 주로 학습 방식이나 모델 구조를 개선하는 방식을 제안했습니다.
대표적으로 NegCLIP*은 일반적인 Contrastive Learning 과정에서 올바른 이미지와 캡션을 매칭하는 데 BOW 표현만으로도 충분하기 때문에 Binding을 학습하지 않는다고 했죠. 이를 해결하기 위해 속성이나 객체의 순서를 바꾼 Hard Negative를 학습에 추가하는 NegCLIP을 제안했습니다.
*NegCLIP: When and why vision-language models behave like bags-of-words, and what to do about it? (ICLR 2023)
다만 기존 연구들이 주로 Loss Function과 Architecture에 집중해서 이 문제를 해결하려고 했는데, 일반적인 평가 환경에서는 그저 그런 성능을 보여 근본적인 해결책은 아니었다는 평가를 받곤 했습니다.
따라서 이번 논문의 저자들은 기존에 집중하지 않았던, 데이터셋에 시선을 돌렸는데요. 즉, 지금까지 상대적으로 충분히 분석되지 않았던 또 다른 요소인 학습 데이터에 문제의 원인이 있을 수 있다고 주장하였습니다
2. 학습 데이터가 Binding을 불필요하게 만든다면?
이 논문의 핵심 가설은 일반적인 이미지-캡션 데이터의 특성이 CLIP으로 하여금 Binding을 학습할 필요가 없도록 만든다는 것입니다.
Contrastive Learning의 목적은 정답 이미지-텍스트 쌍의 유사도를 다른 쌍보다 높이는 것입니다. 따라서 객체와 속성을 정확히 연결하지 않더라도 개별 개념들의 조합만으로 정답을 구분할 수 있다면, 모델은 굳이 Binding을 학습할 필요가 없습니다.
저자들은 이러한 상황을 유발할 수 있는 네 가지 데이터 특성에 주목했습니다.
- Multi-object Images: 이미지에 여러 객체가 등장하는 비율
- Multi-object Captions: 캡션이 이미지의 여러 객체를 함께 설명하는 비율
- Attribute Density: 캡션에서 객체당 설명하는 속성의 수
- Saliency Bias: 눈에 띄는 객체가 우선적으로 설명되는 편향
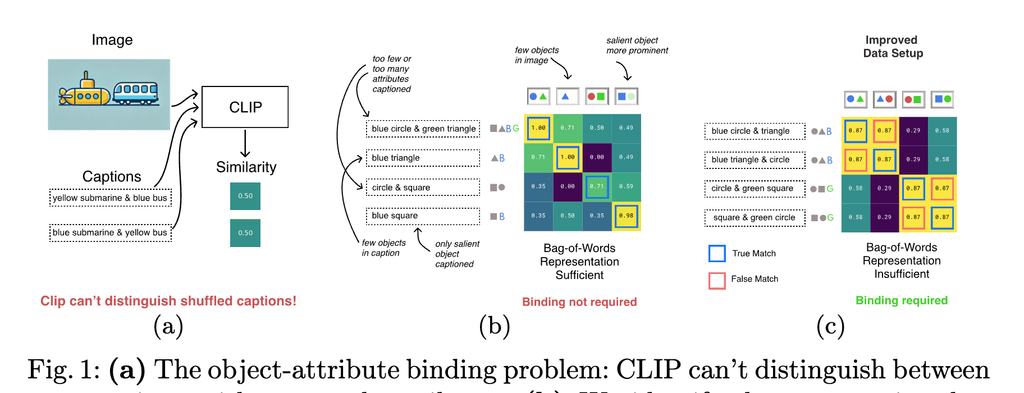
Figure 1(b)는 이러한 데이터 특성으로 인해 BOW 표현만으로도 이미지와 캡션을 구별할 수 있는 상황입니다. 반면 Figure 1(c)는 단순히 등장하는 개념만 비교해서는 정답을 구분할 수 없으며, 객체와 속성 사이의 Binding이 필요한 상황을 나타낸 것인데요
이를 검증하기 위해 저자들은 데이터 특성을 독립적으로 조절할 수 있는 합성 데이터셋 MADMAN을 구성하고, 각 특성이 CLIP의 Binding 성능에 미치는 영향을 분석하였습니다. 자세한 내용 알아보겠습니다.
3. MADMAN: 데이터 특성의 영향을 어떻게 검증했는가?
실제 이미지-캡션 데이터에서는 여러 특성이 복합적으로 나타나므로, 특정 데이터 특성이 Binding에 미치는 영향을 독립적으로 분석하기 어렵습니다. 따라서 저자들은 각 특성을 자유롭게 조절할 수 있는 합성 데이터셋 MADMAN을 구축했습니다.
MADMAN은 MNIST의 숫자(0~9)를 기반으로 하며, 각 숫자에는 색상, 크기, 두께, 회전, 팽창, 균열의 여섯 가지 속성이 적용됩니다. 이미지에는 최대 두 개의 숫자가 등장하고, 캡션은 “small yellow 7 and large blue 4“처럼 객체와 속성을 함께 설명합니다 (상단 그림 참고)
이러한 환경에서 앞서 소개한 네 가지 Data Properties를 개별적으로 조절하여, 어떤 조건이 Binding 학습에 영향을 미치는지 분석했습니다. 또한 실제 데이터와 유사한 조건을 만들기 위해 CC12M의 이미지 100장을 분석하여 Realistic Data 설정을 구성했습니다.
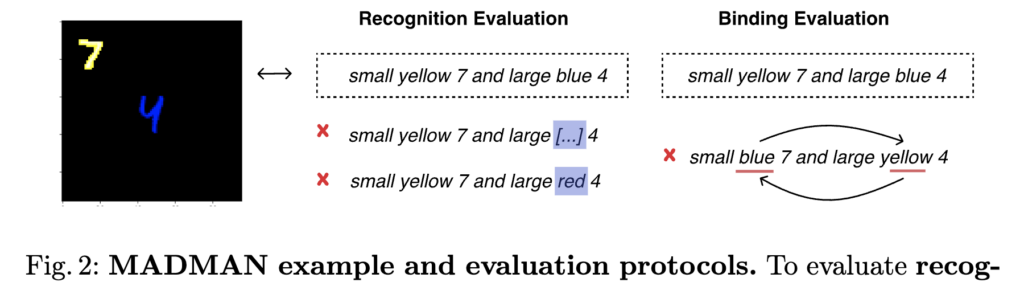
상단 Figure 2는 두 가지 평가 방식을 의미하는데요,
- Recognition: 속성을 다른 값으로 바꿔 모델이 개별 속성을 정확하게 인식하는지 평가
- Binding: 두 객체의 속성을 서로 바꾼 캡션과 정답 캡션을 비교하여 올바른 결합 관계를 구분하는지 평가
특히 저자들은 두 객체의 속성을 모두 올바르게 인식한 샘플에 대해서만 Binding 정확도를 계산했습니다. 이는 단순히 색상을 인식하지 못한 경우와, 색상은 인식했지만 객체에 잘못 연결한 경우를 구분하기 위해서입니다.
실험에서는 소규모 CLIP을 처음부터 학습한 결과를 리포팅하였습니다
4. 데이터 특성이 Binding 성능에 미치는 영향
저자들은 먼저 CLIP이 정말 Binding을 학습할 수 없는 모델인지, 아니면 학습 데이터가 이를 방해하는지 확인했습니다.
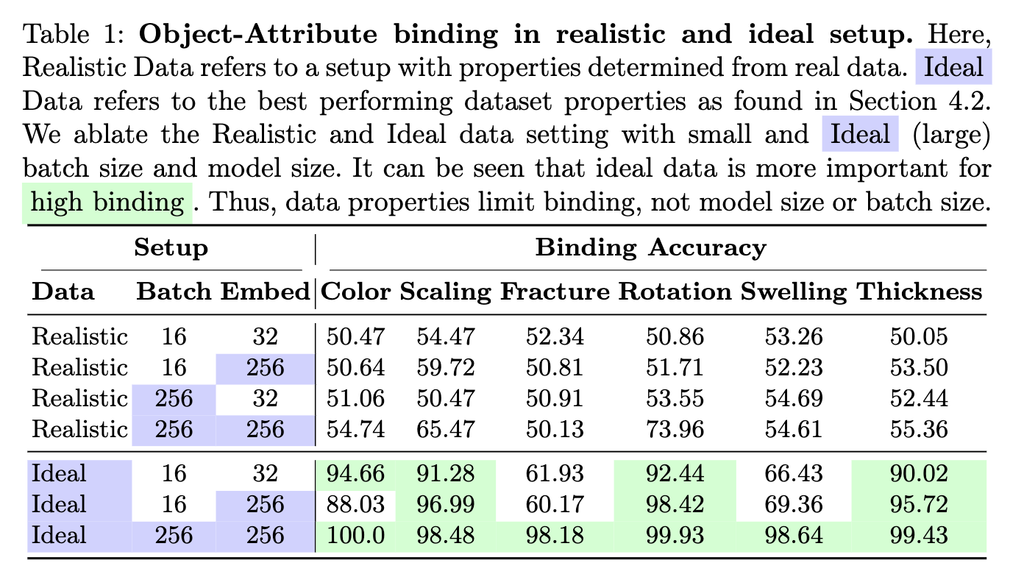
상단 Table 1은 실제 데이터의 특성을 반영한 Realistic Data와 Binding 학습에 유리하도록 구성한 Ideal Data를 비교한 결과입니다.
Realistic Data에서는 배치 사이즈와 임베딩 크기를 증가시켜도 대부분의 Binding 정확도가 랜덤 성능인 50% 부근에 머물렀습니다. 반면 Ideal Data에서는 동일한 작은 모델에서도 6개 속성 중 4개가 90% 이상의 정확도를 기록했고, 모델과 배치사이즈를 함께 증가시키자 모든 속성에서 98% 이상의 성능을 달성했습니다.
이는 CLIP이 Binding을 학습할 능력이 없는 것이 아니라, 데이터의 특성이 학습을 제한할 수 있음을 보여주는 결과입니다.
어떤 데이터 특성이 Binding을 제한하는가?
저자들은 네 가지 데이터 특성을 하나씩 변경하면서 성능 변화를 분석했습니다.
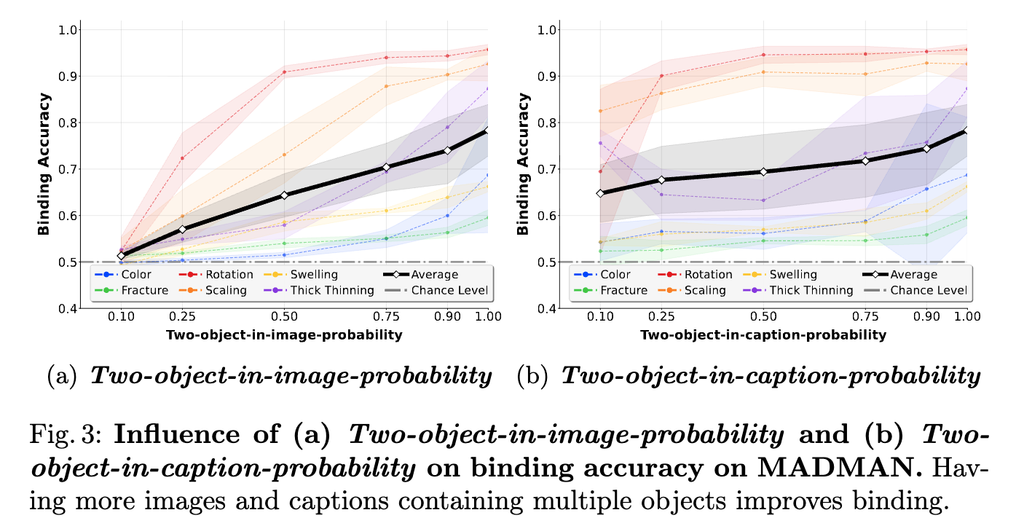
Figure 3에서는 Multi-object Images와 Multi-object Captions의 비율이 증가할수록 Binding 성능이 향상되었습니다. 이미지에 여러 객체가 등장하고, 캡션도 이들을 함께 설명해야 객체와 속성의 결합 관계를 학습할 기회가 많아지는 것입니다.
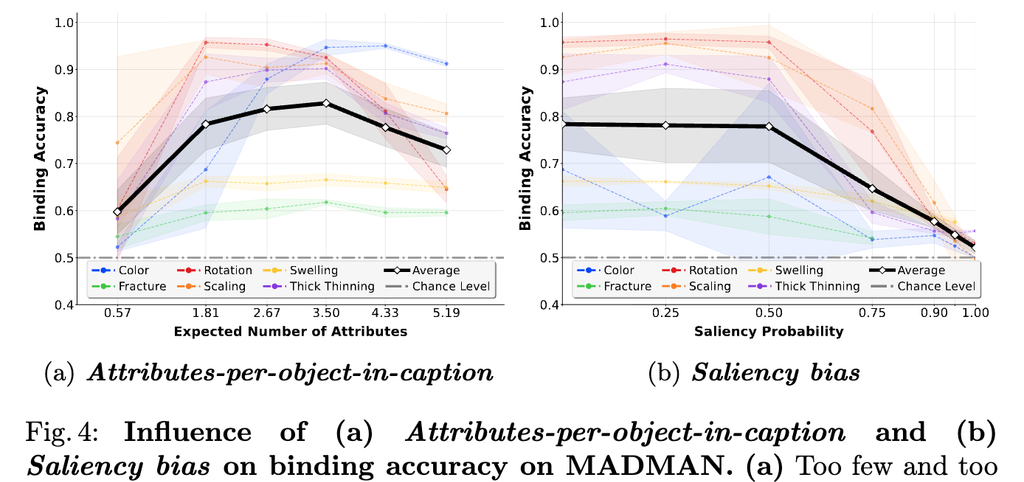
Figure 4(a)는 흥미롭게도 Attribute Density와 Binding 성능 사이에 역 U자형 관계가 나타남을 보여주는 결과라고 하는데요. 속성을 너무 적게 설명하면 Binding 학습에 필요한 정보가 부족하지만, 반대로 너무 많이 설명하면 개별 개념들의 조합만으로도 이미지를 구분할 수 있어 Binding이 불필요해집니다. 실험에서는 객체당 평균 약 3.5개의 속성을 설명할 때 가장 좋은 결과를 보였습니다.
Figure 4(b)에서는 Saliency Bias가 높아질수록 Binding 성능이 크게 감소했습니다. 특히 Saliency Probability가 0.75를 넘어서면서 성능이 급격히 저하되었습니다. 이는 모델이 모든 객체의 속성을 연결하기보다, 눈에 띄는 객체의 정보만 활용하는 Shortcut을 학습할 수 있음을 시사하는 것이죠
결국 이 실험의 핵심은 캡션에 정보를 무조건 많이 제공하는 것보다, 모델이 BOW 표현만으로는 정답을 구분하기 어려운 학습 환경을 만드는 것이 중요하다는 점입니다.
5. 데이터 특성의 영향은 얼마나 견고한가?
앞선 실험에서 확인한 데이터 특성의 영향이 특정 모델 설정에 의존하는 것은 아닌지 확인하기 위해, 저자들은 추가적인 검증 실험을 수행했습니다.
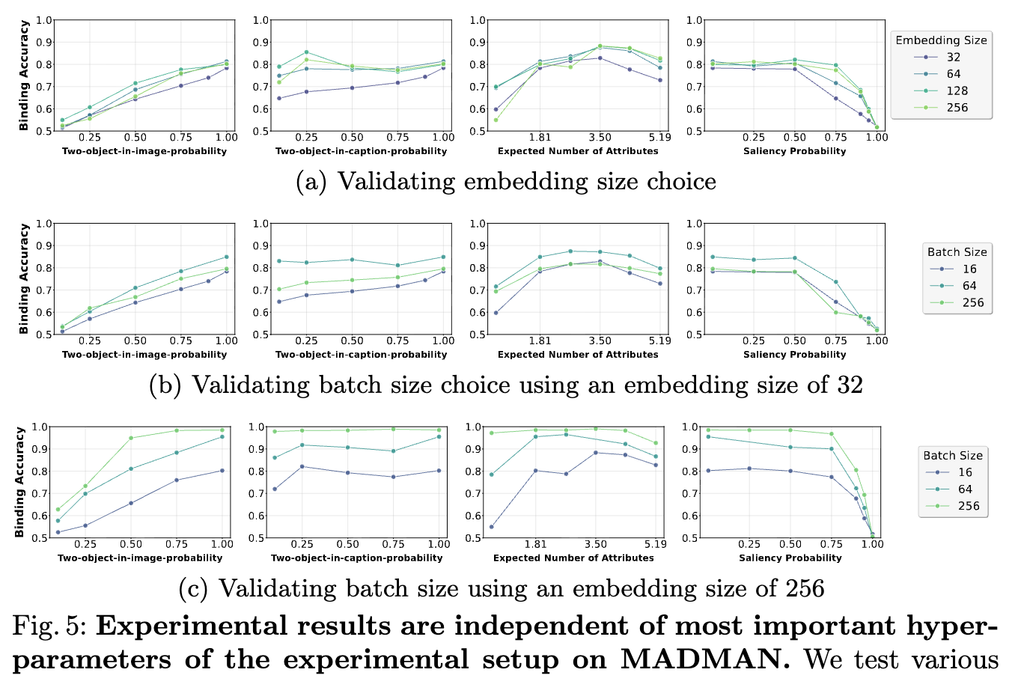
먼저 Batch Size(16~256)와 Embedding Size(32~256) 를 변경하여 실험했습니다. Figure 5를 보면 모델의 크기나 배치 사이즈가 달라져도 네 가지 데이터 특성에 따른 Binding 성능 변화는 대부분 유사하게 나타났습니다. 다만 Multi-object Captions의 영향은 모델과 배치 사이즈가 커질수록 일부 약해졌습니다.
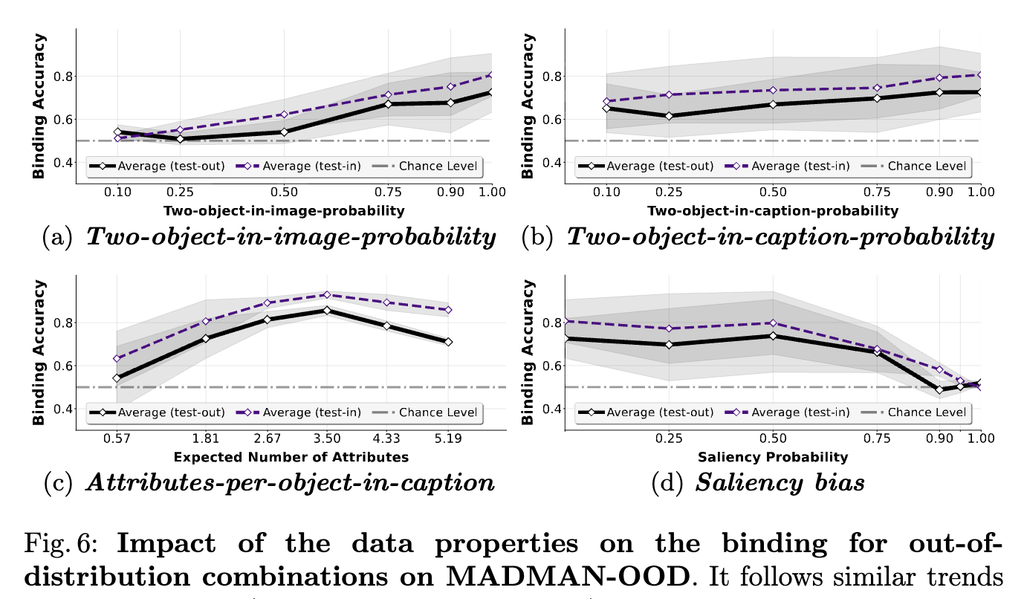
다음으로 학습 과정에서 등장하지 않은 Object-Attribute 조합을 활용한 OOD 평가를 진행했습니다. Figure 6에서도 기존 실험과 유사한 경향이 나타났으며, 이는 모델이 단순히 학습 데이터의 조합을 암기한 결과만은 아니라는 것을 뒷받침하는 결과라고 하네요.
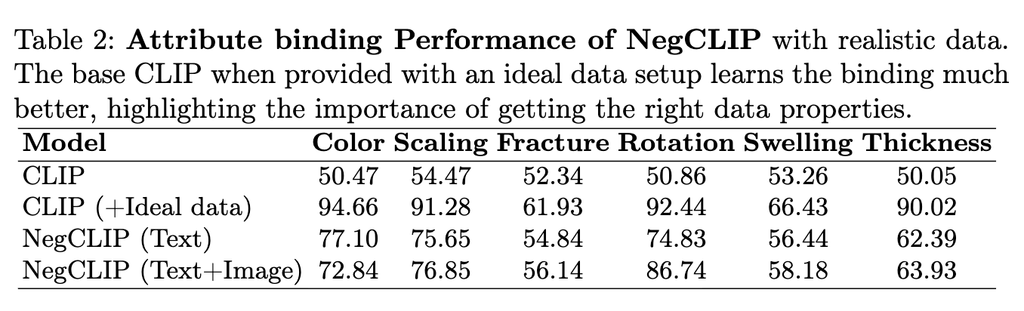
마지막으로 Hard Negative를 활용하는 NegCLIP과 비교했습니다. Realistic Data에서 기존 CLIP의 Binding 정확도는 대부분 50% 수준이었지만, NegCLIP은 Color에서 최대 77.10%, Rotation에서 최대 86.74%를 기록하며 성능이 개선되었습니다. 그러나 동일한 기본 모델을 Ideal Data로 학습했을 때는 각각 94.66%, 92.44%를 기록하여 NegCLIP보다 높은 성능을 보였습니다.
따라서 저자들은 Hard Negative나 모델 크기를 개선하는 것만으로는 데이터 특성에서 비롯된 Binding 문제를 충분히 해결하기 어렵다고 결론지었습니다.
6. Conclusion & Discussion
이 논문은 CLIP의 Object-Attribute Binding 문제가 단순히 모델 구조나 학습 방식의 한계가 아니라, 학습 데이터의 특성에서 비롯될 수 있다는 점을 보여주었습니다.
특히 여러 객체를 충분히 설명하지 않는 캡션, 지나치게 적거나 많은 속성 정보, 그리고 Saliency Bias가 Binding 학습을 방해한다는 사실을 확인했습니다. 반면 이러한 데이터 특성을 개선하면 기존 CLIP 구조만으로도 높은 Binding 정확도를 달성할 수 있었습니다.
다만 몇 가지 한계가 있는 것 같긴 합니다.
첫째, 모든 핵심 실험이 합성 데이터셋 MADMAN에서 수행되었다는 점입니다. 실제 CC12M 데이터 100장을 분석하여 현실적인 데이터 특성을 설정했다고는 하지만… 일반화하기엔 너무나도 작은 수치구요. 실제 이미지-캡션 데이터의 특성을 변경했을 때도 동일한 결과가 나타나는지는 검증하지 않았습니다.
둘째, Saliency Bias의 구현 방식이 실제 데이터의 복잡성을 충분히 반영하는지는 의문입니다. 저자들은 중앙에 위치한 객체를 Salient Object로 정의하고 이를 캡션에서 우선 설명하도록 설정했습니다. 하지만 실제 이미지에서는 객체의 크기, 의미적 중요도, 주변 맥락 등 다양한 요인이 Saliency에 영향을 미칩니다.
다만 기존의 뻔한 접근과는 다르게 새로운 관점을 제시하였다는 점이 차별점 아닐까 싶습니다. 단순히 학습 데이터의 양을 늘리거나 더 자세한 캡션을 제공하는 것이 아니라, 모델이 객체와 속성의 결합 관계를 학습해야만 정답을 구별할 수 있는 환경을 구성해야한다는 것? 어찌보면 뻔한 얘기일 수는 있으나 합성 데이터를 통해 주장하였다는 점이 인상깊네요. 리뷰 마치겠습니다
저자들은 후속 연구로 Salient Object를 캡션에서 선택적으로 제외하거나, 객체당 설명하는 속성 수를 조절하는 Re-captioning 전략을 제안했습니다. 실제 데이터에서도 이러한 접근이 유효한지 검증한다면, Data-centric 관점에서 CLIP의 Compositionality를 개선할 수 있는 중요한 단서가 될 것으로 생각합니다.