안녕하세요. 이번에는 Latent Implicit Visual Reasoning (LIVR) 논문을 읽어보았습니다.
지난번에 리뷰한 Coconut이 LLM의 reasoning을 language space에서 continuous latent space로 옮겼다면, 이번 논문은 비슷한 문제의식을 Large Multimodal Model의 visual reasoning으로 확장합니다.
기존 LMM은 이미지를 입력으로 받더라도 실제 reasoning 과정은 대부분 language model 내부의 text space에서 이루어지는데요. LIVR은 별도의 visual intermediate supervision 없이 모델 스스로 task에 필요한 visual representation을 latent token에 학습하도록 합니다.
그럼 리뷰 시작하겠습니다.
Abstract
현재 Large Multimodal Model(LMM)은 visual understanding에서 높은 성능을 보이고 있지만, 여전히 reasoning 과정이 상당히 text-centric하다는 문제가 있습니다.
이미지는 처음 visual token으로 입력되지만 이후 reasoning과 output은 주로 language space에서 이루어지기 때문에 (CoT 및 Thinking 모드), fine-grained visual structure나 복잡한 visual abstraction이 필요한 task에서는 한계가 나타날 수 있습니다.
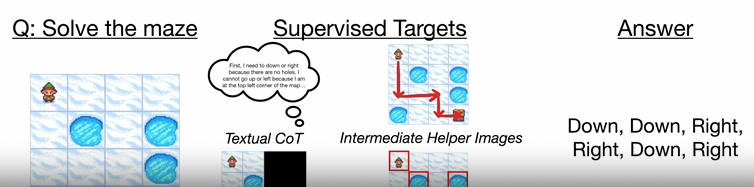
기존 연구에서는 이를 해결하기 위해 intermediate image, image crop, depth map, bounding box와 같은 explicit visual intermediate supervision을 사용했습니다.
하지만 이러한 방식은 어떤 visual representation이 reasoning에 유용한지를 사람이 미리 정의해야 하고, task-specific annotation 비용이 발생하며, 새로운 task로 확장하기 어렵다는 문제가 있습니다.
저자들은 이를 해결하기 위해 Latent Implicit Visual Reasoning, LIVR을 제안합니다.
LIVR은 LMM에 별도의 latent visual token을 추가하고, answer를 생성할 때 원본 image token을 직접 보지 못하도록 attention을 제한합니다.
따라서 image의 task-relevant information은 반드시 latent token을 거쳐 answer로 전달되어야 하고, 이 과정에서 latent token이 현재 task에 필요한 visual representation을 스스로 학습하게 됩니다.
중요한 점은 latent token에 대해 bounding box나 image crop과 같은 별도의 target을 제공하지 않는다는 것입니다. 오직 최종 answer supervision만으로 latent visual representation을 학습합니다.
실험에서는 여러 vision-centric task와 LMM backbone에서 direct supervised fine-tuning보다 높은 성능을 보였으며, 별도의 helper image, bounding box, crop, depth map, CoT annotation 없이도 기존 explicit visual reasoning 방법들과 경쟁력 있는 결과를 보였습니다.
Introduction
최근 LMM은 visual understanding에서 큰 발전을 보였지만, fine-grained visual reasoning이나 visual abstraction이 중요한 task에서는 여전히 어려움을 겪습니다.
저자들은 그 원인 중 하나를 현재 LMM의 language-centric architecture에서 찾습니다.
대부분의 LMM은 LLaVA와 유사하게 image를 visual encoder로 encoding한 뒤 language model embedding space로 projection하고, 이후 모든 output을 text token으로 생성합니다.
즉 visual information을 입력으로 받기는 하지만 reasoning 과정 자체는 결국 language representation에 크게 의존하게 됩니다.
하지만 모든 visual reasoning을 language로 표현하는 것이 항상 적절한 것은 아닙니다. 특히 spatial structure나 visual pattern처럼 언어로 명확하게 표현하기 어려운 정보가 필요한 task에서는 text representation만으로 충분한 abstraction을 만들기 어려울 수 있습니다.
이러한 문제를 해결하기 위해 기존 연구들은 intermediate visual representation을 직접 supervision했습니다.
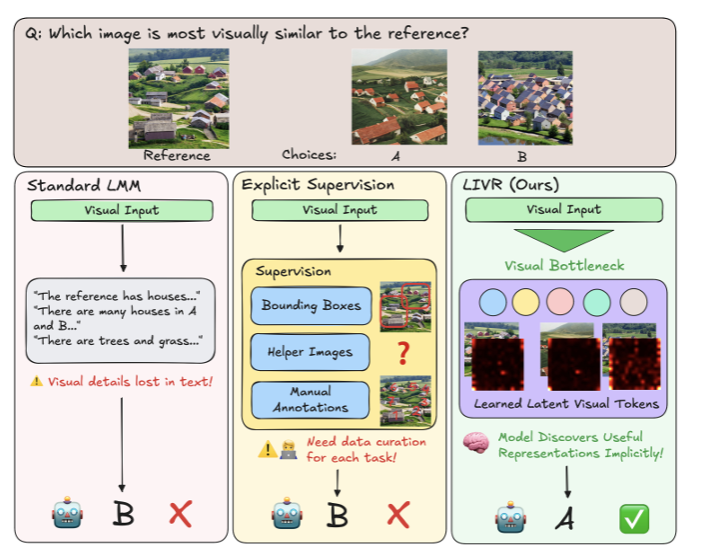
위의 Figure1처럼 bounding box나 image crop을 생성하거나, depth map이나 새로운 helper image를 reasoning 중간 단계로 생성하는 방식입니다.
하지만 이러한 explicit supervision에는 세 가지 문제가 있습니다.
첫째, task마다 별도의 intermediate annotation이 필요하기 때문에 비용이 높습니다.
둘째, 어떤 visual representation이 reasoning에 유용한지를 사람이 미리 정의해야 합니다.
셋째, 위의 figure의 Question 예시처럼 visual similarity나 abstract visual pattern처럼 어떤 intermediate representation이 필요한지 자체가 명확하지 않은 task도 존재합니다.
이러한 문제에서는 관계를 text로 설명하는 것도 어렵고, 어떤 bounding box나 crop을 intermediate supervision으로 제공해야 하는지도 명확하지 않습니다.
LIVR은 이 문제를 해결하기 위해 intermediate representation을 사람이 정의하는 대신, latent token이 task에 필요한 visual abstraction을 직접 학습하도록 설계합니다.
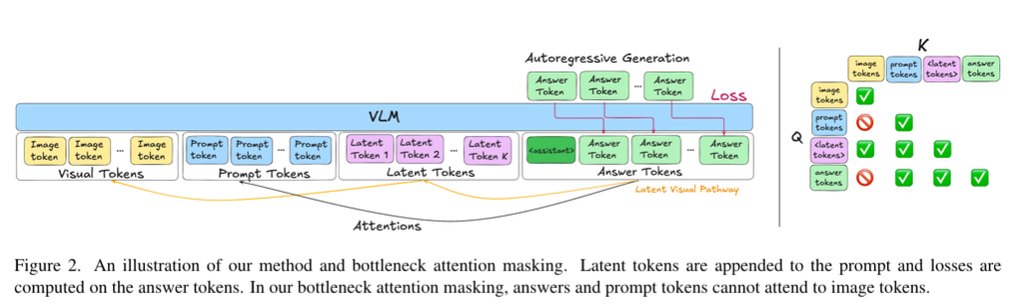
이를 위해 latent token을 추가하고, image에서 answer로 visual information이 직접 전달되는 경로를 막는 visual bottlenecking을 사용합니다.
그 결과 모델은 answer를 맞히기 위해 image의 필요한 정보를 latent token에 담을 수밖에 없게 됩니다.
논문의 contribution은 크게 세 가지입니다.
- 별도의 intermediate supervision 없이 latent token을 통해 visual representation을 학습하는 LIVR을 제안합니다.
- 9개의 perception-heavy task와 3개의 LMM backbone에서 direct supervised fine-tuning보다 일관되게 높은 성능을 보입니다.
- helper image, bounding box, crop, depth map, CoT annotation 없이도 기존 text-based 및 explicit visual reasoning 방법들과 경쟁력 있는 성능을 보입니다.
Method
LIVR의 전체 구조는 생각보다 단순합니다.
기존 LMM에 latent token을 추가하고, 학습 초기에 answer가 image token을 직접 볼 수 없도록 attention을 제한해서 visual information이 반드시 latent token을 거쳐가도록 만드는 것이 핵심입니다.
3.1 Preliminaries
먼저 일반적인 LMM은 visual encoder, projector, language model로 구성됩니다.
Image는 visual encoder를 통해 feature로 변환되고, projector를 거쳐 language model의 embedding space로 들어갑니다. Text prompt 역시 embedding된 뒤 language model이 image와 question을 함께 받아 최종 response를 생성합니다.
해당 논문에서는 모든 task를 VQA 형태로 구성합니다. 즉 image와 question을 입력으로 받고, ground-truth answer를 맞히도록 모델을 학습합니다.
3.2 Latent Implicit Visual Reasoning
기존 LMM에서는 image information이 처음 input으로 들어온 이후, reasoning과 answer generation은 주로 language model 내부에서 이루어집니다.
저자들은 여기에 별도의 visual computation space를 제공하기 위해 latent token을 추가합니다.
다만 기존 LVR이나 Mirage라는 논문이 Visual latent 를 학습하기 위해 latent token이 특정 crop이나 helper image를 복원하도록 학습하지는 않습니다.
대신 최종 answer를 잘 맞히는 데 필요한 visual information이 무엇인지를 모델이 스스로 latent token에 담도록 학습한다고 합니다.
Latent Tokens
먼저 기존 vocabulary에 (K)개의 새로운 special latent token을 추가하고, 이 token들을 question prompt 뒤에 붙입니다.
즉 입력 구조를 간단하게 보면
Image Tokens → Question Tokens → Latent Tokens → Answer Tokens
형태가 됩니다.
latent token의 embedding은 random initialization되고 학습 과정에서 업데이트됩니다.
여기서 중요한 점은 latent token을 모델이 직접 생성하는 것이 아니라는 것입니다. 미리 input에 삽입되어 있으며, Transformer를 통과하면서 image와 question을 참고해 task에 필요한 visual information을 담는 역할을 합니다.
Visual Bottlenecking
그런데 단순히 latent token을 추가하는 것만으로는 문제가 있습니다.
Answer token이 기존처럼 image token을 직접 볼 수 있다면, 굳이 새로 추가된 latent token을 사용할 필요가 없기 때문입니다. 모델 입장에서는 latent를 무시하고 기존 visual pathway만 사용해도 answer loss를 줄일 수 있습니다.
그래서 LIVR에서는 학습 초기에 attention mask를 강제로 수정합니다.
Figure 2를 보면 latent token은 image token을 참조할 수 있지만, answer token은 image token을 직접 참조할 수 없습니다.
또 하나 중요한 점은 question prompt 역시 image token을 볼 수 없도록 막는다는 것입니다. Prompt가 image를 먼저 보고 그 visual information을 answer로 전달하면 latent를 우회하는 leakage가 생길 수 있기 때문입니다.
따라서 Stage 1에서 visual information이 answer까지 전달될 수 있는 경로는 사실상
Image → Latent Token → Answer
하나로 제한되게끔 설계했습니다.
즉 latent token이 visual bottleneck 역할을 하게 되는 것입니다.
Answer를 맞히려면 image의 필요한 정보를 latent에 담아야 하기 때문에, 별도의 intermediate supervision을 주지 않아도 answer loss만으로 latent token이 task-relevant visual representation을 학습하게 됩니다.
이게 LIVR에서 가장 핵심적인 부분이라고 보면 되겠습니다.
Multi-Stage Training
LIVR은 총 2-stage로 학습합니다.
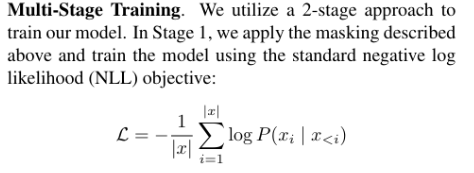
Stage 1에서는 앞서 설명한 visual bottleneck mask를 적용합니다. Answer와 prompt가 image token을 직접 볼 수 없기 때문에 visual information은 반드시 latent token을 거쳐야 합니다.
학습 objective 자체는 특별한 loss가 아니라 일반적인 Negative Log-Likelihood를 사용하고, loss는 answer token에 대해서만 계산합니다. 즉 latent token 자체에 정답 representation을 지정하거나 reconstruction loss를 주는 것이 아닙니다.
최종 answer를 맞히도록 backpropagation을 수행하는 과정에서 latent token이 자연스럽게 필요한 visual information을 학습하도록 합니다.
그리고 Stage 2에서는 bottleneck을 제거하고 standard attention mask로 돌아갑니다. 이제 answer token은 원본 image token과 latent token을 모두 볼 수 있습니다.
Stage 1이
Image → Latent → Answer
만 허용해서 latent에 visual information을 학습시키는 과정이었다면,
Stage 2는
Image + Learned Latent → Answer
형태로 원본 visual information과 학습된 latent representation을 함께 사용하도록 만드는 과정입니다.
Loss는 Stage 1과 동일하게 answer token에 대해서만 계산합니다. 결국 굳이 2-stage로 나눈 이유는 처음부터 image와 latent를 모두 허용하면 모델이 latent를 무시할 가능성이 있기 때문입니다. 먼저 Stage 1에서 latent를 강제로 사용하게 만든 뒤, Stage 2에서 원본 image와 함께 사용할 수 있도록 풀어주는 방식입니다.
3.3 Implementation Details
학습에서는 language backbone 전체를 full fine-tuning하지 않고 LoRA를 attention과 MLP block에 적용합니다.
Vision encoder와 projector는 frozen 상태로 유지하며, 추가된 latent token의 embedding row만 별도로 unfreeze해서 학습합니다.
따라서 기존 LMM 구조를 크게 변경하거나 별도의 visual generator를 추가하는 것이 아니라, latent token과 attention masking을 이용해 기존 LMM 내부에 visual reasoning pathway를 추가하는 방식이라고 볼 수 있습니다.
특히 기존 visual latent reasoning 방법들이 intermediate image나 crop 등을 latent의 target으로 직접 지정했다면, LIVR은 무엇을 latent에 담아야 하는지조차 지정하지 않고 최종 QA objective만으로 학습한다는 점이 가장 큰 차이입니다.
4. Results
저자들은 먼저 동일한 training data와 backbone을 사용하는 Direct SFT와의 data-matched comparison을 통해 LIVR 자체의 효과를 확인합니다.
이후 기존 visual reasoning 방법들과 비교하고, 마지막으로 latent token과 visual bottleneck이 실제로 필요한지 ablation을 진행합니다.
평가는 BLINK에서 가져온 9개의 perception-heavy task를 사용합니다.
Counting, Jigsaw, Object Localization, Visual Correspondence, Art Style, Semantic Correspondence, Functional Correspondence, Relative Reflectance, Visual Similarity로 구성되어 있고, 모두 visual reasoning이나 abstraction이 중요한 task입니다.
여기서 백본은 Qwen2.5 VL-3B, Qwen3-VL-4B, LLaVA-OneVision-1.5-4B 에서 진행합니다. 위의 Direct SFT와 저자의 LIVR은 동일한 training data를 사용했다고 합니다.
Single task Results
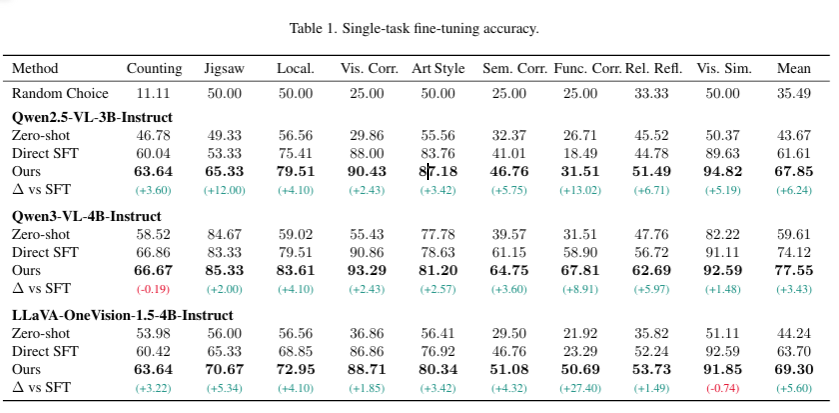
LIVR은 세 backbone 모두에서 Direct SFT보다 높은 평균 성능을 보였습니다.
특히 Functional Correspondence, Visual Similarity, Relative Reflectance처럼 어떤 intermediate visual representation을 만들어야 할지 명확하지 않은 task에서도 꾸준히 성능이 향상됩니다.
즉 별도의 visual supervision 없이도 latent token이 task에 필요한 visual abstraction을 학습할 수 있다는 결과로 해석할 수 있습니다.
Multi-Task Results
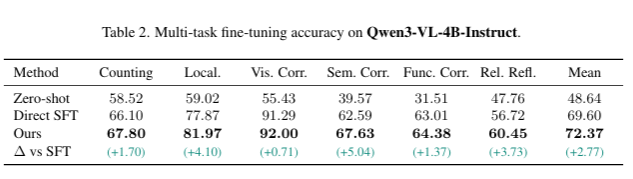
여러 task를 하나의 모델에서 동시에 학습하는 multi-task setting에서도 동일한 경향을 보입니다.
Qwen3-VL에서 Direct SFT의 평균 성능은 69.60이었고, LIVR은 72.37로 +2.77%p 향상되었습니다.
6개 task 모두에서 Direct SFT보다 높은 성능을 보였다는 점도 중요합니다.
LIVR은 latent에 특정 depth map이나 bounding box 같은 task-specific target을 주지 않기 때문에, 서로 다른 종류의 visual task를 함께 학습할 때도 동일한 구조를 그대로 사용할 수 있다는 장점이 있습니다.\
Comparison with Prior Reasoning Methods
저자들은 기존 visual reasoning 방법들과도 비교합니다.
먼저 Visual Spatial Planning에서는 latent token을 helper image representation으로 학습하는 Mirage와 비교합니다.
Qwen2.5-VL-3B에서 Mirage가 46.0을 기록한 반면, LIVR은 별도의 helper image 없이 66.0을 기록합니다.
7B 모델에서도 LIVR은 77.5로 Mirage의 76.0보다 높은 성능을 보였습니다.
Spatial Reasoning Generalization
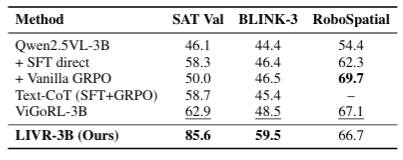
ViGoRL과 동일한 SAT-32k 데이터를 사용해 spatial reasoning generalization도 평가합니다.
LIVR은 text CoT, bounding box supervision, RL 없이도 SAT validation에서 85.6, BLINK-3에서 59.5를 기록하며 기존 방법보다 높은 성능을 보였습니다.
RoboSpatial에서는 66.7로 ViGoRL의 67.1과 비슷한 수준을 보입니다.
즉 synthetic spatial data로 학습한 뒤 real-image benchmark로 넘어가는 상황에서도 latent visual reasoning이 어느 정도 generalization된다는 결과입니다.
Broader Visual Reasoning Benchmarks
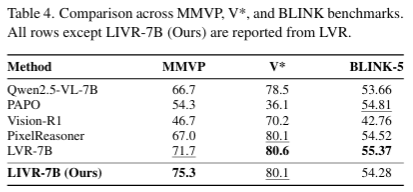
Qwen2.5-VL-7B를 이용한 broader benchmark에서도 LIVR은 기존 방법과 경쟁력 있는 결과를 보입니다.
MMVP에서는 75.3으로 LVR의 71.7보다 높았고, V*에서는 80.1로 LVR의 80.6과 유사한 수준을 보였습니다.
중요한 점은 LVR이 visual intermediate와 RL을 사용하는 반면, LIVR은 intermediate image, crop, text CoT와 같은 별도의 supervision을 사용하지 않는다는 것입니다.
Ablation study
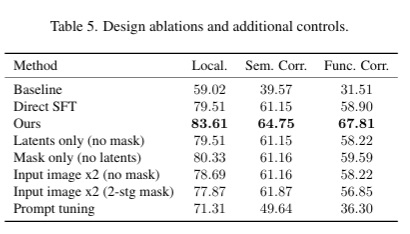
여기서 상당히 중요한 실험을 하나 합니다. 단순히 latent token을 추가하기만 하고 Stage 1 bottleneck training을 하지 않은 Latents-only 모델과 LIVR을 비교합니다.
Latents-only 모델은 inference에서 latent token을 제거해도 성능이 79.51 → 79.51 로 전혀 변하지 않았습니다. 즉 latent token을 추가만 하면 모델이 그냥 무시해버린다는 것입니다.
반면 LIVR은 latent token을 제거했을 때 83.61 → 76.23 으로 성능이 크게 떨어집니다.
Answer token에서 latent token으로 향하는 attention도 LIVR이 0.076, Latents-only가 0.028로 LIVR에서 훨씬 높았습니다. 그리고 inference에서도 image를 직접 볼 수 없게 bottleneck을 다시 적용했을 때, Latents-only는 43.44로 거의 random 수준까지 떨어지는 반면 LIVR은 70.49를 유지합니다.
즉 LIVR의 latent token은 단순히 추가 capacity 역할을 하는 것이 아니라, 실제로 task-relevant visual information을 담고 있으며 모델도 이를 사용하고 있음을 보여줍니다.
mask only 는 bottleneck은 적용하지만 별도의 latent token 없이 기존 prompt token이 visual information을 전달하도록 만든 경우입니다. 두 경우 모두 full LIVR보다 낮은 성능을 보였습니다.
특히 mask only의 경우 저자들은 기존 text token에는 이미 language semantics가 강하게 학습되어 있기 때문에, 새로운 visual abstraction을 담는 representation으로 활용하기 어렵다고 해석합니다.
반면 새롭게 추가된 latent token은 기존 semantics에 묶여 있지 않기 때문에 task-specific visual representation으로 자유롭게 학습될 수 있습니다.
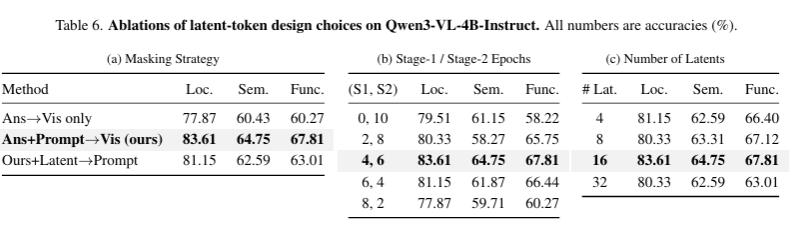
추가로 여러 design choice를 분석합니다.
먼저 latent token은 prompt 앞보다 prompt 뒤에 배치하는 것이 더 좋았습니다. Prompt 뒤에 위치해야 latent token이 question을 확인한 뒤 어떤 visual information을 가져올지 결정할 수 있기 때문이라고 설명합니다.
Masking에서도 answer-to-image만 차단하는 것보다, answer와 prompt 모두 image를 직접 볼 수 없도록 막는 현재 LIVR 설정이 가장 좋은 성능을 보였습니다. Prompt가 image를 볼 수 있으면 visual information이 prompt를 거쳐 answer로 전달될 수 있기 때문에 latent bottleneck이 제대로 형성되지 않는다고 이해하면 됩니다.
Stage 1과 Stage 2 비율은 4 epoch + 6 epoch이 가장 좋았습니다.
Stage 1이 너무 짧으면 latent가 visual information을 충분히 학습하지 못하고, 반대로 너무 길면 Stage 2에서 image와 latent를 함께 사용하는 방법을 충분히 학습하지 못한다고 합니다.
Latent token 개수는 4, 8, 16, 32개를 비교했고, 16개에서 가장 좋은 성능을 보였습니다.
너무 적으면 representation capacity가 부족하고, 너무 많으면 attention이 여러 latent에 분산되면서 오히려 학습이 어려워질 수 있다고 분석하는데 생각보다 성능차이가 많이 나는 것을 확인할 수 있습니다.
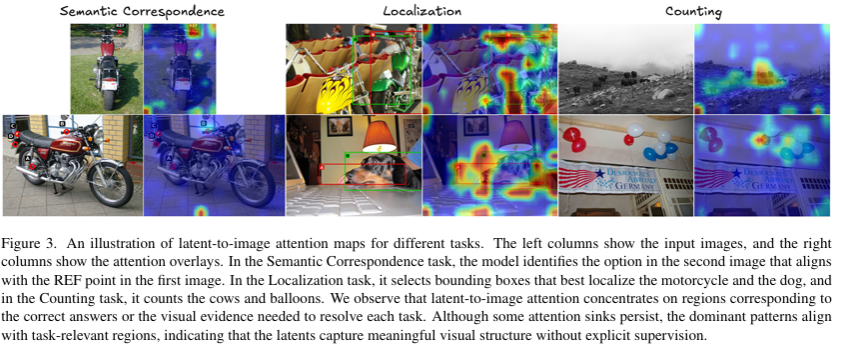
마지막으로 latent token이 실제 image의 어디를 attend하는지 시각화합니다.
Semantic Correspondence에서는 motorcycle의 handle처럼 서로 대응되는 부분을 찾고, Localization에서는 motorcycle이나 dog의 영역을 집중해서 보고, Counting에서는 세어야 하는 여러 object를 동시에 attend하는 모습을 보여줍니다.
즉 latent token에 어떤 visual target도 직접 supervision하지 않았음에도 불구하고, 각 task에서 필요한 visual structure를 서로 다르게 학습하고 있다는 것을 qualitative하게 보여줍니다.
Conclusion
본 논문에서는 별도의 intermediate supervision 없이 LMM의 visual reasoning을 강화하는 Latent Implicit Visual Reasoning(LIVR)을 제안했습니다.
정리하면 LIVR은 latent token과 visual bottleneck을 이용해 task-specific visual abstraction을 end-to-end로 학습할 수 있다는 점을 보여준, 단순하면서도 task-agnostic한 visual reasoning 방법인 것 같습니다.