안녕하세요. 오늘의 리뷰도 PRVR 관련 논문을 리뷰하고자 합니다. 이번 논문은 최근 PRVR 연구들에서 베이스라인으로 많이 사용되는 방법론입니다. 그럼 바로 리뷰 시작하겠습니다.
1. Introduction
최근 비디오가 주요 정보 전달 매체로 자리잡으면서 Text-to-Video Retrieval, T2VR 역시 꾸준히 주목받고 있습니다. T2VR은 하나의 text query가 주어졌을 때, 대규모 비디오 데이터베이스에서 해당 query와 의미적으로 가장 관련 있는 비디오를 찾는 문제입니다. 하지만 기존 T2VR 데이터셋은 대부분 하나의 비디오 전체가 query와 관련 있도록 미리 잘려 있는 pre-trimmed video를 사용합니다. 실제 YouTube와 같은 환경에서는 하나의 긴 영상 안에 여러 moment가 존재하고, query와 관련 있는 구간은 그중 일부에 불과합니다.
이러한 현실적인 환경을 반영하기 위해 Partially Relevant Video Retrieval, PRVR이 제안되었습니다. PRVR에서는 하나의 비디오가 여러 text query와 연결될 수 있고, 각각의 query는 비디오 전체가 아닌 특정 moment와 대응합니다.
기존 PRVR 방법들은 pretrained vision-language model을 이용해 frame과 word feature를 추출한 뒤, Transformer와 같은 sequential model을 통해 frame embedding과 sentence embedding을 생성합니다. 이후 multi-scale sliding window를 사용해 다양한 길이의 clip representation을 만들고, text와 frame, clip 사이의 similarity를 이용해 retrieval을 수행합니다.
저자는 이러한 기존 PRVR 방식에 두 가지 문제가 있다고 지적합니다.
첫 번째는 global frame interaction이 서로 다른 moment의 정보를 섞을 수 있다는 점입니다. 하나의 untrimmed video에는 서로 다른 내용을 가진 여러 moment가 존재하지만, 모든 frame이 서로 global하게 interaction하면 frame representation이 비슷해질 수 있습니다. 결국 query와 실제로 대응하는 temporal region을 정확하게 구분하기 어려워진다는 주장입니다.
두 번째는 explicit clip modeling에서 많은 중복 정보가 발생한다는 점입니다. 기존 방식은 multi-scale sliding window를 이용해 가능한 clip을 광범위하게 생성합니다. 예를 들어 PRVR을 처음 제안한 방법론인 MS-SL에서는 32개의 frame feature로부터 528개의 clip embedding을 생성하지만, TVR에서 실제 text와 관련된 clip은 평균적으로 약 5개에 불과합니다.
즉 temporal localization을 위해 많은 candidate clip을 만드는 대신, 대부분의 irrelevant clip까지 저장하고 비교하면서 storage overhead와 retrieval cost가 증가하게 됩니다.
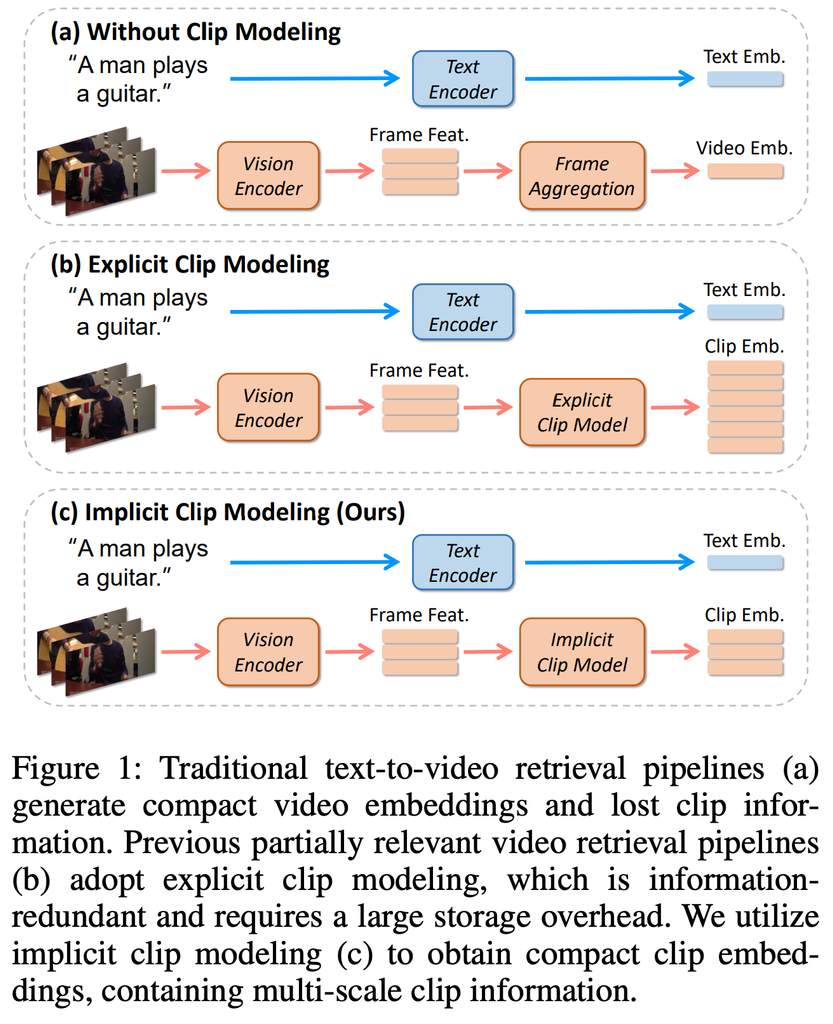
그림 1은 이러한 차이를 보여줍니다. 기존 T2VR 방식인 그림 1(a)는 frame을 하나의 video embedding으로 aggregation하기 때문에 세부적인 clip 정보를 잃을 수 있습니다. 반면 기존 PRVR 방식인 그림 1(b)는 여러 clip을 explicit하게 생성해 local information을 보존하지만, 많은 redundant representation이 발생합니다.
저자는 이를 해결하기 위해 그림 1(c)의 implicit clip modeling을 제안합니다. 핵심은 실제 clip을 하나하나 생성하지 않고도 여러 temporal scale의 정보를 representation 안에 포함시키는 것입니다.
이를 위해 GMMFormer, 즉 Gaussian-Mixture-Model 기반 Transformer를 제안합니다.
GMMFormer의 기본적인 motivation은 하나의 video moment가 시간적으로 연속되어 있다는 점입니다. 특정 frame을 이해할 때 전체 video의 모든 frame을 동일하게 참고하기보다는, 가까운 frame에 더 집중하는 것이 자연스럽다는 것이죠.
저자는 이를 Gaussian distribution으로 모델링합니다. GMMFormer block에서는 frame interaction에 multi-scale Gaussian constraint를 적용해 각 frame이 서로 다른 범위의 주변 frame을 바라보도록 합니다. 작은 Gaussian window는 짧은 temporal context를 모델링하고, 큰 window는 더 긴 범위를 모델링합니다. 이후 여러 scale에서 얻은 feature를 aggregation하여 다양한 길이의 moment 정보를 포함하는 compact clip embedding을 생성합니다.
따라서 기존 방식이
Frame → 여러 Clip 직접 생성 → Clip별 representation 저장
방식이었다면, GMMFormer는
Frame → Multi-scale Gaussian interaction → Compact clip representation
방식으로 clip 정보를 implicit하게 모델링합니다.
저자는 text representation에서도 한 가지 문제를 추가로 지적합니다.
PRVR에서는 하나의 video에 여러 query가 연결되지만, 각 query는 서로 다른 moment를 설명하기 때문에 의미적으로는 상당히 다를 수 있습니다. 하지만 기존 triplet ranking loss나 InfoNCE loss는 이러한 query들을 동일한 video의 positive sample로 취급하면서 embedding space에서 서로 가까워지도록 만듭니다.
저자는 이 과정이 서로 다른 query의 semantic structure를 흐릴 수 있다고 보고, Query Diverse Loss를 제안합니다. 같은 video와 연결된 query라도 서로 다른 내용을 설명한다면 embedding space에서 일정 수준 구분되도록 만들어 보다 discriminative한 sentence representation을 얻는 방식입니다.
결국 GMMFormer는 크게 두 부분으로 정리할 수 있습니다.
첫 번째는 multi-scale Gaussian interaction을 통해 clip을 직접 생성하지 않고 temporal information을 모델링하는 것입니다.
두 번째는 Query Diverse Loss를 통해 동일한 video에 연결된 query들의 semantic diversity를 유지하는 것입니다.
결국 이 논문의 핵심은 기존 PRVR처럼 많은 clip을 직접 생성하지 않고도, Gaussian 기반의 local interaction을 통해 다양한 temporal scale의 정보를 효율적으로 표현할 수 있다는 것입니다.
각 모듈의 구체적인 구조는 방법론 파트에서 자세히 살펴보겠습니다.
2. Methodology
방법론에서는 먼저 PRVR 문제를 정의한 뒤, GMMFormer의 전체 구조를 살펴보겠습니다. 이후 핵심 모듈인 GMMFormer Block과 학습에 사용되는 loss를 순서대로 설명하겠습니다.
2.1 Problem Formulation
PRVR은 하나의 text query가 주어졌을 때, 해당 query와 의미적으로 관련된 moment를 포함하는 video를 대규모 untrimmed video database에서 찾는 문제입니다.
하나의 video에는 여러 moment가 존재하고, 각 moment를 설명하는 여러 text query가 연결되어 있습니다. 중요한 점은 PRVR에서는 각 moment의 시작과 종료 시점에 대한 annotation이 주어지지 않는다는 것입니다.
즉 모델은 단순히 video와 text가 관련 있는지를 판단하는 것뿐만 아니라, 별도의 temporal supervision 없이 query와 관련된 구간까지 representation 안에서 찾아낼 수 있어야 합니다.
2.2 Overview
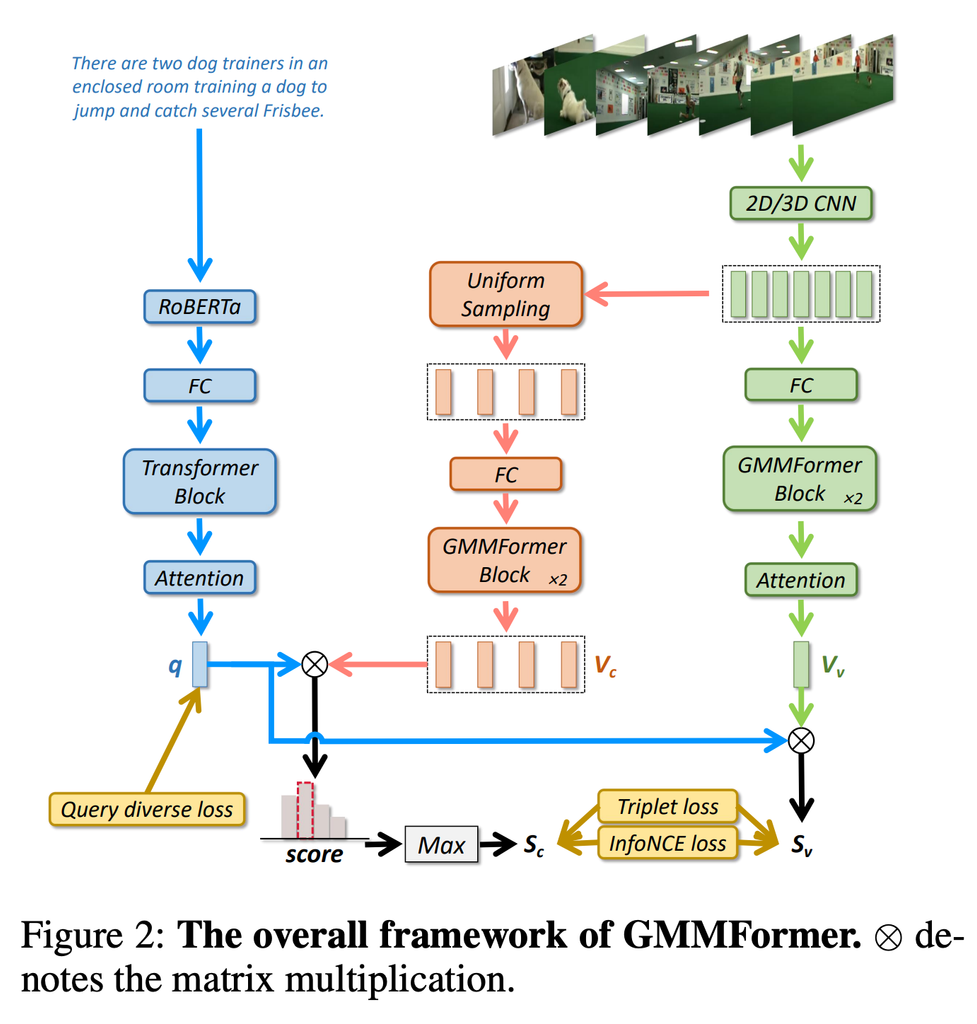
그림 2는 GMMFormer의 전체 구조입니다. 크게 Sentence Representation, Video Representation, Similarity Measure의 세 부분으로 구성됩니다.
먼저 Sentence Representation부터 보겠습니다.
입력 문장은 pretrained RoBERTa를 통해 word feature로 변환됩니다. 이후 FC layer와 ReLU를 이용해 feature dimension을 줄이고, positional embedding을 추가한 뒤 일반적인 Transformer를 통과시킵니다. 여기에서는 GMMFormer Block을 사용하지 않습니다. GMMFormer는 여러 moment가 포함된 untrimmed video의 temporal structure를 모델링하기 위해 설계되었기 때문입니다. 마지막으로 attention을 이용해 여러 word feature의 중요도를 계산하고, 이를 weighted sum하여 하나의 sentence embedding (q) 를 생성합니다.
다음은 Video Representation입니다. 입력 video는 먼저 pretrained 2D 또는 3D CNN을 이용해 frame feature를 추출합니다. 이후 video representation은 두 개의 branch로 나뉩니다.
하나는 clip-level branch, 다른 하나는 video-level branch입니다.
Clip-level branch의 목적은 query와 관련된 local moment를 찾는 것입니다. 먼저 연속된 frame feature를 mean pooling하여 일정한 개수의 feature로 uniform sampling합니다. 이후 FC layer를 거쳐 dimension을 줄이고, positional embedding과 두 개의 GMMFormer Block을 적용해 clip embeddings (Vc) 를 생성합니다. 여기서 중요한 점은 기존 방식처럼 여러 길이의 clip을 sliding window로 직접 생성하지 않는다는 것입니다. GMMFormer 내부에서 다양한 temporal range를 모델링하기 때문에 compact한 embedding 안에 multi-scale clip information을 포함할 수 있습니다.
Video-level branch는 video 전체의 global representation을 만드는 역할을 합니다. Frame feature에 FC layer와 두 개의 GMMFormer Block을 적용한 뒤, attention을 통해 frame별 중요도를 계산합니다. 이를 weighted sum하여 하나의 video embedding (Vv) 를 생성합니다. 결국 하나의 video에서 Clip-level representation (Vc) 는 local moment를 찾고, Video-level representation (Vv) 는 video 전체와 text의 global semantic similarity를 판단합니다.
Similarity Measure
Text와 video 사이의 similarity 역시 두 가지 관점에서 계산합니다.
먼저 video-level similarity (Sv) 는 sentence embedding (q)와 video embedding (Vv) 사이의 cosine similarity로 계산합니다.
반면 clip-level similarity (Sc) 는 sentence embedding과 각각의 clip embedding 사이의 cosine similarity를 계산한 뒤, 그중 가장 높은 값을 선택합니다.
쉽게 말하면 Video-level similarity는 “이 문장과 영상 전체가 얼마나 관련 있는가?”를 보고, Clip-level similarity는 “영상 내부에 이 문장과 강하게 대응하는 moment가 존재하는가?”를 보는 것입니다.
최종 text-video similarity는 이 두 similarity를 가중합하여 계산합니다.
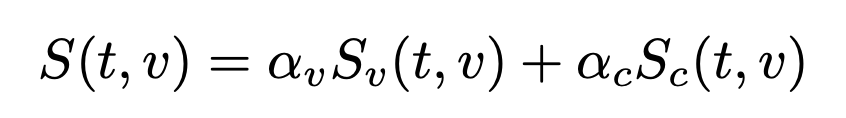
따라서 GMMFormer는 local moment와 global video semantics를 동시에 사용해 retrieval을 수행합니다.
2.3 GMMFormer Block
이제 이 논문의 핵심인 GMMFormer Block을 살펴보겠습니다.
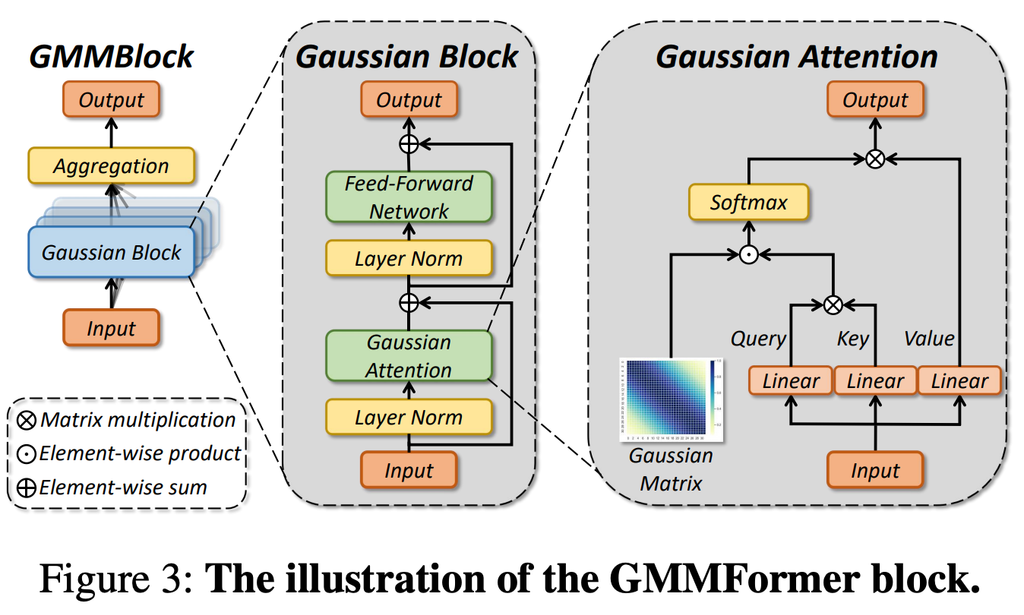
기본적인 출발점은 Transformer의 self-attention입니다. 일반적인 self-attention에서는 하나의 frame이 video 안의 모든 frame을 바라볼 수 있습니다. 하지만 앞에서 설명했듯 이러한 global interaction은 서로 다른 moment의 정보를 섞을 수 있습니다. 그래서 GMMFormer에서는 attention에 Gaussian constraint를 추가합니다.
입력 feature는 기존 Transformer와 마찬가지로 Query, Key, Value로 projection됩니다. 이후 Query와 Key를 이용해 attention score를 계산하는데, 여기에 별도로 만든 Gaussian Matrix를 element-wise product합니다. Gaussian Matrix의 중심은 현재 frame에 위치합니다. 따라서 현재 frame과 가까운 위치에는 큰 값이 주어지고, 시간적으로 멀어질수록 값이 작아집니다. 즉 기존 self-attention이 모든 frame을 자유롭게 참고하는 구조였다면, Gaussian attention은 현재 frame 주변의 temporal context에 더 집중하는 구조라고 볼 수 있습니다.
이후 Gaussian constraint가 적용된 attention score에 softmax를 적용하고 Value와 결합합니다. 나머지는 일반적인 Transformer와 비슷하게 FFN, residual connection, Layer Normalization을 사용합니다.
그런데 Gaussian window 하나만 사용하면 한 가지 길이의 temporal context만 모델링할 수 있다는 문제가 있습니다. 실제 video moment의 길이는 모두 다릅니다. 짧은 행동도 있고, 비교적 긴 event도 존재합니다. 이를 해결하기 위해 GMMFormer는 서로 다른 variance를 가진 여러 Gaussian Block을 병렬로 사용합니다.
논문에서는 총 4개의 Gaussian Block을 사용하며, 각각 low, medium, high, infinite variance를 사용합니다.
작은 variance를 가진 Gaussian은 가까운 frame에 집중하기 때문에 짧은 temporal pattern을 모델링하고, 큰 variance는 더 넓은 범위를 참고합니다. Infinite variance는 사실상 global interaction에 가까운 정보를 제공합니다. 마지막으로 각 Gaussian Block의 출력을 average pooling하여 하나의 representation으로 통합합니다.
2.4 Learning
학습에서는 video 안에 text와 관련된 moment가 존재하면 positive pair, 관련된 내용이 없으면 negative pair로 정의합니다. 기본 retrieval loss로는 Triplet Ranking Loss와 InfoNCE Loss를 사용합니다.
Triplet Ranking Loss는 positive text-video pair의 similarity가 negative pair보다 일정 margin 이상 높아지도록 학습합니다. 학습 초기에는 mini-batch 내부에서 negative sample을 random하게 선택하고, 20 epoch 이후부터는 similarity가 높은 hard negative sample을 사용합니다.
InfoNCE Loss 역시 positive text-video pair의 similarity를 높이고, mini-batch 내부의 여러 negative pair와는 멀어지도록 학습하는 역할을 합니다. 이 두 loss는 각각 clip-level similarity와 video-level similarity에 모두 적용됩니다. 여기에 GMMFormer는 Query Diverse Loss를 추가합니다.
PRVR에서는 하나의 video에 여러 text query가 연결되어 있지만, 각 query는 서로 다른 moment를 설명할 수 있습니다. 예를 들어 하나의 video에 “남자가 문을 연다”, “남자가 의자에 앉는다”라는 두 query가 존재한다면 같은 video에 연결되어 있더라도 semantic information은 분명히 다릅니다. 하지만 기존 retrieval loss만 사용하면 같은 video와 연결되어 있다는 이유로 이러한 query representation들이 지나치게 가까워질 수 있습니다.
Query Diverse Loss는 이를 반대로 처리합니다.
같은 video와 연결되어 있더라도 서로 다른 query라면 embedding space에서 서로 일정 거리 떨어지도록 학습합니다. 이를 통해 sentence embedding들이 하나의 영역에 몰리는 것을 막고, 각 query가 가진 semantic information을 유지하도록 합니다.
최종 loss는 다음과 같이 구성됩니다.
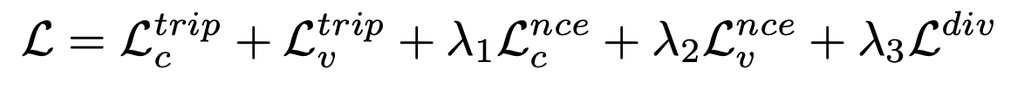
여기서 (c)는 clip-level, (v)는 video-level을 의미합니다.
정리하면 GMMFormer의 학습은 Triplet Ranking Loss를 통한 positive-negative 구분, InfoNCE Loss를 통한 contrastive learning, Query Diverse Loss를 통한 query semantic diversity 유지의 세 방향으로 이루어집니다. 결국 GMMFormer의 핵심은 Gaussian constraint를 이용해 frame interaction의 temporal range를 조절하고, 서로 다른 scale의 결과를 결합해 explicit clip construction 없이 multi-scale moment information을 얻는 것입니다. 여기에 clip-level과 video-level retrieval을 함께 사용하고, Query Diverse Loss를 통해 text representation까지 보완하는 구조입니다.
3. Experiments
3.1 Experimental Setup
GMMFormer는 TVR, ActivityNet Captions, Charades-STA의 세 가지 데이터셋에서 평가합니다. 세 데이터셋 모두 원래 moment annotation을 제공하지만, PRVR 설정에서는 이 정보를 사용하지 않습니다.
TVR은 약 21.8K개의 video로 구성되어 있으며, 하나의 video마다 서로 다른 moment를 설명하는 5개의 문장이 연결되어 있습니다. ActivityNet Captions는 약 20K개의 YouTube video로 구성되고, video당 평균 3.7개의 moment가 존재합니다. Charades-STA는 6,670개의 video와 16,128개의 text description으로 구성되며, video당 평균 2.4개의 moment를 포함합니다.
비교 대상은 크게 세 종류입니다.
먼저 기존 T2VR 모델, 그리고 video retrieval과 moment localization을 함께 수행하는 VCMR 모델, 마지막으로 PRVR 전용 모델인 MS-SL과 비교합니다. VCMR 모델의 경우 PRVR에서는 moment annotation을 사용할 수 없기 때문에 moment localization module을 제거하고 동일한 video feature를 사용해 다시 학습합니다. 평가 지표는 R@1, R@5, R@10, R@100을 사용합니다. 또한 전체적인 retrieval 성능을 보기 위해 네 Recall 값을 더한 SumR도 함께 사용합니다.
3.2 Main Results
먼저 retrieval 성능부터 보겠습니다.
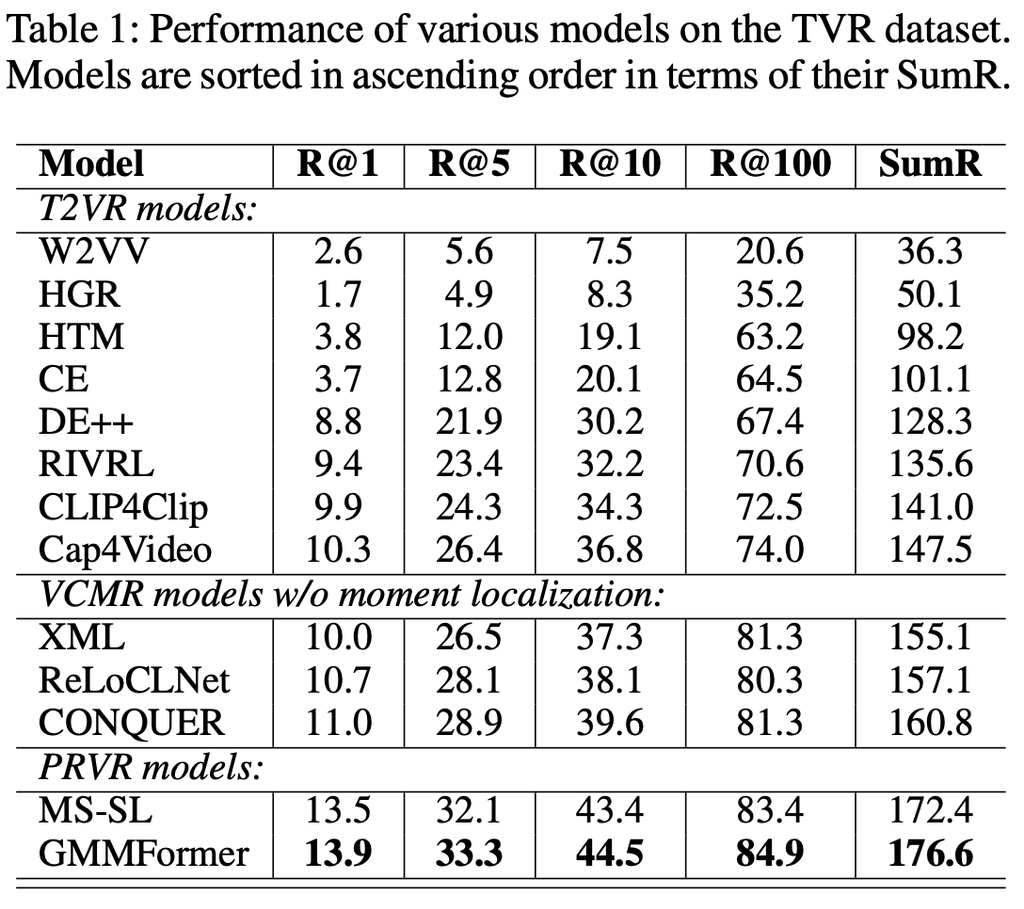
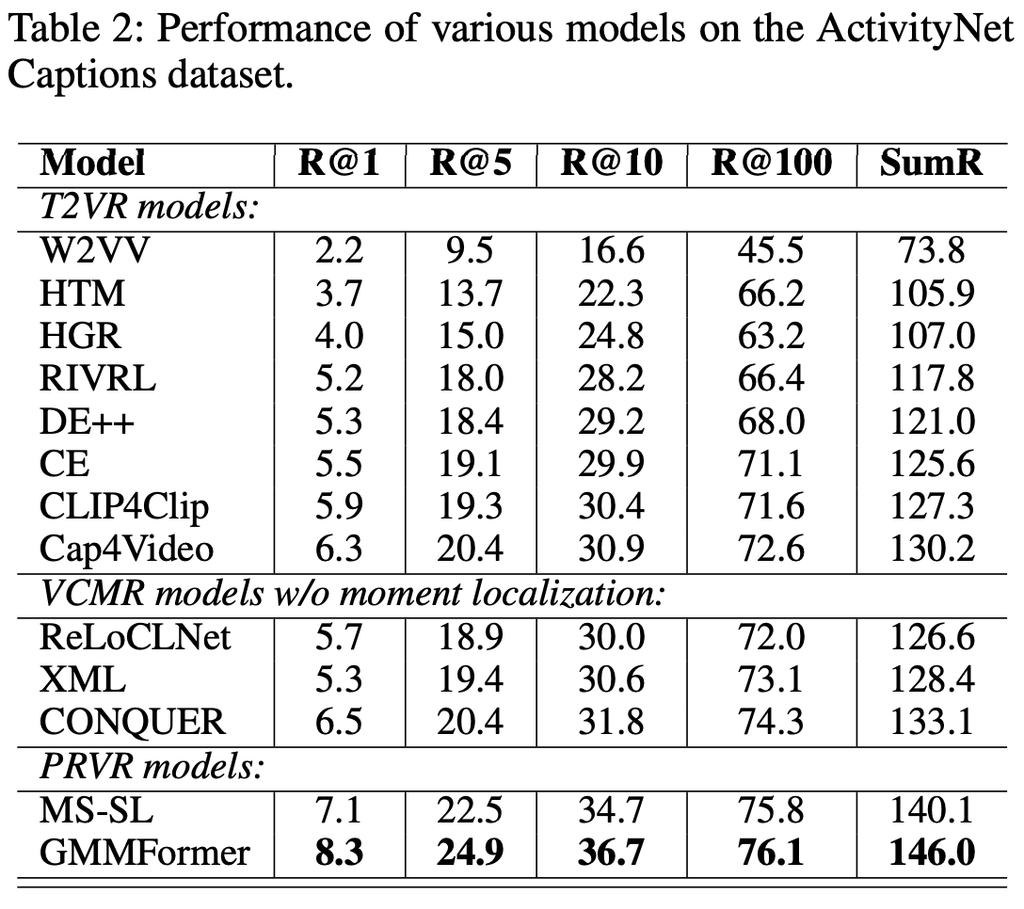
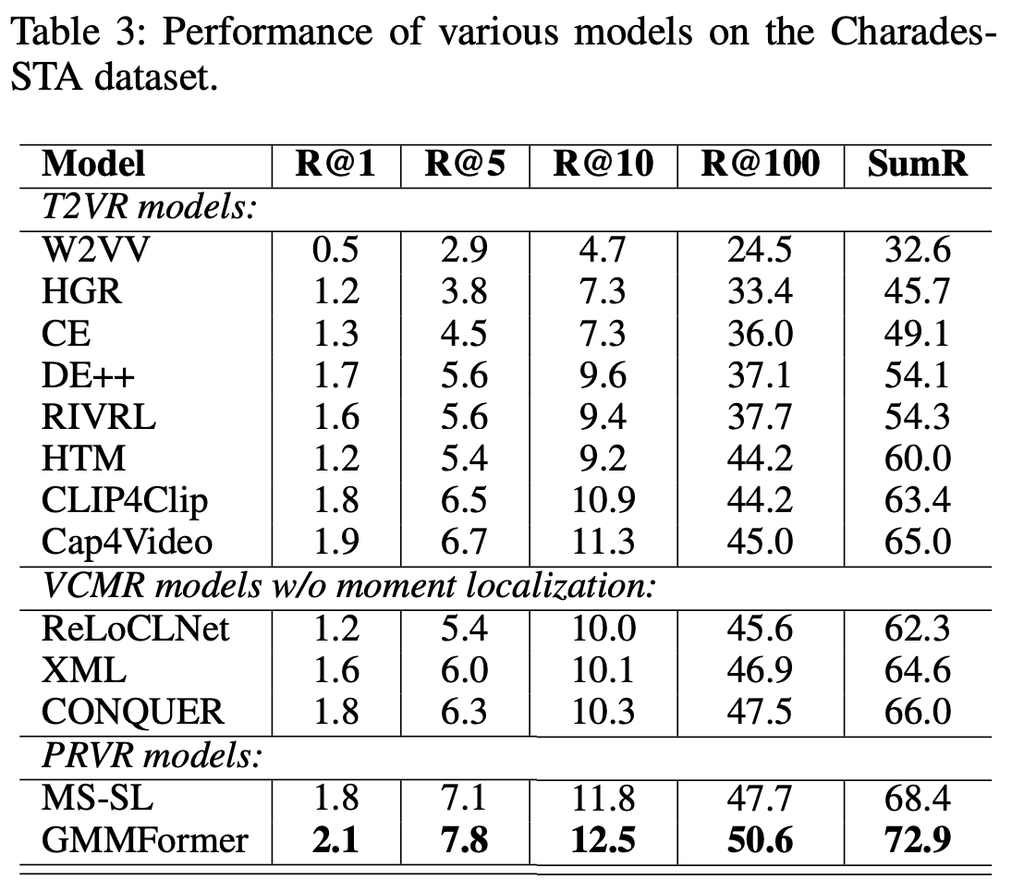
TVR, ActivityNet Captions, Charades-STA의 세 데이터셋에서 공통적으로 T2VR 모델보다 VCMR과 PRVR 모델의 성능이 높게 나타납니다. T2VR은 video 전체와 text의 global relevance를 중심으로 학습하기 때문에, video 일부만 query와 관련 있는 PRVR 환경에서는 한계가 있습니다. 반면 PRVR 모델은 clip-level information을 직접 활용하기 때문에 부분적인 text-video relevance를 더 잘 모델링할 수 있습니다. 그중 GMMFormer는 세 데이터셋 모두에서 최고 성능을 달성합니다.
저자는 이러한 성능 향상의 원인을 크게 두 가지로 봅니다.
첫 번째는 multi-scale Gaussian Block이 서로 다른 길이의 video moment를 모델링할 수 있다는 점이고, 두 번째는 Query Diverse Loss가 text representation의 semantic structure를 유지한다는 점입니다.
Retrieval Efficiency
다음은 모델의 효율성을 살펴보겠습니다.
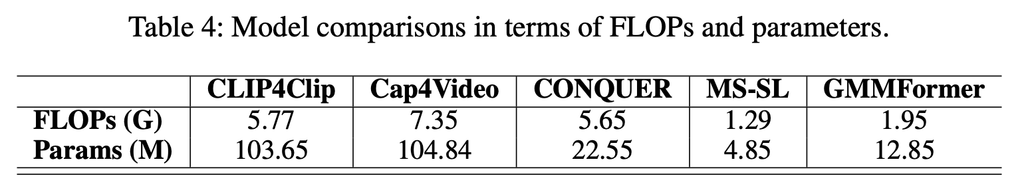
FLOPs와 parameter 수만 보면 GMMFormer는 MS-SL보다 다소 큽니다.
MS-SL은 4.85M parameter와 1.29 GFLOPs를 사용하는 반면, GMMFormer는 12.85M parameter와 1.95 GFLOPs를 사용합니다.
이는 여러 Gaussian Block을 병렬로 사용하기 때문입니다.
다만 Gaussian Block은 video branch에 위치하기 때문에 video representation은 retrieval 전에 미리 계산해 둘 수 있습니다. 따라서 실제 retrieval 과정에서는 모델 자체의 FLOPs보다 저장해야 하는 video representation의 크기와 query당 similarity computation 비용이 더 중요합니다.
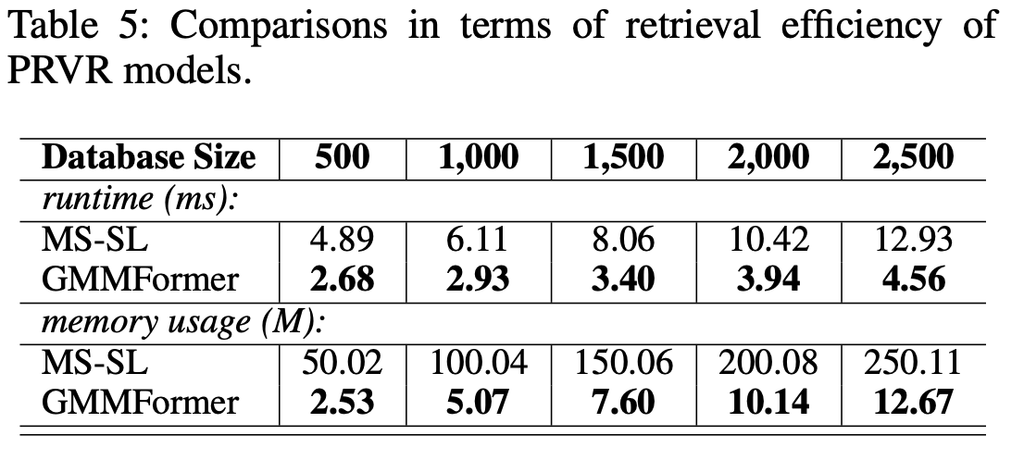
실제 retrieval 환경에서 MS-SL과 비교하면 차이가 크게 나타납니다. Database가 2,500개의 video로 구성된 경우 MS-SL은 약 12.93ms가 필요한 반면, GMMFormer는 4.56ms가 걸립니다. Memory usage 역시 MS-SL은 약 250MB를 사용하지만 GMMFormer는 약 12.67MB만 사용합니다.
전체적으로 보면 GMMFormer가 MS-SL보다 약 2.5배 빠르고, storage overhead는 약 20배 작습니다. 결국 explicit하게 수많은 clip embedding을 저장하지 않고 compact representation 안에 clip information을 포함시키는 implicit clip modeling의 장점이 실제 retrieval 효율에서도 나타난다고 볼 수 있습니다.
3.3 Ablation Study
먼저 GMMFormer Block과 Query Diverse Loss의 효과를 확인합니다.
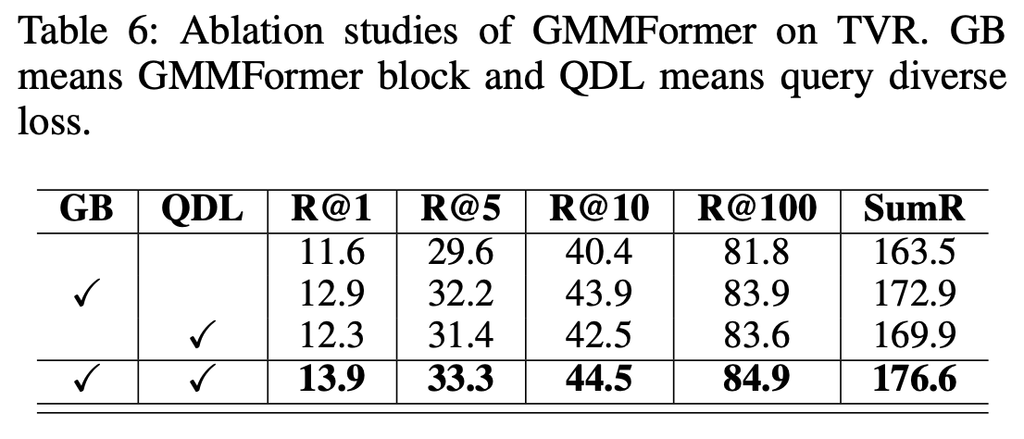
두 모듈을 모두 제거하고 vanilla Transformer만 사용하면 SumR은 163.5입니다. 여기에 GMMFormer Block만 추가하면 172.9, Query Diverse Loss만 추가하면 169.9까지 증가합니다. 두 모듈을 모두 사용한 full setup에서는 176.6으로 가장 높은 성능을 보입니다. 따라서 GMMFormer Block과 Query Diverse Loss가 각각 독립적으로 성능 향상에 기여하고 있으며, 함께 사용할 때 가장 좋은 결과가 나타납니다.
Multi-scale Gaussian Block
다음으로 서로 다른 Gaussian scale이 실제로 각기 다른 길이의 moment를 담당하는지 확인합니다.
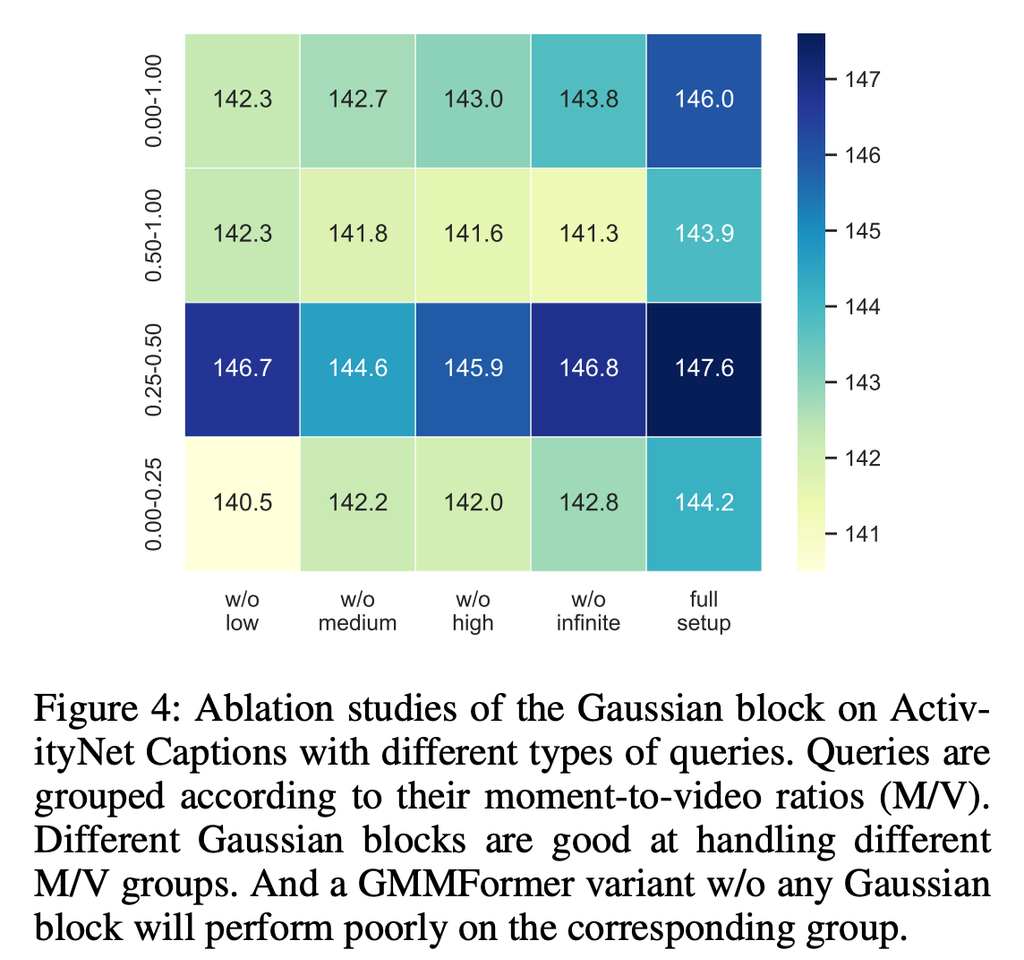
이를 위해 query가 대응하는 moment 길이를 전체 video 길이로 나눈 Moment-to-Video Ratio, M/V를 사용합니다. M/V가 작으면 짧은 moment를 의미하고, 값이 커질수록 query가 video의 더 긴 구간과 관련 있다는 뜻입니다.
실험 결과 짧은 moment가 많은 0.00-0.25 구간에서는 low-variance Gaussian Block을 제거했을 때 성능이 가장 크게 떨어집니다. 반대로 중간 길이의 moment에서는 medium Gaussian이 중요하고, 긴 moment에서는 high 또는 infinite Gaussian을 제거했을 때 성능 감소가 크게 나타납니다. 즉 단순히 여러 Gaussian을 추가한 것이 아니라, 각 Gaussian scale이 서로 다른 길이의 temporal pattern을 실제로 담당하고 있음을 보여주는 실험입니다.
Constraint Window
다음은 Gaussian 자체가 중요한지를 확인하기 위해 constraint window의 형태를 비교합니다.
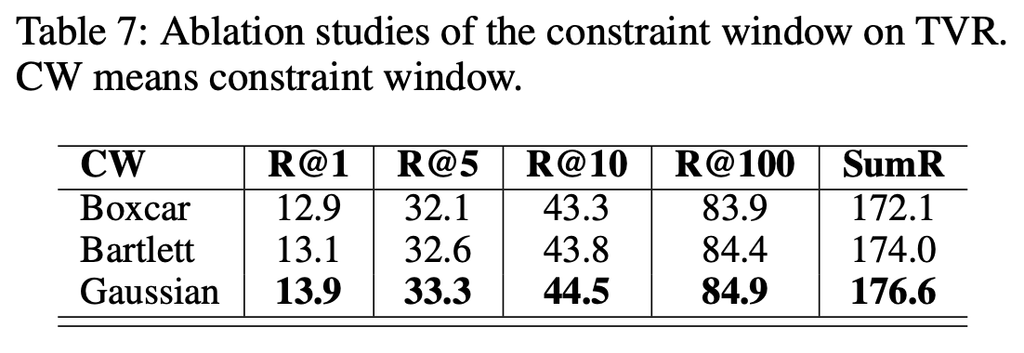
Boxcar, Bartlett, Gaussian의 세 가지 window를 비교한 결과 SumR은 각각 172.1, 174.0, 176.6으로 Gaussian이 가장 높은 성능을 보입니다. Boxcar는 window 내부의 frame을 동일하게 처리하지만, Gaussian은 현재 frame과 가까운 위치에 더 높은 weight를 주고 거리가 멀어질수록 자연스럽게 감소합니다. 따라서 가까운 frame을 더 중요하게 본다는 GMMFormer의 기본 가정에는 Gaussian 형태가 가장 적합하다는 것을 보여줍니다