안녕하세요. 오늘은 soft-token 방식으로 기하학적 정보를 VLM에 주입시켜주는 논문을 가져왔습니다. 바로 한번 시작해보겠습니다
Introduction
Goal-directed navigation에서는 미리 만들어준 지도 없이 처음 보는 3D 환경에서도 text로 주어진 목표를 찾아야합니다. 특히 최근 벤치마크들은 OVOD처럼 open vocab로 목표로 찾도록 평가하기 때문에 3D understanding과 판단이 더 중요해졌습니다. 그래서 결국 어떻게 3D 정보를 더 잘 들고 올까? 가 중요해졌습니다.
이러한 상황에서 크게 두가지 방향으로 발전해왔습니다. 첫번째는 Module식 접근입니다. 두가지 모듈인 perception과 planning으로 분리하는 방식입니다. 그리고 다른 방식은 VLM을 이용하여, 경로를 예측하는 방식입니다. VLM 기반의 방식은 특히 공간적 이해가 부족합니다. 이러한 문제를 해결하기 위해서는 vqa로 fine-tune하거나, scene graph, 문자열로 요약해서 전달 등의 방식이 존재합니다. 그러나 저자들은 이렇게 공간적 정보를 주는것에 대한 손실이 정량적으로 측정된적이 없다고 합니다.
저자들은 결국 3D 정보를 얼마나 잘 추출하는가뿐만 아니라, 이를 VLM에 어떤 형태로 전달하는가가 중요하다고 봅니다. 그래서 3D scene encoder인 PQ3D가 추출한 feature를 텍스트로 변환하지 않고, VLM이 직접 처리할 수 있는 soft token으로 전달하는 SoftNav를 제안합니다.
물체와 탐색 후보 지점인 frontier의 feature를 작은 MLP로 변환하여, 영상 정보 및 목표를 설명하는 텍스트와 함께 VLM에 입력하는 방식입니다. 이를 통해 VLM이 3D 공간 정보와 목표를 함께 고려하여 다음에 어디를 탐색할지 판단하도록 합니다. 또한 동일한 3D encoder와 VLM을 사용하는 조건에서 텍스트로 전달하는 방식과 feature를 직접 전달하는 방식을 비교하여, 정보 전달 방식에 따른 성능 차이를 정량적으로 확인합니다.
즉, 기존 3D 모델의 공간 이해 능력을 VLM의 판단에 직접 활용하고, 이러한 연결 방식이 실제 navigation 성능 향상으로 이어지는지를 검증하는 것이 이 논문의 핵심입니다. 자세한 구조와 학습 방식은 아래에서 설명하겠습니다.
Methods
Softnav에 대해 설명하기 전에 뭔가 PQ3D에 대해서 간략하게 설명하겠습니다. PQ3D는 3D scene과 prompt를 받아, 요청에 관련된 물체 정보를 query로 모으는 모델입니다. 예를 들면, 3D scene과 모니터 옆의 인형을 찾아라라고 프롬프트를 주면 해당 정보를 query로 모읍니다. Softnav는 이 PQ3D을 3D 정보를 주기 위한 백본으로 사용합니다.
A. System Overview
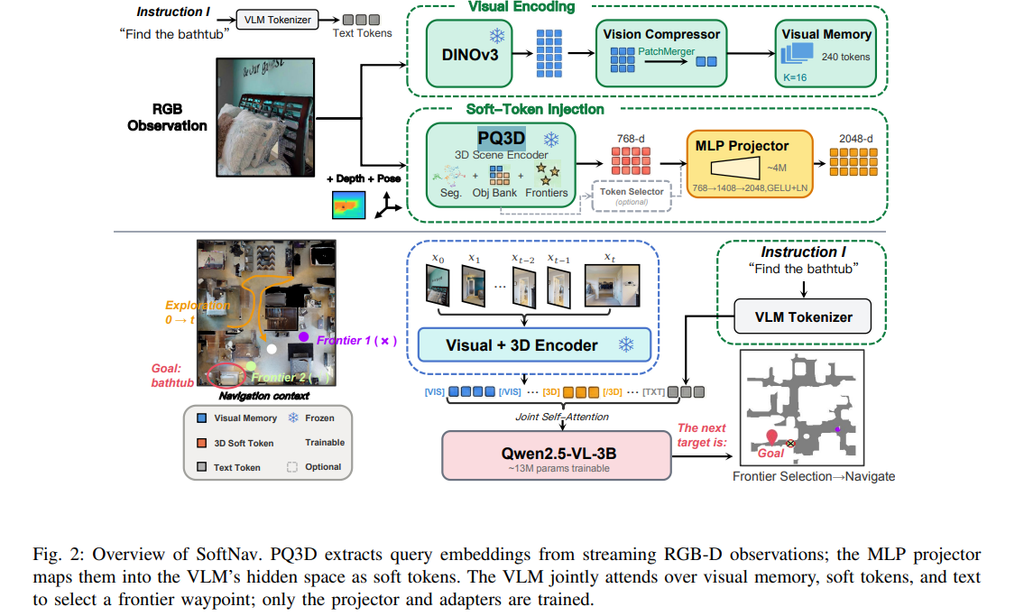
위 그림은 Softnav의 전체 파이프라인입니다. 연속적 Streaming RGB-D는 Visual Encoding(DINOv3쪽)과 3D stream(PQ3D 쪽)을 병렬로 거칩니다. 그리고 텍스트 navigation prompt와 함께 VLM의 latent token과 결합됩니다.
Visual Encoding쪽에서는 DINOv3의 embedding을 PatchMerger를 사용하여(학습 필요 없음) 압축된 visual token을 만듭니다. PatchMerger가 한 RGB-D를 15개의 토큰으로 만들기 때문에 16개의 RGB-D는 240개의 압축된 visual token으로 표현할 수 있습니다.
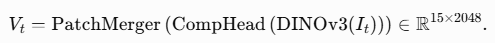
3D Stream쪽에서는 PQ3D를 통해 누적된 RGB-D 관측에서 object와 frontier의 query를 추출합니다. 이를 MLP를 태워 VLM에 입력가능한 soft token으로 만들어줍니다. 해당 과정에서 학습되는 곳은 MLP쪽이 유일합니다. 즉, frozen PQ3D의 output을 MLP를 이용하여 VLM의 분포로 옮기는 작업을 진행합니다. 차원은 768에서 2048으로 만들어줍니다.
VLM backbone은 Qwen2.5-VL-3b를 사용하고, 위에서 만든 토큰들과 token prompt까지 다 넣고 통과시켜, 최종 frontier waypoint를 선택합니다. 이 과정에서 Qwen에는 LoRA adapter를 붙여 학습시킵니다.
B. PQ3D 3D Scene Encoder
해당 연구에서는 embodied navigation에 맞는 PQ3D를 사용하였습니다. PQ3D는 streaming RGB-D로부터 3D instance segmentation을 수행하고, 관측한 물체를 지속적으로 저장하는 object bank를 가지고 있으며, Occupancy map에서 탐색을 위한 frontier를 검출합니다(Frontier는 갈 수 있어 보이는 미개척 영역입니다). 이 과정을 통해 각 object와 frontier에 대해 768차원의 embedding을 만듭니다.
C. Soft-Token Injection
결국 PQ3D가 뽑아낸 object와 frontier 정보를 VLM에 효율적으로 전달해야합니다. 저자들은 이를 위해 Projector와 LoRA를 학습시킵니다(파이프라인에서 유일한 학습 부분입니다).
먼저 Projector는 간단한 MLP를 선택하였습니다. 저자는 이에 대해 2가지 이유를 밝힙니다. 첫번째는 학습 데이터가 1187개 밖에 되지 않기 때문에 파라미터 수가 많은 Cross-attn.을 선택하지 않았다고 밝혔습니다.
두번째로는 이미 PQ3D의 query가 풍부한 semantic 정보를 가지고 있기 때문에 큰 alignment 차이가 없다고 얘기하였습니다. 이에 대한 근거로는 LLaVA가 MLP만으로 충분히 align한걸 들었습니다.
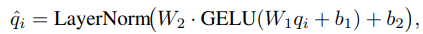
visual memory tokens M_t, text token \tau이라고 표기할때, 먼저 텍스트 토큰에서 M_t, \tau에 대한 placeholder를 잡아둔 이후, M_t, soft query, \tau순으로 넣어줍니다. 그리고 soft query 내부에서는 frontier token을 object token보다 앞에 넣습니다.
D. Frontier Decision
VLM이 최종 좌표를 생성하면, 이를 그래도 navigation target으로 사용하지 않습니다. occupancy map에서 찾은 frontier waypoint중 조건을 만족하는 가장 가까운 지점으로 보정합니다. 이를 통해서, 항상 도달가능하며(라고 저자는 표현하는데 조금 과한거 같긴합니다..), 탐색과 미탐색의 경계로 가도록 합니다.
E. Training Strategy
Visual encoder, PQ3D, VLM backbone은 전부 frozen하고, MLP projector와 VLM의 attention 및 feed-forward layer에 적용한 LoRA만 학습시킵니다. 학습에는 OVON training scene에서 MTU3D가 성공적으로 수행한 episode(성공적으로 목표물체를 찾은것)로부터 수집한 약 1,200개의 supervised sample을 사용했습니다.
각 sample의 정답은 해당 상황에서 MTU3D가 선택한 frontier의 좌표입니다. 예를 들어 MTU3D가 선택한 좌표가 (0.5, 3.2)라면, 이를 “0.5, 3.2″라는 문자열로 만들어 VLM이 출력하도록 학습합니다. 즉, 좌표 자체에 regression loss를 적용하는 것이 아니라, 일반적인 LLM 학습처럼 정답 좌표 문자열의 다음 token을 예측하는 cross-entropy loss를 사용합니다.
Experiments
Experiment Setup
저자들은 3가지 벤치마크에서 평가하였습니다. 전부 Habitat simulator입니다.
1. HM3D-OVON은 open-vocabulary object-goal nav를 평가하며, 3개의 validation split으로 되어있습니다.
2. GOAT-Bench는 multimodal lifelong nav(여러 목표 연속적으로 수행)하는 task입니다.
3. SG3D는 scene graph에 기반한 sequential nav를 평가합니다.
Comparison with Prior Methods
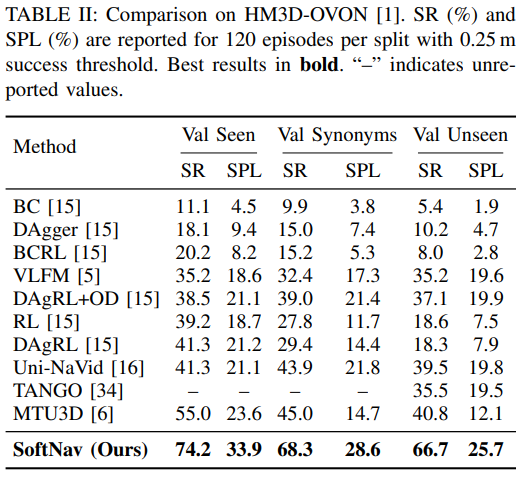
먼저 OVOD에서의 결과입니다. 기존의 방법들보다 일관되게 성능이 높은것을 확인할 수 있습니다. 저자들은 이는 기존 방법들이 3D perception이나 VLM reasoning이 부족한 반면, softnav는 둘다 챙겼기 때문이라고 얘기합니다. 특히 val_unseen에서도 좋은 향상을 보인 점에 대해 적은 데이터로 학습했어도 VLM의 사전지식을 충분히 사용했기에 일반화 성능이 있다고 주장합니다.
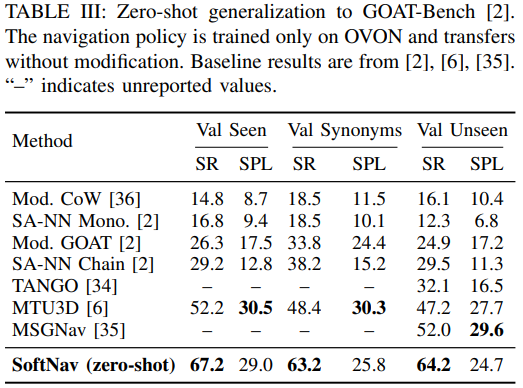
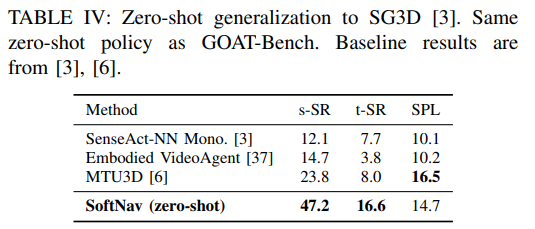
Table 3,4는 zero-shot 결과입니다. GOAT bench에서는 일반적으로 SR(Success rate)에서는 가장 높고, SPL(Success weighted by Path Length, 경로 효율적으로 갔는지에 대한 지표)는 SOTA까지는 아니여도 높은 성능을 보입니다. 이는 새로운 환경에서는 높은 성공률을 보여주기는 하지만 경로적으로는 다소 긴 경로를 따라가는 것을 보여줍니다. SG3D에서도 비슷하게 SR은 높은 반면 SPL은 약간 낮은 성능을 보여줍니다.
Ablation & Baseline
soft token의 효과를 확인하기 위해 baseline으로 text-hint를 사용합니다. 이는 PQ3D로 뽑은 3D 정보를 텍스트로 전달하는 방식입니다. 또한 LoRA나 추가학습 없이 사용합니다 그러면 LoRA에 의해 성능이 올랐다고 볼수 있기도 때문에 text-hint + LoRA도 보여줍니다. Rich-Text는 각 object의 텍스트에 거리, 방향, confident도 추가하여 rich하게 정보를 주면 representation gap을 줄일수있는지 확인합니다.
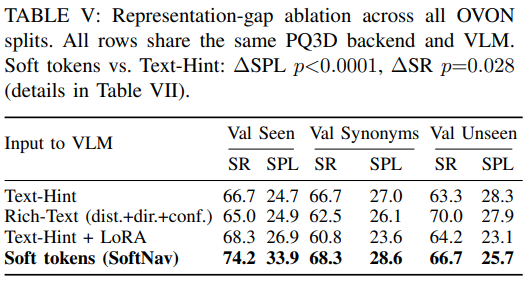
위 Table 5는 일관되게 SoftNav 방식을 지지합니다. 특히 Rich-Text 방식이 오히려 Text-Hint보다 안좋은 구간이 많은 것이 인상적입니다. 저자는 이는 representation gap이 정보의 양보다는 modality에서 비롯되었다고 얘기합니다.
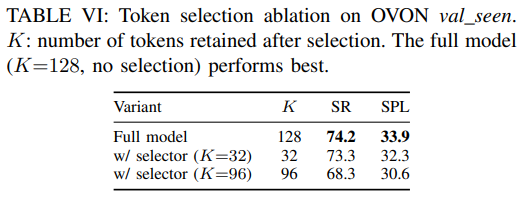
위 Table 6에서 w/ selector는 navigation instruction과 PQ3D query token사이의 cross-attention을 사용하여 projection전에 관련성이 높은 top-K 토큰을 선택합니다(저자들은 Instruction-Conditioned Token Selector)라고 부릅니다. PQ3D의 128개의 토큰 중 25%인 32개와, 75%인 96개를 쓰는 방식 둘다 원래의 방식보다 낮은 성능을 보였습니다. 이는 PQ3D의 query token들 전반에 정보를 담고 있기 때문에 selection하는 방식을 하면 정보가 손실된다는 것을 보여줍니다.
Analysis
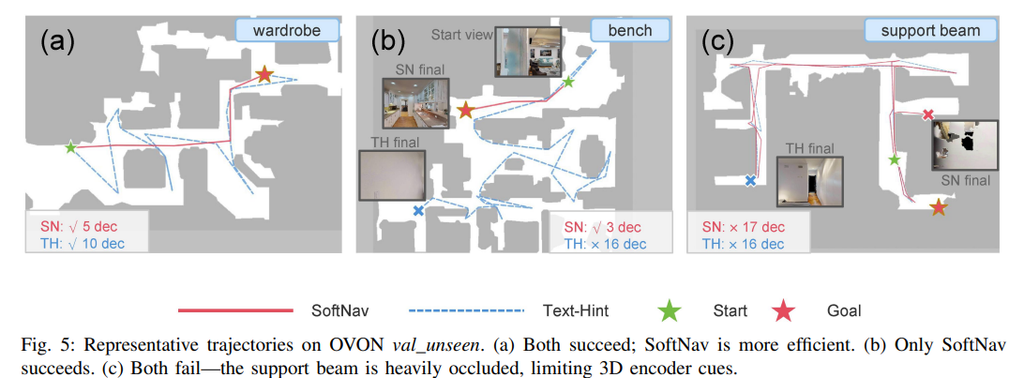
위 fig에서 파란 점선은 텍스트만 준 경우이고, 빨간 실선은 저자들의 softnav 방식입니다. 두 방식이 모두 성공한 (a)에서는 softnav는 더 효율적인 경로를 따릅니다. (b)에서는 softnav만 성공하고, text-hint는 실패한 경우입니다. 그리고 (c)는 둘다 실패한 경우입니다. (c)에서는 3D encoder가 제대로 검출하는데 실패하여 위와 같이 둘다 실패하였다고 얘기합니다.
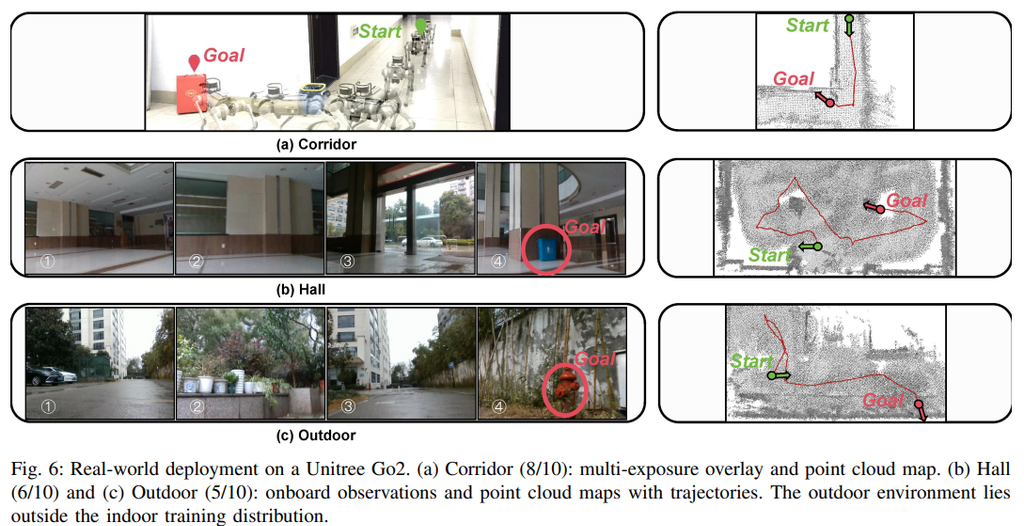
fig 6.는 real world에서 테스트한 결과입니다. 저자들은 Unitree Go2에 Realsense D435i를 달고 실험했습니다. 파인튜닝이나 Domain adapation없이 바로 진행했습니다(원래 simulation data로 학습했습니다). 위 그림처럼 3가지 환경에서 10 epsode씩 테스트했습니다.
(a) corridor에서는 8번 성공, 2번 실패하였고, (b)에서는 6번 성공, 4번 실패하였습니다. 그리고 (c)에서는 5번 성공, 5번 실패하였습니다. 다른 방법론과 비교하진 않았고, 저자들의 방법론만 실험하긴 하였으나, 저자들은 soft-token injection을 통하여 real-world에서도 modest한 성공률을 보인다는 것을 증명하였습니다.



안녕하세요 정우님, 좋은 리뷰 감사합니다.
3d scene encoder를 자연어 형태가 아닌 token/feature 단으로 넣어주는 것이 좋았다! 가 결론인 것으로 이해했습니다. 뭔가 이미지/비디오 인코더 단에서도 비슷한 연구가 있을 거 같긴 한데 추후 token형식의 출력을 그대로 활용할 여지가 있을 것 같네요.
질문이 한 가지 있는데, 학습 데이터가 약 1,200개로 적어 Cross-Attention 대신 단순 MLP Projector를 사용했다고 설명하셨는데, 만약 학습 데이터 수가 충분히 늘어난다면 Cross-Attention이나 더 복잡한 어댑터를 사용하는 것이 MLP보다 fine-grained한 공간 정보를 VLM에 주입하는 데 더 유리해질 가능성이 있을까요?
안녕하세요 정우님 리뷰 잘 읽었습니다.
의문이 드는 부분들이 좀 있었는데, 어느정도 해소가 되긴 했네요. 해당 방식이 3D 정보를 VLM에 넣어주는거에 있어서 초기논문이라 비교논문들중 3D 정보를 활용하는 다른 방법론이 없었던건지 궁금하고, 학습셋이 천개정도 되는거같은데 이게 시나리오니까 어느정도로 적은건지 궁금합니다. 그리고 text를 효율적으로 VLM 에 넣기가 어려울 것 같긴 하네요.