안녕하세요. 이번에 리뷰로 가져온 논문은 CoRL 2026에 올라온 WAM-Nav: Asymmetric Latent World-Action Modeling for Unified Visual Navigation이라는 논문입니다.
해당 논문은 기존 Visual Navigation 모델들이 현재 관측된 이미지로부터 바로 미래 이동 궤적을 예측하는 방식을 지적하고 여기서 추가로 로봇이 앞으로 이동했을 때 관측하게 될 미래의 시각 정보까지 함께 예측하도록 설계한 연구라고 보시면 좋을 것 같습니다. 특히나 핵심은 별도의 월드 모델과 내비게이션 policy를 각각 개별적으로 사용하는 것이 아니라 하나의 DiT를 가지고 미래의 관측(압축 latent)과 미래 action 궤적를 함께 생성하는 Latent World-Action Model을 제안한 논문이라고 이해하시면 좋을 것 같습니다.
그리고 또 Image-Goal, Point-Goal, No-Goal Exploration처럼 서로 다른 형태의 내비게이션 태스크를 하나의 모델로 수행할 수 있도록 설계했다는 점도 특징이라고 볼 수 있습니다.
자세한 내용은 아래 리뷰에서 다루도록 하겠습니다.
Introduction
Visual Navigation은 로봇이 카메라로 주변 환경을 관측하면서 주어진 목표에 도달하기 위한 적절한 이동 경로를 예측하는 기술이고 최근에는 이미지로부터 직접 로봇이 이동할 미래 궤적을 예측하는 E2E Navigation 연구들도 활발하게 진행되고 있습니다. 대표적으로 ViNT, NoMaD, NavDP 같은 연구들이 있는데, 이러한 방법론들은 현재 이미지와 과거 간측 history, 그리고 목표 정보를 입력받아 로봇이 앞으로 이동해야 할 waypoint나 trajectory를 예측합니다. 특히 NoMaD나 NavDP는 Diffusion policy 기반으로 여러 형태의 trajectory를 생성할 수 있도록 설계되어 있다고 보시면 좋을거 같습니다.
저자들은 기존 방법론들이 현재 관측된 이미지와 과거 관측 histroy을 기반으로 바로 궤적을 예측하기 때문에, 해당 궤적을 따라 이동했을 때 미래에 어떤 장면을 관측하게 될지는 명시적으로 모델링하지 않는다는 점을 지적합니다. 저자들은 현재 관측 정보로부터 바로 action을 결정하는 것보다, 앞으로 이동했을 때 관측하게 될 미래의 시각적 상태까지 함께 고려한다면 좀 더 안정적인 내비게이션이 가능할 것이라고 주장합니다. 그래서 이와 관련해서 이러한 문제를 해결하기 위해 최근에는 월드 모델을 활용하는 내비게이션 연구들도 등장하고 있습니다. 이런 월드 모델을 활용한 기존 연구에서는 크게 두 가지 방식으로 활용된다고 합니다. 첫 번째는 미래에 도달해야 할 장면을 먼저 생성하고, 별도의 Inverse Dynamics Model이나 Navigation Policy를 사용해 해당 장면에 도달하기 위한 action을 예측하는 방식이고 두 번째는 여러 개의 궤적 후보를 먼저 생성한 다음, 월드 모델을 통해 각 궤적를 실행했을 때의 미래 관측을 예측하고 가장 적절한 경로를 선택하는 방식입니다. (대표적으로 NWM 방식-CVPR 2025)
근데 이런 방식들은 월드 모델과 내비게이션 Policy가 서로 분리되어 있기 때문에 미래 장면을 생성하고 다시 이를 기반으로 action을 결정하는 과정이 필요합니다. 특히 미래 관측을 여러 step에 걸쳐 autoregressive하게 생성하면 추론 비용이 증가할 뿐 아니라, 예측 오차가 누적되면서 실제 환경과의 차이가 커질 수도 있습니다. 실제로 NWM 같은 경우는 추론 비용이 커서 실시간 성은 떨어지는 문제가 있습니다.
그래서 저자들은 미래 시각 정보를 활용하면서도 별도의 월드 모델과 Policy를 순차적으로 실행하지 않고, 하나의 모델에서 미래 관측과 궤적을 함께 예측하게끔 하고자 WAM-Nav 라는 프레임 워크를 제안 합니다. 좀 구체적으로 설명드리면 WAM-Nav는 사전에 구축된 지도 없이 Visual Navigation을 수행하는 Mapless 환경을 대상으로 하고 모델은 최근 RGB 관측 history와 로봇이 실제로 이동한 motion history, 그리고 goal condition을 입력받습니다. 그리고 이를 기반으로 앞으로 실행할 긴 action trajectory와 가까운 미래의 visual observation을 latent representation 형태로 함께 예측하도록 합니다. 여기서 미래의 모든 장면을 길게 예측하지는 않고 저자들은 내비게이션에서 로봇의 이동 경로는 비교적 긴 구간까지 계획하되미래 장면은 가까운 시점만 예측해도 trajectory 생성에 필요한 정보를 제공할 수 있다고 보고 모든 미래 장면에 대해서 예측하지는 않도록 설계했다고 합니다.
정리하면 WAM-Nav는 긴 Action Planning과 짧은 Visual Foresight를 하나의 생성 모델에서 동시에 학습하는 방식을 제안한 것이고 그리고 추가적으로 서로 다른goal 모달리티를 처리하기 위한 Unified Goal Alignment와 과거 로봇의 움직임을 함께 고려하기 위한 Dual-Stream Contextual Conditioning을 도입합니다.
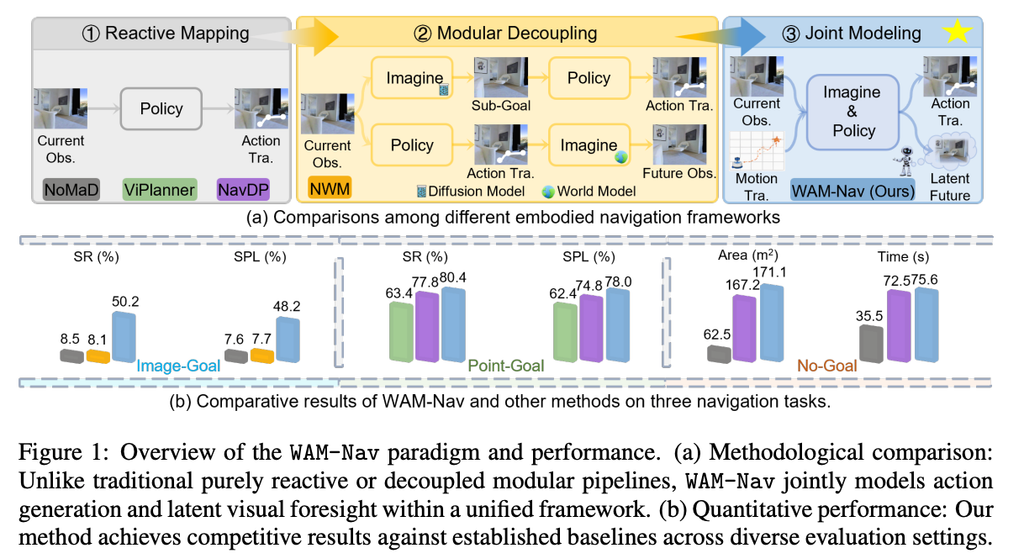
위 그림은 기존 내비세이션 파이프라인(1,2)와 WAM-Nav(3)의 차이를 보여주는 그림이고 기존 Reactive 방식은 관측으로부터 바로 action을 예측하고, Modular 방식은 미래 observation 생성과 action planning을 별도의 단계로 수행합니다. 반면 WAM-Nav는 action과 미래 visual representation을 하나의 모델 내부에서 함께 생성하도록 설계했다는 점이 핵심이라고 보시면 좋을 것 같습니다.
Method
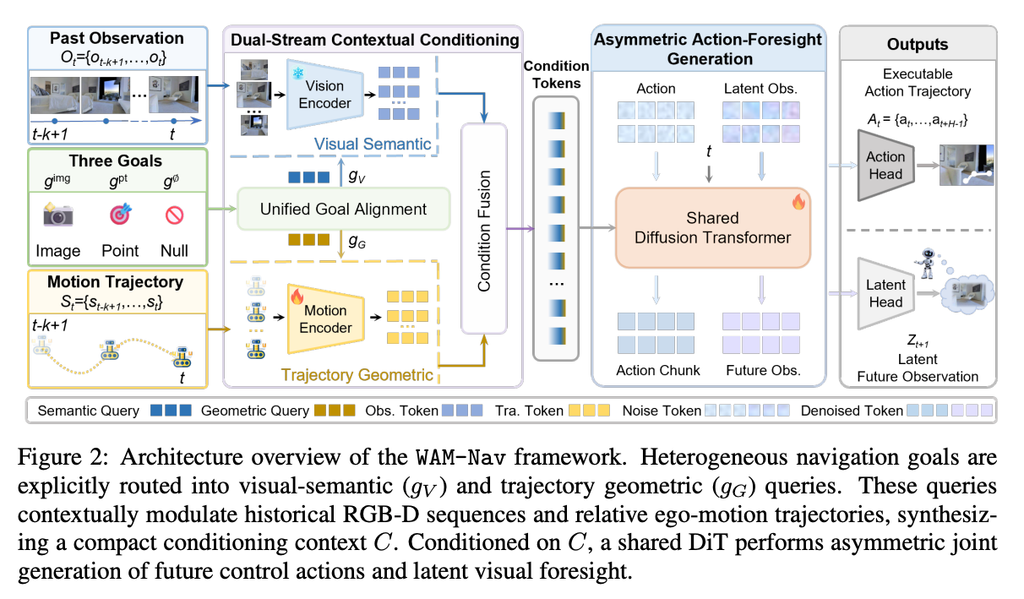
위 그림은 WAM-Nav의 전체적인 파이프라인입니다.WAM-Nav는 크게 세 가지 모듈로 구성됩니다. 먼저 서로 다른 목표 형태를 공통된 representation으로 처리하기 위한 Unified Goal Alignment, 과거 이미지와 로봇의 이동 history를 결합하는 Dual-Stream Contextual Conditioning, 그리고 실제 trajectory와 미래 visual representation을 함께 생성하는 Asymmetric Action-Foresight Generation입니다.
전체적인 흐름을 간단하게 설명드리면, 먼저 로봇의 목표 정보와 최근 RGB observation, motion history를 각각 인코딩하고 이후 목표와 관련된 시각 정보 및 로봇의 과거 움직임을 결합해서 Condition Token을 생성합니다. 그리고 해당 Condition Token을 입력 조건으로 사용해서 DiT에서 미래 action 궤과와 latent visual representation을 함께 생성하는 방식으로 구성되어있다고 보시면 좋을 것 같습니다.
Unified Goal Alignment
먼저 Unified Goal Alignment는 서로 다른 내비게이션 태스크를 하나의 모델로 수행하기 위해 제안된 모듈이라고 보시면 좋을 것 같습니다. WAM-Nav에서 고려하는 내비게이션 태스크는 총 세 가지인데, 먼저 Image-Goal은 목표 장소의 이미지를 입력받고 해당 장소까지 이동하는 태스크이고, Point-Goal은 로봇을 기준으로 목표 위치의 상대적인 좌표가 주어지는 방식입니다. 그리고 No-Goal은 별도의 목표 없이 주변 환경을 탐색하면서 이동하는 탐색하는 태스크입니다. 이 세가지 경우에 해당하는 골 모달리티를 고려해서 아키텍쳐를 구성했다고 보시면 될것 같습니다. 근데 이러한 목표들은 입력으로 주어지는 정보의 형태 자체가 다릅니다. Image-Goal에서는 목표 이미지와 현재 관측 이미지 사이의 시각적인 유사성이나 공간적 관계를 파악해야 하고, Point-Goal에서는 주어진 목표 좌표가 현재 로봇을 기준으로 어느 방향에 있는지를 이해해야 합니다. 그래서 저자들은 서로 다른 형태의 Goal을 인코딩한 다음, 이를 두 가지의 쿼리로 변환하는 방식을 제안합니다.
첫 번째는 Visual Semantic Query입니다. 해당 Query는 목표와 관련된 시각적 특징을 찾아내기 위한 것으로, 과거 RGB observation에서 목표와 연관성이 높은 영역을 강조하는 데 사용됩니다.
두 번째는 Geometric Query입니다. 해당 Query는 목표에 대한 기하학적 방향 정보를 표현하며, 로봇의 과거 움직임 중 목표 방향과 관련된 motion 정보를 추출하는 데 사용됩니다.
각각 골 모달리티에 대해서 각각의 전용 인코더들이 존재하고 이 인코더를 통해서 나온 특징들을 각각 서로다른 g_v, g_G 로 변환하는 선형 투영을 거쳐 쿼리를 생성한다고 합니다.
Dual-Stream Contextual Conditioning
앞서 말씀드린 두개의 쿼리들이 어떻게 동작하는지 여기서 설명을 드리도록하겠습니다. 기존 Visual Navigation 모델들은 일반적으로 과거 여러 프레임의 RGB 관측을 입력받아 주변 환경의 공간적 구조를 이해합니다. 근데 이미지 정보만으로는 로봇이 최근에 어떤 방향으로 움직였고, 얼마나 회전했고, 어떤 경로를 따라 이동해 왔는지를 명시적으로 표현하기 어렵습니다. 그래서 저자들은 RGB 관측 history뿐 아니라 로봇의 Ego-Motion History도 함께 활용하도록 설계했다고 합ㄴ디ㅏ.
먼저 Visual 스트림에서는 최근 8개 프레임의 RGB 관측을 DINOv2로 인코딩하여 비쥬얼 피쳐를 추출합니다. 이후 앞에서 설명한 Visual Semantic Query를 사용해서 각 이미지 패치가 현재 목표와 얼마나 관련되어 있는지를 내적 연산을 통해 계산하고, 관련있는 패치에 대해서 즉 패치별 유사도 점수로 이 시각 토큰을 게이팅하는 식으로 동작한다고 보시면 좋을 것 같습니다.
그리고 Motion 스트림에서는 과거 로봇의 이동 history를 입력받고 여기서 사용하는 정보는 로봇의 위치 변화와 회전 변화로 구성되고 절대적인 좌표가 아니라 현재 로봇을 기준으로 한 상대적인 이동량으로 변환된 값일가로 보시면 됩니다. 이후 이 Motion History를 트랜스포머 인코더에 입력하고, 앞에서 생성한 Geometric Query를 사용한 Cross Attention을 통해 목표 방향과 관련된 Motion 피쳐를 추출합니다.
마지막으로 이 두 가지 정보를 하나로 결합하는 Condition Fusion을 수행합니다. 여기서는 학습가능한 쿼리를 도입해서해서 Visual 피쳐에서 필요한 정보를 가져오는데, 이때 앞에서 추출한 Motion 피쳐를 Query에 반영합니다. 즉, 로봇이 지금까지 어떻게 움직여 왔는지를 고려하면서 과거 이미지에서 필요한 공간 정보를 선택적으로 추출하도록 설계한 것입니다.
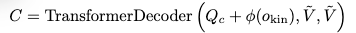
위 수식이 앞서 설명한 내용인데 Q_c라는 친구가 여기서 도입한 학습 가능한 쿼리이고 \phi(o_{\mathrm{xin}}) 이게 앞서 motion 스트림 쪽에서 g_G가 CA를 거쳐서 motion 정보들의 중요한 정보들을 뽑아온게 o_kin이고 이걸 학습가능한 쿼리 Q_c의 차원에 맞추기위해 선형 투영하는 \phi를 거쳐서 이걸 Q_c와 더한걸 쿼리로 사용하고 나머지 이미지 스트림 쪽에서 받은 시각 토큰들을 키, 키밸류로 condition Fusion을 진행한다고 보시면 좋을 것 같습니다.
이 과정을 거치면 최종적으로 visual 피쳐와 Motion 피쳐가 결합된 Condition Token이 생성됩니다. 그리고 이 Condition Token은 이후 Shared DiT에서 trajectory를 생성할 때 입력 조건으로 사용됩니다.
Asymmetric Action-Foresight Generation
앞에서 설명한 모듈들이 목표 정보와 과거 관측들을 결합해서 Condition을 생성하는 과정이었다면, 이제 해당 Condition을 기반으로 실제 로봇이 이동할 trajectory와 미래 visual observation을 생성하는 단계라고 보시면 좋을 것 같습니다. 저자들은 이 과정에서 Flow Matching 기반의 Diffusion Transformer를 사용합니다. 여기서 기존 방식과의 살짝 다른점은 일반적인 Diffusion Navigation Policy처럼 action만 생성하는 것이 아니라, Action Token과 Future Visual Token을 하나의 Shared DiT에 함께 입력한다는 점이고 각각에 대해서 궤적, 미래 시각 예측을 진행한다고 보시면 좋을 것 같습니다. 구체적으로 Action 쪽에서는 앞으로 이동할 24 step의 action 궤적을를 생성하고, Visual(latent obs)쪽 에서는 미래 1 step에 해당하는 visual observation을 latent space에서 예측합니다. 여기서 미래 이미지를 직접 픽셀 단위로 생성하는 것이 아니라, 사전학습된 Stable Diffusion VAE를 이용해 압축된 latent representation을 예측하도록 설계합니다.
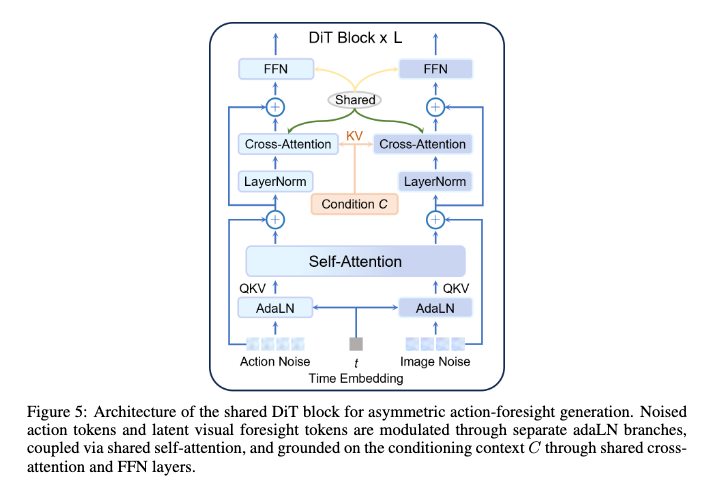
위 그림을 보면 Action과 Visual 피쳐가 각각 noise 형태로 입력되고, 여러 DiT Block을 거치면서 점진적으로 실제 trajectory와 미래 visual representation으로 복원되는 구조입니다.
여기서 두 가지 정보는 독립적으로 생성되는 것이 아니라 Shared Self-Attention을 통해 서로 정보를 주고받습니다. 그리고 앞에서 생성한 Condition Token을 Cross-Attention으로 참조하면서 현재 상황과 목표에 적절한 action 및 미래 visual representation을 예측하도록 학습합니다. CA와 FFN 부분은 가중치를 공유하면서 학습이 됩니다. 이 부분이 기존 Modular World Model 기반 내비게이션 방법론과 가장 큰 차이점인데 기존 방식처럼 미래 이미지를 먼저 생성한 다음 이를 별도의 Policy에 입력하는 것이 아니라, Action과 Future Visual Representation을 같은 생성 과정에서 함께 학습하도록 만들었다고 이해하시면 좋을 것 같습니다.
그리고 여기서 Asymmetric(비대칭)이라는 표현을 사용하는 이유는 Action과 Visual Prediction의 예측 구간이 서로 다르기 때문이라고하는데 앞에서 설명드린 것처럼 Action은 24 step을 예측하지만, Visual Foresight는 1 step만 예측합니다. 저자들은 로봇이 이동할 경로는 충분히 긴 구간까지 계획하면서도, 미래 장면은 가까운 시점만 예측하도록 설계했기 때문에 이런 비대칭이라는 키워드를 넣은 것 같습니다.
근데 이 부분이 살짝 공감이 되는게 내비게이션에서는 로봇이 이동하면서 카메라의 시점이 크게 변하는 경우가 많기 때문에 특히 회전하는 경우면, 그래서 사실 먼 미래의 이미지를 정확하게 예측하기가 어려울 것 같습니다. 그리고 미래 관측을 길게 생성할수록 예측 오차가 누적되거나 계산 비용이 증가할 수 도 있어서 저자들은 긴 궤적을 예측하는 데 필요한 정보를 가까운 미래의 관측 예측으로 보완하는 방식으로 설계했다고 합니다.
정리하면 WAM-Nav는 과거 관측 이미지와 Motion History를 기반으로 가까운 미래의 latent obs를 함께 예측하도록 학습하면서, 그 정보를 실제 Action 궤적 예측에 반영하는 구조라고 보시면 좋을 것 같습니다. 특히 기존 월드모델 기반의 내비게이션 방식과의 다른점은 미래 이미지를 별도의 모듈에서 여러 단계 생성하는 것이 아니라 하나의 Shared DiT 내부에서 Action과 함께 생성한다는 점이라고 보시면 좋을 것 같습니다.
Training & Dataset
저자들은 학습 데이터로 VLN-N1 데이터셋을 사용합니다. 해당 데이터셋은 Replica, Matterport3D, Gibson, 3D-FRONT, HSSD, HM3D 등 다양한 3D Scene Asset을 기반으로 구축되어있고 400시간 이상의 내비게이션 trajectory와 20만 개 이상의 trajectory 샘플을 포함한다고 합니다. 그리고 Domain Randomization을 통해 다양한 환경에서의 trajectory를 구성하고, 이를 기반으로 모델을 학습했다고 합니다.
학습 과정에서 DINOv2 Visual Encoder와 Stable Diffusion VAE는 사전학습된 가중치를 고정해서 사용했다고 하고, Goal 이미지 인코더, Motion 인코더, Condition Fusion , Shared DiT는 학습합니다.
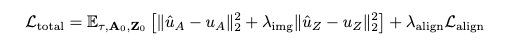
전체 Loss는 크게 세 가지로 구성되느데 먼저 첫번째 항의 Action Flow Matching Loss는 생성된 action trajectory가 실제 학습 데이터의 trajectory와 일치하도록 학습하는 역할을 하는 친구고 Visual Flow Matching Loss는 미래 latent visual observation을 예측하도록 학습하는 Loss라고 보시면 좋을 것 같습니다.그리고 마지막으로 Goal Alignment Loss가 있는데, 이는 Image-Goal과 Point-Goal이 동일한 목적지를 나타내는 경우 두 목표 표현이 서로 연관되도록 Contrastive Learning을 수행하는 방식이라고 합니다.특정 장소의 이미지와 해당 장소를 나타내는 목표 좌표가 같은 목적지를 의미한다면, 두 목표 정보가 서로 일관된 representation을 갖도록 학습시키도록하는 loss 항이라고 하는데 세부구현 사항은 논문에 나와있지는 않습니다.
Experiments
이제 저자들은 WAM-Nav의 성능을 다양한 시뮬레이션 환경과 실제 로봇에서 평가합니다. 먼저 시뮬레이션에서는 아이작 심 기반의 ClutterScenes와 InternScenes를 사용했다고 하고 ClutterScenes는 장애물이 다양한 형태로 배치된 환경이고, InternScenes는 실제 실내 공간에 가까운 집이나 상업시설 등의 환경으로 구성되어 있는 환경이라고 합니다. 60개 Scene에서 Scene당 100개 Episode를 구성해 총 6,000개 Episode를 가지고 제로샷 평가로 진행합니다.
그리고 Image-Goal과 Point-Goal에서는 Success Rate(SR)와 SPL을 사용하고, No-Goal Exploration에서는 일정 시간 동안 탐색한 면적과 탐색 지속 시간을 기준으로 성능을 평가를 진행합니다.
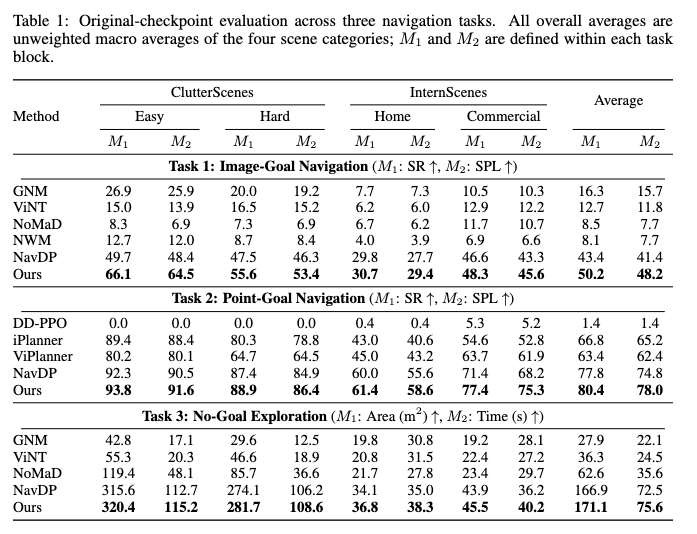
위 테이블은 WAM-Nav와 기존 냅게이션 모델들의 성능을 비교한 결과인데 먼저 Image-Goal 내비게이션,Point-Goal 내바게이션, 탐색 하는 태스크 셋다 가장 좋은 성능을 보입니다. 특히 Image-Goal에서 개선 폭이 상대적으로 크게 나타나는 것을 보면, 목표 이미지와 현재 관측 사이의 공간적 관계를 이해해야 하는 상황에서 visual Foresight와 motion history가 도움이 되었을 가능성이 있는 것 같습니다.,물론 Image-Goal의 절대적인 성공률 자체는 50% 정도이기 때문에 복잡한 환경에서 안정적으로 목표까지 도달하는 문제는 여전히 어려운 것같긴 합니다.
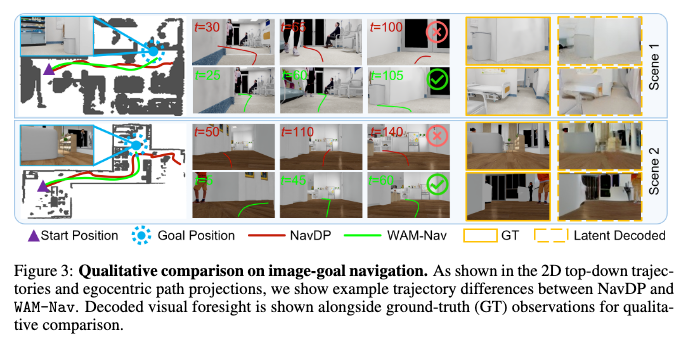
위 그림은 NavDP와 WAM-Nav가 생성한 trajectory를 비교한 결과입니다. 각각의 경로를 보면 WAM-Nav가 장애물이 배치된 환경에서 보다 적절한 우회 경로를 생성하는 결과를 볼 수 있고 오른쪽에서는 모델이 예측한 미래 visual observation을 실제 GT와 비교하고 있습니다. 근데 현재 관측이미지가 저 fig 에서 안나와있어서 현재 관측이 어떤 상황에서의 저런 미래 예측 observation을 생성했는지는 모르겠네요..
Computational Efficiency
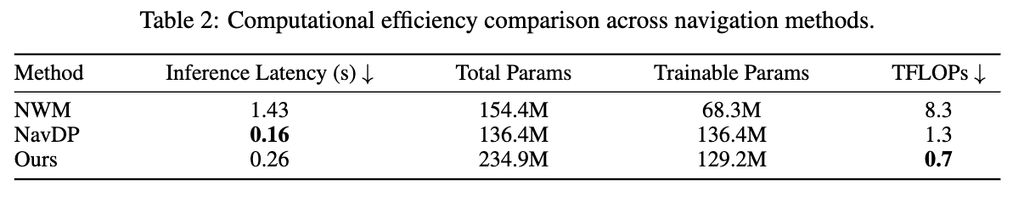
위는 추론 효율에 대한 비교인데, 결과적으로 NWM이라고 하는 기존 월드 모델 기반 내비게이션 방식보다는 훨씬 추론 효율을 빠른 결과를 보입니다. 근데 Nav-DP 는 reactive 내비게이션 모델이고 별도의 월드 모델링이 안들어가 있기 때문에 이것보다는 느리지만 그래도 미래의 관측 latent까지 함께 생성하는 것 치고는 빠른 결과를 보입니다. 그리고 연산량 자체만을 비교하면 WAM-Nav가 가장 낮은 결과를 보입니다. 결국 이 표에서 말하고 싶은 건 미래 시각 정보를 함께 예측하면서도 기존 Modular 월드 모델 방식처럼 큰 추론 비용이 발생하지 않도록 설계했다는 점에서 의미가 있는 결과이다 정도로 보시면 좋을 것 같습니다.
Ablation Study
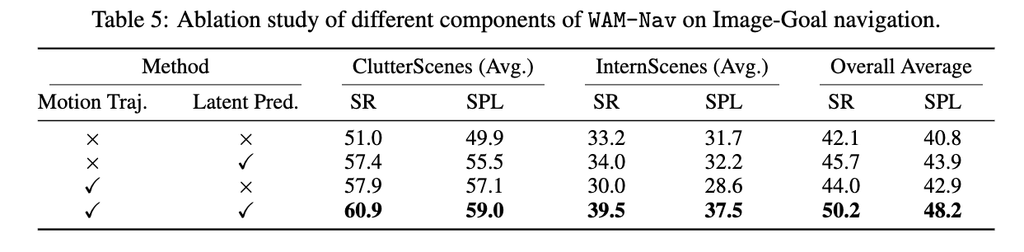
먼저 Motion History와 Latent Visual Prediction의 효과를 비교한 결과이고 결과적으로 두 모듈을 함께 사용했을 때는 50.2%로 가장 높은 성능을 보입니다. 이 결과를 보면 미래의 Visual 관측을 예측하도록 학습하는 것 자체가 성능에 도움이 되고, 여기에 로봇의 과거 움직임까지 함께 고려했을 때 추가적인 성능 향상이 발생하는 결과를 볼 수 있습니다.
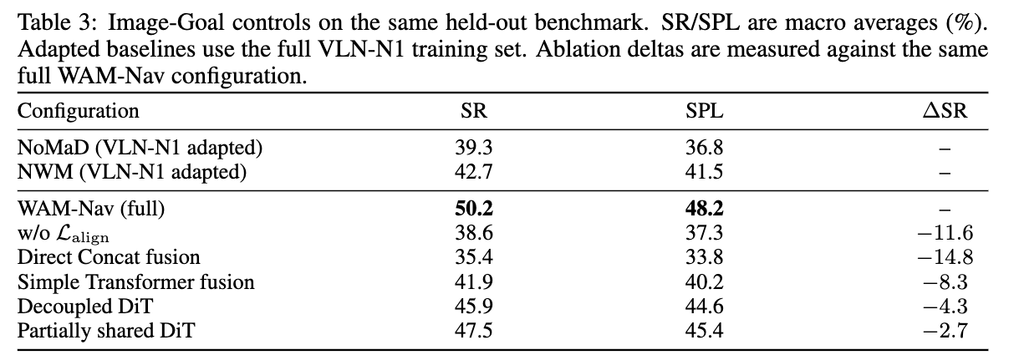
추가적으로 Condition Fusion 방식에 대한 Ablation도 진행하는데 단순히 Visual Feature와 Motion Feature를 Concat하는 방식에서는 SR이 떨어지는 결과를 보이고 그리고 일반적인 트랜스포머 기반 Fusion에서는 41.9%를 기록하는 반면, 저자들이 제안한 DSCC 방식에서 더 좋은 결과를 보입니다. 단순히 두 정보를 함께 입력하는 것보다는 Motion History를 이용해 목표와 관련된 Visual 피쳐를 선택적으로 추출하도록 설계한 것이 중요한 역할을 했다고 볼 수 있습니다. 그리고 Goal Alignment Loss를 제거했을 때도 SR이 감소하는 결과를 보입니다. 서로 다른 형태의 목표 정보를 공통된 공간에서 정렬하도록 학습하는 과정 또한 중요한 역할을 하는 것 같습니다.
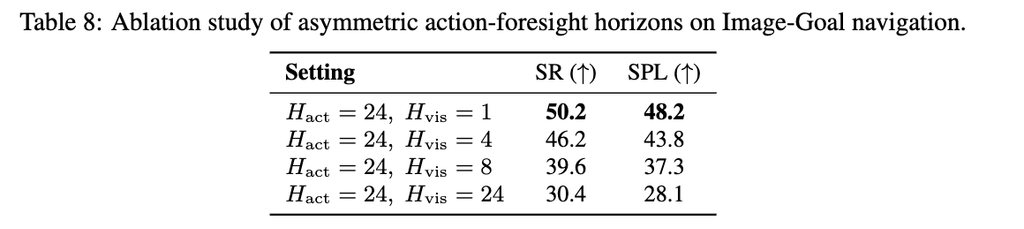
그리고 여기는 미래 예측 시퀀스와 미래 관측 시점에 대한 ablation 인데 저자들은 Action Horizon을 24 step으로 고정하고, 미래 visual observation을 몇 step까지 예측할지를 변경하면서 실험을 진행합니다.
결과를 보면 Visual Horizon이 1일 때 가장 높은 성능을 기록하지만, 이를 4, 8, 24 step으로 증가시키면 각각 점점 성능이 감소합니다. 내비게이션에서는 이동에 따른 카메라 시점 변화가 크기 때문에 미래 observation을 길게 예측할수록 정확도가 떨어질 수 있다고 저자들은 설명하고 실제로 이거 관련해서 저자들이 아래 실험 표에 분석결과를 제시합니다.
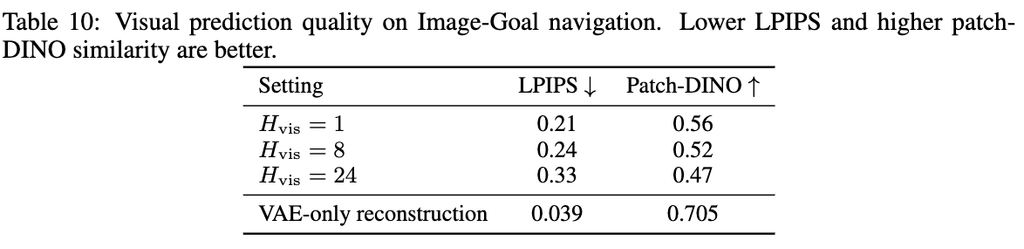
미래 이미지의 예측 품질을 비교했을 때도 Visual Horizon이 길어질수록 LPIPS와 DINO Feature Similarity가 악화되는 경향을 보입니다. 결국 미래를 얼마나 멀리 예측하는지가 중요한 것이 아니라, 실제 미래 궤적 생성에 도움이 될 수 있는 신뢰할 만한 미래 정보를 얼마나 잘 활용하느냐가 중요하다는 점을 보여주는 결과인 것 같습니다.
Real-World Deployment
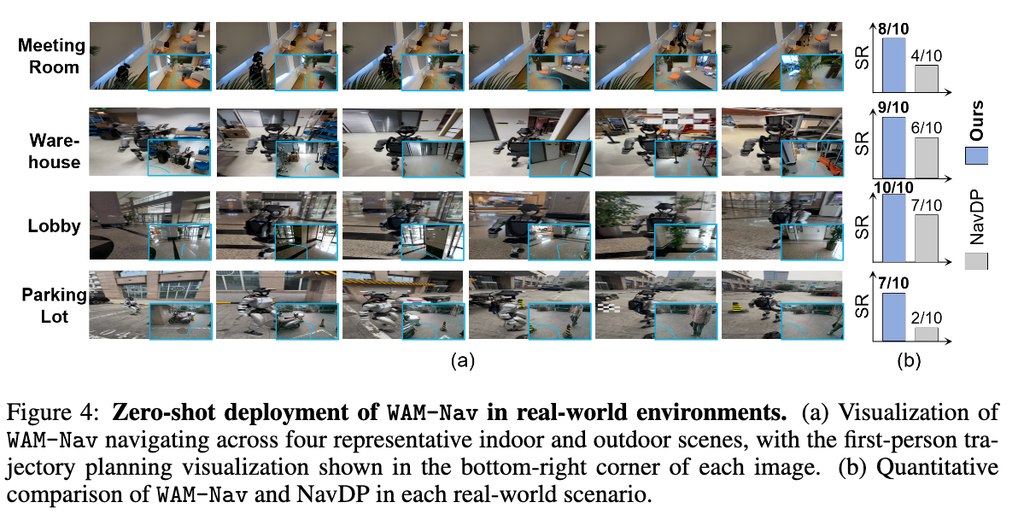
마지막으로 저자들은 시뮬레이션뿐 아니라 실제 로봇 환경에서도 Zero-Shot Deployment를 진행합니다.실험에는 Unitree G1 휴머노이드를 사용하고, WAM-Nav가 예측한 trajectory는 별도의 MPC Controller를 통해 실제 로봇의 속도 명령으로 변환하는 방식으로 deploy 합니다.
실제 환경에서는 Meeting Room, Warehouse, Lobby, Parking Lot의 네 가지 시나리오에서 평가를 진행합니다. 각 환경별로 10번씩 실험한 결과, 각각 80%, 90%, 100%, 70%의 성공률을 기록하면서 평균 85%의 성공률을 달성합니다. 그리고 동일한 조건에서 평가한 NavDP보다 모든 시나리오에서 높은 성공률을 기록합니다.
Conclusion
기존 Visual Navigation 연구들을 보면 현재 observation을 기반으로 바로 trajectory를 예측하거나, 별도의 World Model을 사용해서 미래 장면을 생성한 다음 이를 Planning에 활용하는 경우가 많았는데 WAM-Nav는 이 두 가지를 분리하지 않고 하나의 Shared DiT에서 미래 Visual Representation과 Action Trajectory를 함께 생성하도록 설계했다는 점이 기존 방식과 다른 차이점이라고 정리할 수 있을 것 같습니다. 그리고 저자들이 말하는 한계는 잇는데, 이건 저자들의 방식 뿐만이 아니라 다른 방법론에도 공통 적으로 적용되는 한계라 한계라고 말할 수 있나 싶습니다. 먼저 카메라의 제한적인 시야 그리고 로봇의 실제 몸체 크기나 형태를 명시적으로 고려하지 않기 때문에, 카메라 기준으로는 통과할 수 있을 것처럼 보이는 경로에서도 로봇 몸체가 장애물에 충돌하는 경우가 발생한다고 합니다. 암튼 이번 논문을 보면서 느낀 건 기존 Navigation Policy에 World Model을 별도로 추가하는 것도 하나의 방법이지만, 미래 환경을 이해하는 능력 자체를 Action 생성과 함께 학습하도록 만드는 방식도 충분히 해볼만하고 합리적인 접근 방식인거 같습니다. 앞으로는 이런 방식처럼 단순히 현재 관측 정보에서 바로 action을 예측하는 방식에서 벗어나 로봇이 특정 행동을 수행했을 때 어떤 상황이 발생할지를 예측하고 이를 바탕으로 trajectory를 생성하는 방향으로 확장되는 식의 방법론들이 많이 나올 것 같다는 생각이 듭니다.
이만 리뷰 마치도록 하겠습니다. 감사합니다.


안녕하세요 우현님 좋은 리뷰 감사합니다.
이전에 있었던 방식에서 latency나 학습방식을 조금 더 구체화한 것 같네요.
저자의 방법론으로 DiT를 사용해서 어떤 미래의 시점을 생성한 정성적 결과도 있나요? 아니면 latent만 활용하는 느낌인가요?