VLM(MLLM)은 왜 Spatial Reasoning을 어려워 할까요? VLM은 “Under”, “Behind”와 같은 단순한 공간적 관계를 인지하는 것조차 어려워 합니다. 이번 논문은 그런 의문을 Attention Mechanism 관점에서 분석하여 해결 방안을 제시하였습니다.
리뷰하기 앞서, 해당 논문에서 VLM이라고 부르는 것들은 LLaVA, Qwen-VL 처럼 Vision Encoder를 통해 거친 Image Token을 Text Token space에 투영하여 Input을 구성하고, LLM을 붙혀 사용하는 MLLM, LVLM을 의미합니다.
저는 Contrastive VLM(e.g. CLIP)을 VLM, LLM based VLM(e.g. LLaVA, Qwen-VL)을 MLLM이라고 부르는 것이 익숙합니다. 따라서, 해당 리뷰에서 편의상 MLLM이라고 용어를 통일하려고 합니다.
Introduction
MLLM은 vision-centric task에 취약함을 보입니다. 특히, 해당 논문에서는 Spatial Reasoning, 즉 공간 관계에 대한 이해의 실패를 더욱 집중해서 다루었습니다. Spatial Reasoning이라는 task가 모델에 요구하는 부분은 “left”, “right”, “above”, “below”, “behind”, “front” 등의 두 물체 간의 관계를 인지하는 것입니다.
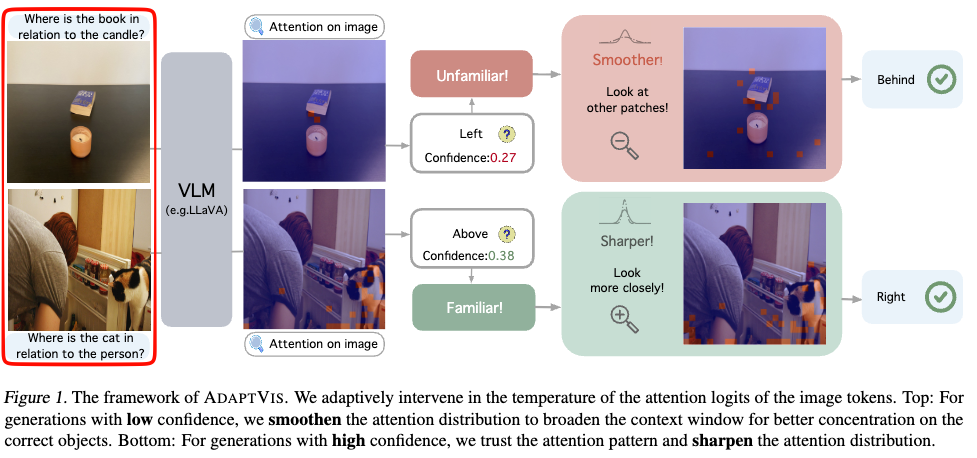
하지만, 모델들은 이런 관계들을 명확하게 인지하지 못하고, 옳지 못한 답을 내곤합니다. 이런 오류들은 단발성 사건이 아님을 저자들은 명시합니다. 이런 오류들에 대해 최근 연구들은 CLIP, 즉 vision encoder를 중심으로 분석과 연구를 하였습니다. 하지만, MLLM에서 Image와 Text token들이 모델 내부에서 어떻게 상호작용하며, 기하학적 이해 구조를 형성하는지 활발히 탐구되지 않았음을 저자들은 강조합니다. 이에 추가로, 모델은 객체를 인지함과 동시에 해당 객체의 전역적인 기하학적 맥락과 객체 간의 복잡한 기하학적 관계를 이해하는 능력이 필요하다고 주장합니다.
따라서 저자들은 MLLM의 내부를 뜯어보기로 결심합니다.
Datasets
먼저, 저자들이 주요 분석 및 평가에 사용한 데이터셋을 정리하고자 합니다.
What’s up
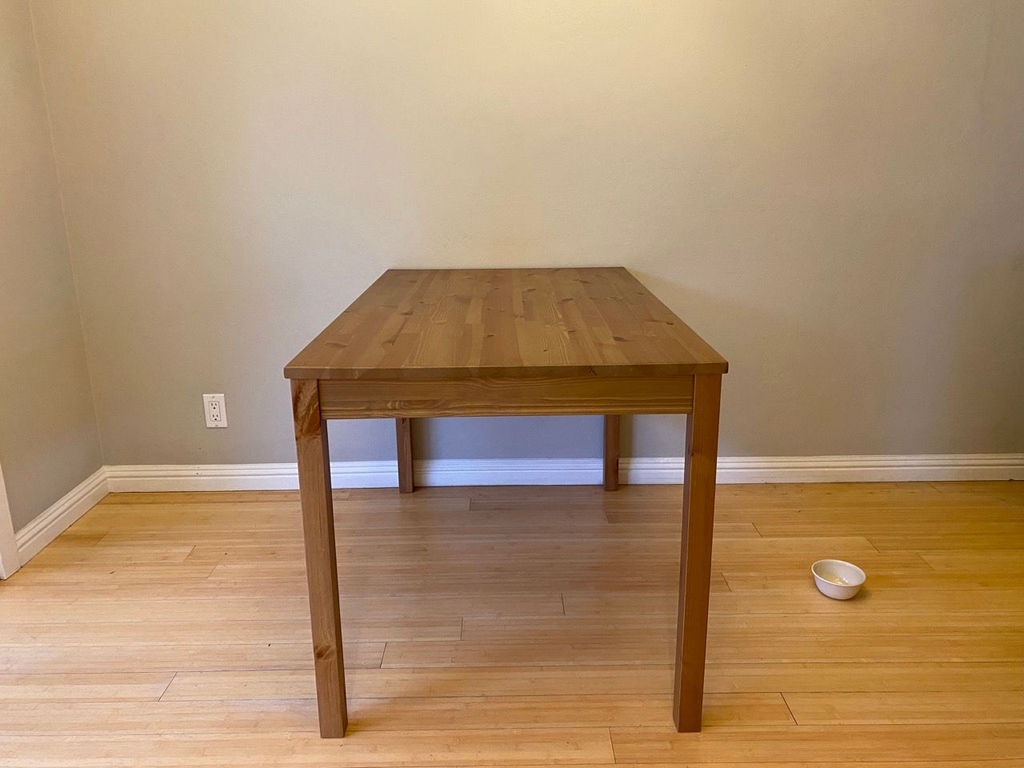
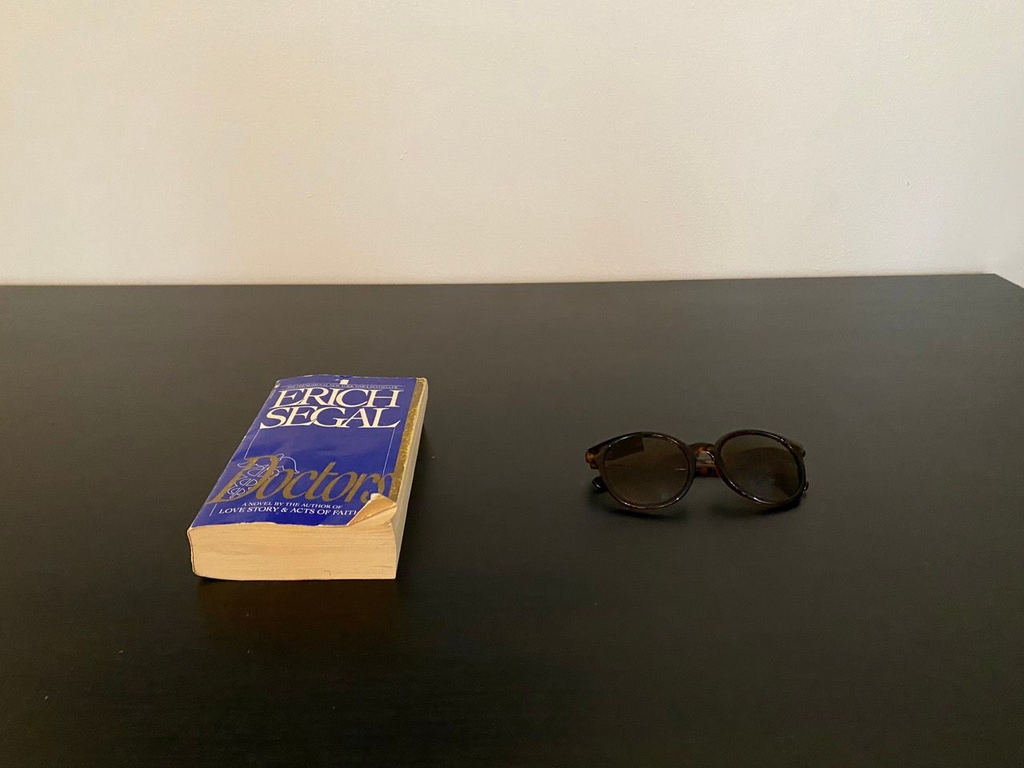
합성 데이터와 realistic 데이터 모두를 포함하고 있지만 해당 논문에서는 합성 데이터(Controlled_Image)를 활용하였습니다.
Controlled_Image에는 A,B 두가지 타입이 있습니다. Cont_A는 “left”, “right”, “above”, “below” 네가지 관계에 대한 이미지로, 소파와 같은 큰 객체와, 컵과 같은 작은 객체로 이루어져 있습니다. Cont_B는 “left”, “right”, “behind”, “front” 네가지 관계에 대한 이미지로, 두 작은 객체로 이루어져 있습니다.
COCO, VG
Realistic 데이터는 MSCOCO, VG 데이터셋에서, 복잡한 배경과 다중 객체를 포함하고 있는 데이터를 기반으로 구성하였습니다. 각 데이터는 Caption에서 언급되는 객체의 갯수가 1개 또는 2개입니다.
Metrics
실험들은 Accuracy(정확도)를 중심으로 분석합니다. What’s up set과 COCO는 4가지 관계를 option으로 사용하고, VG는 6가지 관계를 option으로 사용합니다.
더 나아가 What’s up의 경우 동일한 객체들에 대한 서로 다른 관계를 보이는 이미지를 쌍으로 이룹니다. 예를 들어, 동일한 객체들의 좌/우 관계만 바뀐 이미지가 쌍을 이룹니다. 따라서, 저자들은 pair accuracy, set accuracy를 통해, 동일한 배경의 동일한 객체가 관계만 바뀌었을 때 바뀐 관계를 인지하는지 평가하였습니다.
Text-Vision Attetion Interactions
모델의 내부를 뜯어보기 앞서, 저자들은 MLLM의 spatial reasoning의 실패는 text-vision interaction에서 오는 문제 때문일 것이라고 가설을 세웁니다.
MLLM allocate sparse attention to the image
저자들은 output token들이 image token을 얼마나 참조하고 있는지 확인하기 위해, 모델 전반의 layer에서 attention logits을 추출했습니다.
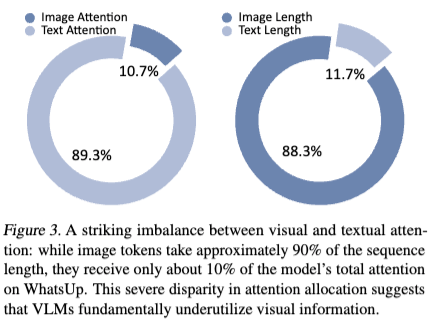
추출한 attention logit을 기반으로 softmax를 거쳐, 전체 text,image token들에 분배되는 weight인 attention score로 나타냅니다.
Figure 3에서 볼 수 있듯, Image와 Text의 attention score의 합을 비교했을 때, text token보다 image token을 참조하는 정도는 약 9배 더 낮습니다. 이는 image token의 수가 적어서 발생하는 것은 아닙니다. 오히려 Image token이 훨씬 많은데도 불구하고, 출력 생성시 모델의 attention은 text에 더 집중됩니다.
Is the Answer more accruate if the model sees the image more? Not really.
그렇다면, Image Token에 attention score을 증가시키면, 즉 모델이 이미지를 더 보게한다면, 정확도가 오를까 직관적으로 의문이 듭니다. 의문을 해소하기 위해 image token의 attention weight를 증가시켜 모델로 하여금 image에 더 집중하도록 하였습니다.
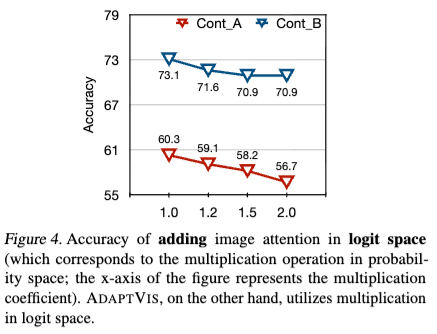
하지만, 오히려 성능은 감소하는 경향을 보였습니다. 즉, 단순히 Image를 더 보는 것이 spatial reasoning을 더 잘 하는 것은 아님을 알게 되었습니다.
Visual Attention Distribution
위에서 Image-Text간의 attention 불균형을 관찰했고, image attention을 증가시켜도, spatial reasoning 능력을 향상 시키는 것이 아님을 확인하였습니다. 이에 저자들은 이에 저자들은 이미지에 할당되는 attention의 총량보다, 이미지 내부에서 attention이 어디에 분포하는지가 중요할 것이라고 가설을 세웠습니다. 이를 확인하기 위해, 실제 image에 어느 위치에 집중하고 있는지 image token과 attention mapping을 수행하였습니다. 해당 Mapping은 단순히 모델이 어느 부분을 보는지 뿐 아니라, attention이 이미지 내에서 실제 spatial relationship과 어떻게 연관되어 있는지 확인할 수 있게 해준다고 언급합니다.
The model automatically focuses on the relevant entity when correctly answering questions
저자들은 질문과 관련된 객체에 attention이 잘 정렬되는지가 답변의 정확성과 연관되는지 확인하였습니다.
먼저 YOLO로 관련 객체의 bounding box를 추출하고, 내부는 1, 외부는 0인 binary mask를 생성하였습니다. 이후 해당 mask와 최종 답변 토큰이 image patch에 부여한 layer별 attention을 정규화하고, 두 벡터의 cosine similarity를 계산하여 공간적 일치도를 측정하였습니다. 이 일치도로 정답과 오답 샘플을 구분할 수 있는지 AUROC로 평가하였습니다.
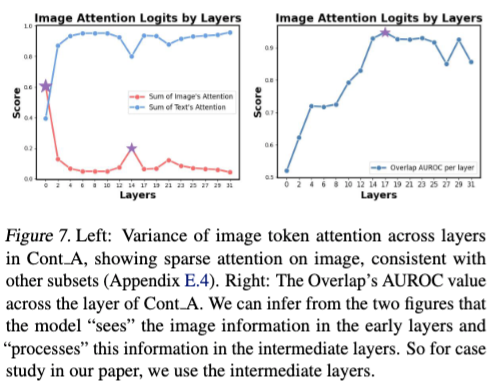
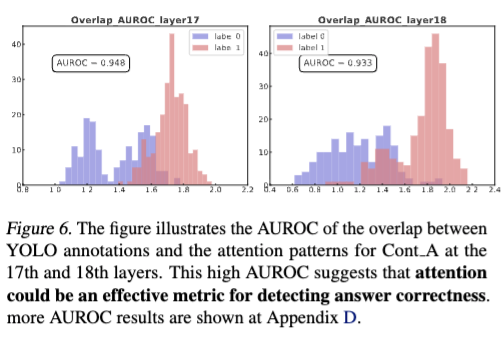
Figure 7의 오른쪽 그림을 보면, 중간 layer(약 17)에서 AUROC가 가장 높은 것을 알 수 있습니다. 초기 layer는 이미지에 할당하는 attention의 총량은 크지만, 객체 영역과의 일치도(AUROC)가 정답과 오답을 구분하는 데에는 덜 효과적이었습니다. 반면 중간 layer에서는 일치도가 답변의 정확성을 더 잘 구분하였습니다. 저자들은 이를 초기 layer가 전역적인 이미지 정보를 파악하고, 중간 layer가 질문과 관련된 정보를 구체적으로 처리한다는 근거로 해석하였습니다.
정답과 오답 사례의 attention map을 비교한 정성적인 분석에서도 차이가 나타났습니다. 정답 case의 경우 관련 객체에 충분한 attention을 할당한 반면, 오답 case에서는 다음 두가지 실패 패턴이 관찰되었습니다.
- Insufficient attention: 질문과 관련된 객체에 attention을 충분히 할당하지 못함.
- Misplaced attention: 질문과 무관한 객체에 attention을 할당함.
해당 결과는 attention의 총량 뿐 아니라 관련 객체에 대한 공간적 정렬이 답변의 정확성과 연관됨을 보여줍니다.
SCALINGVIS: Temperature scaling to image attention distribution
모델의 misplaced attention이 spatial reasoning의 오류를 야기하기 때문에, 저자들은 이를 해결하기 위해 attention 분포의 temperature를 수정하여 이미지에 할당되는 attention의 분포에 직접적으로 개입하기로 합니다. 저자들은 attention의 분포를 더욱 smoother 또는 sharper 하게 개입할 수 있다고 하였습니다. 예를 들어, attention pattern이 올바른 영역을 보고 있지만, precision이 낮다면, sharpening을 한다고 합니다.
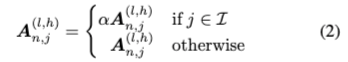
다음 수식을 적용하여 sharpening, smoothing을 수행할 수 있습니다. 마지막 입력 토큰(n)이 image token에 주는 attention logit에 계수 α를 곱합니다. α > 1이면 기존에 높은 attention이 할당된 위치에 더 집중하고, 0 < α < 1이면 분포가 더 평탄해집니다.
Image attention의 분포를 조정하는 것이 spatial reasoning 성능 향상까지 연결되는지 확인하기 위해 앞서 설명한 what’s up(외 COCO, VG)과 VSR 데이터를 기반으로 평가하였습니다. Baseline은 LLaVA 모델과 Contrastive Decoding 방식을 통해 output을 조정한 VCD, DoLa와 함께 비교하였습니다.
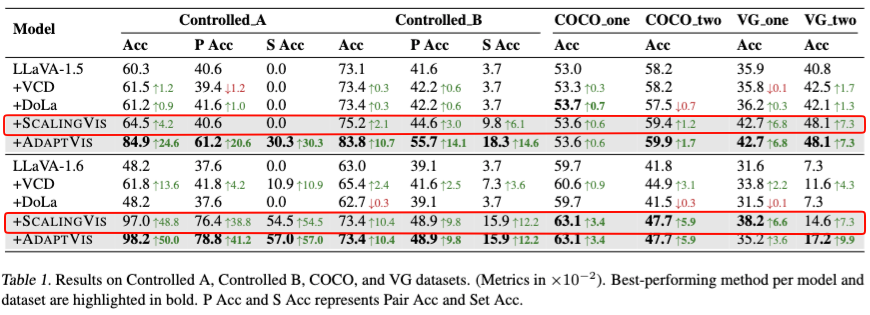
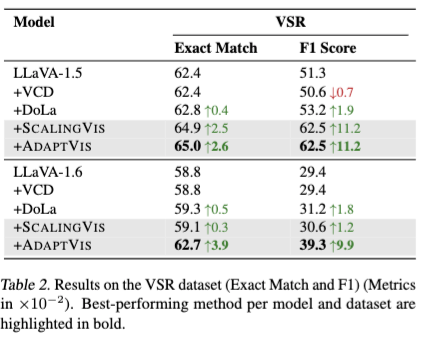
결과적으로 spatial reasoning 능력이 최대 54.5%p 향상 되었습니다. 저자들은 데이터의 유형에 따라 효과적인 설정이 다름을 확인하였습니다. Synthetic data의 경우 대부분(75%) α < 1에서 개선되었으나, Real Image data의 경우 모든 경우에 대해서 α > 1에서 개선 되어습니다. 이를 익숙한 이미지(COCO, VG, VSR)와 공간 관계에 대해서는 기존 attention이 대체로 올바르지만 정밀하지 않아, 분포를 sharpening하는 것이 도움이 된다고 해석하였습니다. 반면 익숙하지 않은(synthetic data) 이미지와 공간 관계에 대해서는 기존 attention에 과도하게 집중하기 보다는, 분포를 smooting하여 더 넓은 맥락을 보는 것이 더 도움이 된다고 해석하였습니다.
다만 이러한 경향은 데이터셋 수준의 관찰이며, 같은 합성 데이터 안에서도 공간 관계에 따라 효과적인 개입 방향이 달랐습니다.
Adaptively Intervening the Attention Distribution by Model Confidence
앞선 관찰들에서 Attention 분포를 Sharper or Smoother 하게 하는 것이 효과적인 경우가 다르다는 것을 알 수 있었습니다. 이에 저자들은 현재 attention 분포를 신뢰하고 강화할지, 분포를 완화하여 더 넓은 영역을 참조할 수 있도록 할 지 동적으로 결정할 수 있는 metric를 찾고자 하였습니다.
Self-confidence reflects whether we can trust the model’s image attention distribution.
Attention pattern과 모델의 답변의 정확성이 연관됨을 앞선 절에서 확인하였습니다. 이에 저자들은 출력의 confidence를 통해 attention 분포의 confidence를 간접적으로 판단하고자 하였습니다. 이를 위해 생성된 출력의 logit을 모델의 self-confidence metrics로 사용하였습니다.
실험은 네가지 공간 관계가 균등하게 분포한 What’s up의 Cont_A, Cont_B를 사용하였고, Attention 조절 변수 α를 변경하면서 confidence와 accuracy의 변화를 분석하였습니다.
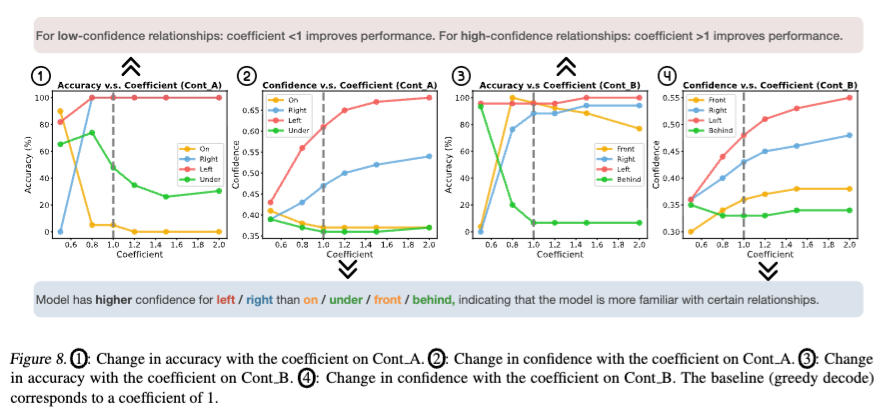
Baseline(α = 1)에서 left, right 관계에 대한 confidence와 accuracy가 다른 관계보다 높게 나타났습니다. α를 증가시켜 Attention 분포를 sharpening 한다면 left, right의 성능이 향상되는 반면, 다른 관계에서는 α를 감소시켜 분포를 smoothing 했을 때 성능이 향상되었습니다.
저자들은 이를 모델이 익숙한 관계에서 기존 attention을 강화하고, 덜 익숙한 관계에서는 더 넑은 맥락을 탐색하는 것이 효과적이라고 해석하였습니다. 이는 앞서 언급하였던, 익숙한 데이터 내에서도 공간 관계에 따라 변하는 효과적인 개입 방향이 다르다는 해석과 연결됩니다.
해당 결과를 바탕으로 self-confidence에 따라 attention 조절 방향을 결정하는 adaptive intervention을 제안하였습니다.
Method : ADAPTVIS
앞서 제안한 SCALINGVIS는 attention의 misallocation이 spatial reasoning의 오류와 연관되어 제안되었습니다. 이에 추가로 공간 관계에 따라 모델의 confidence와 accuracy가 다르게 나타남을 확인하여, SCALINGVIS를 확장하여, 모델의 self-confidence에 따라 attention 분포의 조절 방향을 결정하는 ADAPTVIS를 제안하였습니다.
Confidence가 낮으면 기존 attention 분포가 신뢰하기 어려울 수 있다고 보고, α < 1을 적용하여 분포를 smooting합니다. 이는 특정 image token에 대한 과도한 집중을 완화하고 더 넓은 이미지 영역을 참조하도록 유도합니다. 반대로 confidence가 높으면 기존 attention이 대체로 올바르다고 판단하여, α > 1 을 적용하여 더욱 sharpening 하게 합니다. 이를 통해 이미 집중 된던 주요 객체에 더 선명하게 attention을 할당하도록 합니다.
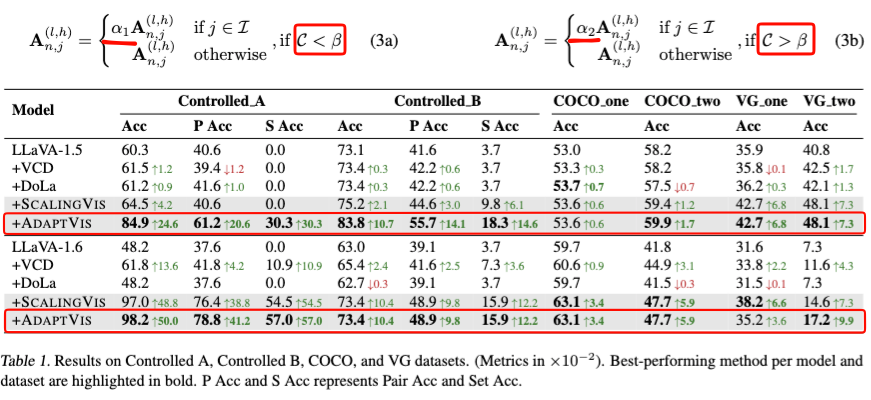
평가는 SCALINGVIS와 동일한 setting에서 수행하였습니다. 결과적으로 ADAPTVIS를 적용한 경우, Spatial reasoning 성능이 대폭 향상 되었습니다. Synthetic dataset에서 SCALINGVIS보다 크게 향상 되는 것은 고정된 constant를 사용하여 전체적으로 동일한 방향으로 attention을 조절하는 것보다, 입력의 confidence에 따라 동적으로 조절하는 방식이 더 효과적임을 알 수 있습니다. 또한 실제 이미지에 대해서도 성능의 소폭 개선이 있었습니다.
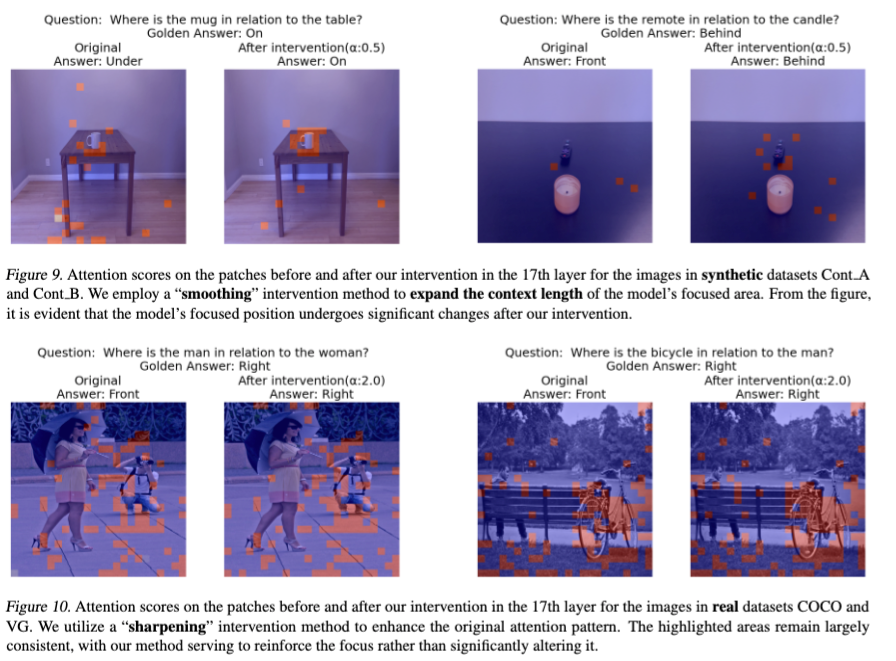
다음은 합성 이미지와 실제 이미지에서 개입 전후의 attention 분포를 비교한 결과입니다. 합성 데이터에서는 대체로 낮은 계수를 적용하여 attention 분포를 평탄하게 만드는 것이 효과적이었으며, 실제 이미지에서는 높은 계수를 적용하여 기존 attention을 강화하는 것이 효과적이었습니다.
저자들은 LLaVA 계열 모델이 COCO로 학습되어 실제 이미지 유형에 익숙하므로, 높은 confidence를 바탕으로 기존 attention을 강화하는 방식이 유효하다고 해석하였습니다. 이러한 경우에는 고정 계수를 사용하는 SCALINGVIS도 효과적이어서 ADAPTVIS의 추가 개선 폭이 작았습니다. 반면 익숙하지 않은 이미지에서는 입력별 confidence에 따라 attention을 완화하거나 강화하는 adaptive intervention의 이점이 더 크게 나타났습니다.
Conclusion and Future work
저자들은 MLLM의 spatial reasoning 한계를 layer별 attention의 관점에서 분석하였습니다. 이를 통해 이미지에 할당되는 attention의 총량보다 관련 객체에 정확히 집중하는 공간적 분포가 중요하며, confidence가 해당 분포의 신뢰도를 판단하는 단서가 될 수 있음을 확인하였습니다. 이를 바탕으로 confidence에 따라 attention 분포를 조절하는 ADAPTVIS를 제안하고, spatial reasoning 성능을 개선하였습니다.
이후로는 left/right와 같은 단순한 관계에서 더 나아가, 장기적인 추론이 필요한 복잡한 공간 관계로 분석을 확장하고, attention 이외의 성능 병목도 연구가 필요함을 언급하였습니다.
최근 Compositionality 관련 연구에서 범위를 좁혀 Spatial Understanding 관련 연구를 진행중인데, 모델의 내부적인 상태를 분석한 것이 인상 깊었습니다. 안그래도 최근 연구들도 Layer wise로 모델 내부를 분석하는 방법을 꽤나 채택하는 것으로 보입니다.
일반화 관점에서 다양한 데이터들에 정적인 방법을 적용하기 보단 동적으로 적용할 수 있는 방법이 더 눈에 가곤하는데, 해당 논문에서 그런 방식으로 접근한 것 같아 좋았습니다. 다만, 어떤 방식을 적용할 지 선택의 기준은 동적이지만, Attention의 분포를 얼마나 sharpening, smoothing할 지 정하는 기준 α 값 자체는 고정된 두 상수인 점이 아쉬웠습니다. 개입의 강도까지 조절한다면 spatial reasoning을 충분히 잘 할 수 있는지 궁금해지는 것 같습니다.
리뷰를 읽어주셔서 감사합니다!


안녕하세요 희승님, 좋은 리뷰 감사합니다.
제가 VLM에 대해 잘 알지 못해도 희승님이 설명을 잘해주셔서 쉽게 이해하며 읽을 수 있었던 것 같습니다ㅎㅎ
Confidence에 따른 attention 쪽에서 질문이 생겼는데요!
ADAPTVIS에서는 model의 confidence를 기준으로 attention을 sharpening하거나 smoothing하는 것으로 이해했습니다. 그런데 confidence가 높더라도 model의 판단이 틀릴 수 있을 것 같다는 생각이 듭니다.
이런 부분에서 confidence만으로 attention의 신뢰도를 판단하는 것이 충분한건지, 아니면 논문에서 이에 대한 보완을 위해 추가적인 정보를 활용하는지 궁금합니다!
감사합니다.
안녕하세요 희승님 리뷰 잘 읽었습니다.
몇가지 질문이 있는데, “Figure 3에서 볼 수 있듯, Image와 Text의 attention score의 합을 비교했을 때, text token보다 image token을 참조하는 정도는 약 9배 더 낮습니다. 이는 image token의 수가 적어서 발생하는 것은 아닙니다. 오히려 Image token이 훨씬 많은데도 불구하고, 출력 생성시 모델의 attention은 text에 더 집중됩니다.”
이 표현에서 figure 3 의 attention 분포가 그러면 MLLM 의 최초 layer에서의 attention 을 뽑아본건가요?
“저자들은 이를 모델이 익숙한 관계에서 기존 attention을 강화하고, 덜 익숙한 관계에서는 더 넑은 맥락을 탐색하는 것이 효과적이라고 해석하였습니다. 이는 앞서 언급하였던, 익숙한 데이터 내에서도 공간 관계에 따라 변하는 효과적인 개입 방향이 다르다는 해석과 연결됩니다.”
이 부분도 뭔가 들었을때 당연하다? 느껴지는 부분이라 생각이 드는데, 방법론도 확신하면 더 확신하고, 덜 확신하면 덜 확신하게 하는 adaptive 를 줬고, 나름 합리적이라 생각하지만 데이터셋이 너무 적은게 아닌가 싶습니다.. broad한 부분에서 평가가 됐어야하는게 아닌가,
(open reivew 에서는 다른 데이터셋 + 다른 모델에도 평가한게 있는 것 같긴하네요 효과적인지는 모르겠으나)
감사합니다.