모델이 해당 정보를 잘 알고있는가를 평가하는
- Venue: NIPS 2026
- Authors: Nadir Kutluozen, Christian Internò, David Klindt
- Affiliation: Cold Spring Harbor Laboratory, Bielefeld University
- Title: Is a Linear Probe Evidence of a Linear Representation?
0. Background
본격적인 리뷰에 앞서, 이번 논문에서 핵심적으로 다루는 Linear Probing이라는 평가 방법에 대해 먼저 살펴보겠습니다.
CLIP이나 DINO와 같은 사전학습된 Vision Encoder는 이미지를 입력받아 고차원의 Feature Representation을 생성합니다. 그런데 이렇게 생성된 Feature가 실제로 얼마나 유용한 정보를 담고 있는지는 어떻게 확인할 수 있을까요?
이를 평가하기 위해 Representation Learning 분야에서 널리 사용해 온 방법이 바로 Linear Probing입니다.
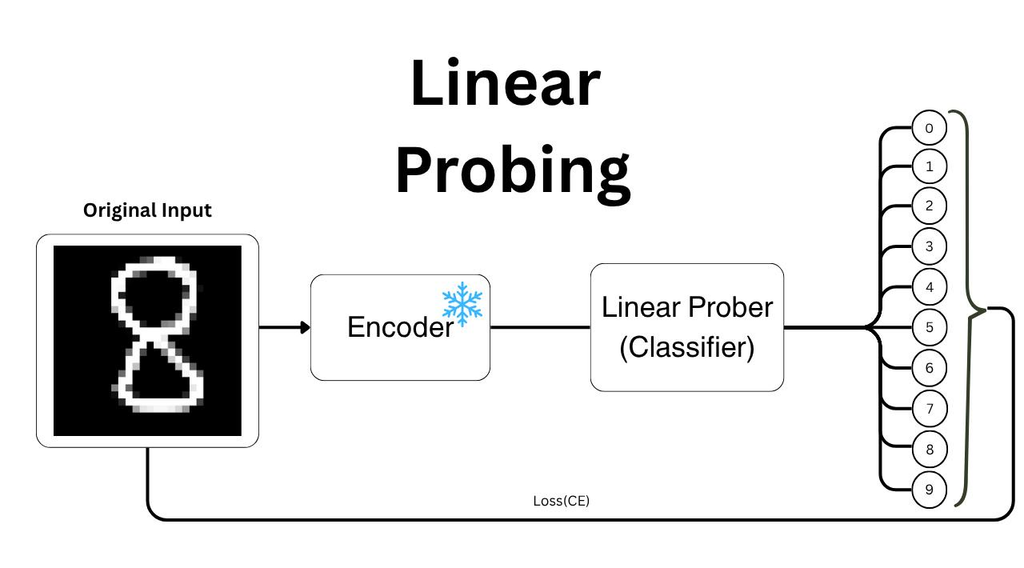
Linear Probing은 위 그림처럼 사전학습된 Encoder를 고정(Frozen)한 상태에서, 추출된 Feature에 간단한 Linear Layer만 연결하여 특정 정보를 예측하는 방법입니다. 예를 들어 이미지 속 객체의 위치를 예측한다고 가정해보겠습니다. Encoder가 생성한 Feature를 f(x)라고 할 때, Linear Probe는 다음과 같이 표현할 수 있습니다.
\hat{z}=W_{\mathrm{probe}}f(x)+b
여기서 z는 우리가 예측하고 싶은 정보로, 객체의 위치나 크기, 색상 등이 될 수 있죠. 이때 중요한 것은 Encoder는 학습하지 않고, Linear Probe의 가중치만 학습한다는 점입니다.
그런데 왜 굳이 Linear Layer를 사용하는 걸까요? 실제 Downstream Task에서는 MLP와 같은 비선형 Prediction Head를 사용하는 경우도 많잖아요?!
그 이유는 Encoder 자체의 Representation Quality를 평가하기 위해서입니다. 복잡한 MLP Head를 사용하면, 최종적으로 높은 성능이 나왔을 때 Encoder가 유용한 Feature를 생성한 덕분인지, 아니면 Head가 추가적인 비선형 변환을 학습한 덕분인지 구분하기 어려울 수 있습니다.
반면 Linear Probing은 Head의 표현력을 제한하기 때문에, 이미 학습된 Feature에서 원하는 정보를 얼마나 쉽게 선형적으로 읽어낼 수 있는지를 평가할 수 있는 것이죠.
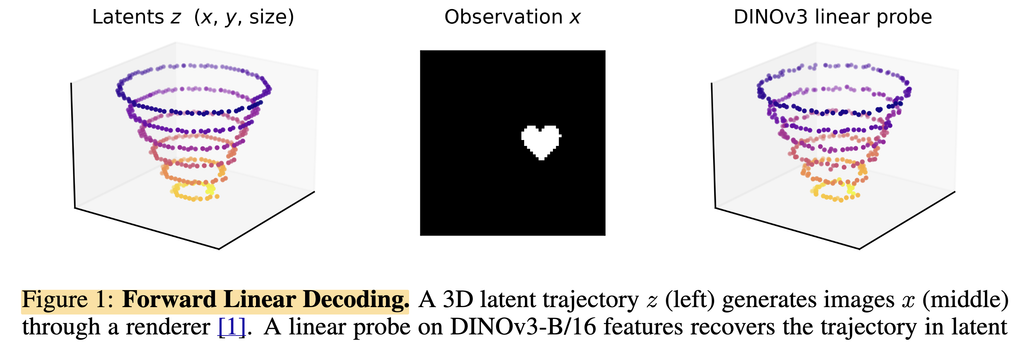
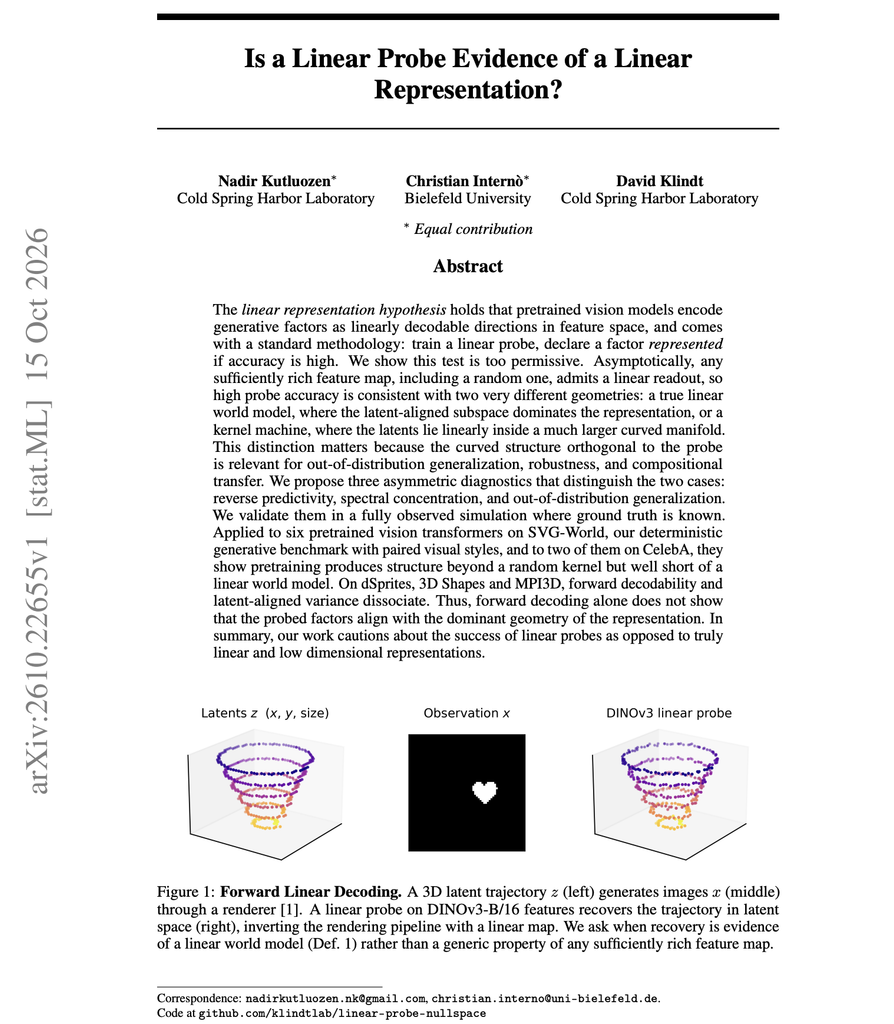
위 그림은 본 논문에서 보여준 Linear Probing의 예시입니다. 왼쪽은 객체의 x좌표, y좌표, 크기(size)라는 세 가지 변수로 구성된 궤적을 보여주고, 가운데는 해당 변수들을 이용해 렌더링한 이미지입니다. 그리고 오른쪽은 DINOv3의 Feature에 Linear Probe를 적용하여 원래의 위치와 크기를 복원한 결과이죠
흥미롭게도 왼쪽의 실제 궤적과 오른쪽의 예측 결과가 거의 일치하는 것을 볼 수 있습니다. 즉, DINOv3의 Feature만으로 객체의 위치와 크기를 선형적으로 복원할 수 있다는 것이죠!
이처럼 특정 정보를 Linear Probe로 잘 예측할 수 있다면, 해당 정보가 Feature에서 Linearly Decodable(선형적으로 복원 가능하다) 하다고 표현합니다.
따라서 높은 Linear Probing 성능은 해당 Representation이 특정 Task에 유용한 정보를 담고 있다는 근거가 될 수 있습니다. 실제로 많은 연구에서 이러한 방식으로 사전학습된 Encoder의 Representation Quality를 평가해 왔습니다.
1. Introduction
그런데 본 논문의 저자들은 이러한 Linear Probing의 결과를 해석하는 과정에서 한 가지 의문을 제기합니다.
“특정 정보를 선형적으로 복원할 수 있다는 사실만으로, 모델이 그 정보를 Representation의 주요한 선형 구조로 학습했다고 볼 수 있을까요?”
앞서 살펴본 Linear Probing은 특정 정보를 읽어낼 수 있는가를 평가하는 방법이었습니다. 하지만 저자들이 확인하고 싶은 것은 한 단계 더 나아가, 그 정보가 실제 Feature Space에서 어떤 구조를 형성하고 있는가에 대한 것이죠.
얼핏 보면 비슷한 이야기처럼 느껴지지만, 사실 두 주장은 조금 다릅니다. Linear Probing이 확인하는 것은 Feature에서 원하는 정보를 읽어낼 수 있는가에 대한 것이고, 저자들이 추가로 확인하려는 것은 그 정보가 Feature Space에서 어떤 구조를 형성하고 있는가에 대한 것이기 때문입니다.
이를 설명하기 위해 저자들은 다음 그림과 같이 서로 다른 두 가지 Representation 구조를 비교하였습니다.
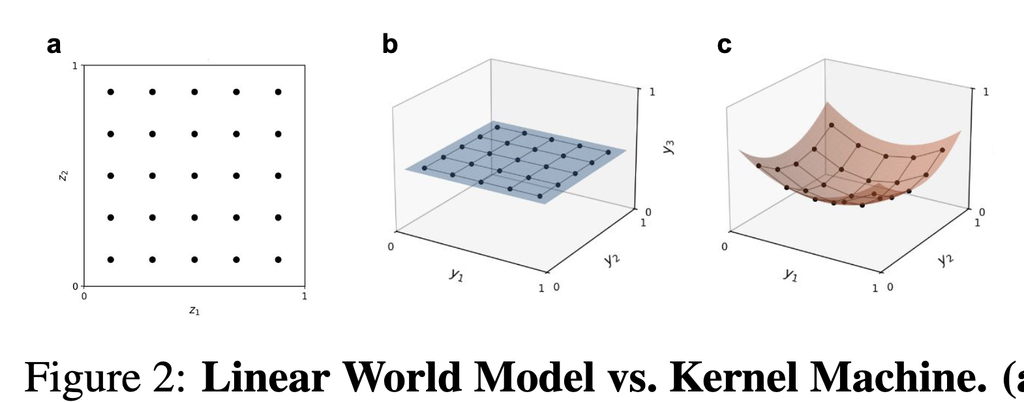
위 그림을 보면 저자들이 구분하고자 하는 두 가지 Representation을 직관적으로 이해할 수 있습니다.
먼저 (a)는 두 개의 Latent Variable인 z₁과 z₂로 구성된 2차원 좌표를 보여줍니다. 여기서 Latent Variable은 객체의 위치나 크기처럼 데이터를 생성하는 요인이라고 이해하면 됩니다. 그리고 (b)와 (c)는 동일한 Latent Variable을 서로 다른 방식으로 Feature Space에 표현한 결과입니다.
(b)의 Linear World Model에서는 Latent Variable의 변화가 Feature Space에서도 평평한 평면 형태로 나타나는 반면, (c)의 Kernel Machine에서는 휘어진 곡면 형태로 나타납니다.
그런데 흥미로운 점은 이렇게 서로 다른 구조에서도 Linear Probing으로 원래의 Latent Variable을 복원할 수 있다는 것입니다. 즉, Linear Probing 성능이 높다는 사실만으로는 두 Representation의 차이를 구분하기 어렵다는 것이죠.
더욱 흥미롭게도 저자들은 학습하지 않은 Random Feature에서도 높은 Linear Probing 성능이 나타날 수 있다는 사실을 지적합니다. 충분히 풍부한 고차원 Feature가 존재한다면, Encoder를 별도로 학습하지 않았더라도 특정 정보를 선형적으로 복원할 수 있다는 것입니다.
그렇다면 학습하지 않은 Random Feature에서도 Linear Probing이 가능하다면, 높은 Linear Probing 성능을 어디까지 해석할 수 있을까요? 본 논문은 이러한 의문에서 시작했습니다
2. Random Feature
Random Feature: 학습하지 않은 Feature에서도 Linear Probing이 가능할까?
앞서 저자들은 학습하지 않은 Random Feature에서도 높은 Linear Probing 성능이 나타날 수 있다고 언급했습니다. 그런데 조금 이상하지 않나요? 아무것도 학습하지 않은 Encoder가 어떻게 특정 정보를 선형적으로 복원할 수 있는 걸까요?
이를 이해하기 위해 저자들은 기존의 Random Feature Theory를 언급합니다.
간단한 예시로, 입력 t와 정답 y가 y=t^2라는 비선형 관계를 가진다고 가정해보겠습니다. 이때 입력 t에 Linear Regression을 적용하면 정답을 정확하게 예측하기 어렵겠죠. 그런데 입력을 f(t)=[t,t^2,t^3]라는 Feature로 변환하면 어떨까요?
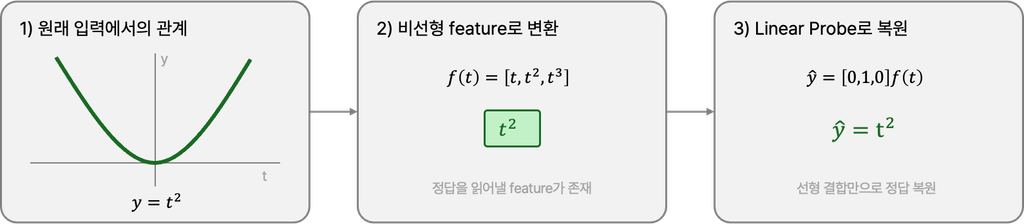
위 그림처럼 Feature의 두 번째 차원에 이미 정답인 t²가 포함되어 있기 때문에, Linear Probe는 해당 차원만 선택하여 정답을 복원할 수 있습니다. 즉, 원래 입력에서는 비선형이었던 관계가 Feature Space에서는 선형적으로 복원 가능해진 것입니다.
물론 위 예시는 필요한 Feature를 의도적으로 넣은 경우입니다. 반면 Random Feature Theory에서는 입력을 무작위로 설정된 여러 비선형 함수로 변환하여 고차원 Feature를 생성합니다. 이때 충분히 풍부한 Feature가 존재한다면, Encoder를 학습하지 않더라도 Linear Probe만 학습하여 원하는 정보를 근사할 수 있다는 것이죠.
여기서 Random Feature는 입력과 무관한 무작위 잡음이 아니라, 무작위로 초기화한 함수에 입력을 통과시켜 얻은 Feature라는 점이 중요합니다. 물론 이러한 복원이 항상 가능한 것은 아니며, Feature의 차원과 목표 함수 등에 대한 적절한 조건이 필요합니다.
결국 저자들이 강조하고 싶은 것은 Linear Probing이 성공했다는 사실만으로 Encoder가 해당 Factor를 중심으로 Representation을 구조화하도록 학습했다고 단정할 수는 없다는 것입니다.
따라서 본 논문에서는 단순한 Linear Decodability를 넘어, 실제 Feature가 Latent Variable과 얼마나 선형적으로 정렬되어 있는지 확인하기 위한 추가적인 진단 방법을 제안합니다.
3. Method: Linear World Model과 세 가지 진단 방법
앞서 살펴본 것처럼, Linear Probing만으로는 특정 정보가 Feature Space에서 어떤 구조로 표현되어 있는지까지 확인하기 어렵습니다. 그렇다면 저자들은 이러한 차이를 어떻게 검증하고자 했을까요?
먼저 저자들은 Linear World Model이라는 강한 선형 표현 구조를 다음과 같이 정의합니다.
f(x)=W\tilde{z}(x)+\mu+\varepsilon(x)
여기서 z는 객체의 위치나 크기와 같은 Latent Variable이고, W는 이를 Feature Space로 변환하는 선형 변환입니다. 또한 ε는 Latent의 선형 결합으로 설명되지 않는 나머지 Feature를 의미합니다.
쉽게 말해, 특정 Latent Variable만으로 Feature의 변화 대부분을 선형적으로 설명할 수 있다면 Linear World Model에 가깝다는 것입니다. 따라서 저자들은 단순히 정보를 복원할 수 있는지보다, 해당 정보가 Feature의 주요 변화를 얼마나 설명하는지 확인하고자 했습니다.
이를 위해 다음과 같은 세 가지 진단 방법을 제안합니다.
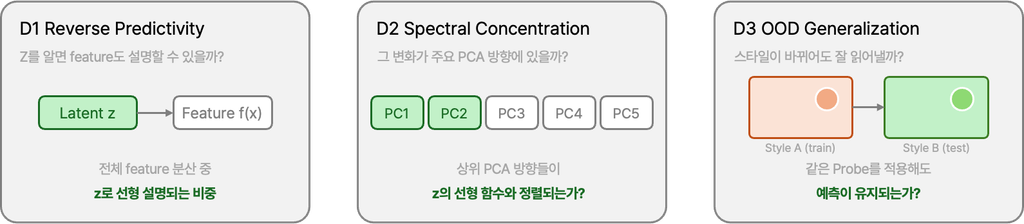
D1. Reverse Predictivity
기존 Linear Probing은 Feature에서 Latent를 예측하는 Forward 방식이었습니다. 그런데 저자들은 반대로 Latent를 이용해 Feature를 얼마나 잘 설명할 수 있는지 확인합니다.
예를 들어 객체의 위치를 알고 있을 때, 그 위치만으로 Feature의 변화 대부분을 선형적으로 예측할 수 있다면 Reverse R²가 높게 나타납니다. 반대로 Feature에 위치로 설명되지 않는 비선형적인 변화나 다른 정보가 많이 포함되어 있다면 Reverse R²는 낮아질 수 있겠죠.
즉, D1은 전체 Feature Variance 중 Latent로 선형적으로 설명되는 비율을 측정하는 방법입니다.
D2. Spectral Concentration
D1이 Feature 전체의 분산을 살펴봤다면, D2는 Latent와 관련된 선형적 변화가 Feature의 주요 분산 방향에 정렬되어 있는지 확인합니다.
이를 위해 PCA를 적용하여 Feature의 분산이 큰 방향부터 정렬하고, 상위 Principal Components가 Latent의 선형적인 변화로 얼마나 설명되는지 측정합니다. 이때 각 PC의 분산을 동일하게 맞추는 Whitening을 적용합니다.
예를 들어 객체의 위치가 Feature의 상위 PCA 방향들과 잘 정렬되어 있다면 Spectral Concentration이 높게 나타나는 것이죠.
D3. OOD Generalization
마지막은 시각적 환경이 달라져도 동일한 Linear Probe가 작동하는지 확인하는 방법입니다.
예를 들어 바다를 배경으로 한 이미지에서 객체의 위치를 예측하도록 Linear Probe를 학습한 뒤, 서부 사막을 배경으로 한 이미지에 그대로 적용한다고 가정해보겠습니다.
만약 모델이 시각적 스타일과 무관하게 위치 정보를 안정적인 선형 관계로 표현하고 있다면, 새로운 환경에서도 기존 Linear Probe의 예측 성능이 유지될 가능성이 높겠죠.
결국 저자들은 이러한 세 가지 진단 방법을 통해 Linear Decodability가 높다는 사실과 실제 Representation이 강한 선형 구조를 갖는다는 사실을 구분하고자 했습니다.
다만 여기서 중요한 점은, 이러한 지표들이 좋은 Representation의 보편적인 기준은 아니라는 것입니다. 저자들이 정의한 Linear World Model에 얼마나 가까운지를 확인하기 위한 방법이며, 높은 점수만으로 해당 구조가 완전히 입증되는 것도 아닙니다.
그렇다면 실제로 Linear Probing 성능이 비슷한 모델에서도 이러한 진단 지표들이 서로 다른 결과를 보여줄까요? 다음 장에서는 Random Encoder와 학습된 Encoder를 비교한 실험을 살펴보겠습니다.
4. Controlled Simulation
앞서 저자들은 Linear Probing만으로는 Linear World Model과 Kernel Machine을 구분하기 어렵다고 설명했습니다. 그렇다면 실제로 Linear Probing 성능은 비슷하지만, Representation의 내부 구조는 서로 다른 경우가 존재할까요?
이를 확인하기 위해 저자들은 실제 이미지 대신 정답을 정확히 알고 있는 간단한 Simulation을 구성했습니다.
먼저 2차원의 Latent Variable을 생성하고, 이를 고정된 Random Fourier Mapping으로 256차원으로 변환한 뒤, 2-layer MLP를 통해 Feature를 생성합니다. 이때 MLP는 Random Initialization, 학습된 모델, Weight Decay를 적용해 학습된 모델의 세 가지 조건으로 비교하였으며, Feature Dimension도 4부터 1024까지 변화시켰습니다.
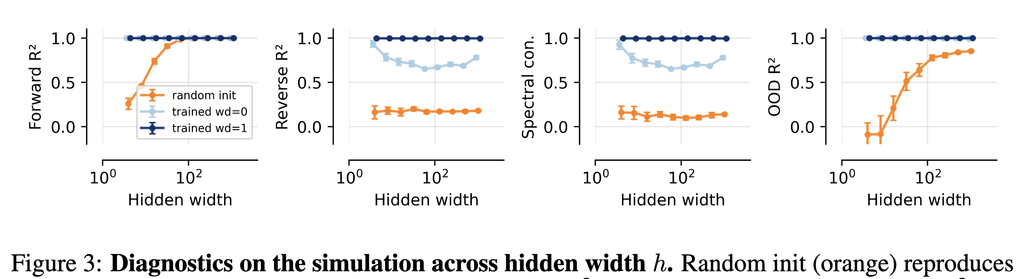
위 Figure 3에서 가장 먼저 살펴볼 것은 첫 번째 Forward R² 그래프입니다. 놀랍게도 Random Encoder 역시 Feature Dimension이 증가하면서 성능이 빠르게 향상되었고, 약 100차원부터는 학습된 모델과 마찬가지로 거의 완벽하게 Latent를 복원했습니다.
그런데 두 번째 Reverse R² 그래프에서는 전혀 다른 결과가 나타났습니다. Random Encoder의 Reverse R²는 약 0.2에 머문 반면, 학습된 모델은 훨씬 높은 값을 보였고, Weight Decay를 적용한 경우 거의 1에 도달했습니다. 주요 PCA 방향의 정렬 정도를 살펴본 세 번째 그래프에서도 유사한 차이를 확인할 수 있습니다.
즉, Latent를 복원하는 능력은 비슷했지만, Latent가 Feature의 주요 변화를 선형적으로 설명하는 정도는 크게 달랐던 것입니다.
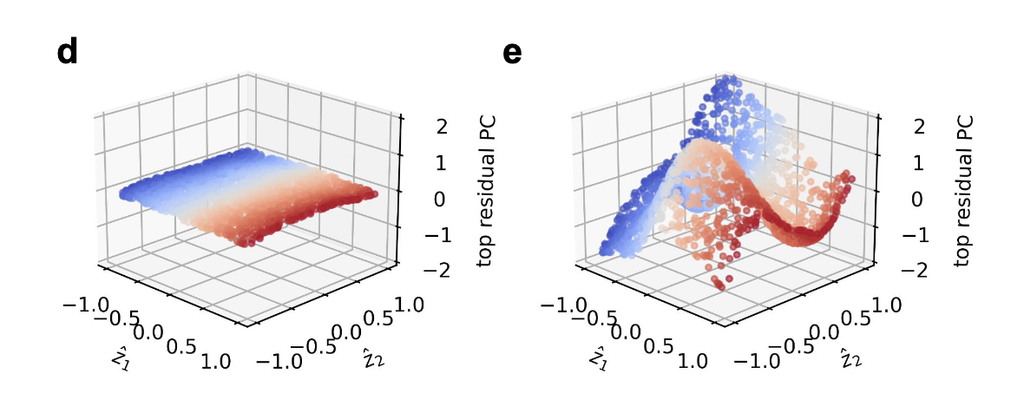
이러한 차이는 상단 그림 (d–e)에서도 확인할 수 있습니다. 학습된 Encoder의 Feature는 (d)처럼 거의 평평한 평면을 형성한 반면, Random Encoder의 Feature는 (e)처럼 휘어진 곡면 구조를 보였습니다.
다시 말해, Random Encoder에서도 Latent를 선형적으로 읽어낼 수는 있지만, Feature에는 Linear Probe가 설명하지 못하는 비선형적인 변화가 상당히 남아 있었던 것이죠.
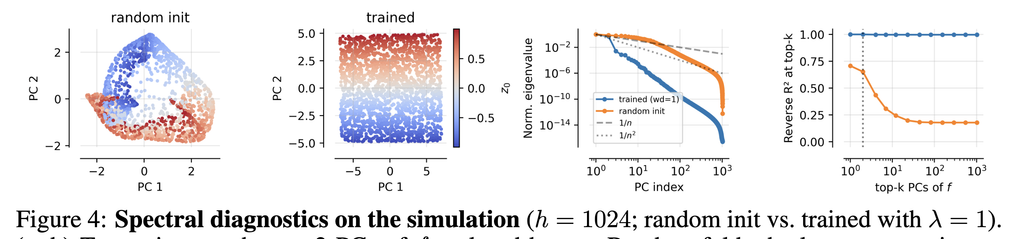
Figure 4에서도 유사한 결과가 나타난걸 확인할 수 있었습니다. Weight Decay를 적용한 모델은 상위 2개의 Principal Component가 전체 Feature 분산의 99.57%를 설명한 반면, Random Encoder에서는 25.35%에 불과했습니다. 즉, 학습된 모델에서는 두 Latent에 대응하는 선형 구조가 주요 분산 방향에 집중된 반면, Random Encoder에서는 분산이 훨씬 다양한 방향에 퍼져 있었던 것입니다.
결국 이번 실험을 통해 저자들은 Forward Linear Probing만으로는 구분할 수 없었던 Representation의 구조적 차이를, Reverse Predictivity와 Spectral Concentration을 통해 확인할 수 있다는 점을 보였습니다.
다만 이 실험은 단 두 개의 Latent Variable을 예측하는 간단한 Simulation이라는 한계가 있습니다. 그렇다면 다양한 시각 정보를 표현하도록 사전학습된 실제 Vision Encoder에서도 비슷한 현상이 나타날까요? 이를 다음 장에서 살펴보겠습니다.
5. Real Vision Encoders
앞선 Simulation에서는 Random Encoder와 학습된 Encoder가 동일한 Linear Probing 성능을 보이더라도, 실제 Feature의 구조는 크게 다를 수 있다는 것을 확인했습니다. 그렇다면 CLIP이나 DINOv3와 같은 실제 Pretrained Vision Encoder에서도 이러한 차이가 나타날까요?
이를 확인하기 위해 저자들은 SVG-World라는 새로운 합성 이미지 데이터셋을 구성하였습니다.
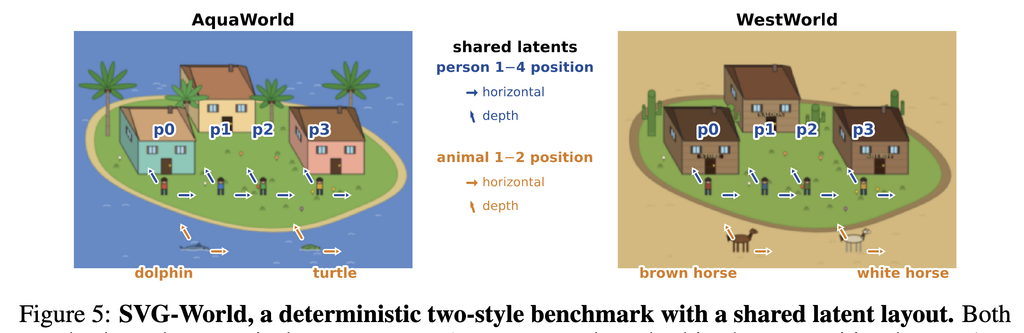
위 Figure 5를 보면, AquaWorld와 WestWorld라는 서로 다른 두 가지 스타일의 환경이 등장합니다. 두 환경에는 각각 4명의 사람과 2마리의 동물이 등장하며, 객체들의 위치를 결정하는 Latent Variable은 동일하지만 이미지의 시각적 스타일만 다르게 구성되어 있습니다.
저자들은 이러한 환경에서 총 12개의 객체 위치 변수를 평가하였으며, 이를 통해 위치 정보가 Feature에서 얼마나 잘 복원되는지뿐 아니라, 스타일이 달라져도 동일한 선형 관계가 유지되는지 확인하고자 했습니다.
먼저 DINOv3-B/16의 Pretrained Encoder와 Random Initialization Encoder를 비교하였습니다.
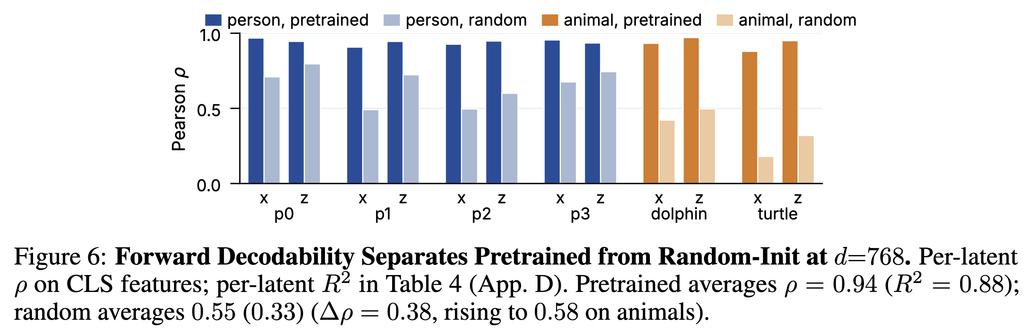
Figure 6을 보면 Pretrained DINOv3가 Random Encoder보다 객체의 위치를 훨씬 잘 복원하는 것을 확인할 수 있습니다. CLS Feature 기준 Forward R²는 Pretrained가 0.88, Random Encoder가 0.33으로 나타났습니다.
앞선 Simulation에서는 Random Encoder도 거의 완벽한 Forward Decoding 성능을 보였지만, 실제 Vision Encoder에서는 그렇지 않았던 것이죠. 이는 Pretraining이 실제로 위치 정보의 Linear Decodability를 향상시킨다는 것을 보여줍니다.
그런데 Forward 성능이 높아졌다고 해서 Linear World Model에 가까워졌다고 볼 수 있을까요? 이를 확인하기 위해 D1과 D2를 적용하였습니다.
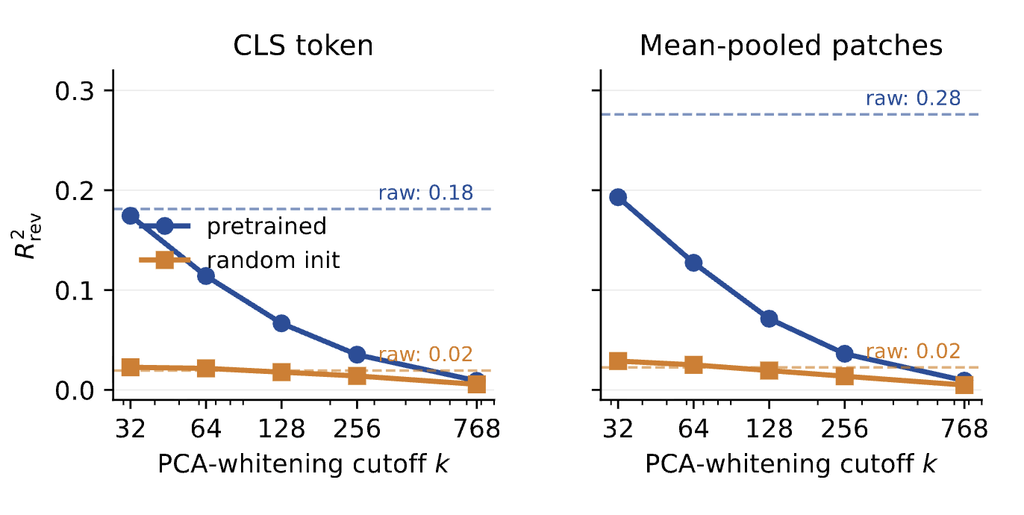
Figure 7에서 점선은 전체 Feature에 대한 Reverse R²를 보여줍니다. Pretrained DINOv3는 CLS 기준 0.18, Mean-pooled Patch 기준 0.28로, Random Encoder의 0.02보다 높은 결과를 보였습니다.
또한 실선 그래프를 보면 Pretrained 모델에서는 Latent와 선형적으로 관련된 Feature 변화가 상위 약 32~64개의 Principal Components에 상대적으로 집중되어 있음을 확인할 수 있습니다.
즉, Pretraining을 통해 위치 정보가 단순히 복원 가능한 수준을 넘어, Feature의 주요 분산 방향과 더 강하게 정렬된 것이죠. 하지만 Reverse R²의 절대적인 값은 여전히 낮았기 때문에, 저자들이 정의한 강한 Linear World Model에 도달했다고 보기는 어려웠습니다.
마지막으로 저자들은 이러한 위치 정보가 이미지 스타일이 달라져도 안정적으로 유지되는지 확인하였습니다.
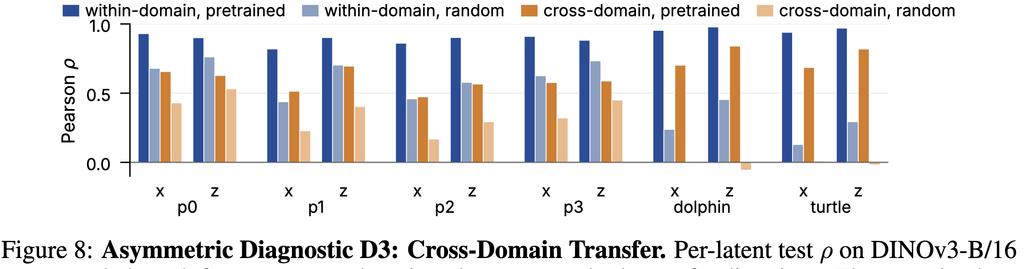
Figure 8은 한 스타일에서 학습한 Linear Probe를 다른 스타일에 적용한 결과입니다. Pretrained DINOv3의 Pearson Correlation은 동일한 스타일에서 0.91, 다른 스타일에서는 0.65로 감소하였지만, Random Encoder의 Cross-domain 성능인 0.23보다는 훨씬 높게 나타났습니다.
따라서 Pretrained DINOv3는 위치 정보를 읽어내는 선형적인 관계를 시각적 스타일이 바뀐 상황에서도 부분적으로 유지하고 있음을 확인할 수 있습니다. 다만 여기서는 Feature 평균을 스타일별로 보정하고 Pearson Correlation을 평가하였으므로, 새로운 환경에서도 정확한 좌표값을 그대로 복원한다는 의미는 아닙니다.
이후 저자들은 DINOv2, DeiT, CLIP 등 다른 Encoder와 dSprites, CelebA 등의 데이터셋으로 실험을 확장하였습니다. 전반적으로 Pretraining은 Latent와 정렬된 Feature 구조를 강화하는 경향을 보였지만, 이러한 결과가 모든 데이터셋에서 일관되게 나타나지는 않았습니다.
흥미롭게도 DINOv3의 모델 크기가 커질수록 Forward R²는 증가했지만, Reverse R²는 오히려 감소하기도 했습니다. 즉, 특정 정보를 더 잘 복원하는 것과 그 정보가 Feature의 주요 분산을 더 많이 설명하는 것은 반드시 함께 증가하지 않는다는 것이죠.
결국 저자들은 Pretraining이 특정 Latent Variable을 선형적으로 복원 가능하게 만드는 것을 넘어, 해당 정보와 관련된 Feature의 선형적 정렬을 강화한다는 점을 확인하였습니다. 다만 실제 Pretrained Encoder는 저자들이 정의한 강한 Linear World Model을 만족하지 않았으며, 이는 단순한 Random Feature와도 다른 중간적인 Representation 구조를 형성하고 있음을 보여줍니다.
6. Discussion & Conclusion
지금까지 저자들은 높은 Linear Probing 성능이 반드시 Linear World Model을 의미하지는 않는다는 것을 이론과 실험을 통해 보여주었습니다. 특히 Random Feature에서도 높은 Linear Decodability가 나타날 수 있으며, 실제 Pretrained Encoder는 단순한 Random Feature보다 더 구조화된 Representation을 학습하지만, 강한 Linear World Model에는 도달하지 못한다는 것을 확인했습니다.
그런데 여기서 한 가지 의문이 남습니다. 애초에 좋은 Representation이라면 특정 Latent Variable이 Feature의 주요 분산 방향을 설명해야 하는 걸까요?
흥미롭게도 저자들은 Discussion에서 일반적인 Pretrained Encoder가 강한 Linear World Model을 만족할 것으로 기대하지 않는다고 설명합니다. CLIP이나 DINOv3와 같은 범용 Encoder는 객체의 위치뿐 아니라 색상, 형태, 질감 등 다양한 정보를 함께 표현해야 하기 때문이죠. 따라서 특정 Factor가 Feature 전체의 분산을 충분히 설명하지 못한다고 해서, 해당 모델의 표현력이 부족하다고 볼 수는 없습니다.
저자들 역시 Linear World Model을 좋은 Representation의 필수조건이라기보다, Representation이 특정 Factor와 얼마나 선형적으로 정렬되어 있는지 분석하기 위한 하나의 강한 기준으로 해석하고 있습니다.
개인적으로는 이 지점에서 논문의 문제 설정에 대한 의문이 남았습니다. 기존 연구에서 Linear Probing은 주로 “해당 정보가 Representation에 존재하는가?” 를 확인하기 위한 평가 방법으로 사용되어 왔습니다. 그렇다면 실제로 기존 연구들이 높은 Linear Probing 성능을 근거로, 해당 정보가 Feature의 주요 분산 방향까지 형성한다고 주장해왔는지는 조금 더 명확히 짚어줄 필요가 있지 않았을까 싶습니다.
또한 본 논문은 Linear Decodability와 Representation의 구조적 차이를 구분하는 데 성공했지만, 이러한 구조적 차이가 실제 Downstream Generalization이나 Compositionality에 얼마나 중요한 영향을 미치는지는 아직 충분히 검증되지 않았다고 생각합니다. 저자들 역시 이러한 연결을 향후 연구 과제로 제시하고 있습니다.
결국 본 논문은 Linear Probing 자체의 유용성을 부정하기보다는, Linear Probing 결과로부터 Representation의 내부 구조까지 해석하는 과정에서 주의가 필요하다는 점을 강조한 연구라고 볼 수 있을 것 같네요!
다만 저자들이 제안한 강한 Linear World Model이 실제 모델의 일반화 능력이나 활용 가능성을 설명하는 데 어떤 추가적인 가치를 제공하는지는 여전히 남은 질문인 것 같습니다. 이상 리뷰 마치겠습니다~!

안녕하세요 주영님 좋은리뷰 감사합니다.
figure 3 아래의 Feature 그림에서 Random Encoder에는 Linear Probe가 설명하지 못하는 비선형적인 변화가 상당히 남아 있기는 하지만, 그래도 latent space의 값과 원본 데이터의 상관관계가 있었다고 이해했습니다, 이를 linear probing을 하려는 시도 자체에 문제가 쉽다는 변수가 작동할 수 있다는 것으로 이해해도 될까요?
좋은 질문 감사합니다!
말씀하신 것처럼 Random Encoder에서도 원본 데이터의 Latent 정보가 일부 유지될 수 있습니다. 애초에 입력 데이터가 Latent Variable을 바탕으로 생성되었기 때문에, Encoder를 학습하지 않았더라도 그 정보가 Feature에 남아 있을 수 있는 것이죠.
다만 이 논문에서 얘기하고 싶은 것은 Linear Probing 자체에 문제가 있다기보다는, 그 결과를 해석할 때 주의가 필요하다는 의미에 가깝습니다.
Random Encoder에서도 Linear Probe로 Latent를 잘 복원할 수 있지만, Feature 전체에는 Latent의 비선형적인 변화가 많이 남아 있을 수 있습니다.
따라서 Linear Probing 성능이 높다는 사실만으로 Encoder가 해당 정보를 중심으로 선형적인 Representation을 학습했다고 단정할 수 없다 는 것이 본 논문의 핵심이라고 이해하시면 좋을 것 같습니다!
안녕하세요, 주영님. 좋은 리뷰 감사합니다.
마침 Linear Probing이 Representation을 평가하는데 충분한지 의문을 가지고 있었는데, 관련된 리뷰를 해주셔서 일부 해소된 것 같습니다. 다만 해당 논문이 Linear Probing이 문제라서 새로운 방법을 제안한 연구는 아니어서 아쉬웠던 것 같습니다ㅎㅎ. 간단한 질문이 있어 댓글로 남기겠습니다!
1. Principal Component 방향으로 Random Encoder보다 Pretrained의 경우 더 잘 정렬되어있다고 언급해주셨습니다. 이때, 어떤 특정 task에서는 정렬된 상위 PC보다 다른 하위 PC에 더 의존적인 경우가 존재할 수 있을까요? 그렇다면, 위와 같은 경우에 Linear Probing으로 해당 task에 필요한 정보를 가지고 있다고 판단하기 어려울 것 같다는 의문이 듭니다!
감사합니다!
좋은 질문 감사합니다! 저도 읽으면서 좀 헷갈렸던 포인트에 대해 질문 달아주신 것 같은데요!
말씀하신 것처럼 특정 Task에 필요한 정보가 반드시 상위 PC에 존재하는 것은 아니며, 하위 PC에 더 많이 포함되어 있을 가능성도 있습니다!
다만 Linear Probing은 전체 Feature를 사용한다면 하위 PC에 존재하는 정보도 선형적으로 복원할 수 있습니다. 반대로 상위 PC만 선택해서 평가한다면 해당 정보를 놓칠 수도 있겠죠.
결국 Feature의 분산이 큰 방향과 특정 Task에 유용한 정보가 존재하는 방향이 반드시 일치하는 것은 아닙니다. 이 점에서 본 논문의 Spectral Concentration 역시 Representation의 구조를 분석하는 지표이지, 그 자체로 표현력의 우수성을 판단하는 기준은 아니라고 생각합니다