안녕하세요.
이번 주는 Image representation의 구조도 text representation과 같이 attribute, object, relation 과 같은 concept들을 분리하고 재조합할 수 있는 구조를 가지고 있는 지에 대해 연구한 논문을 리뷰해보려고 합니다. (참고로 해당 논문은 CVPR highlight 논문입니다.)
Motivation
VLM은 text,image라는 서로 다른 modality를 shared space에서 학습합니다. 이를 통해 text, image feature를 비교할 수 있게 합니다. 이를 전제로 기존 연구는 text embedding space는 linear combination (선형 조합) 으로 나타낼 수 있음을 보였습니다.
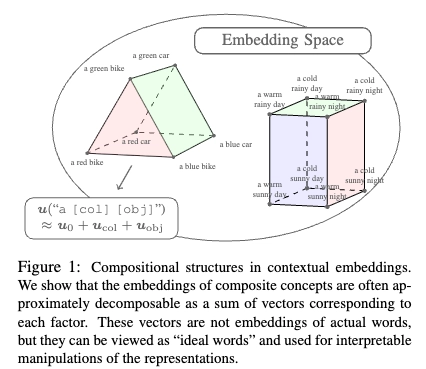
“Linear spaces of meanings: compositional structures in vision-language models, ICCV, 2023”
위와 같이 embedding space에서 새로운 concept으로 조합할 수 있는 vector들을 ideal word라고 불렀습니다. 해당 연구의 저자들은 text 즉, 언어를 표현하는 symbolic한 구조가 의미적 조합을 계산할 수 있을 것이라는 가정을 통해 접근하였습니다.
이에 저자는 Image representation에도 다음과 같은 구조가 들어있는가에 대한 의문으로 자연스럽게 이어졌습니다.
Image와 Text의 차이
Image라는 modality는 Text와 큰 차이가 존재합니다.
첫 번째로는 Image는 Text에 비해, Noise와 Ambiguity를 고려해야 한다는 점입니다. Text는 대체로, 그 자체로 의미가 명료한 반면, Image의 경우 어디를 집중해서 보는 지에 따라, 배경 또는 객체 등 다양한 visual cue를 고려해야 합니다.
두 번째로, 다양한 조합에 대한 image data가 부족하다는 점입니다. ( data sparcity ) “blue dog”와 같이 비자연적인 조합에 대해 text는 단순 조합으로 충분히 data를 구성할 수 있는 반면, 이에 대응하는 image data는 수집하기 매우 어렵습니다.
Approach
저자들은 image가 text와의 차이를 인지하고, text와 같이 단순 linear structure로는 visual concept들을 구성 및 재구성 하기에는 불충분하다고 보았습니다. 따라서 Manifold Geometry를 반드시 고려해야한다고 주장하였습니다.
Method
Preliminaries
저자들이 Image representation을 Manifold Geometry를 기반으로 구조를 엄밀하게 분석하기 위해 사전에 몇 가지 개념들을 정리하였습니다.
Contrastive Language-Image Pretraining (CLIP)
- Encoders (\phi)
\phi_{\mathrm{im}} : \mathcal{X} \to \mathbb{R}^{d}
\phi_{t} : \mathcal{Y} \to \mathbb{R}^{d}
Image, Text encoder를 수식적으로 다음과 같이 정의하였습니다. - Consine Similarity
Image (x \in \mathcal{X}) 와 Text (y \in \mathcal{Y})의 latent representation을 기반으로
내적 (u_x^{\top}u_y)을 수행합니다.
이때 대상은 u_x = \phi_{im}(x) / ||\phi_{im}(x)|| , u_y = \phi_{t}(y) / ||\phi_{t}(y)||로, 정규화 된 값입니다.
Riemannian Manifolds
리만 매니폴드란 ‘각 점의 접공간에 양의 정부호 쌍선형 형식인 리만 계량이 주어진 매끄러운 매니폴드’ 라는 심오한 정의를 가지고 있습니다.
- Manifold, Intrinsic distance
여기서 매니폴드란 국소적으로 볼 땐 유클리드 공간처럼 평평하게 보이는 위상 공간을 의미합니다. 예로, 지구의 표면은 둥글지만 현재 지상을 보았을 때 평평하게 보이는 것이라고 생각하면 됩니다.
이때, 리만 계량이라는 metric이 주어진 리만 매니폴드에서 두 점 사이의 거리를 곡률과 표면 등을 고려하여 계산할 수 있고 이를 intrinsic distance(내재적 거리)라고 부릅니다. - Exponential maps, Logarithmic maps
\mu 를 manifold \mathcal{M} 위의 점이라고 가정하고, T_{\mu} \mathcal{M}를 \mu 위의 접공간(tangent space) 라고 가정합니다.
Exponential map은 \mu의 접공간 위의 점을 manifold로 투영하는 역할을 합니다.
\mu를 출발점으로 매개변수 t=0~1 동안 초기 벡터 v를 기반으로 움직인 후 도착점을 \gamma_v(1)라고 한다면, \operatorname{Exp}_{\mu}(v) := \gamma_v(1) 를 만족합니다.
Logarithmic map은 manifold 위의 점을 다시 접공간으로 투영하는 함수로, Exponential map과 역함수 관계를 가집니다.
\operatorname{Log}_{\mu} = \operatorname{Exp}_{\mu}^{-1}
이때, 두 점이 \mu 근처에 있다면, 곡면 위에서 잰 거리는 Log 함수로 접공간에 옮긴 뒤 잰 유클리드 직선 거리와 거의 같습니다.
d_{\mathcal{M}}(u,u') \approx \left\| \operatorname{Log}_{\mu}(u)-\operatorname{Log}_{\mu}(u')\right\|,\qquad u,u' \in \mathcal{M}
여기서 두 점 중 하나가 \mu라면 두 거리는 정확히 같아집니다. - Intrinsic mean
\mu=\operatorname*{arg\,min}_{u \in \mathcal{M}}\sum_{i=1}^{N}w_i\,d_{\mathcal{M}}(u,u_i)^2
어떤 점에서 모든 점까지의 곡면 위 거리의 제곱을 가중합하였을 때, 그 값이 가장 작아지는 중심점을 \mu 라고 합니다. 즉, Manifold의 모양을 고려해서 구한 평균 위치입니다.
해당 intrinsic mean을 기준으로 Log를 적용하면, 투영된 벡터들의 가중 평균이 접공간의 원점이 되어, 이후 decompose, compose 계산을 위한 중심으로 사용하기 좋다고 언급합니다.
Geodesically Decomposable Embeddings
먼저, 의미들의 조합을 Z = Z_1 \times \cdots \times Z_s로 정의합니다. 예를 들어 Z = \{red,blue\} \times \{car, dress, flower\} 처럼 concept의 가능한 조합들을 Cartesian product로 표현할 수 있습니다.
해당 공간 내의 z는 encoder를 통해 u_z로 표현할 수 있습니다.
지금까지의 정의 및 정리를 기반으로 Geodesic Decomposability를 확인합니다.
Definition 1
저자는 embedding(\phi(Z) = \{u_z \mid z \in Z\} \subset \mathcal{M})의 concept vector(z_i \in Z_i (i = 1, …, s))들이 접공간 위의 vector로 표현(v_{z_i} \in T_{\mu}\mathcal{M})이 가능하다면, geodesically decomposable하다고 합니다.
u_z =\operatorname{Exp}_{\mu}\left(v_{z_1}+\cdots+v_{z_s}\right),\qquad \forall z=(z_1,\ldots,z_s)\in Z
즉, 접공간 위의 concept vector v_{z_i} 들의 합으로 표현할 수 있습니다.
Lemma 1
\phi(Z)가 geodesically decomposable할 때, 각 concept vector들의 중심을 맞추면 (\sum_{z_i \in Z_i}\text{v}_{z_i} = 0 for all i = 1, …,s) Definition 1의 수식을 만족하는 decomposable vector가 유일하게 정해집니다.
아무리 전체 vector들의 합으로 표현되어도, 합의 결과만으로는 각 vector를 decompose할 수 없습니다. 모든 색상 vector에 c를 더하고, 객체 vector에 c를 뺸다면 (v_{red} + c) + (v_{car} - c) = v_{red} + v_{car} 인 것처럼, 어떠한 decomposed vector를 유일하게 정할 수 없습니다. 따라서, 각 concept vector의 합을 0으로 하여, concept끼리의 중심을 맞춥니다.
이때의 기준점은 \mu가 되며, 해당 기준점에서, concept vector들의 합을 통해 재조합할 수 있다는 것이 저자의 주장입니다.
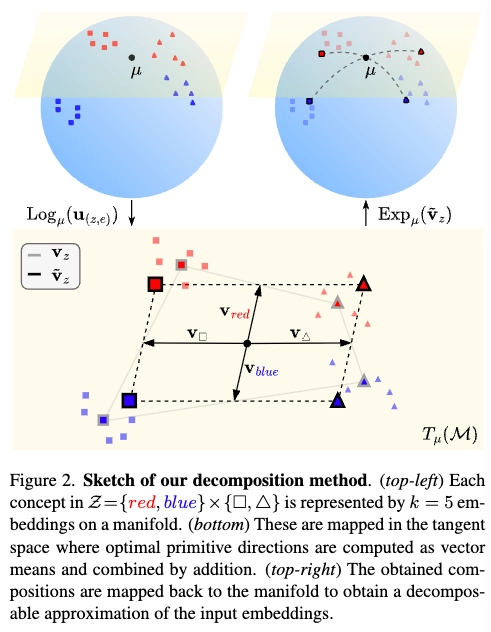
Best decomposable approximation
앞선 Lemma 1에서 중심을 맞추었기 때문에, decomposable한 representation의 concept들이 차지하는 차원은 최대 \sum_i (|Z_i| - 1)입니다. ( 합을 0으로 맞추었기 때문 ) 하지만, 실제 embedding에서는 해당 구조를 만족하지 않을 수 있습니다. 따라서, 저자는 decompsoable embedding을 근사를 통해 구해야 한다고 주장하였습니다.
\sum_{z \in Z} d_{\mathcal{M}}\left(u_z, \tilde{u}_z\right)^2
먼저, 원래 임베딩과, 구하고자 하는 decomposable embedding 사이의 거리 제곱합을 최소화합니다. 이때, 곡면에서는 거리를 구하기 어렵기 때문에, Log를 통해 접공간으로 투영하여 decomposable embedding을 구합니다.
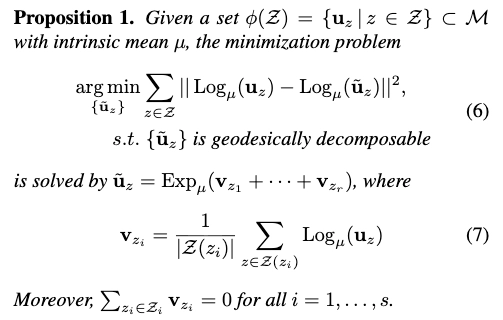
이때, 각 concept vector는 동일한 concept을 포함한 vector들의 평균을 통해 구할 수 있습니다. 이를 기반으로, 재조합하고 Exp를 통해 곡면으로 투영하면 본래의 decomposable embedding으로 복원할 수 있습니다.
Experimental Validation
앞선 정의들을 기반으로 CLIP의 이미지 embedding에 compositional decomposable structure가 존재하는지, 존재한다면, 해당 구조가 실제 task에서 유용한지 검증하고자 하였습니다.
Baseline 모델은 pretrained CLIP ViT-L/14를 사용하였으며, CLIP ResNet50, SigLIP도 함께 평가하였습니다.
데이터는 attribute-object label을 가진 image로 구성하였습니다.
Visualizing Compositional Embeddings
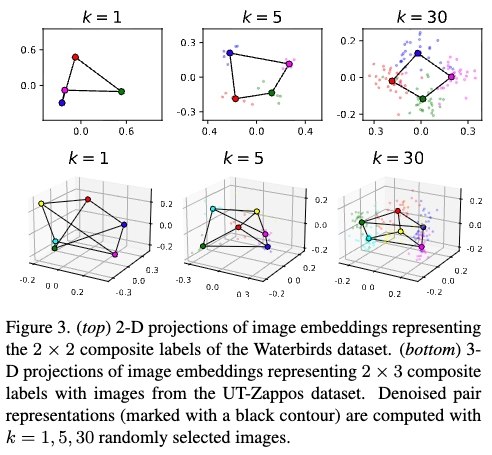
먼저, 저자들은 image embedding이 실제로 decomposable한 구조를 가지는지 기하학적으로 확인하였습니다.
이를 위해 image embedding을 접공간으로 옮기고, 같은 attribute-object 조합에 해당하는 vector들을 평균하였습니다. 이후 PCA를 통해 해당 representation의 배치를 시각화하였습니다.
만약 representation이 attribute vector와 object vector의 합으로 표현된다면, 같은 attribute의 변화는 object가 달라져도 동일한 방향으로 나타나야 합니다. 따라서 2개의 attribute와 2개의 object로 구성된 조합은 평행사변형, 2개의 attribute와 3개의 object로 구성된 조합은 삼각기둥과 같은 구조를 형성하게 됩니다.
[Figure 3]에서는 Waterbirds의 2×2 조합과 UT-Zappos의 2×3 조합을 대상으로 이를 확인하였습니다. 각 조합에 사용하는 image 수를 1, 5, 30개로 늘릴수록 noise가 줄어들며, representation이 이러한 형태에 가까워지는 경향을 보였습니다.
이를 통해 저자들은 visual embedding에도 text embedding처럼 근사적으로 decomposable한 구조가 존재한다고 해석하였습니다.
Compositional Classification
다음으로는 분해한 concept vector들을 활용하여, decompose에 사용한 데이터에서 관측하지 못한 attribute-object 조합을 인식할 수 있는지 평가하였습니다.
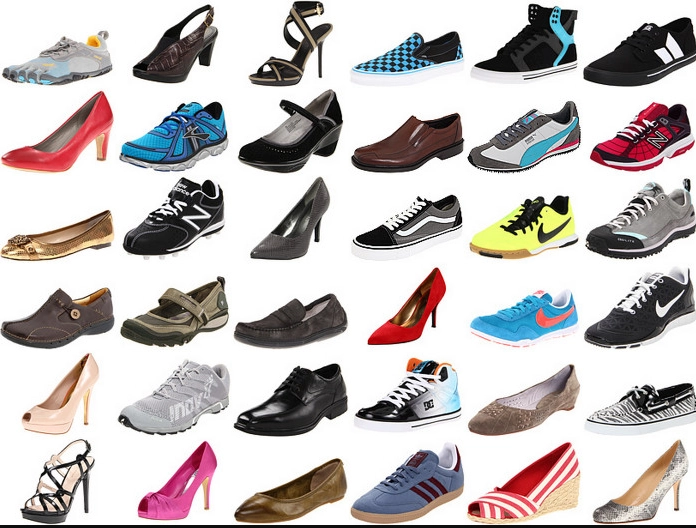
해당 실험에는 소재와 신발 종류로 구성된 UT-Zappos, 다양한 객체와 그 상태로 구성된 MIT-States를 사용하였습니다. (다음은 UT-Zappos 예시)
먼저 학습 데이터에서 attribute direction과 object direction을 추정합니다. 이후 두 vector를 더하고 Exponential map을 적용하여, 각 조합의 대표 embedding을 구성합니다.
\tilde{u}_{(a,o)} = \operatorname{Exp}_{\mu}(v_a + v_o)
예를 들어, ‘red’와 ‘car’에 해당하는 direction을 구했다면, 이를 조합하여 ‘red car’의 embedding을 만들 수 있습니다. 각 기본 concept이 데이터에 등장하였다면, 해당 조합의 image가 없어도 representation을 구성할 수 있다는 것입니다.
이후 test image의 embedding과 각 조합의 대표 embedding을 비교하여, cosine similarity가 가장 높은 조합을 예측합니다.
(\hat{a},\hat{o}) = \operatorname*{arg\,max}_{(a,o)\in Z^{\mathrm{test}}} \tilde{u}_{(a,o)}^{\top}u_x
평가는 두 가지 설정에서 수행하였습니다.
- Closed-world : 데이터셋에 실제로 존재하는 조합들을 예측 후보로 사용합니다. 여기에는 학습 데이터에서 보지 못한 조합도 포함됩니다.
- Open-world : attribute와 object로 만들 수 있는 모든 조합을 예측 후보로 사용합니다. 따라서 구분해야 할 후보가 더 많아집니다.
비교 대상은 text prompt를 이용하는 zero-shot CLIP과, embedding을 선형적으로 분해하는 LDE(Linearly Decomposable Embeddings)입니다. 특히 LDE와 GDE의 비교를 통해 manifold geometry를 고려하는 것이 중요한지 확인하고자 하였습니다.
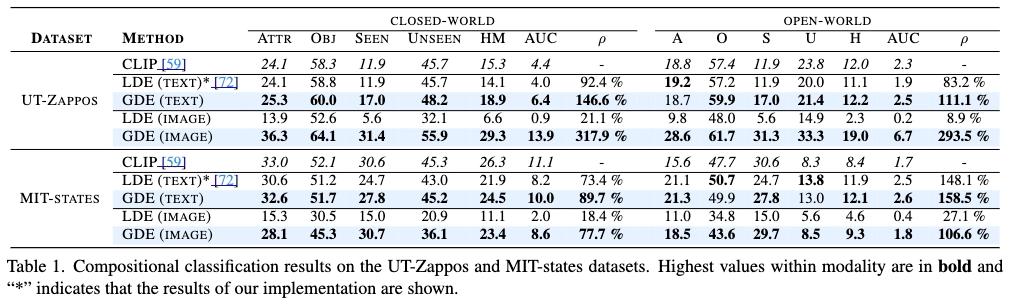
GDE는 두 데이터셋 모두에서 LDE보다 높은 성능을 보였습니다. 또한 UT-Zappos에서는 기존 CLIP보다도 크게 향상된 결과를 보였습니다.
다만 MIT-States의 closed-world 설정에서는 CLIP보다 낮은 성능을 보였습니다. 저자들은 이러한 차이가 annotation의 noise과 각 기본 concept을 추정할 때 사용할 수 있는 image 수의 차이에서 발생한다고 해석하였습니다.
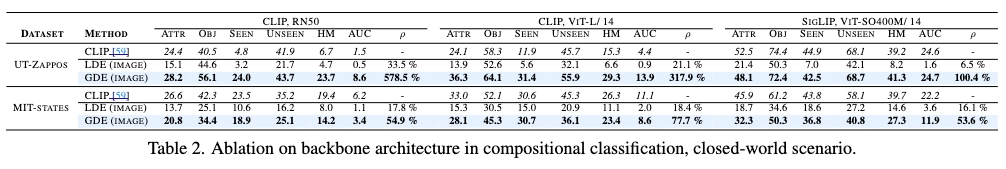
CLIP ResNet50과 SigLIP를 사용한 실험에서도 GDE는 LDE보다 높은 AUC를 보였습니다. 이러한 결과는 visual representation을 분해할 때 공간의 geometry를 고려하는 것이 유용하다는 주장을 뒷받침합니다.
Group Robustness
앞선 실험에서는 attribute와 object를 다시 조합하였다면, 해당 실험에서는 분류에 필요한 concept만 사용했을 때 bias를 줄일 수 있는지 확인하였습니다.
예를 들어, 물새 이미지에 물 배경이 자주 등장한다면 모델은 새의 특징 뿐 아니라 배경에도 의존할 수 있습니다. 이런 경우, 육지에 있는 물새처럼 드문 조합에서 성능이 낮아질 수 있습니다. 저자는 이러한 우연한 상관관계를 spurious correlation이라고 하였습니다.
이를 평가하기 위해 저자들은 다음 데이터셋을 사용하였습니다.
- Waterbirds: 새의 종류를 분류할 때 배경과의 상관관계가 존재합니다.
- CelebA: 머리색을 분류할 때 성별과의 상관관계가 존재합니다.
이때는 attribute direction을 더하지 않고, 예측 대상에 해당하는 object direction만 Exponential map에 넣습니다.
\tilde{u}_o = \operatorname{Exp}_{\mu}(v_o)
이후 test image와 해당 object embedding의 cosine similarity를 비교하여 분류합니다. 즉, 분해 과정에서 구한 object direction을 활용하여, 배경 등 불필요한 attribute에 대한 의존을 줄이고자 하였습니다.
평가에서는 전체 평균 정확도인 AVG와 함께, 가장 성능이 낮은 그룹의 정확도인 WG(Worst-group accuracy)를 확인하였습니다. 특히 WG를 통해, rare combination에서도 모델이 안정적으로 동작하는지 평가할 수 있습니다.
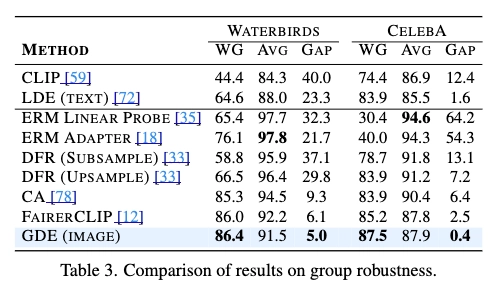
GDE는 논문에서 비교한 방법들 가운데 두 데이터셋 모두 가장 높은 WG를 보였습니다. 또한 AVG 정확도와 worst 그룹 정확도의 차이인 Gap도 가장 작았습니다.
여기서 주목할 점은 pretrained된 encoder를 재학습하지 않고, 레이블이 있는 이미지에서 추정한 concept direction을 활용하여 이러한 결과를 얻었다는 것입니다.
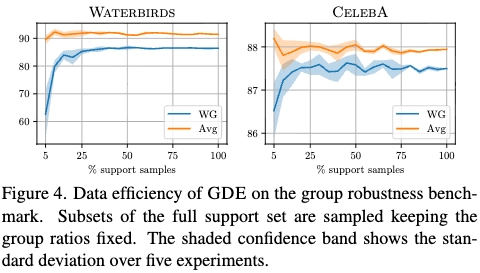
Figure 4에서는 그룹 비율을 유지하며 데이터의 25%만 사용해도 WG가 크게 감소하지 않는 결과를 보였습니다.
Visualize Decomposable Approximations
마지막으로 저자들은 재조합한 embedding이 실제로 어떤 의미를 담고 있는지 image generation을 통해 확인하였습니다.
앞서 구한 attribute-object embedding을 Stable Diffusion v2.1의 unCLIP 방식에 입력하였습니다. unCLIP은 image embedding을 조건으로 이미지를 생성하기 때문에, 재조합한 representation을 시각적으로 확인할 수 있습니다.
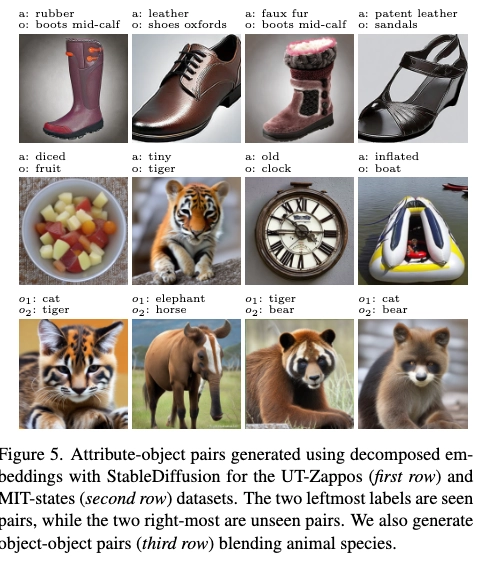
Figure 5에서는 흔하지 않은 attribute-object 조합을 대상으로, 생성된 이미지에 attribute와 object가 함께 반영되는지 살펴보았습니다. 제시된 예시에서는 관측된 조합과 관측되지 않은 조합 모두에서 해당 concept들이 반영되는 모습을 확인할 수 있습니다.
또한 attribute-object뿐 아니라, 서로 다른 두 object direction을 조합하는 실험도 수행하였습니다.
\tilde{u}_{(o_1,o_2)} = \operatorname{Exp}_{\mu}(v_{o_1} + v_{o_2})
서로 다른 동물의 direction을 더했을 때, 생성된 이미지에서 두 동물의 특징이 함께 나타났습니다. 저자들은 이러한 정성적 결과를 통해 분해한 concept vector들이 의미를 유지하며 재조합될 수 있음을 보여주고자 하였습니다.
Conclusion
해당 연구는 VLM의 image representation에도 기본 concept들을 분해하고 재조합할 수 있는 구조가 존재하는가라는 질문에서 출발하였습니다. 저자들은 이를 분석하기 위해, embedding space의 geometry를 고려한 GDE(Geodesically Decomposable Embeddings)를 제안하였습니다.
GDE는 image embedding을 접공간으로 옮겨 기본 concept direction들을 추정하고, 이들을 더한 뒤 Exponential map을 통해 manifold 위의 representation으로 재구성합니다. 이러한 접근은 visual embedding을 선형적으로 분해하는 방법보다 높은 조합 분류 성능을 보였습니다.
이 연구에서 주목할 점은 사전학습된 encoder를 재학습하지 않고도, 기존 representation에 내재된 구조를 활용할 수 있다는 것입니다.
최근 Embedding의 Geometry 관점의 분석 연구들을 보니 자연스레 기하학적 분석에 관심이 가는 것 같습니다. 하지만, Compositionality의 주요 dataset인 Winoground, ARO 등과 같은 natural한 상황에서도 decomposable structure를 보이는지, 또한 잘 working하는 지에 대한 리포팅이 없어 아쉬웠던 것 같습니다. 이게 비단 해당 논문 뿐 아니라, embedding의 기하학적 관점에서의 분석을 수행할 때, 대체적으로 합성 데이터 또는 제약적인 setting에서 보이는 부분이 많은 것 같습니다.
앞으로 해당 주제를 가지고 계속 실험을 할 텐데, 어떤 데이터를 기반으로 주장을 뒷받침할 실험을 설계할 지, 어떻게 실험을 설계할 지 더욱 고민해야할 것 같습니다.
읽어주셔서 감사합니다!