안녕하세요. 강희승입니다. 지난주 Transformer에 이어, Computer Vision 연구에 Transformer를 적용한 ViT에 대해서 리뷰하려고 합니다. ViT는 현재 VLM에서도 많이 채택되어 활용되기 때문에, 다시 한번 복습하고자 해당 논문을 선정하였습니다.
1. Introduction
“Attention is All You Need”에서 Transformer 구조가 처음 등장하고, NLP 분야에서는 해당 구조가 표준으로 자리를 잡았습니다. Vision 분야에서는 여전히 Convolution 구조가 지배적이었지만, NLP에서의 Transformer의 성공에 영감을 받아, Convolution과 Self-Attention을 결합하려는 시도가 있었습니다. 또한, Convolution을 완전히 Self-Attention으로 대체하는 방식의 일부 연구도 있었습니다.
이러한 연구들은 이론적으로는 효율적인 구조지만, Image를 처리하기 위해 설계된 복잡한 Attention Pattern은 그 당시 Hardware Accelerator 상에서 효율적으로 학습하기 어려웠습니다. 따라서, large-scale recognition에서는 ResNet-like 구조들이 여전히 SOTA 자리를 꿰찼습니다.
여기서 저자는 기존 연구들이 Self-Attention이라는 구조 자체에 집중한 접근과 다르게, NLP에서 Transformer가 data scaling과 computation efficiency가 가능하게 된 이유에 집중하였습니다. 기존 연구들의 경우, 이미지를 처리하기 위해 Self-Attention의 구조를 변형하였지만, 저자는 Input을 변형하는 접근을 하였습니다. 즉 image를 약간의 수정을 통해 Transformer의 Self-Attention에 그대로 적용하여 해당 구조의 이점을 취하였습니다.
1.1 Inductive Bias
Transformer는 이런 CNN의 Inductive Bias가 결여되어 있다고 저자는 언급합니다.
여기서 Inductive Bias란, ‘학습데이터에서 보지 못한 데이터에도 generalization이 가능하도록, 어떠한 입/출력의 관계가 어떠한 구조를 가질 것이다’ 는 가정을 모델에 사전 부여하는 것입니다. Logistic regression을 예로 들자면, input과 output이 linear 관계에 있을 것이라는 Inductive Bias를 가집니다. 해당 가정을 기반으로 Decision Boundary가 Linear라는 형태를 가지게 됩니다.
CNN이 가지는 대표적인 Inductive Bias는 다음과 같습니다.
- Locality CNN은 Convolution Kernel을 Sliding Window 기법으로 연산을 수행합니다. FC layer의 경우, 하나의 pixel이 전체 pixel과 연결될 수 있지만, 해당 연산 기법은 pixel 간 연결 범위를 kernel의 크기만큼 영역을 제한합니다. 따라서, 연결 구조 자체가 제한됨으로써 locality bias가 주입됩니다. 이러한 특징을 기반으로 CNN layer를 여러 차례 거치고 Receptive Field가 커지면서, 초기 layer의 저수준의 Local 특징들을 결합하여 점점 큰 구조를 학습하도록 유도될 수 있습니다.
- Translation Equivariance 해당 bias는 입력 이미지가 이동하면 feature map도 같은 방향으로 이동하는 성질입니다. CNN이 Convolution 연산을 수행할 때, weight sharing을 하기 때문에, 어떤 특징이 어떤 위치에 있던, 동일한 특징을 추출합니다. 따라서, 이미지가 이동하면서 특징에 따른 feature map의 활성화 위치 또한 동일하게 이동합니다.
Transformer는 input에 대해 전역적으로 Self Attention을 수행합니다. 즉, 특정 토큰이 모든 토큰을 참고합니다. 또한, Convolution 연산이라는 특정 연산을 수행하는 것이 아니기 때문에, CNN의 Inductive Bias가 결여되어 있다고 생각할 수 있습니다.
따라서, Vision 분야에서 Transformer를 적용하였을 때, 충분한 데이터가 있지 않다면 일반화가 어렵습니다.
2. Method

그럼에도 불구하고, 저자는 Transformer의 이점을 챙기면서도, Vision에서 Image recognition을 일반화하기 위해 Vision Transformer 줄여서 ViT를 제안하였습니다.
2.1 Patch Embedding
NLP에서 Transformer는 1D Sequence를 기반한 Token Embedding을 입력으로 받습니다. 이를 Image에 적용하기 위해, flatten된 2D image의 x \in \mathbb{R^{H\times W \times C}} 에 대해, 2D patch x_p \in \mathbb{R^{N\times (P^2 \cdot C)}} 로 변환합니다.
Patch resolutions (P,P)
N = HW/P^2 로 패치의 개수를 의미
저자의 방법론에서 사용하는 Transformer는 입출력은 D 차원의 고정된 latent representation을 사용합니다. 따라서, 각 patch들을 flatten한 P^2C 차원의 벡터를 trainable linear projection을 통해 D 의 dimension을 가지는 Embedding Space에 투영합니다.
2.2 [CLS] TOKEN
저자는 BERT ( BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding ) 에서 제안한 [CLS] token의 개념을 ViT에 적용하였습니다.
[CLS] token이란 learnable embedding으로, patch sequence의 가장 앞단에 추가되어 학습됩니다. 해당 token은 Transformer Encoder의 Self-Attention을 거치면서 이미지 패치들의 정보를 참조하여, 이미지 전체를 대표하도록 학습되는 token이라고 할 수 있습니다. 이후 해당 token만 추출하여, MLP로 구현된 Classification head를 거쳐 예측을 수행합니다.

구체적으로 (1) 수식에서 z_0은 초기 CLS token으로 이미지 패치들의 정보가 없는 상태로 시작합니다. 이후 (2),(3) 즉 Transformer의 MSA;Multi-head Self-Attention과 MLP 수행하여, CLS token이 모든 이미지 패치들을 참조하도록 하고 해당 token을 비선형 변환을 통해 CLS token의 representation을 정제합니다. 마지막으로 (4)에서 최종 output y를 0번째 token 즉 [CLS] token으로 선택합니다.
2.3 Position Embedding
ViT에서도 동일하게 Position Embedding을 적용하여, 각 패치들에 Position Information을 주입합니다. 다만, 여기서 흥미로운 점은 2D Position Embedding을 사용하는 것이 아닌 1D Position Embedding을 적용하였습니다. 저자가 Ablation을 통해 실험한 결과, 2D-aware 방식이 1D 방식보다 이점을 발견하지 못했다고 합니다.
2.3.1 Ablation
저자는 총 4가지 Position Embedding을 설계하고 실험하여, 왜 2D 방식을 사용하지 않았는지 구체적으로 제시하였습니다.
다음은 저자가 설계한 4가지 Embedding 방식입니다.
- No Position Embedding
- Bag of Patches
- 1D Position Embedding
- Default
- 패치의 flatten order
- 2D Position Embedding
- 이미지 수직 수평을 고려
- Relative Position Embedding
- 절대적 위치보다 상대적 위치를 고려
- 1D relative Attention을 사용
- offset = p_q - p_k 로 특정 패치의 q, 다른 패치의 k embedding의 차를 두 패치간 상대적 거리로 정의하였다.
추가로, Position Embedding을 (1)Transformer의 입력되기 전 한번만 추가, (2) 모든 transformer layer의 시작 부분에서 자신만의 embedding을 더하여 학습, (3) 모든 transformer layer의 시작부분에 공유되는 embedding을 더하여 학습하는 방식을 추가로 설계하였습니다. 위치 정보를 한번만 제공해도 충분한지, 또는 layer 마다 위치 정보를 제공하는 것이 유리한지 확인하기 위해 설계되었습니다.

Table의 결과를 보면 알 수 있듯이, positional embedding을 수행하지 않은 경우와 수행한 경우와의 차이는 크지만, 3가지의 Embedding 방식은 큰 차이가 없는 것을 확인할 수 있습니다. 저자는 ViT의 Transformer Encoder가 Pixel-Level 이 아닌 Patch-Level의 input을 사용하기 때문에, 공간 정보를 Encoding하는 방식의 차이가 상대적으로 덜 중요하다고 해석했습니다. 즉, Positional Encoding은 반드시 필요하나, 방식의 차이보단, 해당 Patch의 Representation이 더욱 중요하다고 해석하였습니다.
2.4 Transformer Encoder
Transformer Encoder는 Patch Embedding 을 Input으로, Multi-head Self-Attention과 MLP(2 layers with a GELU)를 교대로 수행합니다. 각 Block들의 앞에는 Layer Normalization을 수행하고 끝에는 Residual Connection을 적용합니다.
2.5 Fine-Tuning and Higher Resolution
ViT를 활용하는 방법은 다음과 같습니다. Large dataset에 대해 사전학습된 ViT를 기반으로, downstream task로 전이학습을 수행합니다. 이때, 사전학습된 prediction head를 제거하고, zero-init된 Feedforward layer를 추가하여 학습을 합니다.
ViT의 경우, sequence 길이가 학습에 사용된 길이보다 길어도 수행이 가능합니다. 따라서, 더 큰 해상도의 이미지도 동일한 patch size로 처리가 가능합니다. 다만, 기존 학습된 Positional Encoding이 의미가 없어지기 때문에, 기존 사전 학습된 Embedding을 기반으로 2D interpolation을 수행합니다.
저자는 resolution adjustment와 patch extraction이 ViT에서 image 2D 구조에 대한 Inductive Bias가 주입되는 유일한 지점이라고 합니다.
3. Experiments
저자는 그 당시 Vision 분야에서 SOTA인 ResNet을 주요 비교 대상으로 지정하였습니다.
Setup
저자는 다음과 같이 세 가지 모델을 구성하였습니다.

Dataset
- Pretraining
1000개의 classes와 130만 개의 이미지로 구성된 ImageNet-1k dataset, 21,000 classes와 1,400만 개의 이미지로 구성된 ImageNet-21K dataset 과 18,000개의 classes와 3억 300만개의 high resolution 이미지로 구성된 JFT를 사용하였습니다. 이때, 데이터셋에서 Downstream task의 dataset과 중복되는 데이터를 제거하고 사전학습을 진행합니다. - Fine-tuning ImageNet, CIFAR-10/100, Oxford-IIIT Pets, Oxford Flowers-102를 기반으로 fine-tuning 및 Validation을 수행합니다.
3.1 Comparison to SOTA

비교 대상 첫 번째인 BiT는 Large ResNet을 기반으로 supervised transfer learning을 수행한 모델입니다. 두 번째는 Noisy Student로 EfficientNet을 기반으로 준지도학습을 이용하여 학습시킨 모델입니다. ViT 모델들의 scale이 커질 수록, 성능이 오르며, ViT-L/16의 경우 기존 SOTA 성능을 모두 능가하며, Huge 모델의 경우 더 큰 향상을 이루었습니다.
또한, ViT의 경우 사전학습 시 기존의 SOTA 모델에 비해 훨씬 적은 compute resource를 필요로 하였습니다. 가장 큰 Huge의 경우에도, BiT-L에 비해 약 4배 가량 적은 compute를 사용하였습니다.
3.2 Pre-Training Data Requirements
ViT는 large scale 데이터인 JFT-300M dataset으로 사전학습하였을 경우, 좋은 성능을 보입니다. 여기서, 저자는 Resnet보다 적은 Inductive Bias를 가지는 ViT가 dataset의 크기가 얼마나 치명적으로 작용하는지 실험하고자 하였습니다.

- 가장 먼저, ImageNet-1k, ImageNet-21k, JFT-300M 순서로 점차 데이터셋의 scale을 증가시키며 사전 학습을 수행하였습니다. Figure3에서 볼 수 있듯, 작은 데이터셋을 기반으로 학습시켰을 경우, BiT가 ViT를 outperform하지만, 더 큰 데이터셋을 기반으로 사전학습할 시, ViT가 더 높은 성능을 보이는 것을 알 수 있습니다.
- 다음으로, JFT-300M을 9M, 30M, 90M,300M 으로 random subsampling 하여 학습을 수행하였습니다. 해당 실험에서도 동일하게 작은 데이터셋(9M)에서 ViT는 BiT에 비해 낮은 성능을 보이지만, 30M 부터 BiT 작은 모델의 성능을 능가하기 시작해서, 더 큰 데이터셋을 사용할 경우 ViT가 더 높은 성능을 보였습니다.
저자는 Convolution Inductive Bias는 작은 데이터셋에서 더욱 용이하지만, 큰 데이터셋에서는 충분한 데이터를 기반으로 관련 패턴을 학습하는 것이 beneficial 하다고 해석하였습니다.
Conclusion
저자는 Image-specific Inductive Bias를 Transformer에 주입하는 것이 아닌, image를 sequence of patch로 취급하여 standard Transformer를 Vision 분야에 그대로 적용하였습니다. 결과적으로, large dataset을 기반으로 사전 학습을 수행할 때 좋은 성능을 보일 수 있었으며, 기존 SOTA의 성능도 능가하였습니다.
이러한 결과는 CNN 기반의 시각적 Inductive Bias 없이도 Large dataset과 training scale이 보장된다면, Transformer(ViT)가 이미지에 필요한 visual representation을 data로부터 학습할 수 있음을 보였습니다. 또한, standard Transformer을 적용함으로써, 구조적 호환성과 뛰어난 scaling 특성 덕에 이후 이미지와 텍스트의 alignment를 맞추고 결합하는 VLM의 Vision Encoder로 많이 채택되어 활용되는 것 같습니다.
이상으로 ViT 리뷰를 마치겠습니다. 읽어주셔서 감사합니다.
Appendix


안녕하세요. 리뷰 잘 봤습니다. 질문이 몇가지 있는데
1. 먼저 BiT-L과 EfficientNet은 무슨 데이터로 학습된 것인가요? 표2에서 모델들의 성능이 JFT로 학습했는지, ImageNet-21K로 학습했는지 궁금하네요. 그리고 그림3에서 회색 네모가 BiT인데 작은 네모가 있고 큰 네모가 있는 것으로 보입니다. 네모의 크기 차이는 무엇을 의미하나요?
2. 그리고 표2 내용에서 ViT가 TPU 기준으로 사전학습 연산 비용이 기존 SOTA CNN보다 더 적다고 하였습니다. 그러면 추론 시간에 대해서는 리포팅이 안되어있나요? 대용량 데이터를 학습하는 관점에서 학습 비용도 중요하지만, 모델이 실제 서비스되는 관점에서 추론 시간이 더 중요하다고 생각되는데 ViT가 CNN보다 추론 시간과 메모리 비용이 더 적게 들 수 있나요? 그리고 ViT-Huge의 모델 크기가 632M정도 되는데 BiT-L의 모델 크기는 어느정도 하나요? 모델 크기가 비슷한지 또는 한쪽이 일방적으로 큰지 등을 비교할 수 있으면 저자들의 주장에 대해 객관적으로 평가가 가능할 것 같습니다.
3. 그리고 해당 논문은 저희가 지금은 흔하게 사용하는 ViT를 처음 제안하는 논문이다보니, image classification에 대한 평가만 진행되고 있는 것 같습니다. 하지만 backbone 연구 논문들을 살펴보면 보통 image classification뿐만 아니라 object detection, semantic segmentation까지 확장해서 평가를 진행합니다. 즉, coarse-level부터 level perception까지 다 보여줌으로써 모델이 다양한 vision task에서 사용 가능한 backbone임을 증명하려고 하는 것이죠. 그러한 관점에서 비록 논문에는 나와있지 않지만, ViT가 image classification 뿐만 아니라 다른 perception task로 넘어갔을 때 어떠한 결과를 보이는지와 어떠한 단점이 있는지 등을 가볍게라도 보면 좋을 것 같습니다.
예를 들어, 가장 대표적인 ViT의 단점으로는 self-attention 연산 특성상 이미지 해상도에 제곱배에 해당하는 연산이 필요하여 연산량과 VRAM 사용량이 크게 요구됩니다. 다만 image classification에서는 관행상 입력 해상도를 224×224로 사용하기 때문에 이 단점이 크게 부각되지 않아 CNN보다 더 빠르거나 비슷한 추론 속도 및 vram 사용량을 보인다고 이야기하지만, 다른 downstream task에서는 512 이상의 해상도를 사용하기 때문에 여기서부터는 CNN과 비교하여 매우 큰 연산량과 VRAM을 요구하게 됩니다.
이러한 ViT의 단점을 극복하기 위해서 vision side에서 ViT의 구조를 개선하려는 논문들이 그 당시에 많이 등장했습니다. 대표적으로 Swin transformer와 Pyramid Vision Transformer가 있었구요. 그럼 이들 백본이 ViT의 개량 버전임에도 불구하고 왜 지금의 mLLM 등의 연구들은 swin trasnformer같은 개량 백본을 안쓰고 여전히 vision encoder로 plain ViT 구조를 고수하고 있는지도 한번 찾아보면 좋지 않을까 싶네요.
안녕하세요 정민님. 좋은 댓글 및 피드백 감사합니다!!!
각 질문들에 대해 순차적으로 답변 드리겠습니다!
1-1) BiT-L의 경우 JFT를 사용하여 사전학습을 하였습니다. 이때 저자는 JFT를 기반으로 학습한 ViT-H/14, ViT-L/16 모두 outperforming한다고 언급하였습니다.
추가로 EfficientNet의 경우에는 JFT와 ImageNet-21k 모두 사용하였으나, label을 제거한 semi-supervised learning을 통해 학습하였다고 합니다.
* (Noisy Student 모델이 무엇인지 정확히는 몰라 찾아보았습니다. teacher를 EfficientNet에 Noise를 추가하여 JFT, ImageNet-21k를 기반으로 supervised learning을 통해 학습합니다. 이후 teacher를 통해 생성한 pseudo labeled image와 labeled image를 기반으로 Noise가 추가된 student model을 학습한다고 합니다.
이때, 논문에서 언급한 label 제거가 오롯이 pseudo labeled image만 사용한 것인지는 불분명합니다.)
1-2) Figure 3에 대해 논문에서 회색 네모에 대한 차이를 언급한 것이 있는지 확인해보았는데, 특별한 언급은 없었습니다. 다만, 해당 figure와 설명을 통해 유추를 해보면, BiT 모델의 크기 차이를 의미하는 것 같습니다. 설명에서 shaded area라고 언급했는데, 이는 BiT가 모델의 크기에 따라 커버가 가능한 성능 범위 내에서 ViT가 어느 정도까지 성능을 보일 수 있는 가를 보인게 아닐까라는 생각이 듭니다!
* (JFT로 학습된 BiT(ResNet50)과 ViT-B/32, ViT-L/32의 성능 차이를 비교하면 Figure3와 유사한 것을 알 수 있습니다. 하지만 BiT(ResNet152x2)의 경우 Figure3와 다르게, ViT-L/16보다 성능이 낮은 것을 알 수 있습니다. 즉 큰 네모는 논문에서 사용한 더 큰 모델 BiT(ResNet152x4), 작은 네모는 BiT(ResNet50)으로 추정됩니다. )
2) inference time에 대해서도 별도로 리포팅하지는 않았습니다. 다만, BiT-L의 경우 약 928M의 크기를 가지기 때문에, ViT-Huge에 비해 50% 더 큰 모델입니다. 따라서, 논문에서 리포팅한 pre-training compute가 완전히 동일한 조건은 아닙니다. 그럼에도 불구하고 저자가 해당 내용을 리포팅한 이유가, 보통 Model의 Scale이 클수록 성능이 좋다는 것이 직관적이나, ViT-H 모델의 경우 BiT-L 보다 작지만(Computing ↓) 좋은 성능 보인다는 점을 강조하기 위해서가 아니었을까라는 생각도 듭니다! ( 적절한 해석 접근인지는 아직 헷갈립니다. )
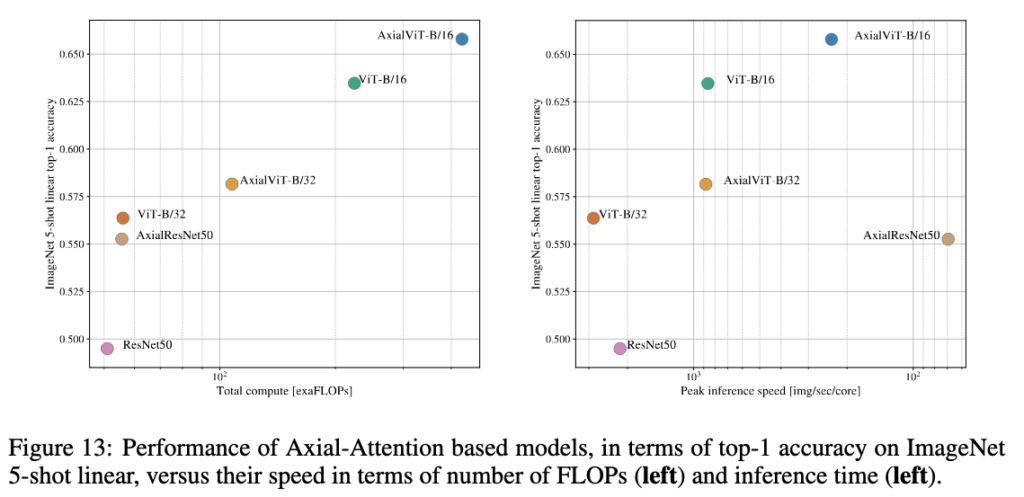
추가로, Appendix에서 Large input에 대한 빠른 연산을 수행하도록 설계된 Axial Transformer를 적용하여, Pre-training Compute와 inference speed를 리포팅 하였습니다. 이때, 모델이 Table2에 있는 모델이 아닌 ViT-B/32,16 과 ResNet50의 비교가 있습니다. ViT-B/32,16 의 경우 86M의 크기를 가지고, ResNet50의 경우 25M을 가집니다. 이 또한, 동일한 크기 조건은 아닙니다. 오히려 이 경우에는 ResNet50이 더 작은 크기를 가지고 있는 경우입니다. 따라서, ResNet50이 FLOPs 상 가장 가볍습니다. 하지만, inference speed를 주목했을 때, ViT-B/16의 경우 더 빠른 속도를 보입니다. 즉, 모델의 크기는 더 크지만, inference speed는 오히려 더 빠르다라는 해석을 할 수 있을 것 같습니다. 해당 figure가 간접적으로 ViT의 inference speed까지 리포팅한 것으로 생각됩니다.
* (ViT-B/32에 대해서는 patch의 수가 32로 ViT-B/16에 비해 두배이기 때문에, ResNet50에 비해서도 낮은 inference speed를 보인 것 같습니다.)
3-1) 좋은 말씀이신 것 같습니다. 말씀대로, 해당 논문이 작성되고 많은 시간이 흘렀기 때문에, 그에 대한, 문제점도 많이 연구 되었을 것입니다. 앞으로 이런 부분들도 생각해보면서 논문을 읽어보겠습니다! 감사합니다.
3-2) 현재 VLM, MLLM에서 사용되는 Visual Backbone은 대부분 CLIP-ViT로 구성되어있습니다. 이때, pre-trained된 weight를 사용하며, 해당 구조는 swin transformer와 같은 개량 버전을 사용한 것이 아니기 때문에, plain ViT 구조를 사용한다고 합니다. 그렇다면 근본적으로 왜 Swin transformer를 CLIP에서 사용하지 않았는지 조사해보았습니다. Swin Transformer에 대해 깊은 이해가 있는 것은 아니나, 연산량을 줄이기 위해 Local Window에 대해 attention을 수행하는 특수한 구조를 띄는 것으로 이해하고 있습니다. 그렇기 때문에, 기존 transformer 보다는 확장성 방면에서 약합니다. 또한, CLIP은 contrastive learning을 기반으로 image,text의 global alignment를 학습하기 때문에, local한 attention을 수행하는 swin transformer를 사용하지 않은 것 같습니다.
다만, CLIP의 등장 이후, 지속적으로 contrastive learning의 global alignment 학습 때문에, fine-grained한 정보들을 학습하지 못한다는 단점들을 개선하려는 연구들이 자주 등장했습니다. 그런 관점에서, Swin transformer가 아예 활용되지 않지는 않을까 막연한 생각도 드는 것 같습니다.
바쁘신 와중 피드백 해주셔서 감사합니다.!!
희승님, 좋은 리뷰 감사합니다! 제가 아직 기초교육 중이라 다소 기초적인 질문일 수 있는 점 양해 부탁드립니다!
제가 이해한 바로는 우선 ViT는 이미지를 픽셀 하나하나가 아니라 여러개의 패치로 나눈 뒤 각 패치를 transformer로 치면 단어 토큰처럼 입력하고 self attention을 통해 패치 간의 관계를 학습하는 모델이라고 이해했습니다! 또한 CNN은 커널을 통해 주변 영역을 훑기 때문에 지역성이라는 inductive bias를 가지고 있지만 ViT는 이런 지역성?이 부족해서(self attention처럼 패치 주변이 아니라 모든 패치를 본다고 이해했습니다.) large dataset을 통해 사전학습이 필요하다고 이해했습니다.
근데 글 중 “downstream task로 전이학습을 수행합니다. 이때, 사전학습된 prediction head를 제거하고, zero-init된 Feedforward layer를 추가하여 학습을 합니다” 이 부분이 잘 이해되지 않았습니다… 제가 쉽게 이해한 바로는 large dataset으로 사전학습된 ViT가 이미 이미지 특징을 학습한 상태이고 새로운 분류 작업(원래는 100개 class 분류였다면 5개 정도의 분류 작업으로 바뀌는 등)을 수행할 때는 기존 prediction head를 제거한 뒤 새로운 작업에 맞는 prediction layer를 추가하여 다시 학습하는 것이라고 이해를 했는데 맞나요? 그리고 제가 이해한 게 맞다면 새 레이어를 zero-init하는 이유가 뭔지 궁금합니다. URP 때 가중치 initialization을 공부하면서 일반적으로 자비에, 허 초기화 등의 방법을 사용하는 것으로 배웠는데 ViT에서는 새 prediction layer를 자비에와 같은 방식이 아니라 0으로 초기화하는 특별한 이유가 있는지 궁금합니다!
네, 시우님 좋은 질문 감사합니다.
ViT 학습 당시에 가볍게 지나쳤던 부분인 것 같습니다.
해당 논문에서 언급하는 Zero-initialize는 생각하시는 대로 가중치를 0으로 초기화하는 것입니다. 이때, 중요한 것은 Classification head, 가장 마지막 linear layer에 적용한다는 점입니다. 아시는대로, 중간 layer에서 0으로 초기화 하게 된다면, forward pass시 정보가 죽어버리는 현상이 발생합니다.
이때, 마지막 layer를 he/xavier 초기화하지 않는 이유는 첫 forward pass 시 완전히 random prediction을 하게 됩니다. 이는 Loss가 크고 방향도 무작위 입니다. 해당 gradient가 backbone까지 그대로 back propagation 하면서, 초기 학습 단계에서 잘 형성된 pre-trained feature representation에 바로 영향을 주게 됩니다.
하지만, 0으로 초기화 시 모든 class에 대해 균등 예측을 하게 됩니다. 이때, 출력 값은 0 이기 때문에 Backbone으로 향하는 gradient를 첫 step에서 0으로 만들어 줍니다. 따라서, 초기 random gradient로 인한 pre-trained representation collapse(catastrophic collapse)를 방지하며, 안정적인 fine-tuning을 가능하게 할 수 있습니다.
감사합니다.