Abstract
3DGS(3D Gaussian Splatting)는 가우시안에서 객체 수준의 조작을 가능하게 하지만, 기존 연구들은 대부분 렌더링된 뷰에서 학습 및 평가가 이루어졌다. 이러한 방식은 렌더링에 기여도가 높은 가우시안에 높은 기여도를 부여하여, 가려져 있거나 렌더링에 기여도가 낮은 가우시안에는 충분한 학습 신호를 제공하지 못한다는 한계가 있다. 따라서, 렌더링된 2D 마스크는 정확하더라도 실제 3D 공간에서는 객체를 구성하는 일부 가우시안이 누락될 수 있다. 해당 논문은 이러한 문제를 해결하기 위해 픽셀별 가우시안을 depth에 따라 그룹화하고, 선택된 depth 클러스터에 속하는 모든 가우시안에 직접 학습 신호를 제공하는 VODA방식을 제안하다. 또한, 3D segmentation에 대한 완전한 평가를 위해 합성 객체제거 벤치마크인 Removal-3D를 제안하고, 객체가 제거됨에 따라 달라지는 depth를 예측하는 Removal Depth Error(RDE) 평가지표를 제안한다. 이를 통해 제안한 방법론을 검증하였으며, 추가 분석을 통해 렌더링에 기여도가 낮았던 가우시안까지도 효과적으로 복원할 수 있음을 확인하였다.
Introduction
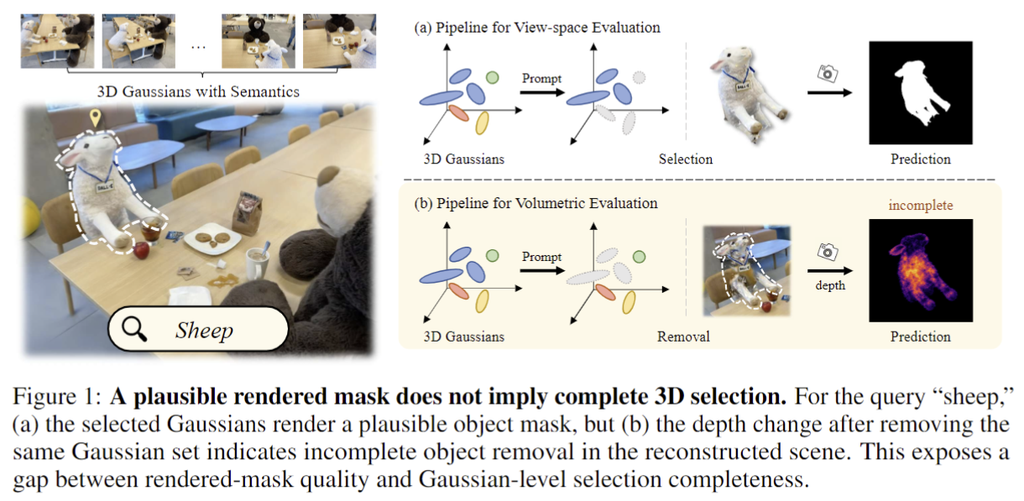
Object-level editing을 위해서는 객체를 구성하는 3D 영역을 완전하게 선택할 수 있어야 한다. 그러나 기존의 3DGS Segmentation 연구들은 렌더링 기반의 학습 및 평가로 인해, 렌더링에 기여도가 높은 가우시안에 학습이 집중되어 기여도가 낮은 가우시안에는 충분한 학습 신호가 전될되지 않는 한계가 있다. 따라서 해당 논문에서는 렌더링에 필요한 가우시안 뿐만 아니라, 객체와 연관된 모든 가우시안을 선택하기 위한 volumetric 3D Gaussian Segmentation을 연구한다. 저자들은 렌더링에 기여도 높은 가우시안 뿐만 아니라 낮은 기여도의 가우시안도 학습에 활용 가능하도록 하는 plug-and-play 목적함수인 VODA를 제안한다. VODA는 특징에 대해 학습 방식만을 수정하며 다른 부분은 변경하지 않고 활용 가능하다.
저자들은 RGB최적화 이후 동일 객체에 속하는 가우시안들이 유사한 depth에 모이는 경향이 있는 반면, 서로 다른 객체들 사이의 depth는 상대적으로 차이가 크다는 것을 관찰하였다. 이를 기반으로 픽셀별 렌더링 기여 가우시안을 depth 기반으로 그룹화한 뒤, 각 픽셀을 가장 잘 설명하는 클러스터를 선택한다. 이후 렌더링된 특징으로부터 생성한 학습 신호를 선택된 클러스터의 모든 가우시안에 적용하여 렌더링 기여도가 낮은 가우시안까지 학습할 수 있도록 하였다. 또한, 추가적인 픽셀 수준의 push loss를 통해 인접 객체들 사이의 경계를 더욱 명확히 구분하도록 하였다.
또한, 3D 공간에서 segmentation의 완전성 평가를 위해, 물체를 제거하기 전후에 대한 depth map 쌍으로 구성된 합성 데이터 벤치마크인 Removal-3D를 제안하였다. 이와 함께 예측된 가우시안을 제거하였을 대 발생하는 depth 변화와 실제 객체를 제거하였을 때 depth 변화를 비교하는 Removal Depth Error(RDE) 평가지표를 제안하였다. 저자들은 4가지 렌더링 기반의 베이스라인을 대상으로 수행한 실험을 통해 VODA가 Removal-3D에서 3D segmentation 성능을 일관되게 향상시키면서도 기존 표준 벤치마크의 성능 유지 및 개선이 가능함을 보였다.
해당 논문의 contribution을 정리하면
- Volumetric 3D Gaussian Segmentation 문제를 정식화하여 렌더링 마스크 정확도와 3D 공간 사이의 완정성을 구분하고 렌더링 기반 방식의 한계를 확인
- 선택된 depth 클러스터에 속한 모든 가우시안에 직접 학습 신호를 제공하도록 하는 plug-and-play 방식의 VODA 제안
- 객체 제거에 따른 depth 변화를 활용하여 3D 공간에서의 객체의 완전성을 평가하는 Removal-3D 벤치마크 및 Removal Depth Error(RDE) 평가지표 제안
Preliminary
3DGS?
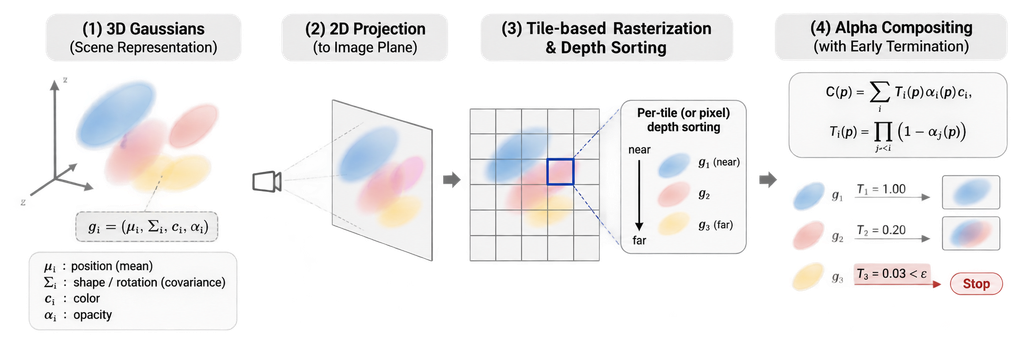
3차원 공간을 수많은 가우시안으로 표현한 뒤, 이를 2D 이미지에 투영하여 새로운 시점의 영상을 생성하는 기술. 카메라로부터 가까운 순으로 가우시안을 합성하며, 앞에 있는 가우시안들이 불투명할수록 뒤에 있는 가우시안의 기여도가 줄어든다. 따라서 앞의 투과율(trasmittance)을 기반으로 임계값 이하부터는 가우시안의 처리를 생략이 가능하다.
Method
1. Contribution-weighted Supervision in Feature Rendering
우선 저자들은 기존의 기여도 기반의 방식이 왜 불충분한 지에 대해 분석한다.
먼저 3DGS는 장면을 구성하는 가우시안 집합을 \{g_i\}^N_{i=1}이라 하고, 각 가우시안 g_i에 대한 learnable instance feature를 \mathbf{f}_i라 할 때, 픽셀 p에 겹치는 가우시안들은 카메라 좌표계에서의 깊이를 기준으로 정렬되며, alpha 블랜딩을 통해 렌더링된 특징맵을 생성한다.
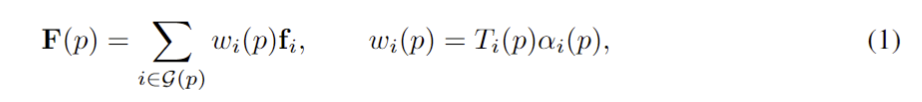
- \mathcal{G}(p): 픽셀 p에 기여하는 가우시안을 depth 순서대로 나타낸 집합
- \alpha_i(p): 가우시안 g_i의 픽셀별 알파값
- T_i(p): 가우시안 g_i가 도달하기까지 누적된 투과율(Transmittance)
기존의 방법론에서 렌더링된 특징맵을 통해 계산된 loss를 \mathcal{L}_{rend}라 정의하며, 각 가우시안특징에 대한 gradient는 아래의 식(2)로 계산된다.
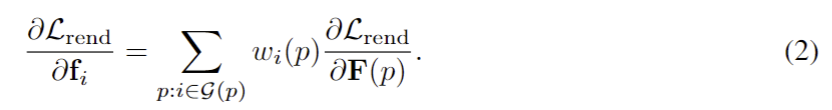
각 가우시안에 전달되는 gradient는 렌더링 기여도에 의하 가중되므로, 기여도가 높은 가우시안을 통해 정확한 2D mask를 생성하도록 학습될 수 있지만, 동일 객체에 속하지만 렌더링에 기여도가 낮은 가우시안은 작은 가중치로 인해 상대적으로 약한 gradient를 전달받게 된다. 즉, 가려져 있거나 렌더링 기여도가 낮은 가우시안은 충분한 학습 신호를 전달받지 못해, 해당 가우시안의 특징이 제대로 학습되지 않을 수 있다.
2. Depth-Aware Rasterizer
저자들은 이러한 문제를 해결하기 위해 기여도나 Top-k개를 선택하는 게 아닌 다른 방식으로 객체에 연관된 가우시안을 식별하고자 하였다.
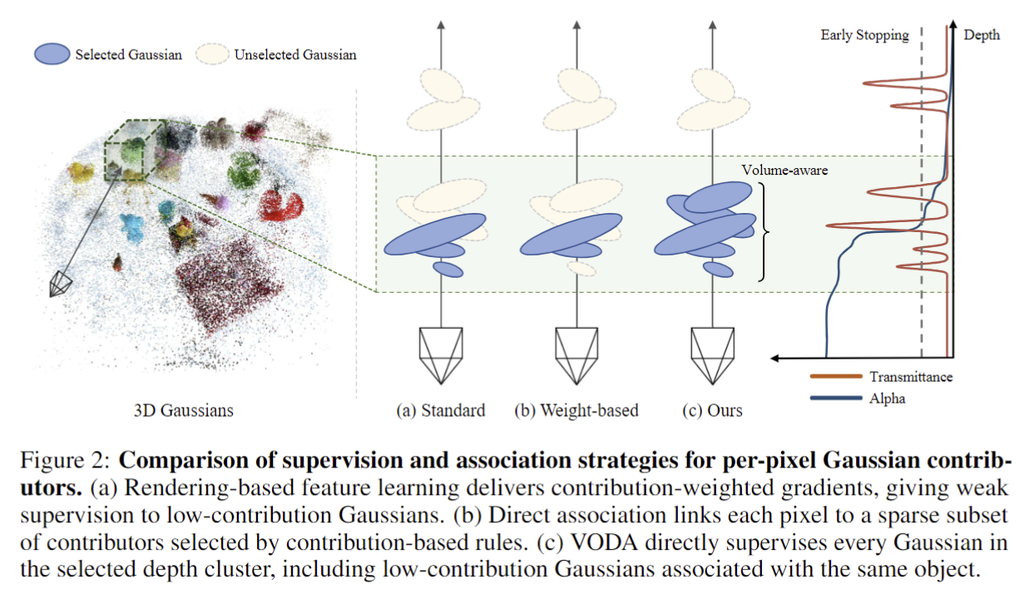
저자들은 3DGS의 재구성 과정에 cloning과 splitting을 통해 기존 가우시안 주변에 새로운 가우시안들이 생성된다는 특징으로부터 depth의 인접성이 물체 식별에 활용이 가능하다고 보았다. 즉, 동일 객체의 local 영역을 표현한 가우시안들이 하나의 클러스터를 형성할 수 있다고 보았다.
Depth Clustering
저자들은 depth 차이로부터 가우시안을 그룹화하기 위해 Depth-aware Rasterizer를 제안하였다. 해당 Rasterizer는 픽셀별 기여와 카메라 공간의 depth, alpha값을 수집하며, 기존과 다르게 trasmittance기반의 early termination을 비활성화하여 기여가 낮은 가우시안도 반영한다.
픽셀 p에서 depth 순으로 정렬된 j번째 가우시안의 depth를 d_j(p)라 할때, 연속된 두 가우시안 사이의 depth 차이가 임계값 \tau(p)를 초과하면 서로 다른 클러스터로 분리하며, 이렇게 생성된 depth cluster를 \mathcal{C}_k(p)라 정의한다.
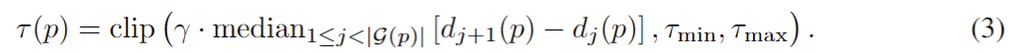
- median: 픽셀값 차이의 분포를 반영하여 임계값 조정
- \gamma: 클러스터 분리의 민감도 조절
- \tau_{min}, \tau_{max}: 임계값이 너무 크거나 작지 않도록 하는 파라미터
Target cluster selection
여러 클러스터 중 대상이 되는 클러스터를 식별하기 위해 VODA는 기여가 가장 큰 클러스터 \mathcal{C}^*(p)를 선택한다. 해당 과정은 단순히 거리를 기준으로 선택하기보다는 기여도 총합을 기준으로 이루어진다.
3. Direct Gaussian-Level Supervision
본 논문에서는 선택된 depth 클러스터에 속하는 가우시안 특징을 직접 학습 신호에 활용한다. 그러나 각 가우시안에 대한 정답 instance feature가 없으므로, 전체 렌더링된 feature \mathbf{F}(p)로부터 가우시안 수준의 pseud target을 생성한다. 해당 과정은 전체 렌더링 feature를 이용하며, 기존의 렌더링 기반의 학습을 통해 기여도가 높은 가우시안들의 특징이 주로 반영되어있다. 이를 동일 클러스터의 다른 가우시안들의 학습 신호로 사용한다.
Gaussian-level target aggregation
하나의 가우시안은 여러 픽셀에서 사용될 수 있으며, 가우시안 g_i가 선택된 클러스터에 포함되는 픽셀 집합을 \mathcal{P}_i = \{p | g_i \in \mathcal{C}^*(p)\}로 정의한다. 이는 해당 가우시안이 선택된 클러스터에 포함된 픽셀만을 의미하며, VODA는 렌더링된 feature를 모아 학습 대상 \hat{\mathbf{F}}_i를 생성한다.
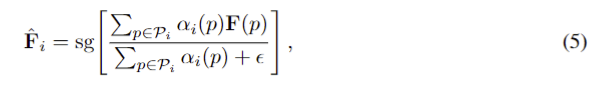
- \epsilon: 안정성을 위한 파라미터
Direct feature loss
선택된 가우시안 특징과 학습 대상 \hat{\mathbf{F}}_i의 정렬을 위해 L2 loss를 적용하며, 이는 가우시안 특징에 직접 적용되어 낮은 기여도의 가우시안에도 gradient가 전달되도록 한다.
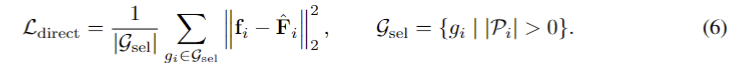
Pixel-level feature push
추가로, depth 클러스터에는 인접한 여러 객체의 가우시안들이 포함될 수 있으므로, 객체 경계에서 특징이 혼합되는 현상을 줄이기 위해 픽셀 수준의 push loss를 도입한다.
각 학습 시점에서 랜덤하게 배경이 아닌 마스크 영역의 픽셀 집합 \mathcal{Q}를 구성한 뒤, 두 픽셀 사이의 렌더링 특징 간 cosine 유사도가 마진 m 를 초과하면 페널티를 부여하였다.
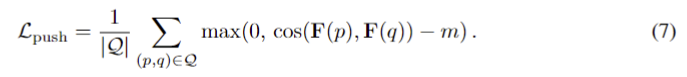
4. Training Objective
해당 방법론은 기존의 가우시안 목적 함수를 유지하면서, VODA의 Direct feature loss와 pixel-level push 를 추가한다.
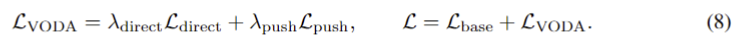
- \lambda_{direct}, \lambda_{push}: 두 함수에 대한 가중치를 조절하는 하이퍼파라미터
베이스라인에 따라 VODA는 재구성된 장면의 특징 학습에 적용하거나, 기존 학습이 완료된 이후 특징만을 미세조정하는 단계에 적용이 가능하다. 또한 VODA는 추론 단계에 추가적인 파라미터나 연산을 요구하지 않으며, 학습 목적함수 외에는 기존의 장면 기하 구조, 불투명도, 특징 표현 및 추론 과정은 변경하지 않는다.
Experiments
저자들은 기존 벤치마크인 LERF와 ScanNet에서 평가를 진행한 뒤, 물체에 대하여 가우시안이 완전하게 할당되었는지를 평가하기 위해 제안한 Removal-3D 벤치마크에서 평가를 진행한다.
Comparison on Standard Benchmarks
먼저, 저자들은 open-vocabulary 3D object selection 벤치마크인 LERF와, semantic segmentation 벤치마크 ScanNet에 대하여 평가를 진행하였다.
LERF
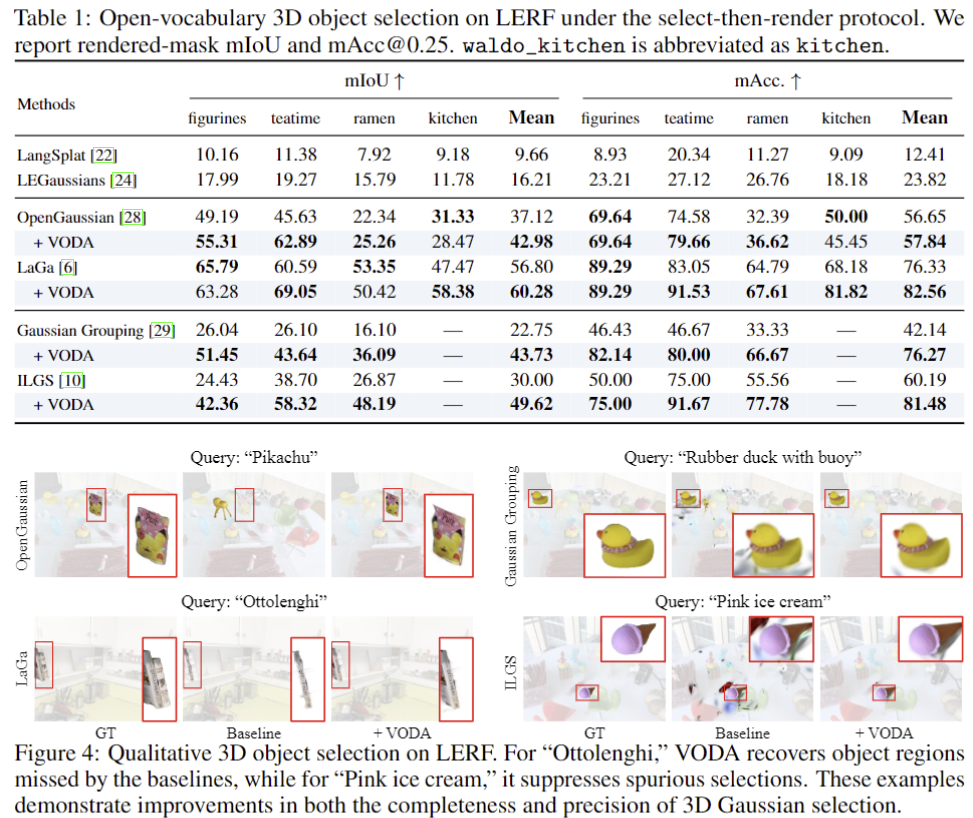
LERF에서는 텍스트 쿼리에 해당하는 가우시안 집합을 선택한 뒤, 해당 가우시안만 여러 시점에서 렌더링하여 GT 마스크와 비교하는 방식으로 Open-Vocabulary 3D Object Selection을 평가하였다. 실험 결과, VODA는 네 가지 베이스라인 모두에서 평균 mIoU와 mAcc@0.25를 향상시켰으며, 특히 Gaussian Grouping과 ILGS 방법론에서 큰 성능 향상을 보였다. 또한 Figure 4의 정성적 평가를 통해 기존 방법에서 누락되었던 객체 영역을 복원하고 잘못 선택된 영역을 감소시키는 것을 확인하였다.
ScanNet
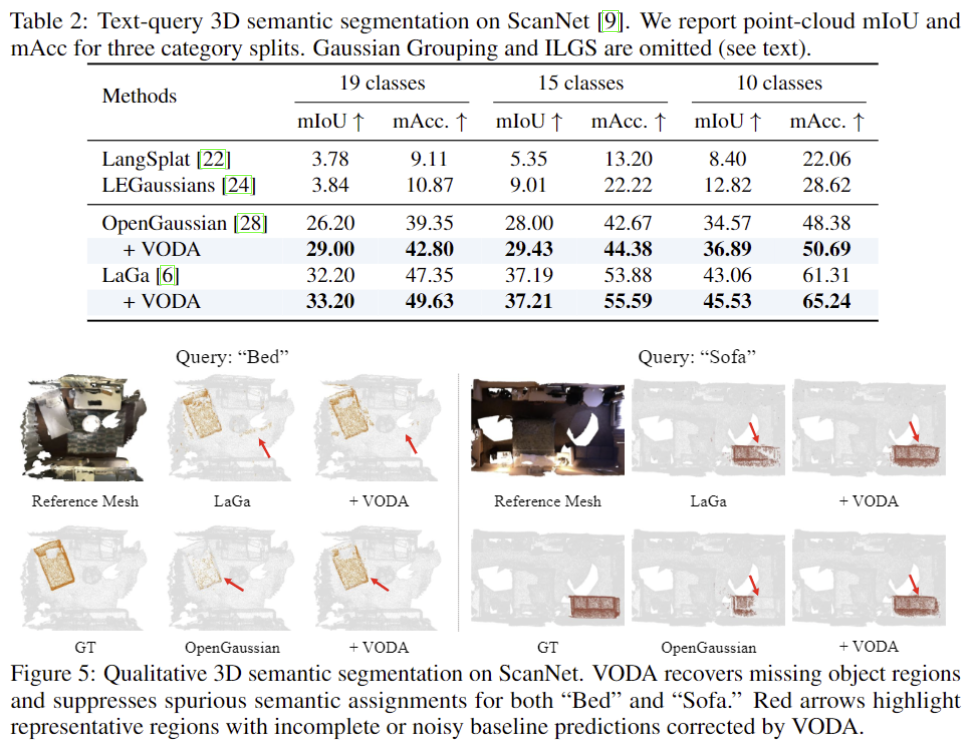
ScanNet에서는 19개, 15개, 10개 카테고리를 텍스트 쿼리로 사용하여 가우시안별 semantic label을 할당하고, 이를 포인트 클라우드로 전달하여 평가하였다. 실험 결과, 모든 카테고리 설정에서 OpenGaussian과 LaGa의 성능이 일관되게 향상되었으며, 객체 경계에서 발생하는 잘못된 레이블 확산도 감소하였다. 그러나 기존 벤치마크는 렌더링된 마스크나 가시적인 표면을 중심으로 평가하기 때문에, 가려진 가우시안까지 완전하게 선택되었는지를 확인하는 데에는 한계가 있다. 따라서 저자들은 새로운 벤치마크 Removal-3D를 통해 3D 공간에서의 객체 선택의 완전성을 평가하고자 하였다.
Comparison on Volumetric Benchmark
Removal-3D
기존 벤치마크는 렌더링된 마스크나 표면의 라벨에 대한 평가만이 이루어지므로 특정 객체에 대하여 완전한 형태로 가우시안이 할당되었는지에 대한 평가는 고려되지 않았다. 따라서 저자들은 blender에서 blender kit 에셋으로 제작한 3가지 합성 실내 장면(Table/Kitchen/Room)을 활용하여 벤치마크를 제안하였다. 각 대상 물체가 제거된 뒤 detph map을 추정하여, 해당 물체에 대한 가우시안이 완전하게 선택 되었는지를 평가하는 것이다.
Removal Depth Error
추가로, 객체 제거 시 발생하는 depth 변화를 비교하기 위해 평가지표로 Removal Depth Error(RDE)를 제안한다.
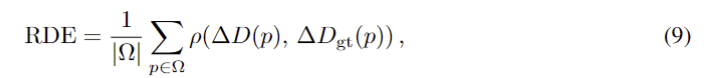
- \Omega: GT 마스크에 해당하는 영역
- \Delta D(p): 예측된 가우시안 제거 시 발생하는 depth 변화
- \Delta D_{gt}(p): 실제 객체 제거 시 발생하는 depth 변화
- \rho: 예측값을 실제 depth 변화 크기에 따라 clipping 한 뒤의 절대 오차를 계산하는 함수
장면별 mRDE는 여러 시점과 대상 객체에 대한 RDE 평균을 계산하여 구해지며, 최종 성능은 3가지 장면에 대하여 평균으로 리포팅한다. 또한, RDE는 정답 마스크 내부에서만 계산이 이루어지므로, 외부에서 잘못된 가우시안을 함께 평가하기 위해 렌더링된 마스크의 mIoU도 함께 리포팅한다.
Volumetric Evaluation on Removal-3D
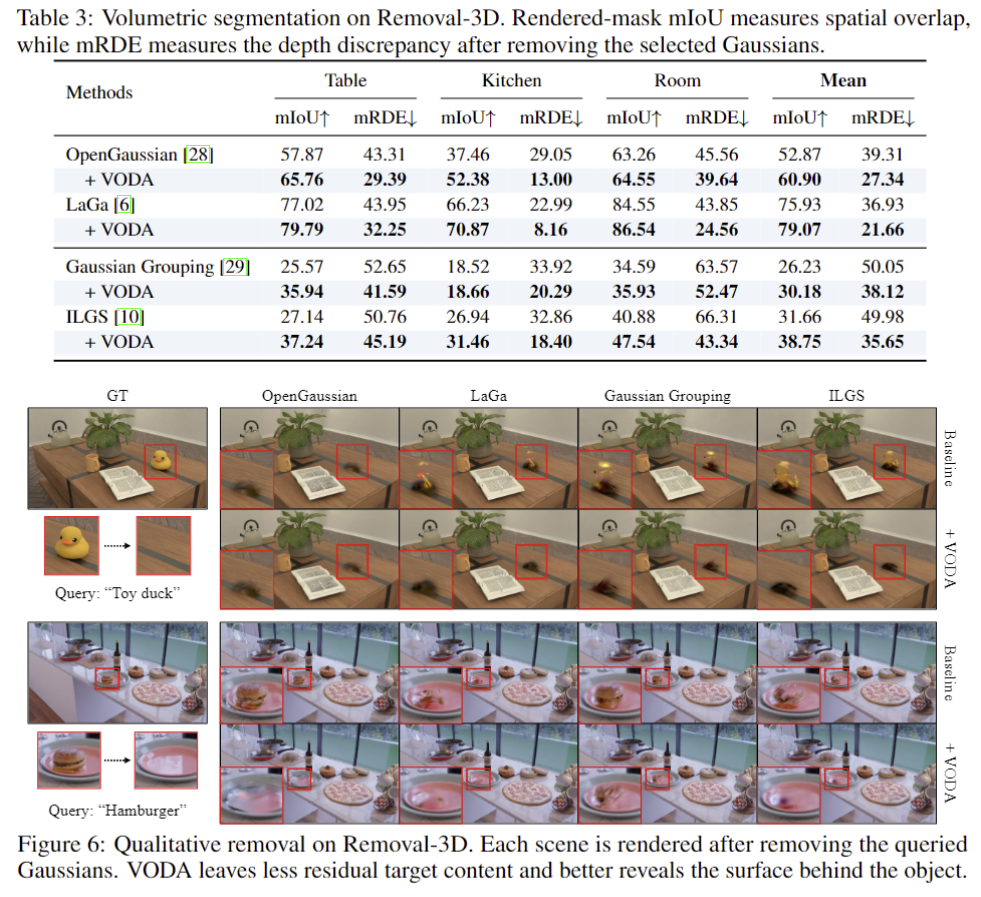
실험 결과는 Table 3에서 확인 가능하며, VODA를 추가하였을 때, 모든 방법론의 모든 지표에서 성능 개선이 이루어짐을 확인하였다. Figure 6에서는 선택된 가우시안을 제거한 이후의 장면을 렌더링하여 객체가 제거되었을 때의 결과를 보였으며, 베이스라인에 비해 객체가 완전하게 제거되는 결과를 보여주고있다.
Ablation Study
다음으로 저자들은 논문에서 제안한 pixel-level push loss와 target aggregation에 대한 ablation study를 진행하였다.
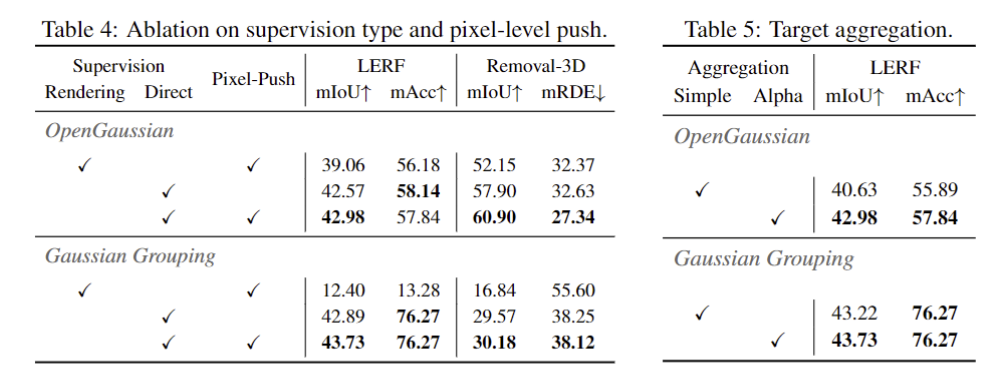
먼저, Table 4는 동일한 depth 클러스터와 target feature를 사용하되, 렌더링을 통해 감독 신호를 전달하는 방식과 가우시안 특징에 직접 전달하는 방식을 비교하였다. 실험 결과, Direct Supervision이 두 베이스라인 모두에서 더 높은 성능을 보였으며, 특히 Gaussian Grouping에서는 LERF mIoU가 12.40에서 43.73으로 크게 향상되었다. 이는 적절한 depth 클러스터를 선택하는 것뿐만 아니라, 렌더링 기여도에 따른 그래디언트 가중치를 우회하여 직접 감독 신호를 제공하는 것이 중요함을 보여준다. 또한 Pixel-Level Push Loss는 LERF 성능에는 큰 영향을 미치지 않았지만, Removal-3D에서 일관된 성능 향상을 보여 인접 객체 사이의 특징 혼합을 줄이는 데 효과적임을 확인하였다.
Table 5는 pseudo-target 생성 과정에서 단순 평균보다 Alpha 가중 평균을 비교한 결과이다. 소폭이지만 가중치를 부여하였을 때 일관된 성능 향상이 나타났음을 확인하였다.
이러한 결과를 통해 Direct Supervision이 VODA의 핵심적인 성능 향상 요소이며, Pixel-Level Push Loss와 Alpha 가중치는 각각 객체 간 특징 구분과 pseudo-target의 신뢰성을 보완한다는 것을 보였다.
Analysis
저자들은 VODA가 기존 렌더링 기반 학습에서 충분한 감독 신호를 받지 못했던 가우시안을 실제로 복원하는지 분석하였다.
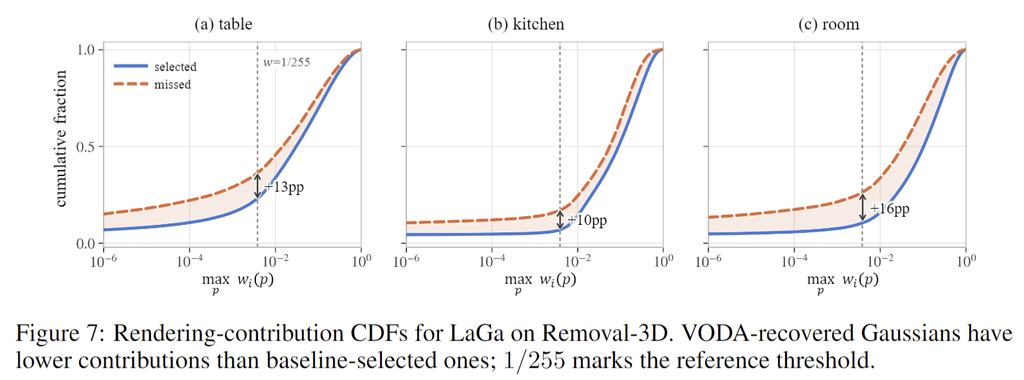
이를 위해 LaGa를 기준으로 기존 베이스라인에서 선택된 가우시안과 VODA를 적용한 후 추가적으로 복원된 가우시안의 최대 렌더링 기여도를 비교하였다. 파란 실선이 기존에도 선택되었던 가우시안이며, 주황 점선이 기존 베이스라인에서 놓쳤다 VODA를 통해 추가로 선택된 가우시안을 의미한다(GT는 아님). 실험 결과, VODA를 추가하였을 때 놓쳤던 가우시안의 많은 비율이 추가로 복원되었음을 확인하였다.