안녕하세요. 이번에 리뷰로 가져온 논문은 CoRL 2026에 올라온 SidewalkBench: Benchmarking Visual Navigation on Urban Sidewalks라는 논문입니다. 불과 올해 상반기까지만 해도 outdoor상에서 모바일 로봇 내비게이션을 시뮬레이션 위에서 Closed-loop 평가를 할 수 있도록 공개한 벤치마크가 없었는데 상반기에 이러한 점을 지적하고 우리는 이런 내비게이션 모델을들 표준화된 평가 체계를 구축해서 공개하겠다! 라고 제시한 논문입니다. 일단 기존에 방법론들이 이런 평가 벤치마크를 제시하지 않은 것은 아닌데, 뭔가 메인 컨트리뷰션으로 평가 벤치마크를 제시하지 않거나, 혹은 메인으로 제시했다고 해도 실제로 코드 공개를 안하는 경우가 대부분이라 사실상 논문은 있지만 평가는 할 수 없는 그런 상황이었습니다. 근데 해당 논문은 물론 나온지는 3개월 정도 되었지만 최근 2주전에 코드까지 공개하면서 실제로 다양한 모델들을 저자들이 제안한 이런 평가 체제 위에서 비교적 단순하지 않고 다양한 시나리오 또한 고려해서 나름 모델 성능을 체계적으로 평가할 수 있도록 진정한 내비게이션 벤치마크를 제안한 논문인 것 같아서 리뷰로 들고오게 되었습니다. 그리고 모바일 로봇 내비게이션의 기존 벤치마크의 한계점들을 명확히 하고 기존 벤치마크보다 훨씬 퀄리티도 좋고 동적인 보행자까지 도입하면서 기존 벤치마크들과의 차이점을 명확히 보여줬기 때문에 CoRL 2026 spotlight까지도 받을 수 있지 않았을까 싶습니다. 읽으면서도 기존 벤치마크들에서 제가 느꼈던 문제점들을 해당 논문에서 똑같이 언급해주고 있어서 공감하면서 술술 읽을 수 있었던 논문이었던 것 같네요.
그리고 해당 연구실이 이런 벤치마크를 올해 한번만 툭 던진게 아니라 2023년 부터 계속 관련 벤치마크 연구(urban-sim, meta urban, urban-verse)를 해온 연구실입니다. 그래서 과거에 여러 시행착오를 거치고 레이어를 쌓아가면서 올해 좀 완성도 있는 벤치마크를 공개한게 아닐까 싶습니다.
일단 해당 논문은 앞서 언급했듯이 기존 Visual Navigation 모델들이 실제 도시의 보행로 환경에서 얼마나 안정적으로 주행할 수 있는지를 평가하기 위한 벤치마크를 제안한 연구입니다. 최근 ViNT, NoMaD, CityWalker와 같은 Visual Navigation 모델들이 등장하면서 다양한 환경에서의 일반화 성능을 보여주고 있긴하지만, 실제 도심 환경에서는 복잡한 보행로 구조나 정적 장애물뿐 아니라 보행자와의 상호작용, 장거리 주행 등 여러 요소를 함께 고려해야 합니다. 근데 기존 연구들은 대부분 제한적인 환경에서 짧은 거리를 주행하는 방식으로 평가를 진행하기 때문에, 실제 도시 환경에서 모델이 얼마나 안정적으로 동작할 수 있는지를 비교하기 어렵다는 문제가 있습니다. 가령 그들의 방법론의 성능에 좋게끔 설계를 했을 수 도 있고 혹은 벤치마크 자체가 너무 쉬워서 사실상 해당 평가가 유의미하지 않을 수 있습니다.
그래서 저자들은 NVIDIA Isaac Sim을 기반으로 다양한 도시 보행로 환경과 보행자 행동을 시뮬레이션하고, 이를 통해 기존 Visual Navigation 모델들을 동일한 조건에서 평가할 수 있는 SidewalkBench를 제안합니다. 특히 단순히 Goal에 도달하는지만 평가하는 것이 아니라, 보행로의 구조를 따라 주행할 수 있는지, 다양한 보행자 행동에 적절하게 반응하는지, 그리고 장거리 주행 과정에서 얼마나 자주 실패하는지를 구분해서 평가한다는 점이 핵심이라고 보시면 좋을 것 같습니다.
자세한 내용은 아래 리뷰에서 다루도록 하겠습니다.
Introduction
앞서 말씀드렸듯이 최근 Visual Navigation 분야에서는 RGB 카메라로 관측한 이미지를 기반으로 로봇이 이동해야 할 Waypoint를 직접 예측하는 E2E Navigation 연구들이 활발하게 진행되고 있고 대표적으로 ViNT, NoMaD, CityWalker 등이 있다고 하였습니다. 그리고 요즘 완전 최근에는 VLM을 활용해서 주변 환경을 이해하고 일반화를 타깃으로 주행 궤적을 예측하는 VLA 기반 방법론들이 많이 쏟아지고 있는 추세입니다.
이러한 모델들은 실내외 여러 환경에서 각자의 벤치마크 내에서는 좋은 성능을 보여주고 있지만, 저자들은 기존 평가 방식만으로는 실제 도시 보행로에서의 주행 성능을 충분히 검증하기 어렵다고 지적합니다.
예를 들어 기존 벤치마크 중 하나인 NavBench-GS는 대부분 10m 이하의 짧고 직선적인 경로를 대상으로 평가하기 때문에, 복잡한 보행로를 따라 장거리를 주행하는 상황을 평가하기에는 한계가 있다고 합니다.
그리고 실제 도시 보행로에서는 단순히 장애물을 피하는 것뿐 아니라, 반대편에서 다가오는 보행자에게 길을 양보하거나 여러 사람이 모여 있는 공간을 우회하는 등 다양한 Social Navigation 능력이 필요합니다. 근데 기존 VN벤치마크에서는 이러한 보행자 행동이 모델 성능에 어떤 영향을 미치는지 체계적으로 분석하기 어렵다는 문제가 있습니다.
그래서 저자들은 실제 도시 보행로에서 발생할 수 있는 다양한 상황을 재현하고, 각각의 상황에서 모델이 어떤 부분에 취약한지를 분석할 수 있는 통합 평가 환경을 구축하고자 한것이고 SideWalkBench라는 벤치마크를 제안합니다.
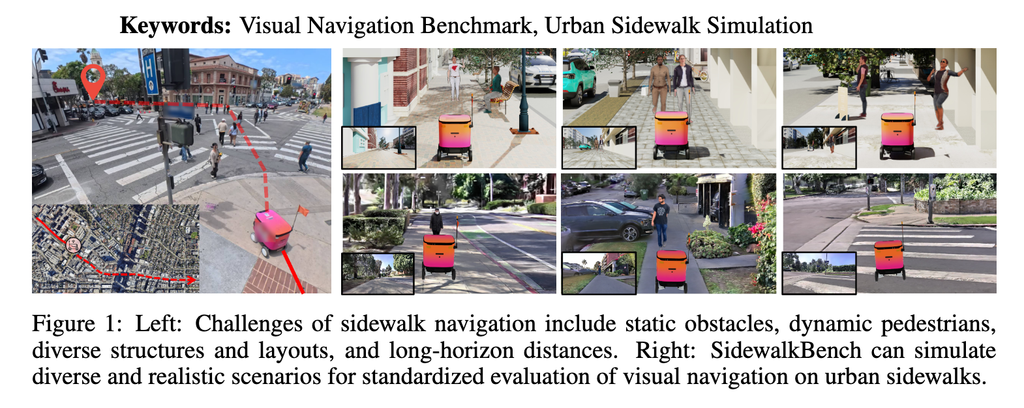
위 그림은 SidewalkBench가 평가하고자 하는 도시 보행로 환경을 보여줍니다. 실제 도시에서는 보행로의 형태가 다양하고 곳곳에 장애물이 존재하면서 실제 보행자들의 움직임도 계속 달라집니다. 결국 이러한 요소들을 함께 고려하면서 장거리를 안정적으로 주행하는 것이 중요한 문제이면서 저자들은 이러한 부분을 평가하기 위한 벤치마크를 제안한 것이라고 보시면 좋을 것 같습니다.
SidewalkBench
SidewalkBench는 크게 도시 보행로 환경을 생성하는 Scene Generation, 다양한 보행자 행동을 재현하는 Pedestrian Simulation, 그리고 모델의 성능을 평가하기 위한 Evaluation Scenarios로 구성된다고 보시면 좋을 것 같습니다. 전체적인 시뮬레이션은 NVIDIA Isaac Sim을 기반으로 구현되어 있고 이를 통해 로봇의 물리적인 움직임과 RGB 카메라 관측을 함께 시뮬레이션할 수 있도록 설계했다고 합니다.
Scene Generation
먼저 저자들은 다양한 도시 환경에서 모델을 평가하기 위해 두 가지 형태의 Scene을 사용합니다.
첫 번째는 Procedurally Generated Scenes입니다.
기존 MetaUrban이나 Urban-Sim과 같은 연구 를 참고해서 직선 도로, 곡선 도로, 교차로 등 총 7가지 기본 블록을 정의하고, 이를 조합해 다양한 형태의 도시 환경을 생성했다고 합니다. 그리고 각 블록을 도로, 보행로, 연석 등 여러 기능 구역으로 구분한 다음, UrbanVerse-100K에서 제공하는 다양한 3D Asset과 Texture를 배치하는 방식으로 환경을 구성했고 이러한 방식으로 총 100개의 대규모 환경을 생성했고, 각 환경은 2km × 2km 규모라고 합니다. 해당 논문에는 디테일한 내용은 안나와있어 자세한 내용은 각각의 논문을 참고하면 좋을 것 같습니다. 단순히 좀 realistic한 asset들을 가지고 실제 시뮬레이션 위에서 각각을 재배치하여 평가환경을 다양하게 구축했다고 보시면 좋을 것 같습니다.
두 번째는 Real-world Scanned Scenes입니다.
앞선 Procedural Generation은 다양한 형태의 환경을 생성하는 데 유리하지만 아무래도 실제 도시 환경과 시각적으로 차이가 발생할 수 있습니다. 그래서 저자들은 실제 도시 공간을 스캔해서 복원한 환경도 함께 사용합니다.
여기서는 LiDAR와 4개의 카메라가 탑재된 XGRIDS사의 Spatial Camera를 이용해서 실제 거리 데이터를 수집하고, 3D Gaussian Splatting(3DGS)을 통해 시각적으로 사실적인 환경을 복원했다고 합니다. 실제 3DGS를 쓰는 경우 metric한 스케일 복원을 못하는데 이런 LiDAR센서와 rgb 센서가 통합된 카메라를 사용함으로써 metric scale 이나 metric한 pose를 맞춘 것 같습니다. 실제 wanderland라는 벤치마크 논문도 이런 spatial camera를 사용해서 사실적이고 metric scale의 closed-loop 평가 벤치마크를 제안한바 있습니다.
근데 여기서 3DGS만 사용하는 것이 아니라, 이를 토대로 별도로 복원한 Mesh를 물리적인 충돌과 지형 정보를 표현했다고 합니다. 3DGS는 사실적인 RGB 관측을 렌더링하는 데 활용하고, 추가적으로 저자들이 뽑아낸 Mesh는 로봇이 실제로 이동하거나 충돌하는 물리적 환경을 구성하는 데 사용한다고 보시면 좋을 것 같습니다.
이러한 방식으로 총 11개의 실제 도시 환경을 복원했고, 각 Scene의 평균 규모는 약 150m × 150m라고 합니다.
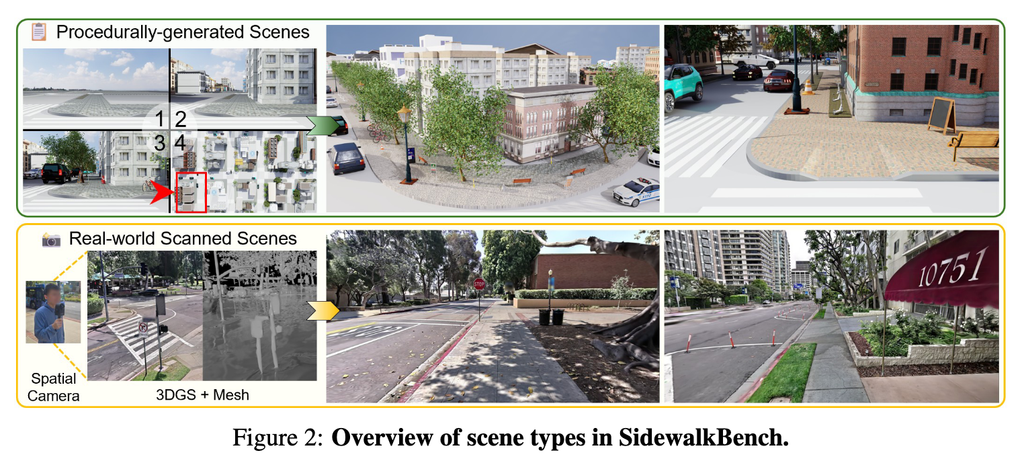
위 그림을 보면 두 가지 Scene의 차이를 확인할 수 있는데, 정리하면 Procedurally Generated Scenes는 다양한 도로 구조와 장애물 배치를 생성하는 데 초점을 맞추고 있고, Real-world Scanned Scenes는 실제 도시 환경의 시각적인 특성과 구조를 최대한 재현하는 데 초점을 맞추고 있습니다.
저자들은 위 두 가지 환경을 함께 사용함으로써 모델이 다양한 구조의 보행로에서 일반화할 수 있는지, 그리고 실제 환경과 유사한 관측에서도 안정적으로 동작하는지를 함께 평가하고자 한 것 같습니다.
Pedestrian Simulation
다음은 Pedestrian Simulation입니다. 이 부분이 기존 벤치마크들과의 어떻게 보면 핵심적인 차이라고 생각하는데, 일단 저자들은 실제 도시 보행로에서의 내비게이션을 평가하려면 단순히 사람이 움직이는 환경을 만드는 것만으로는 부족하고 로봇의 움직임에 따라 보행자가 반응하는 다양한 상황을 재현할 수 있어야 한다고 설명합니다. 단순하게 동적인 보행자를 평가 벤치마크에 넣어서 평가를 하겠다라고 이해하시면 좋을 것 같습니다.
그래서 보행자 시뮬레이션을 크게 High-level Behavior와 Low-level Animation으로 구분해서 설계합니다.
먼저 High-level Behavior에서는 Behavior Graph와 State Machine을 이용해서 보행자의 행동을 정의합니다. (Behavior Graph와 State Machine는 이런 보행자 행동에 관한 이전 연구로 SEAN 2.0: Formalizing and Generating Social Situations for Robot Navigation이라는 논문을 참고하시면 좋을 것 같습니다.) 암튼 이런 것을 가지고 기본적으로 보행자가 특정 위치로 이동하거나 정지하는 등의 행동을 수행하게끔하고 여기에 로봇과 보행자의 상대적인 위치에 따라 특정 행동이 발생하는 Event-based Behavior를 추가했다고 합니다.
제가 간단히 이해한 바로는 예를 들어 로봇이 접근하면 보행자가 갑자기 경로를 가로질러 이동하게끔 한다거나 로봇을 향해 걸어오거나, 정지하라는 제스처를 취하는 식으로 특정 이벤트가 발생했을 때 저자들이 정의한 보행자의 행동이 이루어진도록 설계했다 인것 같습니다.
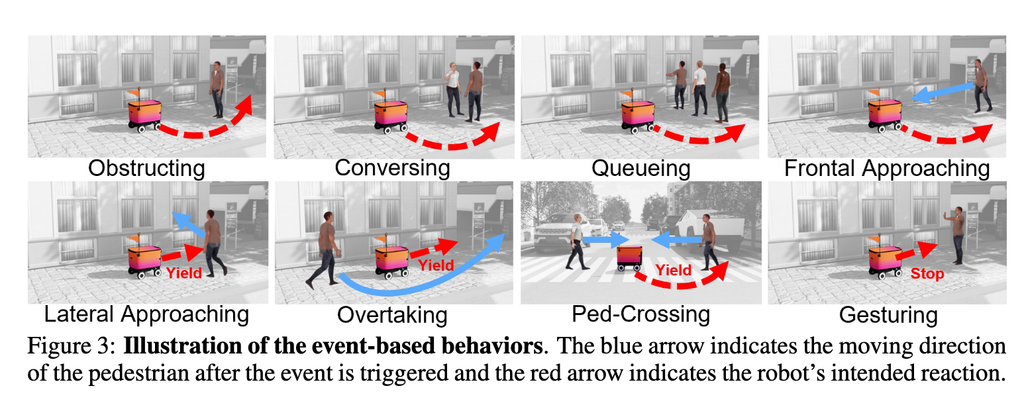
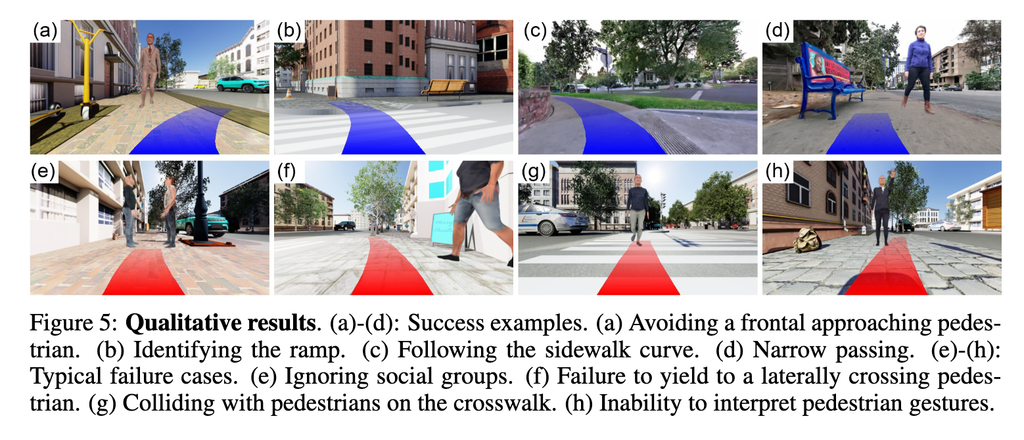
위 그림은 저자들이 정의한 8가지 보행자 행동이라고 하는데 보시면 정지해 있는 보행자, 대화하는 사람들, 줄을 서 있는 사람들뿐 아니라 정면 접근, 측면 접근, 추월, 횡단보도 통행, 정지 제스처 등의 상황이 포함됩니다.
그리고 Low-level Animation에서는 앞서 정의했던 이러한 행동을 실제 사람의 움직임으로 표현하기 위해 SMPL 기반의 인체 모델을 사용했다고 합니다. 여기서 SMPL은 체형과 관절 자세를 조절해 다양한 사람의 3D 몸과 움직임을 표현하는 인체 모델이라고 합니다. 그리고 MotionLCM과 같은 Motion 생성 모델이나 기존 Human Motion Dataset을 활용해 다양한 동작을 생성하고, 별도의 렌더링 파이프라인을 통해 효율적으로 보행자를 렌더링하도록 구성했다고 합니다.
여기까지는 살짝 로봇 내비게이션과는 다른 문제를 풀고 있는 부분이라 저자들도 논문에는 엄청 디테일하게까지는 설명하지는 않았지만, 아주 간단하게 뇌피셜로 정리하면 High-level에서는 보행자가 어떤 행동을 할지를 결정하고, Low-level에서는 해당 행동을 실제 사람의 움직임으로 표현하는 구조인 것 같습니다.
Evaluation Scenarios
이제 앞에서 구성한 환경과 보행자 시뮬레이션을 기반으로 실제 내비게이션 모델을 평가하는 단계입니다. 저자들은 서로 다른 내비게이션 능력을 구분해서 평가하기 위해 총 세 가지 시나리오를 제안합니다.
Unit-test Scenarios
먼저 Unit-test는 로봇이 기본적인 보행로 구조를 따라 주행할 수 있는지를 평가하는 시나리오라고 보시면 좋을 것 같습니다. Straight, Curve, Crosswalk의 세 가지 구조를 대상으로 하고 시작 위치에서 목표까지의 거리는 약 10~20m로 세팅했다고 합니다. 여기서는 보행자를 배치하지 않고, 보행로를 벗어나지 않으면서 정적 장애물을 회피하고 목표에 도달할 수 있는지를 평가하는 식으로 분리했습니다.
여기 시나리오에서는 총 330개의 시나리오로 구성되있고 60초 이내에 목표에 도달하면 성공으로 판단하는 식으로 평가를 구축하고. 중간에 충돌하거나 보행로를 벗어나면 실패로 처리하는 식으로 했다고 합니다.
Pedestrian-reactive Scenarios
그리고 두 번째는 다양한 보행자 행동에 대한 로봇의 반응을 평가하는 시나리오인데, 앞서 설명한 8가지 Event-based Behavior를 대상으로 각각 100개씩 총 800개의 시나리오를 구성했다고 합니다. 여기서는 단순히 보행자와 충돌하지 않는지만 평가하는 것 뿐만아니라, 상황에 맞는 행동을 수행하는지도 함께 고려하게끔 평가를 구축했다고 합니다. 예를 들어 Conversing(여러 보행자가 보도 한가운데서 서로 마주 보고 대화하며 길을 막는 상황)이나 Queueing(보행자들이 보도 한쪽에서 간격을 좁혀 줄을 서 있는 상황)에서는 사람들 사이를 통과하는 것이 아니라 그룹 전체를 우회해야 성공으로 인정하고 Gesturing(보행자가 로봇한테 멈춰! 라고 제스쳐 취하는 상황)에서는 보행자가 정지 제스처를 취했을 때 로봇이 보행자 앞에서 멈춰야 성공으로 인정하는 식으로 했다고 합니다.
단순한 장애물 회피하는 것을 넘어서 보행자의 행동을 이해하고 적절하게 반응할 수 있는지를 평가하는 태스크라고 보시면 좋을 것 같습니다.
Long-horizon Scenarios
마지막은 Long-horizon Navigation인데, 이것도 기존 벤치마크와는 차별점이라고 볼 수 있을 것 같습니다. 앞선 두 시나리오가 비교적 짧은 구간에서 특정 능력을 평가했다면, Long-horizon에서는 실제 도시에서 장거리를 주행할 때 모델이 얼마나 안정적인지를 평가합니다.
시작점과 목표점 사이의 거리가 100m 이상인 경로를 대상으로 하고 총 105개의 시나리오를 구성했다고 합니다. 전체 평가 경로를 합치면 약 36.5km에 해당한다고 합니다. 아무래도 장거리 주행능력 평가는 어렵고 완주하는 성공 확률이 낮기 때문에 저자들은특징은 로봇이 충돌하거나 보행로를 벗어났다고 해서 에피소드를 바로 종료하지 않게끔하고 대신에 로봇을 경로상의 위치로 복구시킨 다음 주행을 계속 진행하고, 전체 주행 거리에서 얼마나 많은 실패가 발생했는지를 기록하는 식으로 평가를 진행합니다.
그리고 다른 경로로 이동하는 것을 방지하기 위해 목적지까지 하나의 경로만 존재하도록 구성합니다. 따라서 복잡한 Global Path Planning보다는 주어진 경로를 얼마나 안정적으로 따라갈 수 있는지를 평가하는 데 가깝다고 볼 수 있습니다.
Evaluation Protocol & Metrics
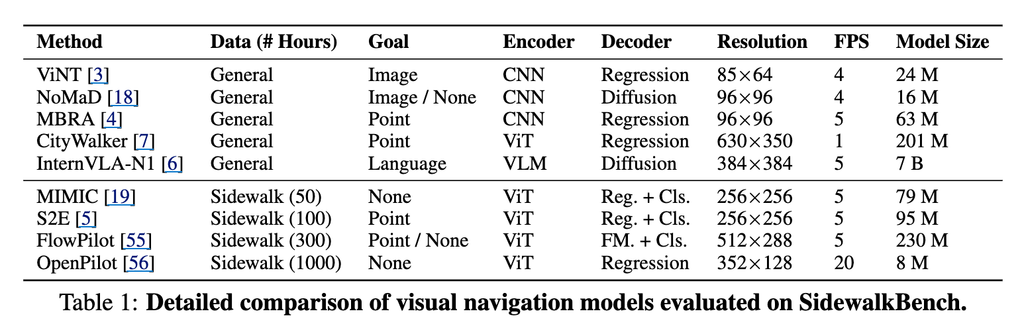
저자들은 ViNT, NoMaD, MBRA, CityWalker, InternVLA-N1과 같은 General Visual Navigation 모델들과 MIMIC, S2E, FlowPilot, OpenPilot처럼 실제 보행로 주행 데이터로 학습한 모델들을 비교해서 평가 합니다.
위 테이블 보시면 각 모델마다 입력으로 사용하는 Goal의 형태나 출력 Waypoint의 개수, 추론 주기 등이 서로 다르기 때문에 사실 동일한 환경에서 평가하더라도 입력 조건과 시뮬레이션 환경(sync vs async 평가)을 어떻게 설정하느냐가 공정한 평가에 중요합니다.
그래서 저자들은 모델에 실제 목표 경로에 대한 추가적인 정보를 제공하지 않는 방식으로 기본 평가를 구성합니다.
ViNT와 NoMaD는 Goal-free 모드로 평가하고, Point-Goal 모델에는 로봇 기준 전방의 임의 목표점을 제공하는 방식을 사용했다고 합니다. 그리고 VLA 모델에는 단순하게 “Follow the sidewalk”라는 일반적인 주행 지시를 입력합니다. 이 부분은 저자의 의도는 이해는 되는데, 뭔가 공정한것 같기도 하면서 아닌것 같기도하고 잘모르겠습니다. 내비게이션 모델 마다 subgoal을 촘촘하게 주냐 듬성하게 주냐, 혹은 prompt를 세세하게 주냐 안주냐에 따라 내비게이션 성능이 천차 만별이라 그런 것 같기도 하고, 그리고 갈수 있는 경로를 사전에 차단해서 goal까지의 경로는 한개 뿐이라고는 하나 과연 goal-free로 했을 때 그 경로를 잘 따라갈 수 있을까하는 의문도 들기도하고 모델 자체가 goal-free도 가능한 것이지 이걸 타깃으로 학습된 모델들이 아니라 공정한 평가가 맞을지는 의문이 들긴합니다. 근데 암튼 제가 느끼기엔 결국 실제 최종 Goal을 직접 알려주고 해당 위치까지 찾아가도록 하는 평가라기보다는, 현재 관측을 기반으로 보행로를 따라 주행하면서 주변 상황에 적절히 반응할 수 있는지를 평가하는 느낌인 것 같습니다.
그리고 여기서 모델들이 예측한 Waypoint는 공통된 PD Controller를 통해 로봇의 선/각속도 명령으로 변환합니다.
평가 메트릭은 시나리오별로 조금씩 다르게 설계합니다.
먼저 Unit-test에서는 Route Completion Rate(RC)를 주요 메트릭으로 사용합니다. 이는 로봇이 전체 경로 중 얼마나 진행했는지를 나타내는 지표이고 그리고 실제 Goal 도달 성공률인 SR과 경로 효율을 고려한 SPL도 함께 제시합니다. 그리고 Pedestrian-reactive에서는 각 상황을 성공적으로 완료했는지를 나타내는 SR을 사용하고, 추가적으로 보행자 충돌 비율이나 최소 거리 등을 분석해서 제시하고 Long-horizon에서는 Failure Counts per 100m를 사용합니다. 이는 100m를 주행하는 동안 충돌, 보행로 이탈, 정지 등의 실패가 평균적으로 몇 번 발생하는지를 나타내는 지표입니다.
Experiments
Unit-test Results
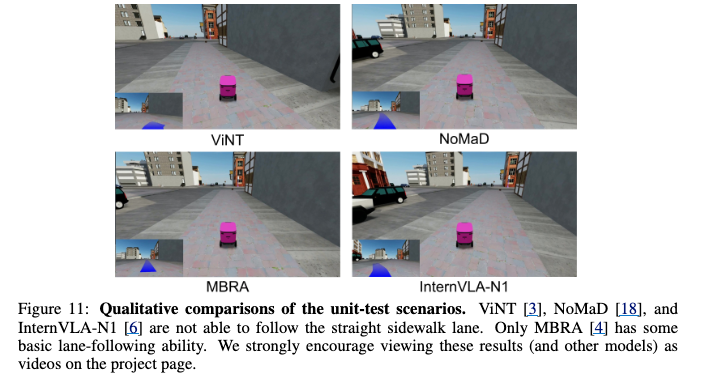
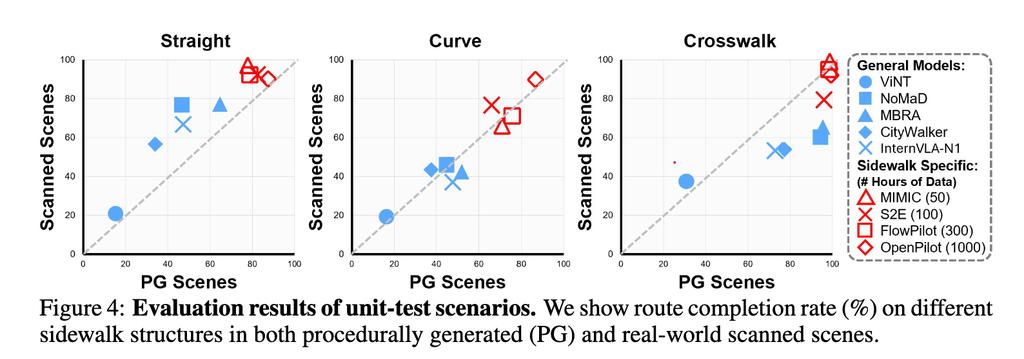
먼저 Unit-test 결과를 보면 어떻게 보면 당연할 수 있는 결과인데 전반적으로 General Visual Navigation 모델보다 Sidewalk-specific 데이터로 학습한 모델들이 더 좋은 성능을 보입니다. Procedurally Generated Scene의 Straight 구간에서 ViNT의 RC보다 50시간의 보행로 주행 데이터로 학습한 MIMIC은 RC가 훨씬 좋은 성능을 보이고 그리고 1,000시간의 보행로 데이터를 사용한 OpenPilot은 대부분의 환경에서 가장 좋은 성능을 보여줍니다.
그리고 Procedurally Generated Scene과 Real-world Scanned Scene에서 비슷한 성능 경향이 나타나는 것을 보실 수 있는데 이런 부분은 Procedural Generation으로 생성한 환경도 모델의 보행로 주행 능력을 비교하는 데 충분히 활용할 수 있다는 점을 보여주는 것 같습니다.
다만 RC는 실제 목표 도달 성공률과는 다른 지표라 예를 들어 실제 도착지점 거의 앞까지 왔는데 마지막에 실수로 이상한길로 빠져서 도착 못하면 RC는 높지만 SR은 낮을 수 있습니다. 그래서 단순히 얼마나 멀리 이동했는지일뿐 최종적으로 안전하게 도착했는지를 나타내는 지표는 아닌걸 감안하고 보시면 좋을 것 같습니다.
Pedestrian-reactive Results
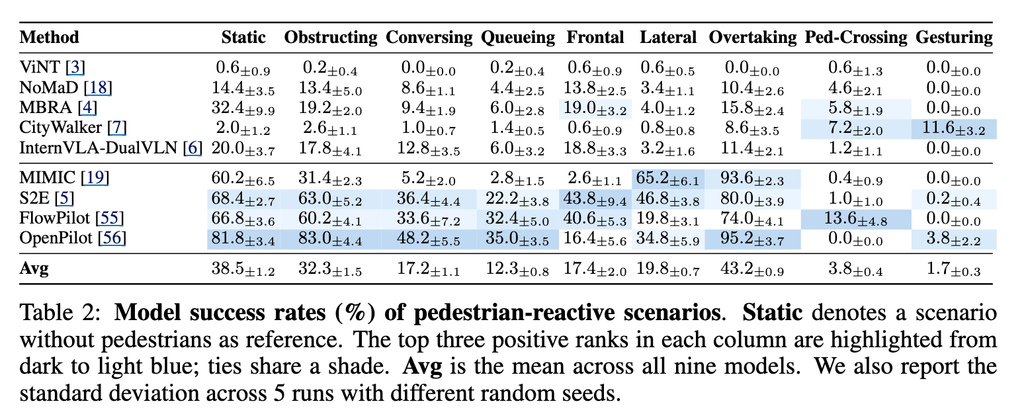
위 테이블2는 보행자와의 상호작용에 대한 평가 결과인데, 결과를 보면 대부분의 모델이 정적인 장애물을 회피하는 것보다 사람들의 행동에 적절하게 대응하는 상황에서 더 어려워한다는 결과를 보실 수 있습니다.
단순히 한 명의 보행자가 서 있는 상황(static)보다 여러 사람이 대화하거나 줄을 서 있는 상황(conversing, queueing)에서 성공률이 크게 감소합니다. 전체 모델의 평균 성공률은 Conversing, Queueing에서는 10퍼 때를 기록합니다.
특히 Ped-Crossing과 Gesturing은 가장 어려운 시나리오의 결과를 보이는데 각각 평균이 한자릿수의 성공률을 보입니다. (Ped-Crossing에서는 횡단보도를 따라 이동하면서 여러 방향에서 접근하는 보행자를 회피해야 하고 Gesturing에서는 보행자의 제스처를 이해해서 주행을 멈춰야 함)
저자들이 말하기로는 VLA 기반 모델인 InternVLA-N1은 일부 상황에서 보행자와의 충돌을 상대적으로 잘 피하고 안전거리를 확보하는 모습을 보여줬다고 합니다. 근데 결과적으로 보면 전체적인 주행 성공률 자체는 높지 않기 때문에, 저자들은 VLA의 하이레벨의 Reasoning 능력과 기존 내비게이션 Policy의 러우 레벨의 Control 능력을 결합하는 방향도 필요하다고 설명합니다.
Long-horizon Results
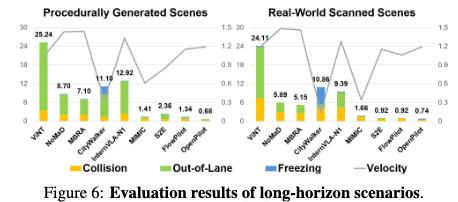
Long-horizon에서도 Sidewalk-specific 데이터로 학습한 모델들이 전반적으로 더 좋은 성능을 보입니다.
특히 OpenPilot은 Procedurally Generated Scene에서 100m당 평균 0.68회의 실패를 기록하면서 가장 좋은 성능을 보였고, 평균 주행 속도도 1.19m/s로 높게 나타나는 결과를 보인데, 사실 실제 서비스 관점에서 봤을 때 100m당 0.68회라는 수치를 실제 배달 로봇의 주행 거리로 확장해서 생각해 보면 아직 부족하다라고 저자들은 말합니다. 저자들은 일반적인 배달 로봇이 약 2km를 주행한다고 가정했을 때 OpenPilot의 성능으로는 평균적으로 약 13.6번의 사람 개입이 필요할 것이라고 얘기합니다. 짧은 구간에서 좋은 성능을 보이는 모델이라도 실제 도시에서 장거리를 연속적으로 주행하기에는 아직 부족하다는 것이고 이제는 저자들이 이런 벤치마크를 제안했으니 이제 여기서 long horizon 도 연구를 진행하고 평 하면 된다 라는 느낌인 것 같습니다.
Ablation
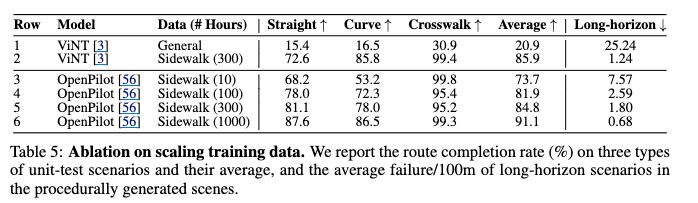
앞선 실험에서 Sidewalk-specific 데이터로 학습한 모델들이 좋은 성능을 보여주었는데, 저자들은 이러한 차이가 모델 아키텍쳐 때문인지 학습 데이터 때문인지를 분석하기 위한 추가적인 Ablation을 진행한것이라고 보시면 좋을 것 같습니다. 먼저 동일한 OpenPilot 구조에서 학습 데이터의 규모를 10시간부터 1,000시간까지 증가시키면서 성능을 비교합니다.
결과적으로 Unit-test의 평균RC는 73.7에서 91.1%까지 증가하고, Long-horizon의 100m당 실패 횟수는 7.57회에서 0.68회까지 감소합니다.그리고 기존 General Dataset으로 학습한 ViNT를 300시간의 Sidewalk 데이터로 다시 학습했을 때도 평균 RC가 20.9에서 85.9%로 증가하는 결과를 보입니다.
여기서 근데 오히려 300시간의 동일한 데이터로 학습한 ViNT가 OpenPilot보다 좀더 좋은 결과를 보입니다. 이 결과를 보면 모델의 아키텍쳐도 물론 중요하지만, 당연한 얘기지만 실제 주행하려는 환경과 유사한 데이터로 충분히 학습을 시켜야한다 라는 것을 보여주는 것 같습니다.
Synthetic Training Data Generation
마지막으로 저자들은 SidewalkBench가 단순한 평가 환경뿐만아니라 학습 데이터를 생성하는 데도 활용될 수 있는지를 검증합니다. 실제로 보행자와 상호작용하는 데이터를 수집하려면 좀 많은 비용이 발생하고 특히 위험한 상황을 반복해서 수집하기는 어렵다고 합니다. 그래서 저자들은 성능이 가장 낮았던 Ped-Crossing과 Gesturing 시나리오를 대상으로 ORCA (Optimal Reciprocal Collision Avoidance, 여러 Agent가 서로 충돌하지 않도록 이동 속도와 방향을 결정하는 알고리즘)기반 Expert Planner를 이용해 각각 시뮬레이션 위에서 500개의 Demonstration을 생성합니다. 이렇게 생성한 Synthetic Dataset을 이용해서 FlowPilot을 파인튜닝합니다. 이때 비전 Backbone은 고정하고, Action Generation과 관련된 모듈을 중심으로 학습했다고 합니다.
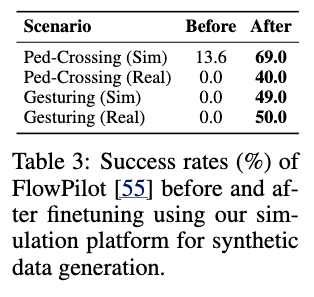
실험 결과를 보면 Ped-Crossing,Gesturing 의 시뮬레이션, real에서 성공률이 모두 크게 증가하는 결과를 보입니다.
그리고 real 환경 평가도 여기서 간단하게 진행을 한 것 같은데 자세한 평가 구성은 언급되어있지는 않습니다. 다만 실제 환경에서의 평가 규모가 크지는 않다 정도로 명시하고 그래서 일반적인 Sim-to-Real 성능을 충분히 검증했다고 보려면 추가 검증이 필요하다 라고 언급만 되어있습니다.
그래도 실제로 수집하기 어렵거나 위험한 보행자 상호작용 데이터를 시뮬레이션에서 생성해서 이를 학습데이터로 사용해서 내비게이션 policy 의 성능을 개선할 수 있다는 가능성을 보여준 실험이라고 생각합니다.
Conclusion
개인적으로 해당 논문의 벤치마크는 추후 내비게이션 모델들의 성능을 공개적으로 평가할 수 있을 것 같아 많이 인용해서 활용될 것 같은 느낌이 듭니다. 기존 연구들이 대체로 짧은 거리에서 Goal에 도달하는지를 평가하거나, realistic한 환경이라고 주장하지만 실제로는 그렇지 않거나, 혹은 벤치마크 자체에 노이즈가 많다거나 혹은 코드 공개를 안하거나, 혹은 일부만 공개했던 기존 방법론들과는 다르게 SidewalkBench는 기본적인 보행로 주행 능력, 다양한 보행자 행동에 대한 반응, 장거리 주행 안정성을 구분해서 평가하는 것 뿐더러 코드와 벤치마크 데이터를 공개해줌에 있어서 정말 감사한 논문이라고 생각합니다. 물론 실제 코드기반으로 저희 환경에 세팅해서 돌려보기까지는 모르는 것이긴하지만.. 근데 느낌이 좋습니다. 암튼 이런 다양한 상황을 실제 로봇으로 반복해서 평가하기는 어렵기 때문에 SidewalkBench와 같이 실제 환경에 가까운 시뮬레이션에서 표준화된 평가를 진행할 수 있는 벤치마크의 중요성이 점점 커질 것 같고 이에 따라 앞으로는 기존 방법론들의 약간 편향된 성능이 걷어지고 각각의 명확한 성능 비교가 가능해질 것 같습니다.
이만 리뷰 마치도록 하겠습니다. 감사합니다.