안녕하세요. 이번에는 Zero-Shot Customizable Video Anomaly Detection with LVLM 논문을 읽어보았습니다. 앞서 읽었던 LAVAD와 EventVAD처럼 별도의 탐지 모델 학습 없이 비디오에서 이상 상황을 찾는 연구인데요. 이번에는 무엇을 이상 상황으로 볼 것인지를 사용자가 텍스트로 지정한다는 점이 다릅니다. 같은 영상이라도 자전거를 찾을지, 넘어진 사람을 찾을지에 따라 탐지 결과가 달라지는 것이죠. 그럼 시작하겠습니다.
1. Introduction
Video Anomaly Detection(VAD)은 비디오에서 이상 상황이 발생하는 시간 구간을 찾는 문제입니다. 그런데 무엇이 이상한지는 환경에 따라 달라집니다. 보행자 전용 공간에서는 자동차가 등장하는 것이 이상할 수 있지만, 도로에서는 자동차가 있는 것이 자연스럽겠죠. 반대로 사람이 차도로 들어오는 상황을 탐지해야 할 수도 있구요.
기존의 one-class classification(OCC) 기반 방법들은 정상 영상의 패턴을 학습하고, 그 패턴에서 벗어나는 장면을 이상으로 판단합니다. 문제는 학습한 정상의 기준을 다른 환경에 그대로 가져가기 어렵다는 점입니다. 새로운 환경에 맞춰 데이터를 모으고 다시 학습하는 과정이 필요해지는 것이죠.
여기서 저자들이 던지는 질문이 있는데여ㅛ. 모델에게 정상 분포를 다시 학습시키는 대신, 사용자가 찾고 싶은 이상 상황을 말로 알려주면 어떨까요?
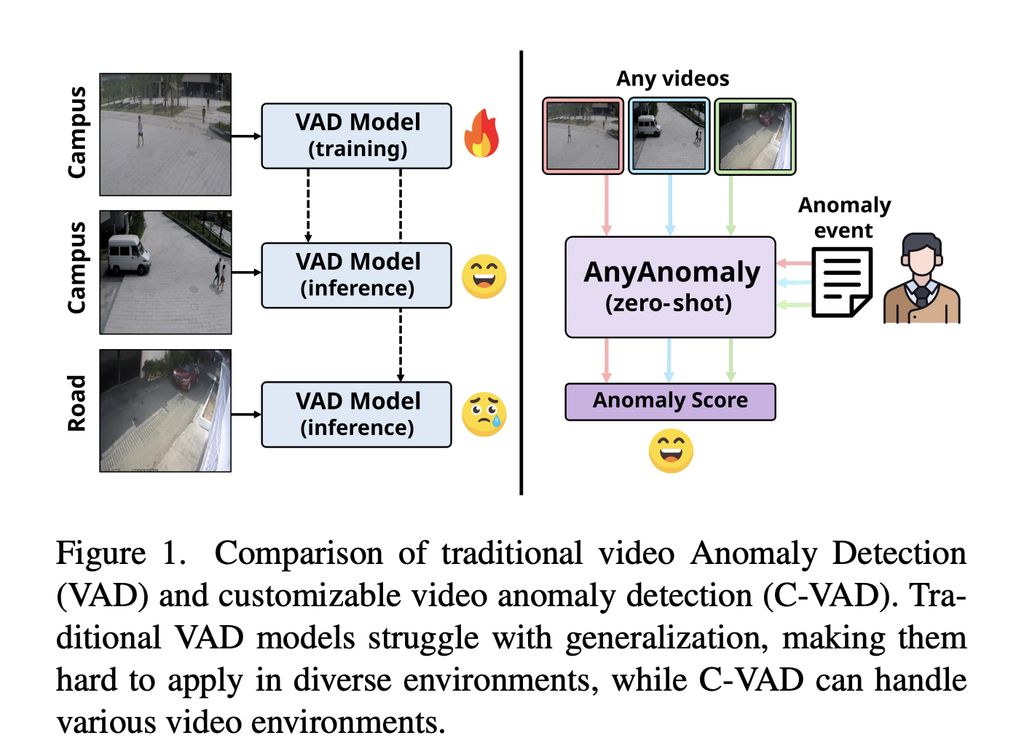
논문에서는 이를 Customizable Video Anomaly Detection, 줄여서 C-VAD라고 부릅니다. 예를 들어 사용자가 bicycle을 입력하면 자전거가 등장하는 프레임을 찾고, fighting을 입력하면 싸움이 발생하는 프레임을 찾습니다. Figure 1을 통해 C-VAD의 동작 파이프라인을 약소한 버전으로 확인할 수 있습니다.
C-VAD를 하는 가장 간단한 방법은 매 프레임을 Large Vision-Language Model(LVLM)에 넣고 해당 사건이 있는지 묻는 것입니다. 하지만 작은 물체가 배경에 묻힐 수 있고, 한 장의 이미지로는 걷기와 싸움처럼 움직임을 봐야 구별되는 행동을 판단하기 어렵습니다. 모든 프레임에 질문하는 비용도 크구요.
논문의 저자가 제안한 AnyAnomaly는 이 문제를 입력 구성으로 풀어봅니다. 비디오 구간에서 대표 프레임을 고르고, 찾는 대상의 위치를 강조한 이미지와 시간적 변화를 보여주는 이미지를 추가로 만들어 LVLM에 제공합니다.
Contribution을 정리하면 다음과 같습니다.
- 사용자가 텍스트로 이상 상황을 지정하는 C-VAD 문제와, 추가 모델 학습 없이 이를 수행하는 AnyAnomaly를 제안함.
- Key frames Selection Module과 position/temporal context를 결합해, LVLM이 어디를 보고 어떤 움직임을 판단해야 하는지 보완함.
- 기존 데이터셋을 사건별로 재구성한 C-ShT와 C-Ave에서 효과를 검증하고, 일반 VAD 및 환경 간 일반화 설정에서도 경쟁력 있는 결과를 보임.
2. Method
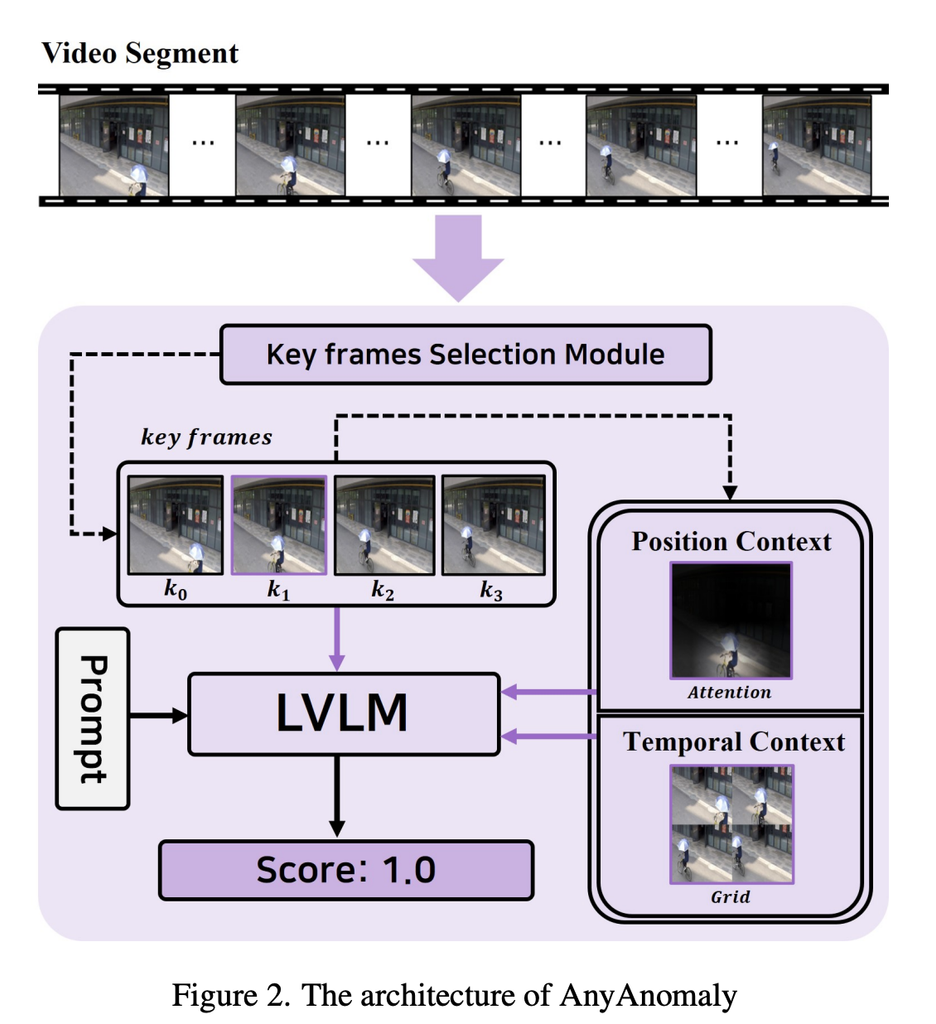
논문의 Figure 2가 전체 구조입니다. 흐름을 먼저 정리하면 다음과 같습니다.
비디오 구간과 사용자 텍스트 입력 -> 네 개의 key frame 선택 -> 위치 및 시간 context 생성 -> 3개 이미지(대표 프레임, 위치 및 시간 context 프레임)에 대한 VQA -> 점수 결합 및 프레임 단위 후처리
2.1 Key frames Selection Module
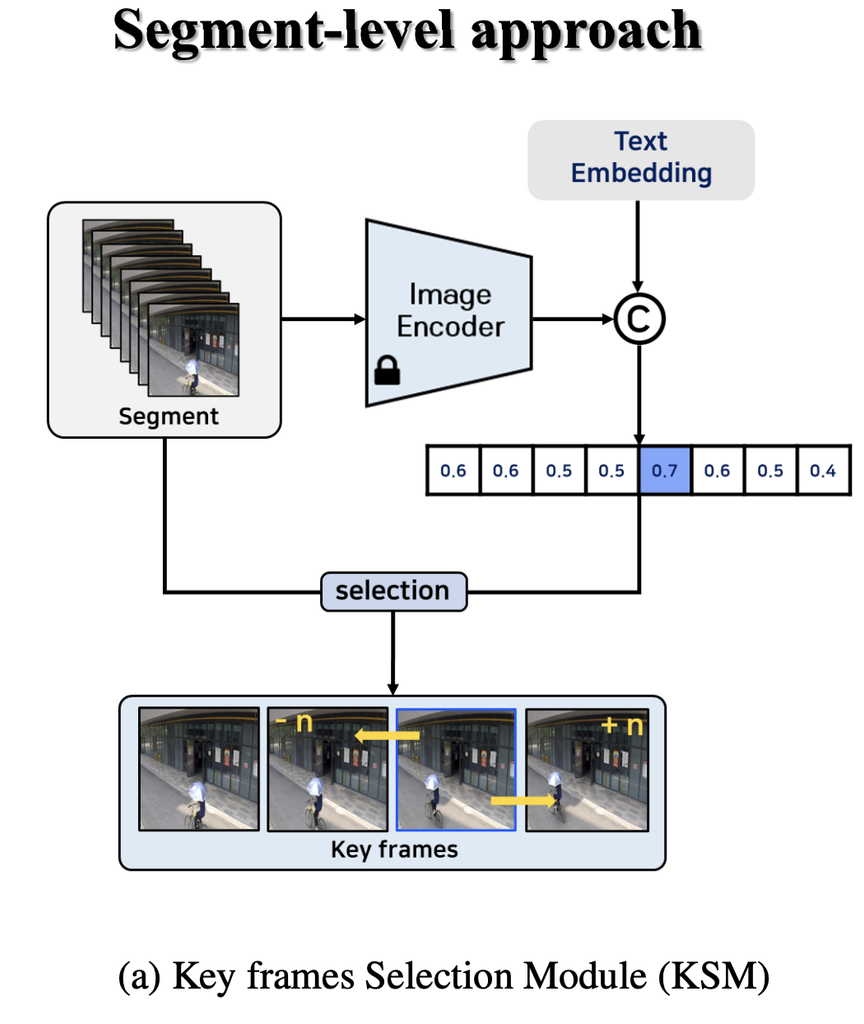
첫 단계는 비디오 구간에서 네 개의 프레임을 고르는 것입니다. 입력 구간을 $S=\{s_0,\ldots,s_{N-1}\}$, 사용자 텍스트를 $X$라고 하겠습니다. $N$은 4의 배수입니다.
먼저 CLIP의 image encoder $E_I$와 text encoder $E_T$를 이용해 각 프레임과 텍스트의 유사도를 계산합니다. 그중 가장 유사한 프레임을 대표 프레임 $\hat{k}$로 선택합니다.
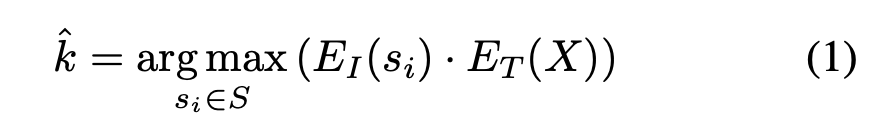
그런데 유사도가 높은 프레임 네 장을 그대로 고르면 비슷한 시점에 몰릴 수 있습니다. 자전거가 가장 잘 보이는 순간만 네 장 고르는 것은 물체를 확인하는 데는 좋겠지만, 시간에 따라 어떻게 움직이는지를 보여주기는 어렵겠죠.
그래서 대표 프레임의 위치를 기준으로 나머지 프레임을 일정한 간격으로 선택합니다. 구간을 네 그룹으로 나누고, 각 그룹에서 대표 프레임과 같은 상대 위치의 프레임을 가져오는 방식입니다. 대표 프레임의 인덱스를 $\hat{i}$라고 하면 다음과 같습니다.
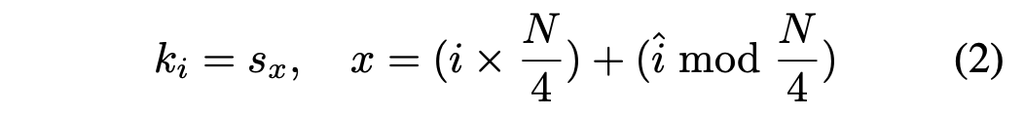
예를 들어 N=8이고 대표 프레임의 인덱스가 4라면, 최종적으로 $s_0,s_2,s_4,s_6$을 고릅니다. 텍스트와 가장 관련 있는 프레임은 포함하면서, 구간의 앞뒤 모습도 일정한 간격으로 확보하는 것이죠.
즉 KSM은 text alignment와 temporal uniformity를 함께 고려합니다. 각 그룹 안에서 CLIP 점수가 가장 높은 프레임을 따로 고르는 방식과는 다릅다고 할 수 있죠
2.2 Position Context
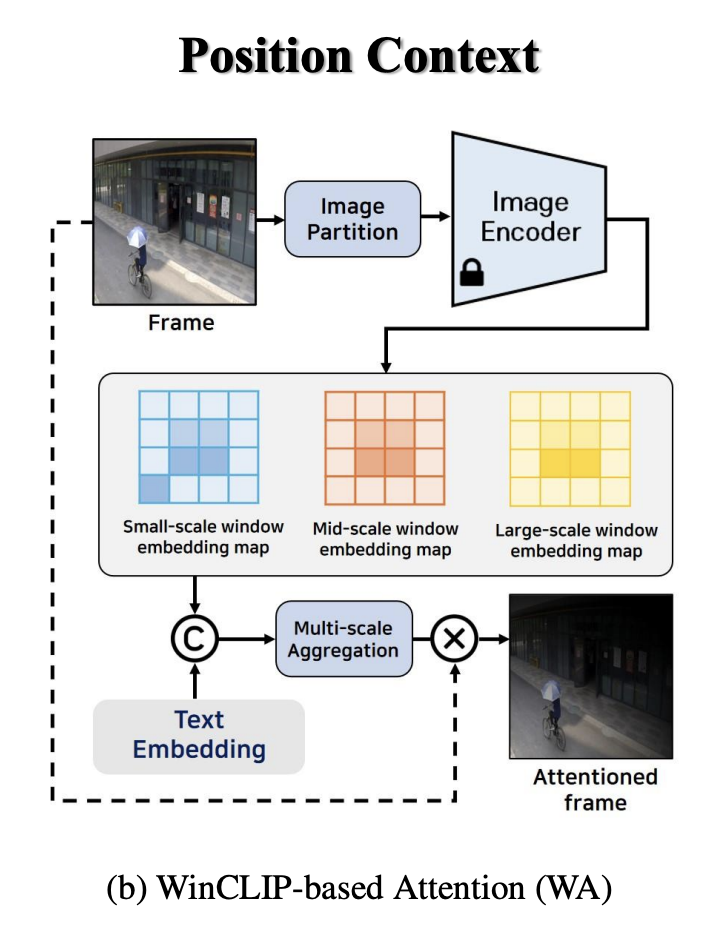
대표 프레임을 골랐더라도 작은 물체는 여전히 놓칠 수 있습니다. 화면 대부분을 사람이 차지하고 있다면, 옆에 작게 보이는 자전거가 질문의 대상인데도 모델이 사람만 설명할 수 있는 것이죠.
이를 보완하는 것이 position context(PC)입니다. 저자들은 WinCLIP-based Attention(WA)을 사용해 대표 프레임에서 텍스트와 관련 있는 영역을 강조합니다.
먼저 대표 프레임을 여러 크기의 window로 나누고, 각 window의 CLIP embedding을 구합니다. 작은 window는 작은 물체를, 큰 window는 더 넓은 영역을 살피는 데 도움을 줍니다. 이후 각 window와 텍스트의 유사도를 계산하고, 세 가지 scale의 정보를 평균해 similarity map M을 만듭니다.
이 map을 원래 이미지 해상도에 맞게 조절하고 min-max 정규화한 뒤 대표 프레임에 곱합니다.
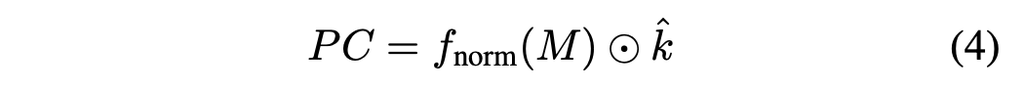
결과적으로 질문과 관련된 영역은 상대적으로 잘 보이고, 관련성이 낮은 영역은 어두워지는 이미지가 만들어집니다.
이름에 attention이 들어가지만, LVLM 내부의 attention weight를 직접 직접 수정하는 것은 아니구요. 모델에 넣기 전에 이미지의 관련 영역을 강조하는 전처리라고 보시면 되겠습니다. 또한 정답 bounding box나 별도로 학습한 detection 모델을 사용하는 것도 아닙니다!
2.3 Temporal Context
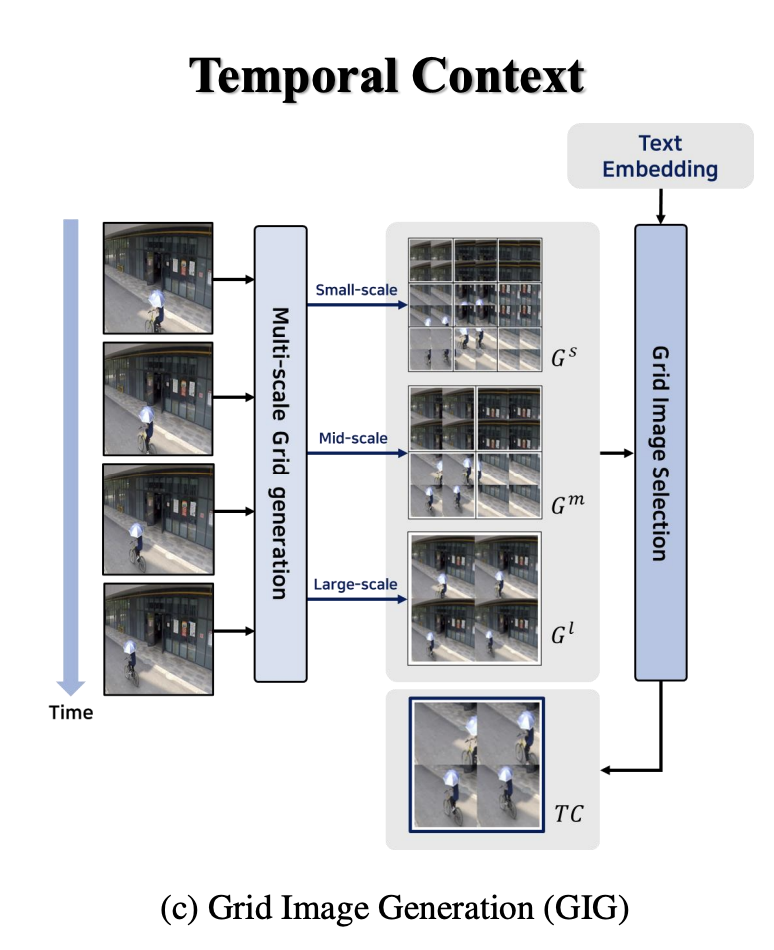
위치를 잘 찾는 것만으로 해결되지 않는 문제가 있을 수 있는데요. 사람이 서 있는 장면 한 장으로는 단순히 대기 중인지, 싸움 도중의 한 순간인지 구별하기 어려울 수 있으니까요.
그래서 두 번째로 temporal context(TC)를 만듭니다. 여기에는 Grid Image Generation(GIG)을 사용합니다.
앞서 선택한 네 개의 key frame을 같은 위치의 window들로 나눕니다. 그리고 동일한 위치에서 가져온 네 시점의 crop을 다음과 같은 $2\times2$ grid로 붙입니다.
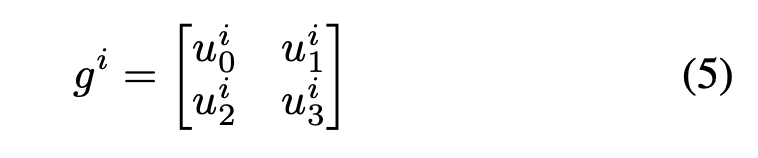
여기서 $u_j^r$는 j번째 key frame의 r번째 window입니다. 왼쪽 위에서 오른쪽 위, 왼쪽 아래, 오른쪽 아래 순서로 시간이 흐르는 것이죠.
이 작업을 작은 window, 중간 window, 큰 window에 대해 수행합니다. 만들어진 모든 grid 후보 중 CLIP 기준으로 사용자 텍스트와 가장 유사한 하나를 골라 TC로 사용합니다.
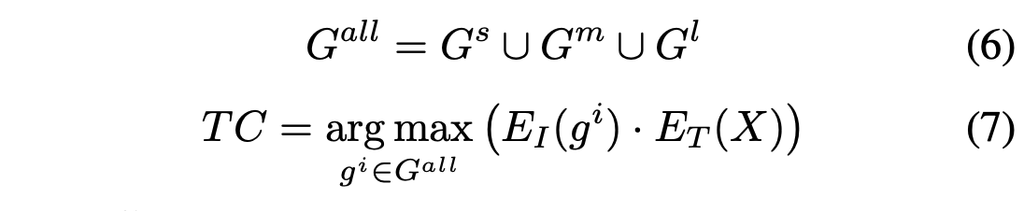
여기서 중요한 점은 네 장의 전체 프레임을 무조건 붙이는 방식이 아니라는 것입니다. 여러 공간 영역과 크기로 grid를 만들고, 질문과 관련 있는 grid를 선택합니다. 따라서 작은 영역에서 일어나는 움직임도 상대적으로 크게 보여줄 수 있습니다.
다만 여기서 알아둬야할 점이 있다면… 동일 위치의 crop을 모으는 것이지, 객체를 추적하면서 crop 위치를 따라 움직이는 방식은 아닙니다. 사람이 영역 밖으로 이동하면 일부 모습이 잘릴 수 있고, 논문에서도 이러한 cropping 문제를 언급합니다.
2.4 Anomaly Detection
이제 세 가지 이미지가 준비됐는데요. 원래 대표 프레임 $\hat{k}$, 위치를 강조한 PC, 시간적 변화를 담은 TC입니다.
논문에서 사용하는 방식은 이 이미지들을 한 번에 묶어 판단시키는 것이 아니라, 각각 LVLM에 넣고 점수를 받은 뒤 결합하는 late fusion입니다.
LVLM에 넣고 점수를 받을 때 사용되는 prompt는 3가지로 구성어있는데요. Task, Consideration, Output으로, 이미지에 사용자 텍스트 X가 얼마나 분명하게 나타나는지를 0부터 1까지 평가하도록 합니다. 화면의 주된 대상이 아니더라도 해당 사건이 존재하면 높은 점수를 주도록 하고, 짧은 이유와 소수점 한 자리의 점수를 출력하게 합니다.
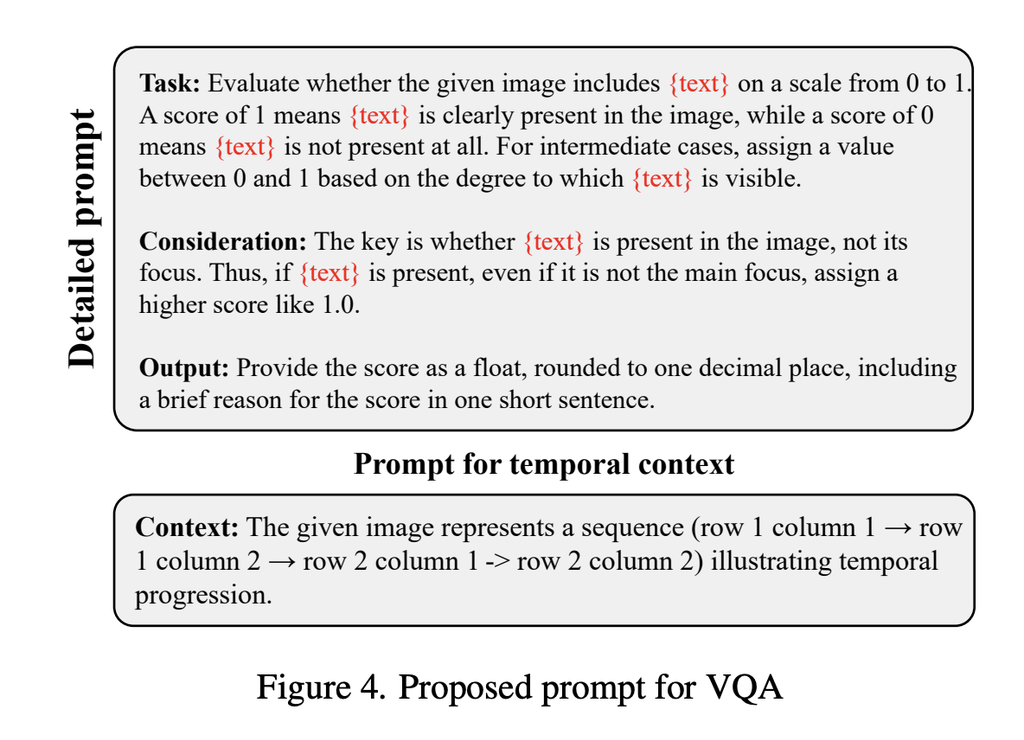
TC를 넣을 때는 추가 설명이 필요한데요. 4개의 칸이 서로 다른 장면의 모음이 아니라 시간 순서라는 점을 알려주어야하기 때문입니다. 따라서 grid를 읽는 순서를 프롬프트에 명시합니다.
세 점수의 결합은 다음과 같습니다.
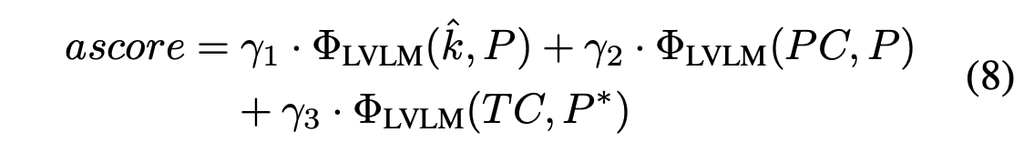
$\Phi$는 LVLM에서 얻은 점수이고, $P^*$는 시간 순서 설명이 추가된 프롬프트입니다. $\gamma_1,\gamma_2,\gamma_3$는 각 입력의 반영 비중입니다.
3. Experiments
실험은 크게 두 가지입니다. 하나는 사용자가 지정한 사건만 찾는 C-VAD이고, 다른 하나는 기존 VAD 벤치마크의 이상 구간을 찾는 평가입니다.
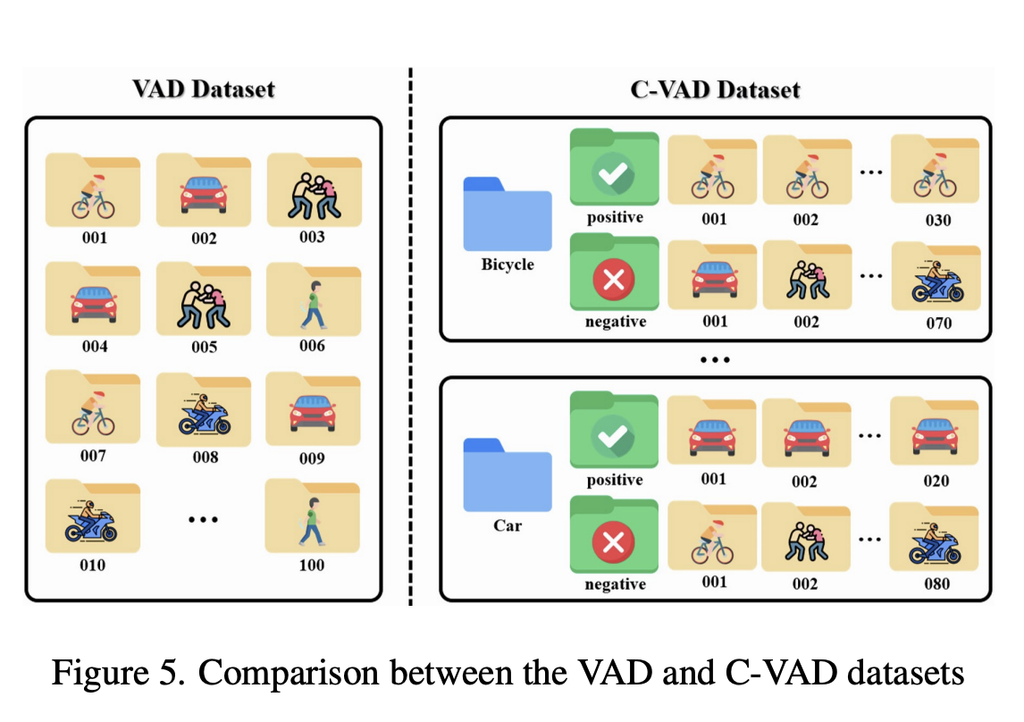
C-VAD를 어떻게 구성하였는지는 Figure 5를 보면 이해하실 수 있는데요. C-VAD를 위해 ShanghaiTech의 test set을 11개 사건으로 재구성한 C-ShT와, CUHK Avenue의 test set을 5개 사건으로 재구성한 C-Ave를 만듭니다. 새 영상을 수집한 데이터셋이라기보다는 기존 영상을 사건별로 다시 분류하고 frame-level label을 부여한 데이터셋이라고 보시면 되겠습니다.
예를 들어 자전거 category에서는 자전거가 등장하는 영상이 positive이고, 실제로 자전거가 보이는 프레임만 1로 표시합니다. 다른 이상 행동이 있더라도 자전거가 없는 영상은 negative입니다.
평가는 frame-level micro AUROC를 사용합니다. 아래 C-VAD 표의 Overall Average는 각 사건별 평가 결과를 평균한 값입니다.
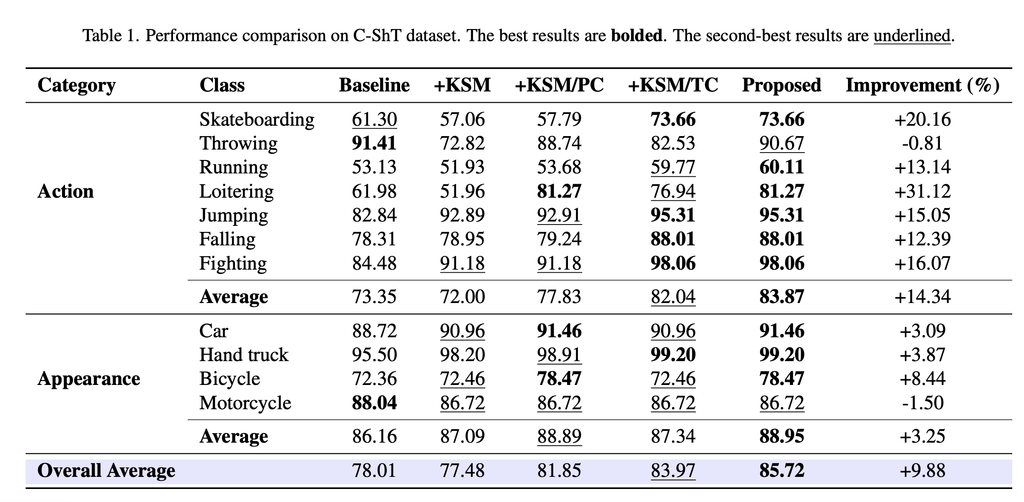
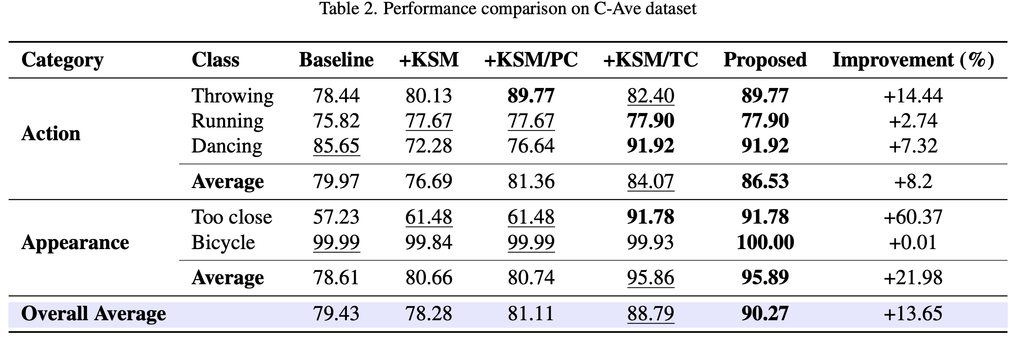
Table 1과 Table 2가 C-VAD에서의 각 데이터셋의 성능을 리포팅한 것입니다. 단순히 이미지와 prompt를 넣어 성능을 도출한 Baseline에 비해 본 방법론이 제안한 AnyAnomaly, 즉 Proposed의 경우 Baseline에 비해 성능이 매우 향상된 것을 볼 수 있습니다.
여기서 재밌는 부분은 KSM만 적용했을 때인데요. 프레임마다 질문하지 않고 대표 프레임으로 줄여도 성능이 유지가 되거나 몇몇의 경우 성능 향상을 보이기도 합니다. 하지만 그 자체로 성능이 좋아지는 것은 아닌데요. C-ShT의 throwing은 91.41에서 72.82로 떨어집니다. 대표 프레임을 고르는 것만으로 모든 행동의 단서를 보존할 수는 없다는 것이죠.
이후 context를 넣으면 결과가 달라집니다. 특히 temporal context가 C-Ave에서 큰 효과를 보이는데 시간에 따른 변화를 이미지 안에 구성해 보여주는 것이 실제 판단에 도움이 된다고 볼 수 있습니다.
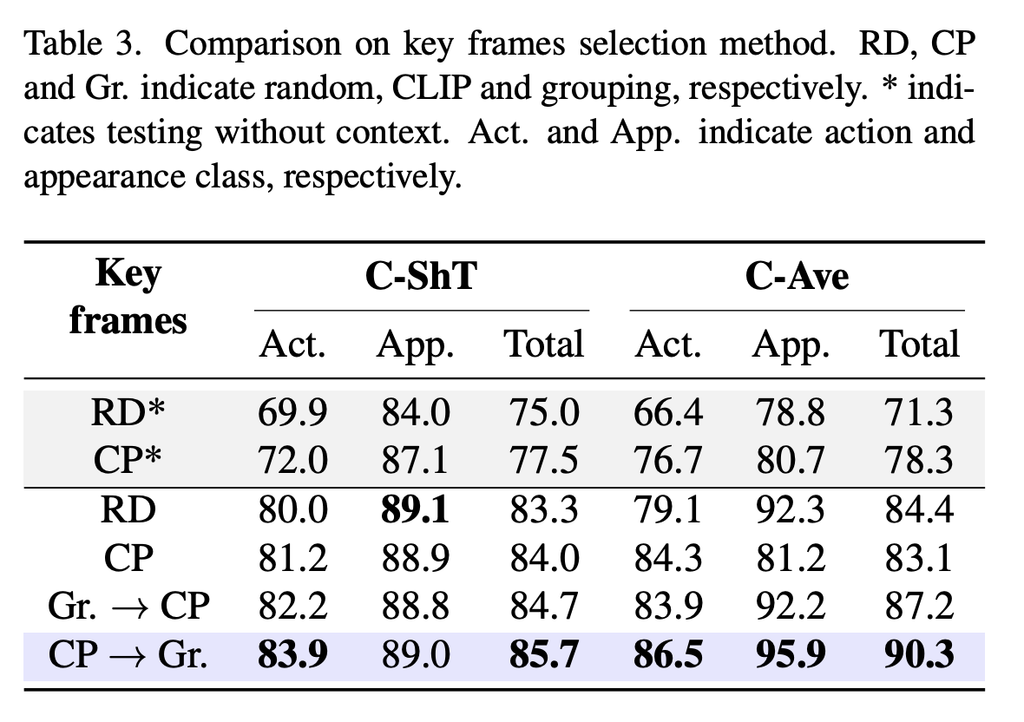
Table 3은 key frame 선택 방식을 비교합니다. context를 사용하는 조건에서 주요 결과는 다음과 같습니다.
여기서 Gr은 Grouping, CP는 CLIP의 약자로 보시면 되겠습니다. Grouping -> CLIP은 구간을 먼저 나눈 뒤 각 그룹에서 텍스트와 맞는 프레임을 고르는 방식입니다. 반면 제안 방식은 CLIP으로 대표 프레임을 먼저 정하고, 그 위치를 기준으로 나머지 프레임을 일정한 간격으로 고릅니다.
둘 다 영상의 여러 시점을 보지만, 프레임 사이의 간격까지 일정하게 유지하는 것은 후자입니다. 이 결과는 단순히 관련 있는 장면을 많이 고르는 것보다, 시간적 배치까지 함께 고려하는 편이 행동 분석에 유리하다는 것을 보여줍니다.
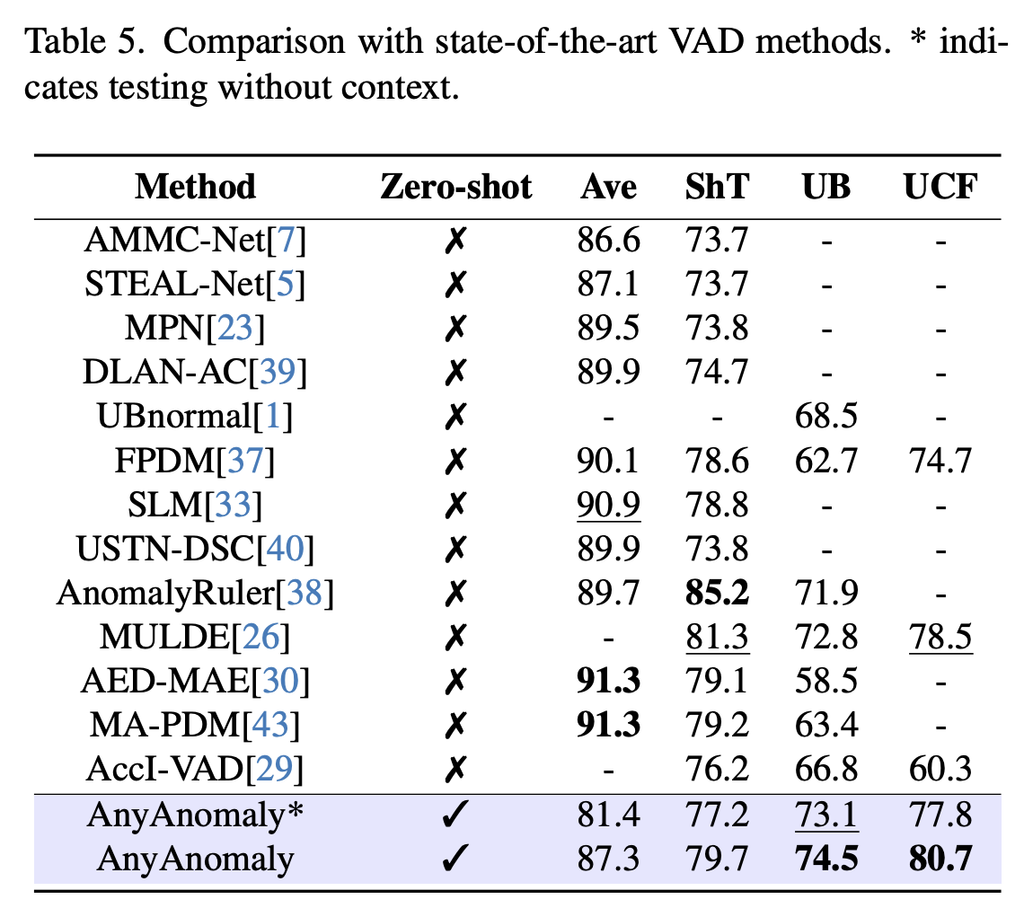
Table 5를 통해 C-VAD가 아닌 기존 VAD 데이터셋에서의 성능을 확인할 수 있습니다. 4개의 데이터셋 모두에서 context를 추가해을 때(별이 붙은 것과 아닌 것을 비교) 성능이 향상되는 것을 볼 수 있습니다. UB와 UCF에서는 SOTA를 달성한 것도 볼 수 있습니다.
지금까지 AnyAnomaly 논문을 읽어보았습니다. 한 줄로 정리하면, 무엇이 이상한지는 사용자가 정하고, 모델에는 그 사건을 판단하기 좋은 위치 정보와 시간 정보를 만들어 보여주자는 논문입니다.
LAVAD가 영상의 설명을 다듬고, EventVAD가 사건의 경계를 구성했다면, AnyAnomaly는 사용자 질문에 맞춰 볼 장면과 영역을 구성합니다. 세 방법 모두 추가 학습 없이 VAD를 풀지만, 모델에 무엇을 어떤 형태로 전달할 것인지에서 논문의 저자에 따라 서로 다르게 답하는 점이 흥미로웠습니다. 지금까지 읽어주셔서 감사합니다.


리뷰 잘 읽었습니다. 그 중 KSM에서 CLIP similarity를 기준으로 대표 프레임 하나를 먼저 선택하고, 해당 위치를 기준으로 나머지 세 프레임을 선택하는 거로 이해했는데요!
그런데 CLIP이 사용자 query와 관련된 핵심 장면을 제대로 찾지 못한다면, 이후 PC와 TC를 생성하더라도 중요한 시각 정보가 이미 누락되었을 가능성도 있을 것이라는 생각이 들어서요. 특히 짧게 발생하는 이상 행동이나 CLIP이 잘 이해하지 못하는 복잡한 행동에서는 이러한 문제가 더 클 것 같은데, 논문에서 초기 key frame selection의 정확도가 최종 탐지 성능에 얼마나 영향을 미치는지 분석 실험은 없었나요?