안녕하세요. 이번에는 10월 아카이브에 올라온 ReaLVR라는 논문을 읽어보았습니다.
제가 국내 학술대회에 제출하려고 하는 논문이 LVR 관련이고 CoT 관련한 연구 동향까지 살피고자 읽게 되었습니다.
Abstract
기존 Latent Visual Reasoning(LVR)은 reasoning 과정을 자연어 CoT로 출력하는 대신, continuous latent token 안에서 intermediate computation을 수행합니다. (제 이전 LVR 논문을 읽어보면 따라오기 쉬울 것 같습니다.)
저자들은 먼저 기존 LVR의 latent token이 정답을 바꾸는 중요한 image perturbation에도 충분히 민감하게 반응하지 않는다는 점을 확인합니다.
즉 최종 accuracy가 높더라도, intermediate latent trajectory가 실제 answer-relevant visual evidence를 안정적으로 보존한다고 보기는 어렵습니다.
저자들은 그 원인을 기존 GRPO training에서 찾습니다. (보통 LVR은 QA loss 를 학습하고 GRPO 로 추가학습하는 방식이 많습니다.)
기존 LVR은 최종 answer에 대한 reward를 받지만, 그 reward만으로는
- 어떤 latent token에 더 강한 supervision이 필요한지
- 각 latent token이 어떤 visual evidence를 보존해야 하는지
를 직접 알려줄 수 없습니다.
이를 저자들은 latent evidence-credit gap이라고 정의합니다.
이를 해결하기 위해 ReaLVR을 제안합니다.
ReaLVR은 현재 model이 실제 inference처럼 생성한 free-running latent trajectory를 직접 학습 대상으로 사용하고,
- correct answer와 model-generated wrong answer를 비교해 어디의 latent token을 더 강하게 supervise할지 결정하고
- relevant visual evidence와 mismatched evidence를 비교해 무엇을 latent token에 보존해야 하는지 결정합니다.
즉 핵심은
Answer contrast → Where to supervise
Visual contrast → What to preserve
라고 볼 수 있습니다.
실험에서는 Qwen2.5-VL, Qwen3-VL, InternVL3, Gemma-3 등 세 model family에 적용했고, Qwen3-VL-235B까지 확장해, 저자들은 continuous latent visual reasoning을 frontier-scale multimodal backbone에서도 학습할 수 있음을 보였다고 합니다.
Introduction
LVR의 가장 큰 장점은 모든 reasoning 과정을 자연어로 풀어쓸 필요 없이 continuous latent space에서 intermediate computation을 수행할 수 있다는 점입니다.
특히 spatial relationship이나 fine-grained visual detail처럼 언어로 단계별로 설명하기 어려운 문제에서 유용할 가능성이 있습니다.
하지만 latent token은 textual CoT처럼 직접 관찰할 수 없기 때문에, 단순 final-answer accuracy만으로는 latent token이 실제로 어떤 visual information을 사용하고 있는가? 를 알기 어렵습니다.
저자들은 이를 확인하기 위해 latent token의 behavior와 representation을 분석하고, 기존 LVR이 answer-relevant visual evidence를 generated latent trajectory에 충분히 보존하지 못한다는 결과를 보입니다.
문제의 핵심은 SFT와 RL/inference 사이의 supervision mismatch입니다.
기존 LVR의 SFT stage에서는 latent visual state가 target visual feature를 따라가도록 직접 supervision을 받을 수 있습니다.
하지만 RL이나 inference 단계에서는 model이 이러한 target 없이 스스로 latent token을 autoregressive하게 생성합니다.
즉 실제 inference에서 사용하는 것은 free-running latent trajectory입니다.
그런데 standard GRPO는 이 generated latent trajectory 자체를 직접 supervise하지 않고, 최종적으로 생성되는 text answer에만 reward를 제공합니다. 따라서 final answer가 맞거나 틀렸다는 정보는 알 수 있어도,
어떤 latent position에서 visual evidence를 놓쳤는지, 혹은 어떤 image region을 더 강하게 보존해야 하는지는 알 수 없습니다. 저자들은 이러한 문제를 앞서 말했듯 latent evidence-credit gap이라고 부릅니다.
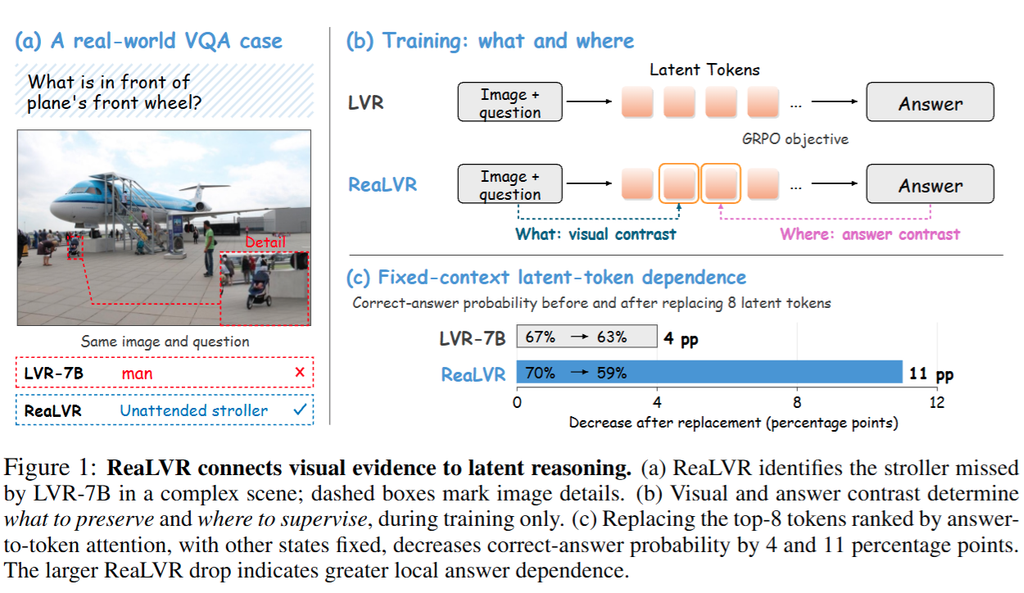
Figure 1은 이 문제와 ReaLVR의 아이디어를 보여줍니다.
기존 LVR에서는 질문에 필요한 visual detail을 놓쳐 잘못된 answer를 생성하는 반면, ReaLVR은 visual evidence를 latent trajectory에 더 강하게 연결합니다.
Training에서는 두 가지 contrast를 사용합니다.
먼저 answer contrast입니다. Ground-truth answer와 behavior policy에서 생성된 wrong answer가 각각 어떤 latent token을 중요하게 사용하는지 비교해, supervision이 더 필요한 latent position을 찾습니다.
다음은 visual contrast입니다. Relevant visual evidence와 mismatched evidence를 비교해, 해당 latent token이 어떤 visual information을 보존해야 하는지를 학습합니다.
즉 ReaLVR은 latent token 전체를 동일하게 supervise하는 것이 아니라, 어디를 더 강하게 supervise할지와 무엇을 보존해야 하는지를 분리해서 결정합니다.
추가 supervision은 training 단계에서만 사용되며, inference에서는 기존 LVR과 동일하게 latent token을 생성한 뒤 answer를 출력합게 됩니다.
Two-Stage LVR Training
기존 LVR training은 크게 두 stage로 구성됩니다.
Stage 1: Visual Supervision
Stage 1에서는 ROI annotation으로부터 얻은 visual feature를 latent target으로 사용합니다.
이때 중요한 점은 model이 생성한 이전 latent token을 다음 step에 다시 입력하는 것이 아니라, ground-truth visual embedding을 teacher forcing으로 latent span에 직접 넣어준다는 것입니다.
그리고 decoder hidden state가 target visual feature를 복원하도록 reconstruction loss를 적용합니다.
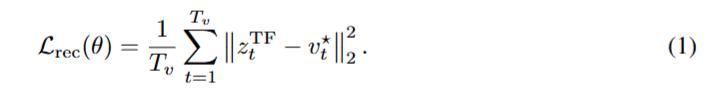
즉 이 단계에서는 latent token이 실제 visual feature를 담도록 직접 supervision을 받을 수 있습니다.
하지만 이것은 inference에서 사용하는 free-running trajectory와는 다릅니다.
Stage 2: GRPO
Stage 2에서는 model이 실제 inference처럼 latent token을 스스로 생성합니다.
각 prompt에 대해 여러 rollout을 만들고, 최종 answer correctness와 output format을 reward로 사용해 GRPO를 수행합니다.
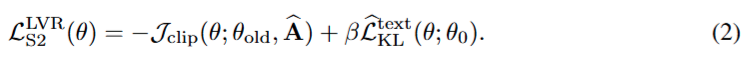
여기서 ReaLVR이 지적하는 핵심적인 문제가 발생합니다.
GRPO update 과정에서는 이미 생성된 latent vectors를 fixed context처럼 취급합니다.
즉 rollout 당시 생성된 latent token을 다시 입력으로 사용하지만,
“그 latent token이 어떻게 생성되었는가”까지 gradient를 역전파하지 않습니다.
따라서 Stage 2에서는 answer text에는 policy-gradient signal이 들어가지만, free-running latent trajectory 자체에는 visual grounding을 위한 직접적인 supervision이 들어가지 않습니다.
ReaLVR: Outcome-Contrastive Evidence Credit
ReaLVR의 핵심은 현재 model이 실제로 생성한 latent trajectory 자체에 visual evidence supervision을 걸어주는 것입니다. 기존 architecture나 inference procedure를 바꾸는 것이 아니라, Stage 2 training objective에 추가적인 supervision을 넣습니다.
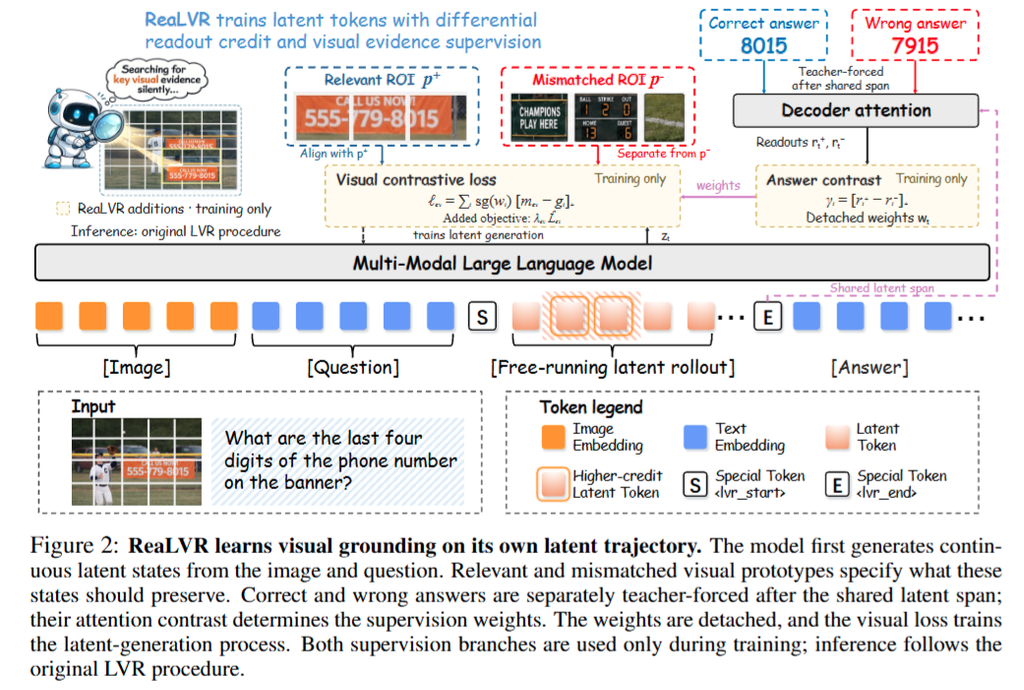
전체적으로 두 가지 정보를 이용합니다.
Answer contrast는 어떤 latent position을 더 강하게 supervise할지 결정하고,
Visual contrast는 해당 latent token이 어떤 visual information을 보존해야 하는지를 결정합니다.
Supervise the Model’s Own Latent Trajectory
먼저 ReaLVR은 기존 GRPO rollout에서 저장된 latent vector를 그대로 사용하는 대신, 현재 model로 latent trajectory를 다시 생성합니다.
즉 이전 latent state를 다음 step의 입력으로 다시 넣으면서
z1 → z2 → … → zK
를 현재 policy로 실제 inference와 동일하게 생성합니다. 그리고 이 recurrent latent-generation 과정 전체에 gradient를 유지합니다.
기존 Stage 2에서는
Generated latent
→ fixed context
→ Answer RL
이었다면,
ReaLVR에서는 추가로
Generated latent
→ Visual evidence loss
→ latent generation 과정까지 backpropagation
이 가능해집니다.
저자들은 이를 on-policy distillation의 관점에서 설명합니다.
즉 teacher-forced 상태에만 supervision을 주는 것이 아니라, 실제 learner가 만들어내는 trajectory 위에서 직접 supervision을 제공하는 것입니다.
Answer Contrast: 어디를 supervise할 것인가
모든 latent position을 동일하게 강하게 supervise할 필요는 없습니다.
ReaLVR은 ground-truth correct answer와 behavior policy가 생성한 wrong answer를 각각 latent trajectory 뒤에 teacher forcing하고, 두 answer가 각 latent token을 얼마나 사용하는지 비교합니다.
Correct answer가 wrong answer보다 특정 latent token에 더 강하게 의존한다면, 해당 token은 정답을 만드는 데 중요한 position으로 볼 수 있습니다. 이를 바탕으로 각 latent position에 supervision weight wt를 부여합니다.
즉 answer contrast는 “어떤 latent token이 정답과 오답을 구분하는 데 중요한가?” 를 찾는 역할을 합니다.
이 weight는 supervision을 어디에 집중할지를 결정하는 용도로만 사용하며, optimization 과정에서는 detach합니다.
따라서 model이 loss를 줄이기 위해 단순히 weight 자체를 낮추는 shortcut을 사용할 수 없습니다.
Visual Contrast: 무엇을 보존할 것인가
다음으로 각 latent token이 어떤 visual evidence를 담아야 하는지를 결정합니다.
이를 위해 question과 관련된 relevant visual evidence와, 그렇지 않은 mismatched visual evidence를 비교합니다.
Latent representation이 relevant visual prototype과는 가까워지고, mismatched prototype과는 충분히 멀어지도록 margin-based contrastive objective를 적용합니다.
즉 단순히 latent ≈ visual feature 를 학습하는 것이 아니라, latent가 정답에 필요한 visual evidence를 선택적으로 보존하도록 학습합니다.
Evidence Loss
최종 evidence loss는 각 latent token의 visual contrastive margin에 앞서 계산한 supervision weight를 적용하는 형태입니다.
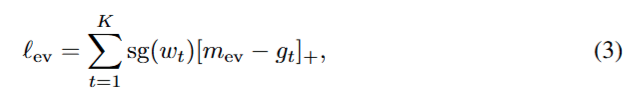
정답과 오답을 비교해 중요한 latent position에는 더 큰 weight를 주고,
그 위치에서 relevant visual evidence와 mismatched evidence를 잘 구분하도록 학습합니다.
그리고 기존 Stage 2 GRPO objective에 이 evidence loss를 추가합니다.
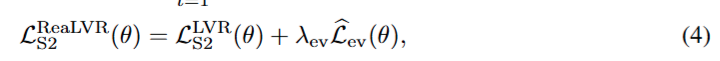
Inference에서는 별도의 ROI annotation이나 correct/wrong answer 비교가 필요하지 않고, 기존 LVR과 동일하게 K개의 latent token을 생성한 뒤 answer를 출력합니다.
Experiments
Experimental Setup
ReaLVR은 visual discrimination, spatial reasoning, high-resolution perception을 포함하는 5개 benchmark에서 평가합니다.
- MMVP
- BLINK
- HRBench-4K
- HRBench-8K
- MME-RealWorld
Backbone은 Qwen2.5-VL, Qwen3-VL, InternVL3, Gemma-3까지 총 6개를 사용하며, model size는 7B부터 Qwen3-VL-235B까지 포함합니다.
비교 대상은 non-latent visual reasoning 방법인 Pixel Reasoner, Vision-R1과, latent reasoning 계열인 LVR, ILVR, Monet입니다.
Main Results
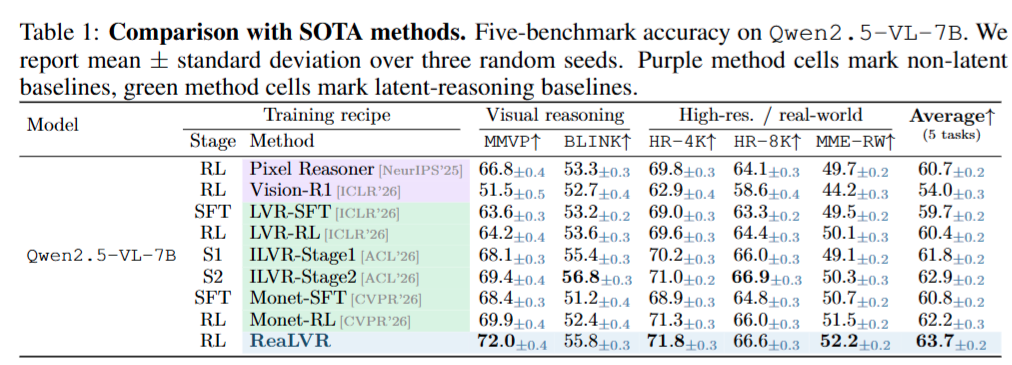
Qwen2.5-VL-7B에서 ReaLVR은 5개 benchmark 평균 63.7%로 가장 높은 성능을 기록합니다.
특히 LVR-SFT 대비 모든 benchmark에서 향상되며, MMVP에서 +8.4%p로 가장 큰 차이를 보입니다.
이는 ReaLVR의 visual evidence supervision이 단순 평균 성능뿐 아니라 subtle visual discrimination에서도 효과가 있음을 보여줍니다.
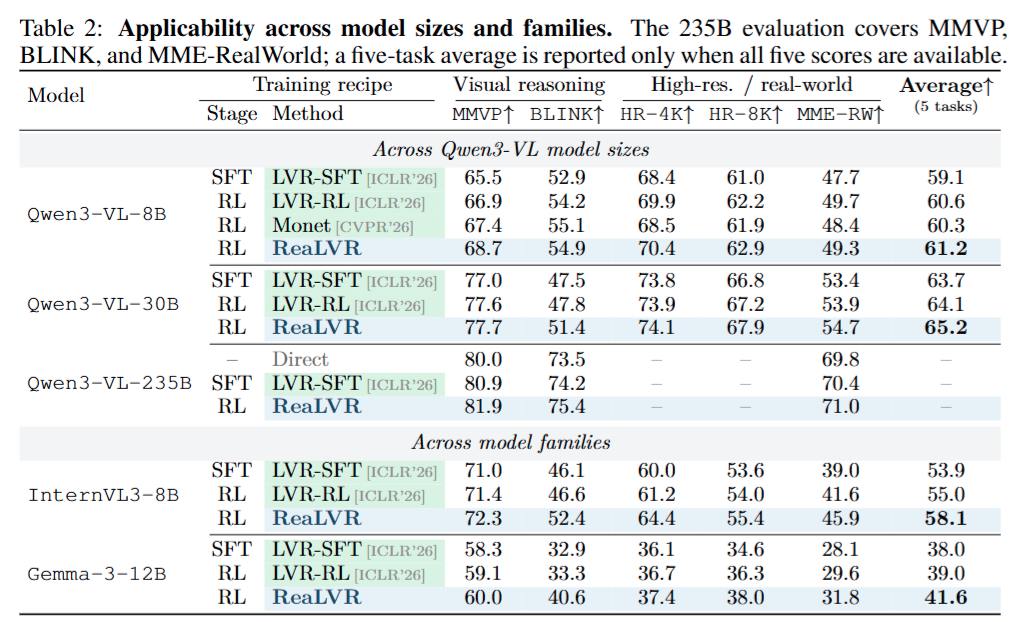
같은 objective를 다른 backbone과 scale에도 적용합니다.
또한 Qwen3-VL-235B에서도 MMVP, BLINK, MME-RealWorld 세 benchmark 모두 LVR-SFT보다 높은 성능을 보입니다.
InternVL3-8B와 Gemma-3-12B에서도 각각 LVR-RL 대비 +3.1%p, +2.6%p 향상되어, 특정 architecture나 vision encoder에만 의존하는 방법은 아니라는 점을 보여줍니다.
저자들은 이를 통해 latent visual reasoning을 235B scale까지 확장한 첫 사례라고 주장합니다. (GPU 를 많이 쓸 수 있는 연구실이기에 가능한 것 같지만)
Mechanism Analysis
성능 향상보다 더 중요한 부분은 ReaLVR의 latent token이 실제로 어떻게 달라졌는지를 분석하는 실험입니다.
Visual Evidence Readout
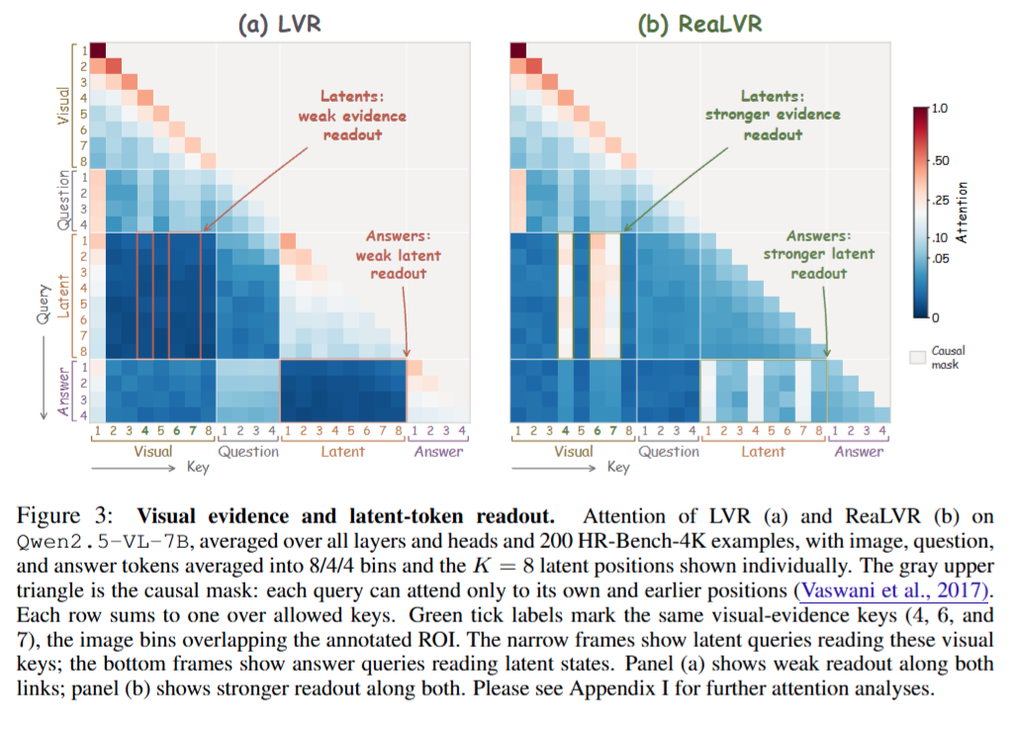
Figure 3에서는 latent token이 image evidence를 얼마나 읽는지, 그리고 answer token이 latent token을 얼마나 읽는지를 attention으로 분석합니다.
기존 LVR에서는
Visual → Latent
Latent → Answer
두 연결 모두 비교적 약하게 나타납니다.
반면 ReaLVR에서는 latent query가 annotated visual evidence에 더 강하게 attend하고, answer token 역시 latent state를 더 많이 참조합니다.
즉 ReaLVR이 단순히 latent representation을 바꾸는 데 그치지 않고,
visual evidence → latent → answer
경로를 더 강하게 형성하는 모습을 보입니다.
Counterfactual Visual Sensitivity
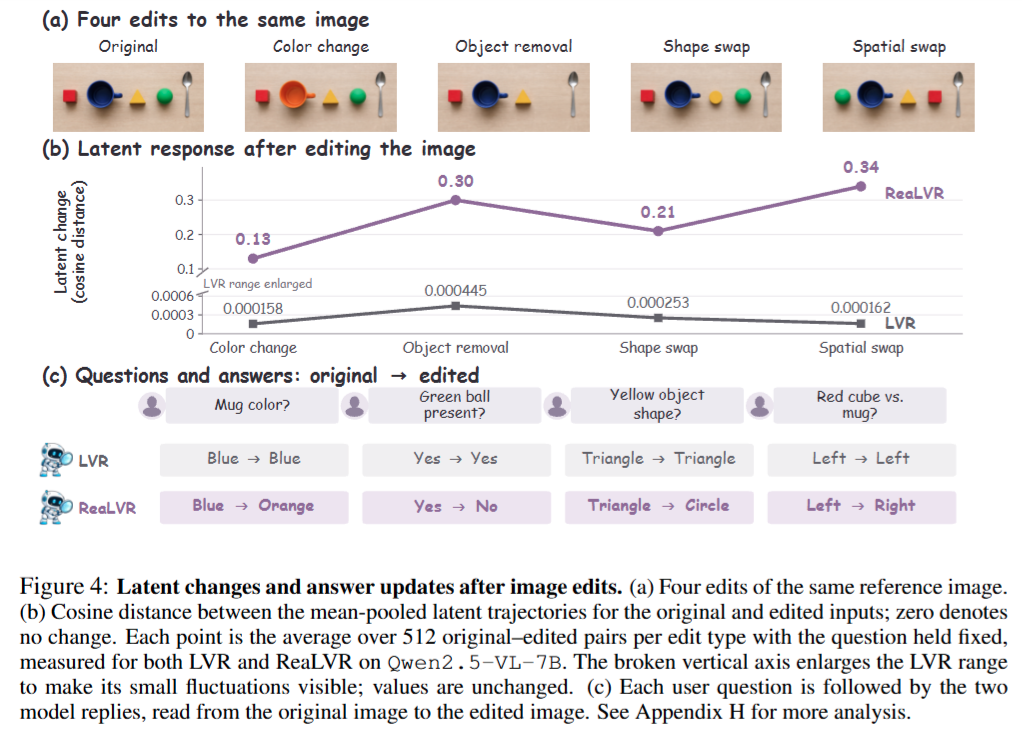
같은 scene에서
- object color 변경
- object 제거
- shape 변경
- spatial relation 변경
처럼 정답에 직접 영향을 주는 visual evidence만 수정한 실험입니다.
Ground-truth answer는 약 81~86%의 sample에서 바뀌지만, 기존 LVR은 prediction을 실제로 바꾸는 비율이 5.66~13.09%밖에 되지 않습니다.
즉 image의 결정적인 evidence가 바뀌었는데도 latent reasoning이 거의 반응하지 않는 경우가 많습니다. Latent representation 자체의 변화도 매우 작습니다.
Original image와 edited image 사이의 mean-pooled latent cosine distance가 기존 LVR에서는 0.0005 이하인 반면,
ReaLVR에서는 0.13~0.34까지 증가합니다. (해당 cosine distance 변화는 다른 논문에서도 지적하는 LVR의 문제점입니다.)
즉 ReaLVR의 latent trajectory는 answer-relevant visual change에 훨씬 민감하게 반응합니다.
Figure 4의 예시에서도 기존 LVR은 mug color, object presence, shape, left-right relation이 바뀌었는데도 기존 answer를 그대로 유지하지만, ReaLVR은 변경된 evidence에 맞게 answer를 수정하는 것을 확인할 수 있습니다.
Position-Specific Latent Variation
ReaLVR에서는 모든 latent position이 동일하게 변하는 것이 아니라, 일부 token position에서 변화가 더 크게 집중됩니다.
이는 ReaLVR이 answer contrast를 통해 latent position별로 서로 다른 supervision weight를 주는 설계와 일치합니다. 즉 latent span 전체가 균일하게 visual representation을 복사하는 것이 아니라, 일부 latent token이 질문에 따라 더 선택적으로 변하는 구조를 형성합니다.
Spatial Grounding
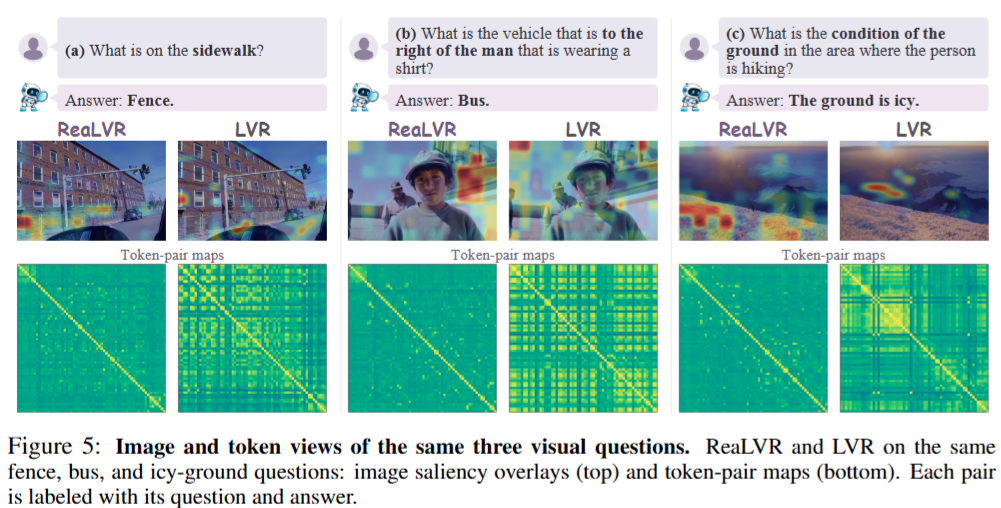
Figure 5에서는 fence, bus, icy ground와 같은 실제 visual question에서 ReaLVR과 LVR의 saliency를 비교합니다.
기존 LVR은 attention이 image 전체에 비교적 diffuse하게 퍼지는 반면, ReaLVR은 질문에 필요한 object나 region에 더 집중하는 경향을 보입니다.
다만 저자들도 correct / incorrect ReaLVR response가 비슷한 alignment curve를 보인다고 언급합니다.
따라서 visual grounding이 강해졌다는 사실 자체가 정답을 보장하는 것은 아닙니다.
Latent Tokens Are Not Verbal Reasoning
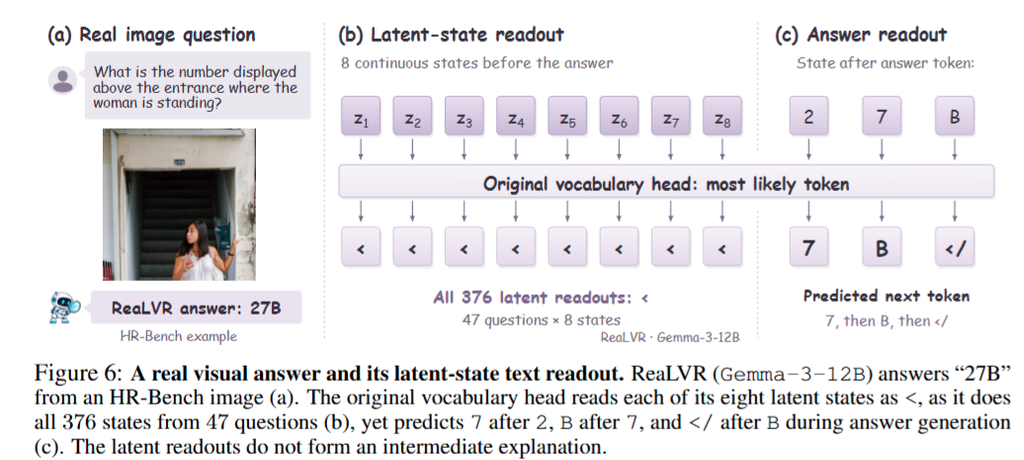
또 하나 흥미로운 분석은 latent token을 vocabulary head로 직접 읽어보는 실험입니다. LVR에서 제안한 방법이긴한데, Gemma-3-12B에서 47개 question × 8 latent token, 총 376개의 latent state를 vocabulary head에 넣었을 때, 모든 token의 top-1 prediction이 < 로 나타납니다.
즉 latent token을 vocabulary space에서 해석한다고 해서 자연어 reasoning trace가 나타나지는 않습니다.
저자들은 이것이 latent span 뒤에 항상 등장하는 <lvr_end> marker의 prior 때문이라고 설명합니다. 하지만 latent state가 아무 정보도 담고 있지 않은 것은 아닙니다. (다른 LVR 논문도 해당 marker 문제를 다루긴 합니다.)
Mean latent representation에 linear probe를 적용하면 BLINK task label을 99.9% accuracy로 복원할 수 있습니다. 즉 latent token은 자연어 sentence처럼 읽히지는 않지만, task-relevant information은 충분히 포함하고 있습니다.
Does the Answer Actually Use the Latents?
마지막으로 latent token이 실제 answer에 영향을 주는지를 fixed-context replacement로 확인합니다. Answer가 가장 많이 attend하는 latent token 8개를 다른 state로 교체하고 나머지 context는 그대로 유지합니다.
그 결과 ReaLVR의 correct-answer probability가 0.70 → 0.59 로 11%p 감소합니다.
기존 LVR의 감소폭은 Figure 1 기준 약 4%p입니다.
즉 ReaLVR에서는 answer가 특정 latent token에 더 강하게 의존하고 있음을 보여줍니다.
전체적으로 ReaLVR의 실험은 단순히 accuracy가 향상되었다는 것보다,
- visual evidence가 바뀌면 latent도 더 크게 변하고
- 질문에 따라 특정 latent position이 선택적으로 변화하며
- relevant image region을 더 강하게 attend하고
- answer가 실제로 해당 latent token에 더 의존한다
는 점을 함께 보여주는 데 초점을 둡니다.
감사합니다.


리뷰 잘 읽었습니다. 제가 이해한 바에 따르면 ReaLVR에서 실제 free-running latent trajectory에 직접 supervision을 적용하는 것 같았는데요.
그런데 기존 LVR과 비교하면 두 가지 변화가 동시에 발생하는 것으로 같습니다. 하나는 generated latent trajectory 전체에 gradient를 전달하도록 만든 것이고, 다른 하나는 Answer/Visual Contrast 기반의 evidence loss를 추가?
그렇다면 성능 향상이 단순히 free-running latent에 직접 supervision을 제공한 효과인지, 아니면 제안한 contrastive objective가 추가적인 이점을 제공한 것인지 궁금합니다. 그러니까 논문에서 두 요소의 영향을 분리해서 본 ablation이 있었나요?