안녕하세요 손우진입니다.
이번에 리뷰할 논문은 FLOW-JEPA: Flow Matching for Robust Latent Dynamics in JEPA World Models입니다. 이전에 I-JEPA를 읽으면서 픽셀을 직접 복원하지 않고 representation을 예측한다는 방향이 흥미로웠는데요. 이번에는 그 아이디어를 로봇의 행동 이후 상태를 예측하는 world model에 적용한 논문을 읽어보았습니다. 특히 기존의 autoregressive prediction을 flow matching으로 바꾸면 visual noise에 더 강해진다는 주장이 궁금했습니다. 이번에 읽은 버전은 ICLR 2027을 목표로 한 논문이고 가볍게 한번 읽어보았습니다. 그럼 리뷰 시작하겠습니다.
Introduction
World model이라는 것은 현재 상태에서 어떤 행동을 했을 때 앞으로 환경이 어떻게 변할지를 예측하는 모델인데요. 이를 통해 실제로 모든 행동을 실행해보지 않고도, 모델 안에서 여러 행동의 결과를 비교하며 계획을 세울 수 있습니다. 그런데 미래 이미지를 픽셀 단위로 생성하려면 배경이나 조명처럼 실제 행동에는 크게 중요하지 않은 정보까지 복원해야 합니다. JEPA 계열은 이러한 부담을 줄이기 위해 이미지 자체가 아닌 latent representation을 예측합니다. (이렇듯 요즘 연구는 표현공간에서 예측을하거나 정렬을 하는 추세로 많이 가고있는 것 같습니다…)
이 논문의 base는 재찬님이 세미나에서도 해주셨고 x-review로도 작성해주신 LeWorldModel입니다. LeWM은 관측 이미지를 encoder로 압축하고 현재 latent와 action을 받아 다음 latent를 예측합니다. 여러 시점의 미래가 필요하면 예측한 latent를 다시 입력으로 넣어 다음 상태를 예측하는 autoregressive 방식을 사용합니다.
저자들은 이 과정에 두 가지 문제가 있다고 지적합니다. 첫째는 앞에서 발생한 예측 오차가 다음 예측으로 전달되면서 누적될 수 있다는 점입니다(전형적인 autoregressive 방법들의 단점이기도 하죠) 둘째는 깨끗한 학습 데이터의 target embedding을 맞추는 것만으로는 관측 이미지에 noise가 들어와 latent가 조금 달라졌을 때도 안정적으로 예측한다는 보장이 없다는 점입니다. 픽셀 복원을 하지 않는다고 해서 배경 변화에 자동으로 강해지는 것은 아니라는 주장하는 걸로 이해를 했습니다.
그래서 저자들은 미래 latent를 한 시점씩 예측하는 대신에 현재 상태와 action sequence를 조건으로 미래 latent trajectory 전체를 flow matching으로 생성하는 F-JEPA를 제안합니다. Gaussian noise에서 시작해 미래 표현으로 이동하는 과정을 학습하면 여러 중간 상태에서 dynamics를 학습하게 되므로 노이즈에도 안정적일 수 있다는 것이 저자들의 가정입니다.
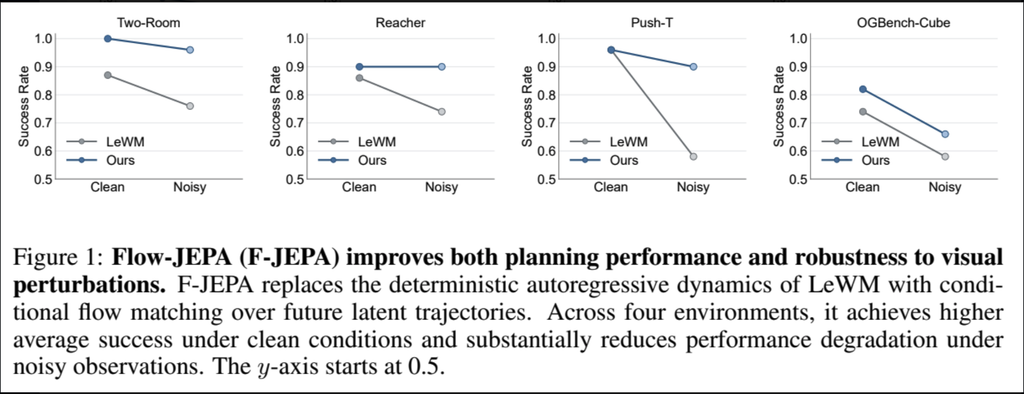
Figure 1은 이 논문의 주장을 먼저 보여줍니다. Clean observation에서도 성능을 유지하거나 개선하면서, 배경에 noise가 들어갔을 때 LeWM보다 성공률이 적게 떨어집니다.
저자들의 contribution을 정리하면 다음과 같습니다.
- 기존 LeWM의 visual perturbation에 대한 취약성을 확인했습니다. 실제 환경의 dynamics가 바뀌지 않아도 task와 무관한 배경 noise만으로 planning 성능이 크게 떨어질 수 있음을 실험적으로 보여줍니다.
- 미래 latent trajectory 전체를 conditional flow matching으로 예측하는 F-JEPA를 제안했습니다. 기존의 deterministic autoregressive transition을 현재 상태와 action sequence에 조건화된 trajectory 단위 예측으로 대체합니다.
- Clean condition의 평균 planning 성능을 높이면서 noisy condition에서의 성능 저하를 줄였습니다. 네 가지 control 환경에서 LeWM 대비 평균 성공률이 clean에서는 86%에서 92%로, noisy에서는 67%에서 86%로 개선됩니다.
Method
Future latent trajectory prediction
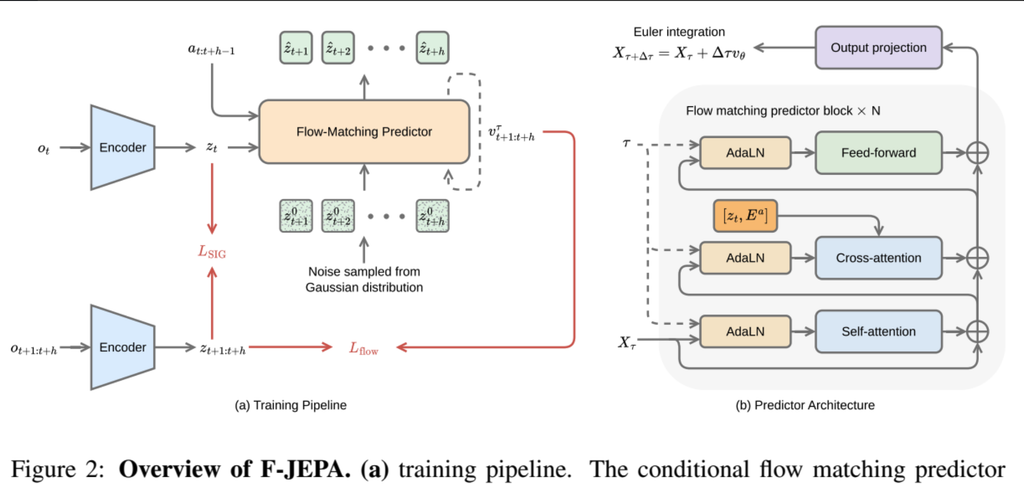
전체 구조는 Figure 2에 정리되어 있습니다. 먼저 observation을 ViT에 넣고, [CLS] token을 MLP로 projection하여 현재 latent를 얻습니다. Action도 별도의 encoder로 embedding합니다. 이때 이미지 한 장을 여러 개의 spatial token으로 유지하는 것이 아니라, projection된 하나의 latent vector로 표현합니다. 논문에서 visual latent와 action embedding의 차원은 모두 192입니다.
학습 데이터에는 현재 관측과 이후 5개 시점의 관측 그리고 그 사이의 action이 들어 있습니다. 미래 관측들도 같은 visual encoder를 통과시켜 target latent sequence로 만듭니다. LeWM이라면 현재 latent에서 다음 latent를 예측한 후, 그 예측을 다시 사용해 두 번째 미래를 예측합니다. 반면 F-JEPA는 5개의 미래 latent를 하나의 trajectory로 묶어 다룹니다. 한 번의 flow update에서 모든 미래 위치를 함께 예측한다는 것이 핵심적인 차이입니다. 다만 이것이 모델을 한 번만 실행하면 미래표현이 만들어지는것이아니라. 미래 시간축을 따라 순차적으로 예측하는 대신 flow time을 따라 trajectory 전체를 여러 번 수정합니다.
Conditional flow matching
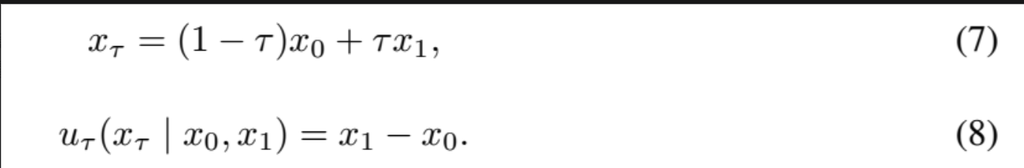
Flow matching은 noise에서 출발한 sample을 데이터 분포로 이동시키는 vector field를 학습하는 방법입니다. flow matching에 대해서 저도 수학적으로 자세하게 공부해본적은 없지만 얼핏 어깨너머 공부해본 바로 설명을 드리자면.. 이 논문에서는 이미지가 아니라 미래 latent sequence가 이동의 대상입니다.
위 수식에서 x₀는 출발점인 Gaussian sample x₁은 실제 데이터이며 τ는 둘 사이에서 어느 위치에 있는지를 나타내는 flow time입니다. τ가 0이면 noise이고, 1이면 실제 데이터입니다. 학습할 때는 그 사이의 τ를 무작위로 뽑고, 해당 중간 상태에서 어느 방향으로 움직여야 하는지를 예측합니다. 직선 경로를 사용하기 때문에 target velocity는 x₁− x₀가 됩니다.
F-JEPA에서는 이 과정을 미래 latent trajectory 전체에 적용합니다. 먼저 학습 데이터에는 현재 observation뿐 아니라 주어진 action들을 실제로 수행한 뒤의 미래 observation들도 들어 있습니다. 이 미래 이미지들을 encoder에 통과시키면 모델이 예측해야 할 정답 latent sequence인 Z를 얻습니다. 예를 들어 앞으로 다섯 시점을 예측한다면 Z는 그 다섯 시점의 표현을 순서대로 묶은 것입니다. 여기에 Gaussian sample Z₀를 준비합니다 학습에서는 Z₀와 Z를 섞어 중간 상태 Xτ를 만듭니다. Noise의 비중이 크면 정답과 거리가 먼 상태이고 실제 미래 latent의 비중이 크면 정답에 가까운 상태가 됩니다. 모델이 학습하는 것은 다양한 중간 상태에서 미래 trajectory를 어느 방향으로, 얼마나 변화시켜야 하는가를 배우게 됩니다. 완성된 미래만 바로 맞추는 것 보다는 출발점에서 미래 표현으로 이동하는 과정의 여러 위치에서 수정 방향을 배우는 것입니다. 이게 대략 flow matching이라고 생가해주시면 될 것 같습니다(?)
여기서 입력들의 역할을 구분하면 이해하기 쉬울거 같은데. Xτ는 모델이 수정해야 할 대상이고, 현재 latent와 action sequence는 그 수정을 안내하는 조건입니다. 예를 들어 현재 로봇과 물체의 배치가 같아도 왼쪽으로 미는 행동과 오른쪽으로 미는 행동의 미래는 달라져야 하니 모델은 중간 trajectory만 보고 움직이는 것이 아니라 현재 상태에서 어떤 행동을 한다고 가정했는지를 함께 보고 velocity를 예측합니다.
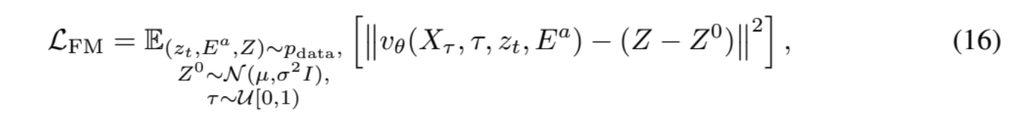
위 loss는 모델이 예측한 velocity를 Z−Z₀에 맞춥니다. Z−Z₀는 source에서 실제 미래 trajectory까지 향하는 직선 경로의 방향과 이동량입니다. 학습 때는 출발점과 정답을 모두 알고 있어서 이 경로의 중간 상태와 그곳에서 따라야 할 velocity를 직접 만들 수 있습니다. 그렇게 하면서 현재 상태와 행동에 맞는 미래 표현 쪽으로 trajectory를 이동시키는 것을 배우게 됩니다. Inference에서는 실제 미래 Z를 모르기 때문에 정답과 noise를 섞어 중간 상태를 만들 수 없습니다. 대신 가우신안 분포로 시작해 현재 observation과 후보 action sequence를 조건으로 모델이 예측한 velocity를 따라 trajectory를 갱신합니다. 바뀐 trajectory에서 다시 velocity를 구하고 이동하는 과정을 거쳐 최종 미래 latent sequence를 얻습니다. 앞 시점의 예측을 다음 시점의 입력으로 넘기는 LeWM과 달리 이 과정에서는 미래 trajectory 전체를 함께 갱신합니다.
여기에 LeWM에서 사용하던 SIGReg를 유지하는데요 SIGReg는 lewm에서 제안한 규제화?같은 항입니다. 예측 대상인 latent는 사람이 정해놓은 정답이 아니라 encoder가 이미지로부터 만든 표현입니다. 그래서 Encoder를 함께 학습할 때 모든 이미지를 같은 vector로 보내버리면 representation collapse가 생기기 때문에 만든 항입니다.

전체 loss는 이 두 역할을 결합한 것입니다.
Predictor architecture
Figure 2(b)의 predictor는 Transformer 기반입니다. 처리 대상은 현재 flow 단계의 future latent token들이고, 각 token에는 어느 미래 시점인지를 알려주는 temporal position embedding이 붙습니다. Flow time은 sinusoidal embedding을 거쳐 AdaLN으로 각 Transformer block에 전달됩니다.
가우시안 소스도 환경에 따라 표준 가우시안을 쓰거나 현재 latent를 중심으로 샘플링합니다. 세부 설정에는 차이가 있지만, 공통적으로 모델이 출력하는 것은 action이 아니라 미래 latent trajectory를 수정할 velocity라는 점이 중요합니다.
Planning with CEM
그렇다면 실제로 어떤 action을 실행할지는 누가 정할까요. 여기서는 CEM(Cross-Entropy Method)이 후보 action sequence를 만들고 F-JEPA가 각 후보의 미래를 예측합니다. Action을 선택하는 planner와 결과를 예측하는 world model의 역할이 나뉘어 있습니다.
CEM은 한 iteration마다 5개 action block으로 이루어진 후보 sequence를 300개 뽑습니다. 각 후보의 미래를 F-JEPA로 예측하고 마지막 predicted latent로 planning cost를 계산합니다. 이후 좋은 후보 30개를 골라 sampling distribution을 갱신하고 다시 탐색합니다. 선택한 5-block sequence를 실제로 실행한 뒤에는 새 observation에서 planning을 반복합니다.
처음 읽을 때는 모델이 action까지 생성하는 것으로 이해하면서 봤는데 F-JEPA가 하는것은 이 action들을 수행하면 어떤 미래가 나오는”입니다. 따라서 미래를 잘 예측하더라도 CEM이 좋은 행동을 충분히 탐색하지 못하면 실패할 수 있습니다. 이 부분은 world model의 예측 능력과는 별도로 생각해야 할 것 같습니다.
Experiments
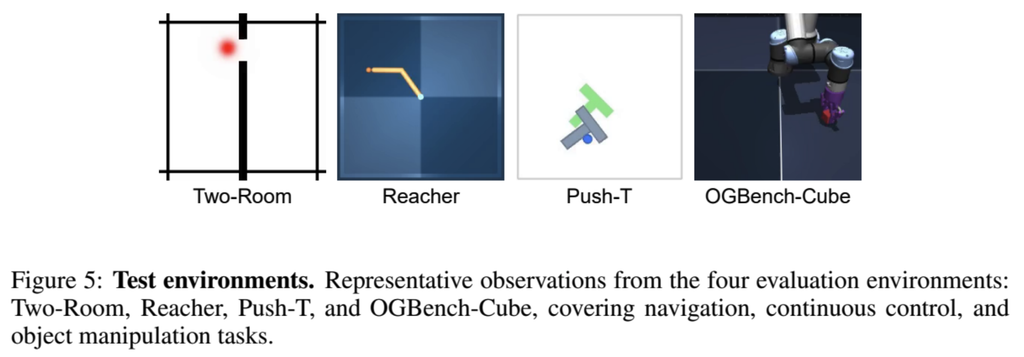
실험은 Two-Room, Reacher, Push-T, OGBench-Cube의 네 환경에서 진행합니다. 각각 navigation, arm reaching, 물체 밀기, cube manipulation에 해당하며, 논문은 50회의 evaluation rollout을 기준으로 성공률을 보고합니다. 일반적인 관측에서 planning을 잘하는지 그리고 task와 무관한 visual noise가 들어갔을 때 성능을 얼마나 유지하는지입니다.
Clean observation
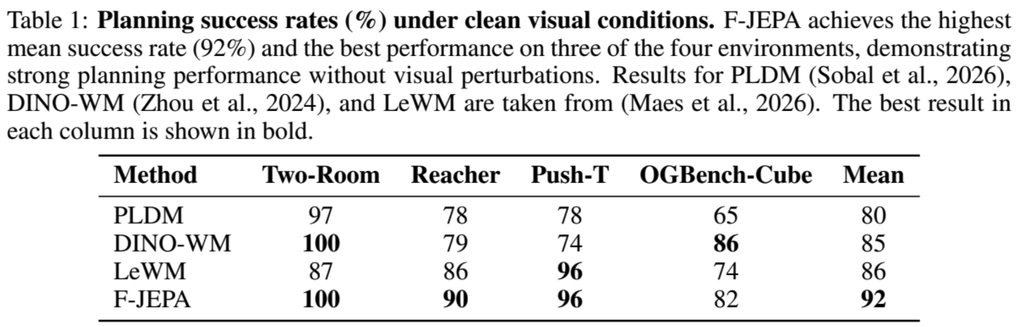
여기서 baseline 수치는 이번 논문에서 모두 새로 측정한 것이 아니라 LeWM 논문에서 가져온 결과라고 합니다.아직 실험표가 완성이 안된건가 ? 실험이 좀 빈약한 생각들이 밑에서도 계속들지만 우선 표를 보자면. 정상인 환경에서 flow matching기반의 jepa가 성능이좋은 것을 보실수있습니다. 저자가 핵심으로 주장하고싶은 것은 두번째 표가 아닐까 싶은데요
이 논문의 중심 실험입니다. 저자들은 물리적인 환경이나 action dynamics를 바꾸지 않고 RGB observation의 배경 일부에 Gaussian noise를 추가합니다. Noise의 중심은 agent와 중요한 물체를 피해 배경에서 선택하며 하나의 rollout 안에서는 고정합니다. 즉 “해야 할 일은 그대로인데 배경이 달라져도 잘 동작하는가”를 확인하는 실험입니다.
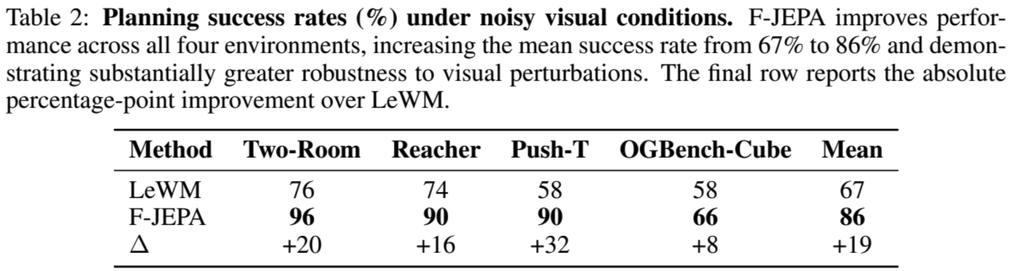
Noise 강도는 공통으로 설정하지만, Push-T에서는 LeWM의 성능이 지나치게 낮아지는 것을 피하기 위해 다른 환경보다 작은 noise radius를 사용합니다.
Noise가 들어가면 차이가 더 커집니다. 평균 성공률은 LeWM 67%, F-JEPA 86%로 19%p 차이입니다. 논문에 보고된 평균을 기준으로 clean에서 noisy로 바뀔 때 전제척으로 감소합니다. 특히 Push-T에서는 58%와 90%로 차이가 크게 나타납니다.
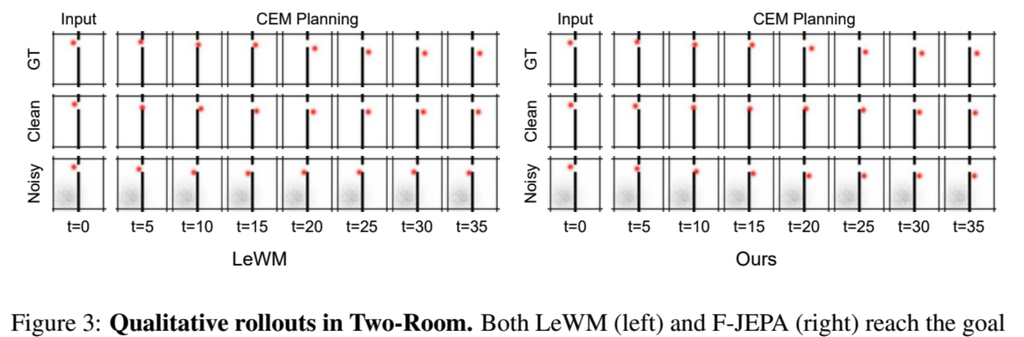
Figure 3의 예시에서도 clean condition에서는 두 방법 모두 목표에 도달하지만, noise가 추가되면 LeWM은 실패하고 F-JEPA는 성공합니다. 근데 지금 노이즈가 들어간 이미지들이 저게 들어간건가 ? 라는 생각을 하실 수도있는데요 뒤에 가면 노이즈 정도를 추가한것으로 디펜스를 한것같습니다. 아무튼 여기서 말하는 핵심은 저정도의 노이즈를 추가했음에도 불구하고 autoregressive한 lewm은 실패를 하고 저자들은 flow matching을 통해 성공한다는게 핵심이 아닐까 싶습니다
또한 아쉬운것은 clean 비교에는 DINO-WM과 PLDM이 등장하는데, 정작 핵심인 noisy 비교에서는 LeWM만 남는다는 점입니다. LeWM의 predictor를 바꾸는 연구라는 점에서는 이해되지만, 다른 world model보다도 robust한지는 이 결과만으로 알기 어렵습니다. 동일한 perturbation을 적용한 비교가 있었다면 주장이 더 설득력 있었을 것 같습니다.
Ablation study
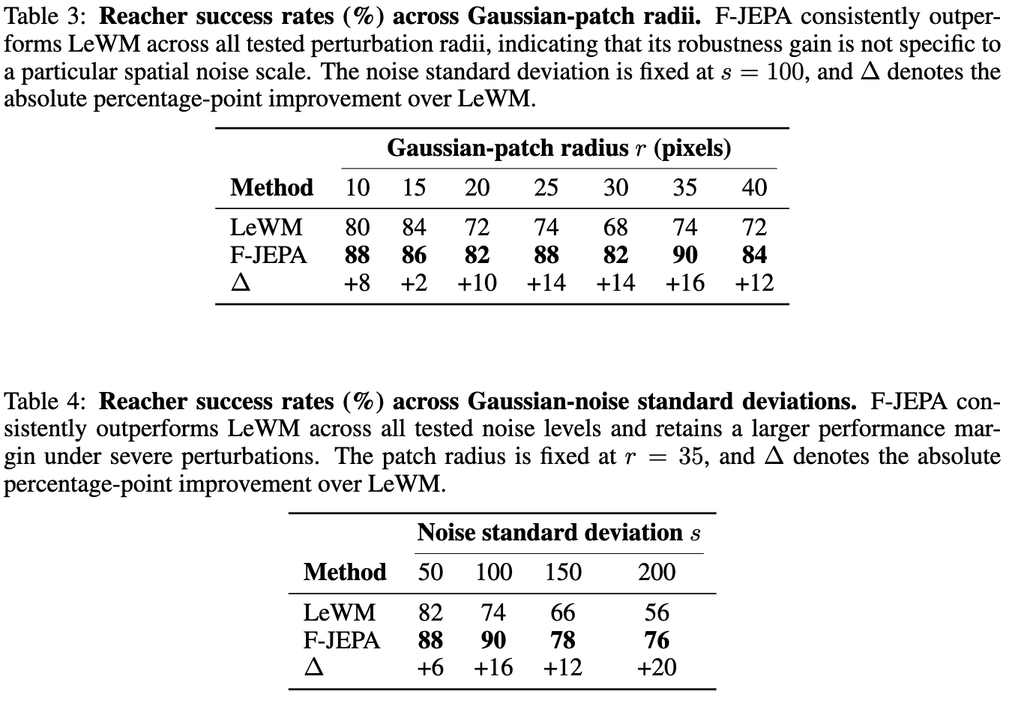
저자들은 noise patch의 크기와 강도를 바꾸어 특정 설정에서만 효과가 나타난 것은 아닌지 확인합니다. Reacher에서는 radius를 10부터 40까지 standard deviation를 을 50부터 200까지 바꾼 모든 설정에서 F-JEPA가 LeWM보다 높은 성공률을 보입니다. 적어도 평가한 범위에서는 한 가지 noise 세팅에만 의존한 결과는 아닙니다.
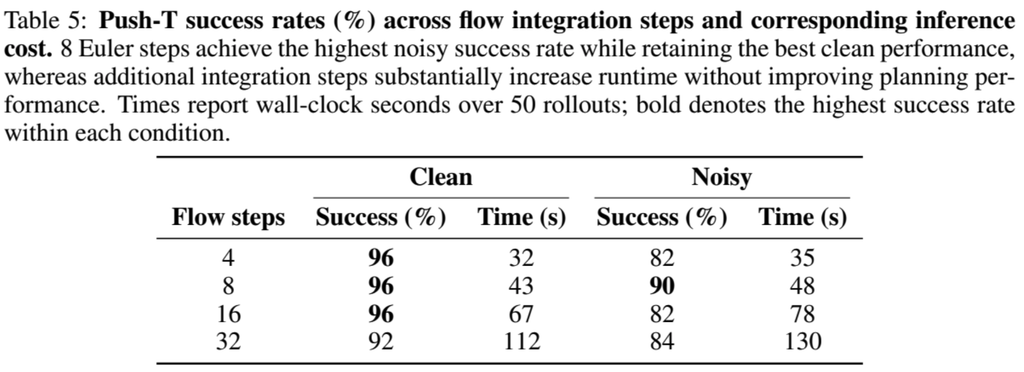
Flow integration을 많이 할수록 좋아지는지도 확인합니다. Push-T에서 8 step은 clean 96%, noisy 90%로 좋은 결과를 보이지만 16이나 32 step으로 늘린다고 더 좋아지지는 않습니다. 그에 따라 시간은 더 증가되겠죠 ?
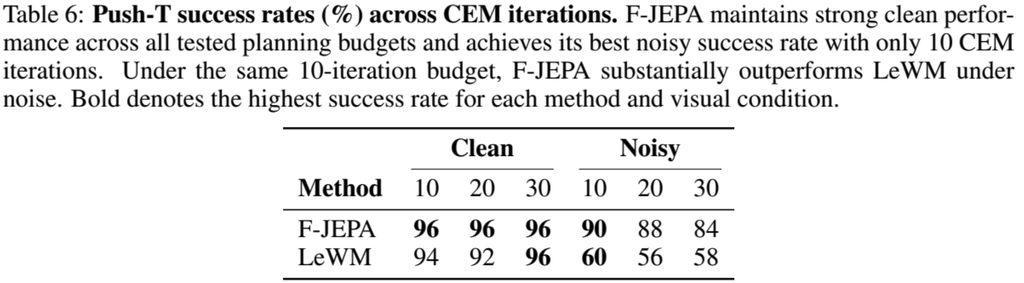
마지막으로 CEM의 탐색 횟수를 비교합니다. Main result에서 Push-T의 F-JEPA는 10 iteration, LeWM은 기존 설정인 30 iteration을 사용했기 때문입니다. 동일하게 10 iteration으로 맞춰도 noisy 성공률은 F-JEPA가 더 좋다는 것을 볼 수 있습니다.
Conclusion
FLOW-JEPA는 JEPA world model의 미래 예측 방식을 autoregressive regression에서 conditional flow matching으로 바꾼 논문입니다. 미래 latent trajectory 전체를 함께 갱신하며, 4가지 환경에서 clean 성능을 유지하거나 개선하고 배경 noise로 인한 성능 저하를 줄였습니다.
개인적으로는 픽셀 복원을 없애는 것에서 더 나아가, latent 공간에서 무엇을 예측하는지만큼 어떻게 예측하는지도 중요하다는 점을 보여주는 논문으로 읽었습니다.
감사합니다