안녕하세요. 오늘의 X-Review는 DreamPRVR이라는 PRVR 논문입니다. 최근 저도 PRVR을 연구하면서 frame과 clip 수준의 local matching을 어떻게 개선할지 여러 실험을 진행하고 있는데, DreamPRVR에서 문제를 바라보는 관점이 흥미로워 정리해보게 되었습니다. 그럼 바로 리뷰 시작하겠습니다.
1. Introduction
먼저 Partially Relevant Video Retrieval, 즉 PRVR이 어떤 문제인지 간단히 설명드리겠습니다. 일반적인 Text-to-Video Retrieval(T2VR)은 자연어 query가 주어졌을 때 이와 가장 잘 맞는 영상을 찾아주는 task입니다. 기존 T2VR 연구에서는 대부분 하나의 짧은 영상 전체가 query와 잘 대응되는 fully relevant setting을 가정합니다. 예를 들어 query가 “A man is playing the guitar.”라면, 검색 대상 영상 역시 처음부터 끝까지 남성이 기타를 연주하는 장면으로 구성되어 있다고 가정하는 것이죠.
하지만 실제 환경에서는 조금 다릅니다. YouTube와 같은 곳에서 볼 수 있는 영상은 대부분 여러 장면이 섞여 있는 긴 untrimmed video이고, 사용자가 입력하는 query는 그 영상 전체가 아니라 특정 순간만을 설명하는 경우가 많습니다. 이를 해결하기 위해 제안된 것이 Partially Relevant Video Retrieval(PRVR)입니다. PRVR에서는 하나의 긴 영상 중 query와 관련된 일부 clip만 존재하더라도 해당 영상을 올바르게 검색하는 것을 목표로 합니다. 문제는 이렇게 영상의 일부만 query와 관련되기 시작하면, 검색 난이도가 크게 올라간다는 점입니다.
특히 저자들은 PRVR에서 중요한 문제로 query ambiguity를 지적합니다. 하나의 일반적인 query는 정답 영상 안의 특정 clip과 잘 맞을 수도 있지만, 동시에 전혀 다른 영상의 일부 장면과 우연히 높은 similarity를 가질 수도 있습니다.
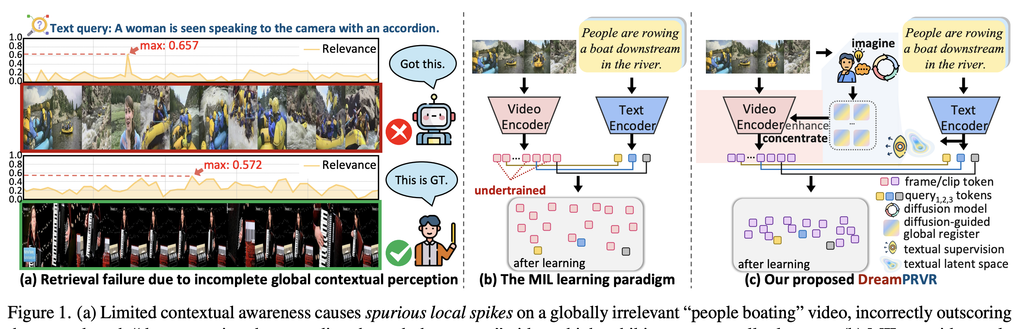
예를 들어 그림 1-(a)의 query는“A woman is seen speaking to the camera with an accordion.입니다. 당연히 정답 영상은 여성이 카메라를 보며 accordion을 보여주는 영상입니다. 그런데 다른 영상의 특정 순간이 query와 우연히 비슷한 visual pattern을 갖는다면, 모델은 정답 영상 전체의 문맥을 제대로 이해하지 못한 채 그 일부 장면에만 높은 similarity를 줄 수 있습니다. 그 결과 실제 정답 영상보다 전혀 관련 없는 영상에서 순간적으로 높은 local spike activation이 발생하고, 잘못된 영상을 검색하게 되는 것이죠.
저자들은 이러한 현상의 원인을 불완전한 global contextual perception에서 찾습니다. 현재 PRVR 모델은 “이 영상 전체가 어떤 내용을 담고 있는가?”를 충분히 이해하기보다는, query와 가장 비슷한 일부 clip을 찾는 데 집중하는 경우가 많습니다. 그렇기 때문에 영상 전체로 보면 전혀 관련 없는 영상이라 하더라도, 그 안에 우연히 query와 비슷한 장면 하나가 존재하면 모델이 쉽게 속을 수 있다는 것입니다.
여기서 문제가 하나 더 있습니다. 바로 PRVR에서 널리 사용되는 Multiple Instance Learning(MIL)입니다. PRVR에서는 하나의 영상을 여러 clip 또는 frame으로 나눈 뒤, query와 가장 similarity가 높은 local instance를 해당 영상의 대표 score처럼 사용합니다. 쉽게 말하면,“영상 안에서 query와 가장 비슷한 장면 하나만 찾으면 된다.” 라는 방식입니다. 부분적으로 관련된 장면을 찾는 PRVR 특성상 상당히 자연스러운 방법이지만, 저자들은 오히려 이것이 앞서 설명한 ambiguity 문제를 더욱 심화시킨다고 주장합니다. 그림 1-(b)를 보면 MIL은 query와 가장 잘 맞는 token 또는 clip에만 강한 supervision을 주게 됩니다. 반대로 similarity가 낮은 나머지 video token들은 상대적으로 충분히 학습되지 못하게 됩니다.
결국 모델 입장에서는 이 영상 전체가 어떤 영상인지를 이해할 필요 없이, query와 비슷해 보이는 장면 하나만 찾아내면 되는 방향으로 학습될 수 있는 것이죠. 이렇게 학습된 representation은 충분한 contextual grounding을 갖지 못하기 때문에 query ambiguity를 해결하기 어렵고, 앞서 본 것처럼 일부 local token에서 비정상적으로 높은 similarity가 발생하는 문제가 나타날 수 있습니다.
그렇다면 자연스럽게 다음과 같은 질문을 해볼 수 있습니다.
“Local matching을 하기 전에, 영상 전체의 의미를 먼저 모델에게 알려주면 어떨까?”
저자들이 DreamPRVR에서 해결하고자 하는 핵심 문제가 바로 이것입니다. 물론 기존 연구에서도 global context를 활용하려는 시도는 있었습니다. HLFormer는 semantic entailment를 활용하고, RAL은 영상의 global uncertainty를 학습합니다. 하지만 이러한 global information은 대부분 training 단계의 regularization으로만 사용됩니다. 즉 실제 inference 단계에서 사용하는 video embedding 자체를 직접적으로 보완해주지는 않습니다. DL-DKD는 CLIP으로부터 global knowledge를 가져오지만, 이 역시 teacher model이 temporal context를 충분히 모델링하지 못한다는 한계가 있습니다.
따라서 저자들은 조금 다른 접근을 선택합니다. 최근 Vision Transformer 연구에서 사용되는 register token의 아이디어를 가져와, 영상 전체의 holistic semantics를 담는 global register를 만들고 이를 모든 local video token과 interaction시키는 것입니다. 이렇게 하면 각 frame이나 clip token이 자신의 local information만 갖는 것이 아니라, “이 영상 전체가 어떤 내용을 담고 있는가”라는 global context를 함께 참고하면서 representation을 만들 수 있습니다. 결과적으로 MIL에서 충분히 학습되지 않았던 local token까지 global context의 도움을 받을 수 있고, 우연히 query와 비슷해 높은 similarity를 갖는 noisy local spike 역시 억제할 수 있다는 것이 저자들의 핵심 아이디어입니다.
하지만 여기서 또 하나의 문제가 생깁니다.
“그렇다면 신뢰할 수 있는 global register는 어떻게 만들 것인가?”
PRVR에서 다루는 영상은 untrimmed video이기 때문에 관련 없는 장면이 상당히 많이 포함되어 있습니다. 따라서 모든 video token을 단순 average pooling하거나 한 번의 projection을 통해 global representation을 만드는 방식으로는, 중요한 의미와 noise를 제대로 분리하기 어렵습니다.
저자들은 바로 이 문제를 해결하기 위해 DreamPRVR을 제안합니다. DreamPRVR의 핵심 아이디어는 이름에서도 어느 정도 드러나듯이, local representation을 바로 학습하는 것이 아니라 먼저 영상 전체의 의미를 imaging하는 것입니다. 구체적으로는
coarse-grained contextual imagination → fine-grained representation learning
순서로 진행됩니다. 먼저 video representation으로부터 global register를 바로 만드는 대신, diffusion process를 이용하여 register를 반복적으로 denoising합니다. 그리고 이 과정에 text supervision을 함께 사용하면서 noisy한 video information으로부터 영상 전체를 설명할 수 있는 cleaner global semantics를 점진적으로 만들어냅니다.
그림 1-(c)가 이 전체 과정을 보여줍니다. DreamPRVR은 먼저 diffusion을 통해 영상의 global register를 imagine하고, 이후 이 register를 각각의 frame/clip token과 interaction시킵니다. 이를 통해 local token들이 영상 전체의 context를 반영하도록 만들고, 최종적으로 coarse-to-fine 방식의 cross-modal alignment를 수행하는 것입니다.
그런데 diffusion을 이용해 reliable global register를 만든다고 하면 크게 두 가지 문제가 발생합니다. 첫 번째는, “어떤 textual information을 이용해서 register 생성을 supervise할 것인가?”입니다. 하나의 영상에는 여러 개의 query가 존재할 수 있습니다. 기존 연구에서는 서로 다른 query representation을 떨어뜨리는 diversity loss를 사용하는 경우가 많았는데, 저자들은 이것이 동일 영상에 대한 query들 사이의 관계까지 무시한다는 문제를 지적합니다.
예를 들어 하나의 영상에 “사람들이 강에서 배를 젓고 있다.”, “몇 명의 사람들이 보트를 타고 강을 따라 이동한다.”와 같은 query가 존재한다면 두 문장은 표현은 다르지만 동일 영상의 global semantics를 서로 다른 관점에서 설명하고 있습니다. 따라서 DreamPRVR은 동일 영상에 속한 query들을 서로 완전히 다른 sample로 보지 않고, 하나의 영상 의미를 설명하는 complementary positive view로 사용합니다.
이를 위해 저자들은 Query Similarity Preservation(QSP) Loss를 제안합니다. QSP는 동일 영상에 속한 query는 embedding space에서 가깝게 유지하면서, 다른 영상에 속한 query와는 잘 구분되도록 학습합니다. 기존 diversity loss와 함께 사용하면서 intra-video compactness와 inter-video separability를 동시에 확보하는 것입니다. 결과적으로 register diffusion을 supervise하기 위한 보다 구조화된 textual latent space를 만들 수 있습니다.
또한 하나의 text embedding만을 그대로 supervision으로 사용하는 대신, 저자들은 Textual Perturbation Sampler(TPS)를 사용합니다. TPS는 학습된 textual latent space 주변에서 일정 범위의 perturbation을 주어 여러 semantic representation을 sampling합니다. 쉽게 말하면 하나의 query를 고정된 하나의 point로 보는 것이 아니라, 해당 의미가 존재할 수 있는 주변 semantic region까지 supervision으로 활용하는 것입니다.
두 번째 문제는 noise가 많은 영상에서 diffusion을 어디서부터 시작할 것인가? 입니다. 일반적인 diffusion model은 random noise에서 시작해 원하는 representation을 만들어갑니다. 하지만 DreamPRVR의 목표는 이미지나 영상을 새롭게 생성하는 것이 아니라 이미 존재하는 video semantics를 정제하는 것입니다. 따라서 random noise부터 시작하는 것은 굳이 필요하지 않습니다.
이를 위해 저자들은 Probabilistic Variational Sampler(PVS)를 제안합니다. PVS는 video feature로부터 learnable probabilistic latent distribution을 만들고, 여기서 sampling한 representation을 diffusion의 시작점으로 사용합니다. 즉,
random noise → global register
가 아니라
video-centric latent representation → refined global register
형태로 diffusion을 수행하는 것입니다. 그 이후 Diffusion Register Estimator(DRE)가 TPS에서 제공하는 textual supervision을 이용해 이 representation을 반복적으로 denoising하면서, noise가 제거된 holistic global register를 만들어냅니다. 마지막으로 이렇게 얻어진 global register는 Register-augmented Gaussian Attention Block(RAB)을 통해 기존 video token들과 결합됩니다.
정리하면 DreamPRVR은 query와 가장 비슷한 clip 하나를 잘 찾자라는 기존 PRVR의 local matching 관점에서 한 단계 더 나아가, 먼저 이 영상 전체가 무엇을 의미하는지 imagine한 뒤, 그 context를 이용해 각각의 local representation을 학습하는 접근이라 볼 수 있습니다.
방법론에서 각각의 QSP, TPS, PVS, DRE, RAB가 구체적으로 어떤 역할을 하는지는 이어서 살펴보겠습니다.
2. DreamPRVR
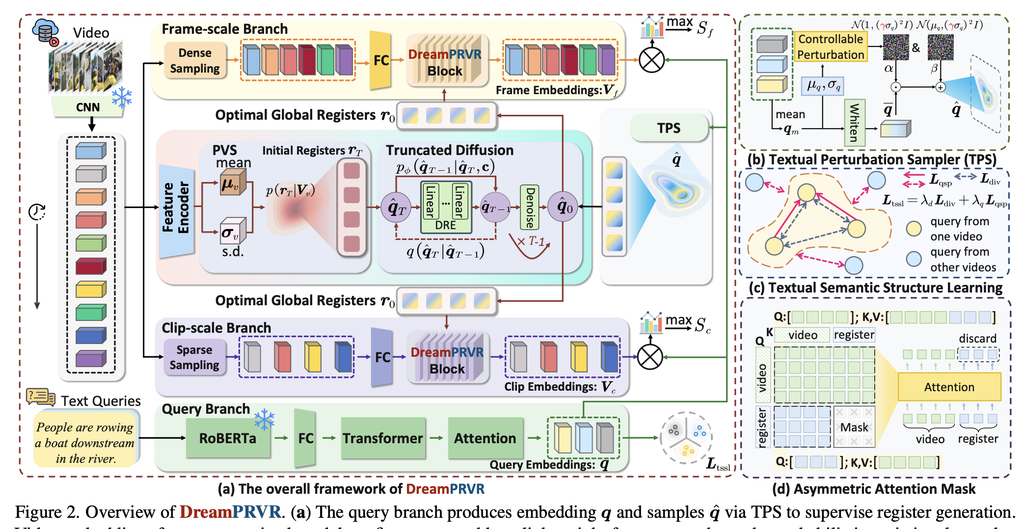
그림 2는 DreamPRVR의 전체적인 구조를 보여주고 있습니다. 먼저 위쪽의 text branch에서는 RoBERTa와 Transformer를 통해 query embedding을 만들고, 여러 query 사이의 관계를 학습하여 register generation을 supervise하기 위한 textual latent space를 구성합니다. 아래쪽의 video branch에서는 pre-trained vision model에서 얻은 feature를 바탕으로 PVS를 통해 initial global register를 만들고, 이를 diffusion model로 여러 번 denoising하여 영상 전체의 의미를 담는 optimal global register를 생성합니다. 마지막으로 이렇게 만들어진 register를 frame branch와 clip branch의 local token들과 interaction시켜 각각의 representation을 보완한 뒤, query와의 similarity를 계산하여 retrieval을 수행합니다.
앞서 Introduction에서 이야기했듯 DreamPRVR이 해결하려는 핵심 문제는 기존 MIL 방식에서 query와 가장 잘 맞는 일부 local token만 제대로 학습되고, 나머지 token들은 충분한 supervision을 받지 못한다는 것입니다. 따라서 DreamPRVR은 바로 local matching을 수행하는 대신, 먼저 영상 전체의 context를 담는 global register를 만들고 이를 각각의 local representation에 전달합니다. 저자는 앞의 global context 생성 과정을 imagination, 이후 local representation을 학습하는 과정을 concentration이라고 표현하고 있습니다.
2.1 Textual Semantic Structure Learning
먼저 global register를 supervise하기 위한 text representation부터 만들어줍니다. 하나의 query가 들어오면 pre-trained RoBERTa에서 word-level feature를 추출하고, FC layer와 Transformer encoder를 거친 뒤 attention aggregation을 통해 하나의 query embedding q를 얻습니다. 여기까지만 보면 일반적인 text encoder와 크게 다르지 않습니다.
문제는 하나의 video에 여러 개의 query가 존재한다는 점입니다. 기존 PRVR 연구에서는 다양한 query가 모두 비슷한 representation으로 collapse되는 것을 막기 위해 query diversity loss를 사용했는데, 말 그대로 모든 query를 서로 떨어뜨리는 방향으로 학습합니다. 하지만 같은 video에 속하는 query들은 표현은 다르더라도 결국 동일한 영상의 서로 다른 부분이나 의미를 설명하고 있습니다. 이러한 query들까지 모두 멀리 떨어뜨리면 해당 video가 가지는 공통된 global semantics를 제대로 표현하기 어렵겠죠.
이를 해결하기 위해 저자는 Query Similarity Preservation, 즉 QSP Loss를 추가합니다. 위 그림 2-(c)처럼 같은 video에서 나온 query는 complementary positive로 보고 서로 가까운 embedding을 갖도록 만들고, 다른 video의 query와는 구분되도록 학습하는 것입니다. 결국 기존 diversity loss는 다양한 query를 충분히 분리하는 역할을 하고, QSP는 그 과정에서도 같은 video의 query가 갖는 공통적인 의미는 유지하도록 하는 역할을 합니다.
두 loss를 합친 최종 textual semantic structure learning objective는 아래와 같습니다.
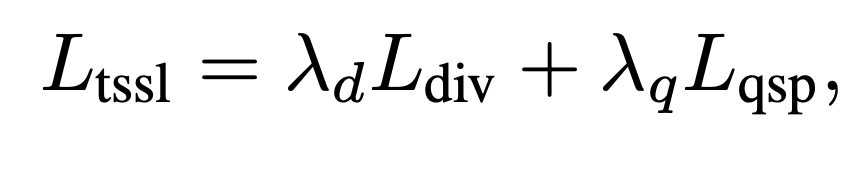
이를 통해 같은 video의 query들은 어느 정도 compact하게 모이고, 서로 다른 video의 query는 잘 구분되는 structured textual latent space를 만들게 됩니다. 저자는 이렇게 만들어진 textual space를 이후 global register generation을 supervise하는 데 사용합니다.
그런데 text query 자체에도 uncertainty가 존재합니다. 같은 장면을 설명하더라도 “사람들이 강에서 배를 젓고 있다.”라고 표현할 수도 있고, “사람들이 보트를 타고 강을 따라 내려가고 있다.”라고 표현할 수도 있는 것이죠. 따라서 하나의 video가 가지는 semantic information을 정확히 하나의 embedding point로만 표현하는 것은 다소 제한적일 수 있습니다.
이러한 문제를 해결하기 위해 그림 2-(b)의 Textual Perturbation Sampler, TPS를 사용합니다. 먼저 동일 video에 속한 query embedding들을 평균내어 하나의 global semantic representation을 만들고, 이를 whitening한 뒤 일정 범위의 controllable perturbation을 추가합니다.
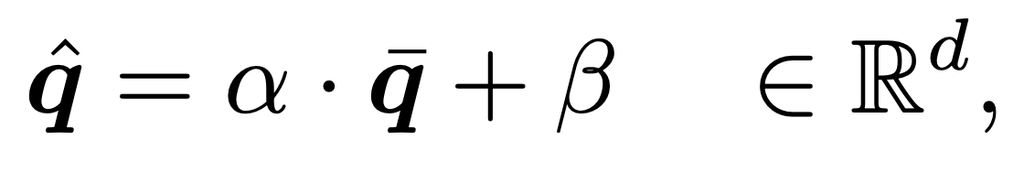
쉽게 말하면 이 video의 text semantics는 정확히 이 한 점이다라고 지정하는 대신, 해당 embedding 주변의 일정한 semantic region까지 함께 모델링하는 것입니다. 이때 perturbation의 크기는 γ를 통해 조절되며, 이렇게 sampling된 q̂가 뒤에서 diffusion model이 global register를 생성할 때 target 역할을 하게 됩니다. TPS 자체에는 별도의 trainable parameter가 들어가지 않습니다.
2.2 Register Generation via Truncated Diffusion
이제 DreamPRVR의 핵심인 global register를 생성합니다. 앞서 TPS를 통해 영상이 가져야 할 global semantics에 대한 text supervision을 준비했다면, 이제 실제 video feature만을 이용해 이 semantics에 가까운 global register를 만들어야 합니다.
저자는 이를 위해 일반적인 diffusion model처럼 random Gaussian noise에서 시작하지 않습니다. 어차피 우리가 원하는 것은 새로운 데이터를 처음부터 생성하는 것이 아니라, 입력 video가 가지고 있는 정보 중에서 noise를 제거하고 reliable한 global semantics를 얻는 것이기 때문입니다. 따라서 video 정보를 어느 정도 포함하고 있는 좋은 시작점을 먼저 만드는 Probabilistic Variational Sampler, PVS를 사용합니다.
그림 2-(a)의 PVS와 DRE에서는 먼저 pre-trained vision model의 feature를 lightweight한 linear layer와 Transformer block에 통과시켜 V를 만듭니다. 그리고 PVS는 이 feature에서 바로 하나의 embedding을 출력하지 않고 mean μv와 standard deviation σv를 예측하여 Gaussian distribution을 만듭니다.
그리고 이 distribution에서 다음과 같이 sampling하여 initial register rT를 만듭니다.
즉 일반적인 diffusion model이 완전한 random noise에서 시작한다면, DreamPRVR은 처음부터 해당 video의 정보를 어느 정도 가지고 있는 video-centric noise에서 시작합니다. 그림 2-(a)의 PVS 부분에서 video feature로부터 mean과 standard deviation을 구한 뒤 여러 개의 initial register를 sampling하는 과정이 바로 이것입니다. 저자는 이러한 좋은 initialization 덕분에 굉장히 많은 diffusion timestep을 사용할 필요 없이 truncated diffusion만으로도 register를 생성할 수 있다고 이야기합니다.
이제 이렇게 얻어진 rT를 Diffusion Register Estimator, DRE에 넣어 최종 register로 정제합니다. DRE의 학습 자체는 DDPM과 유사합니다. 앞서 TPS가 만들어준 textual feature q̂를 clean data라고 생각하고 여기에 timestep에 따라 Gaussian noise를 추가합니다. 그리고 DRE는 각각의 timestep에서 얼마만큼의 noise가 들어갔는지를 예측하도록 학습됩니다.
핵심 objective만 보면 아래와 같습니다.
일반적인 diffusion의 noise prediction loss와 동일하게 실제 추가된 noise ε와 모델이 예측한 noise 사이의 차이를 줄이는 것이죠. 이때 condition c는 video feature와 learnable parameter 사이의 cross-attention을 통해 만들어집니다.
학습할 때는 text feature q̂에 noise를 추가하고 이를 다시 복원하도록 학습하지만, 실제 register를 생성할 때는 random noise가 아니라 PVS에서 만든 video-centric rT를 시작점으로 사용합니다. 이후 여러 timestep에 걸쳐 반복적으로 denoising하면서 text가 표현하고 있는 global semantics에 가까운 representation을 만들어내고, 최종적으로 optimal global register r0를 얻게 됩니다.
2.3 Register-Augmented Video Representation
이제 이렇게 만들어진 global register를 실제 frame과 clip representation에 넣어줘야 합니다. DreamPRVR은 기존 PRVR 모델들과 마찬가지로 frame-scale branch와 clip-scale branch의 dual-branch 구조를 사용합니다. Frame branch에서는 Mf개의 frame을 비교적 dense하게 sampling하고, clip branch에서는 video를 Mc개의 clip으로 downsampling합니다. 이후 두 branch 모두 FC layer와 DreamPRVR block을 거쳐 각각 frame embedding Vf와 clip embedding Vc를 얻습니다.
기존 방식과 다른 부분은 DreamPRVR block 안에서 앞서 만든 global register r0가 함께 사용된다는 것입니다. Video token과 global register를 concatenate한 뒤 Register-Augmented Attention Block, RAB를 통해 서로 interaction시킵니다.
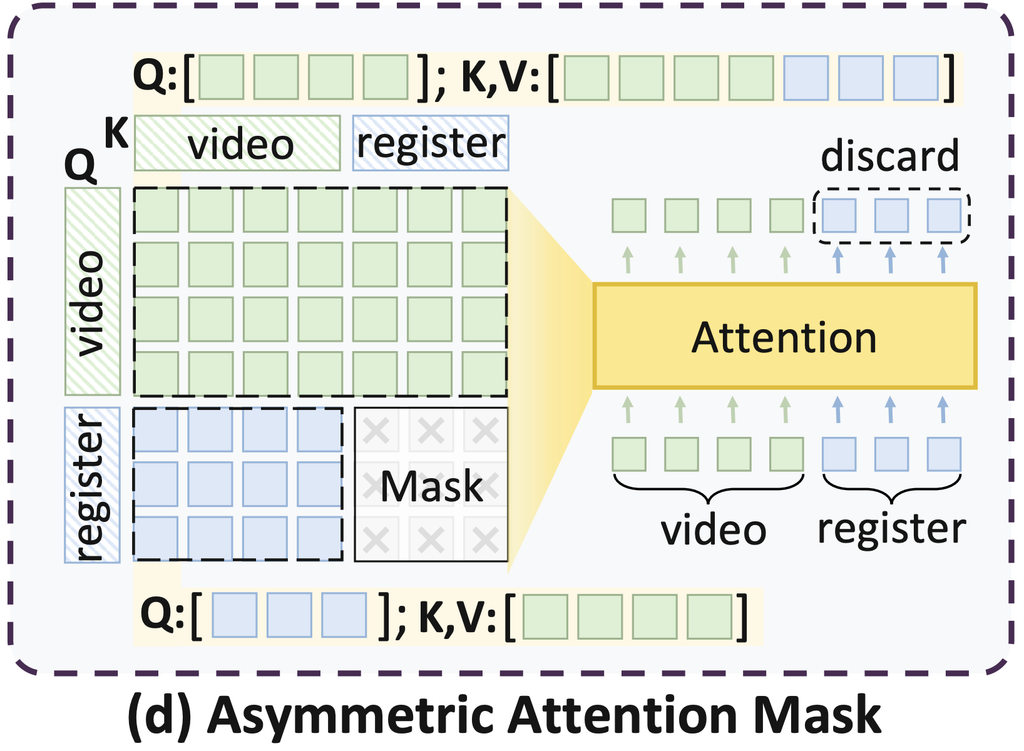
위 그림은 RAB에서 사용하는 asymmetric attention mask를 보여줍니다. Video token은 다른 video token뿐만 아니라 global register에도 attention할 수 있습니다. 반대로 register는 모든 token에 unrestricted하게 attention하지 않고 video token과만 interaction하도록 구성됩니다. 특히 register끼리 정보를 계속 주고받으며 자체적으로 변형되는 것을 제한하고, 실제 video feature와의 interaction을 통해 context를 전달하도록 만드는 것입니다. Attention이 끝난 뒤에는 register 자체는 버리고 업데이트된 video token만 사용합니다.
2.4 Model Optimization
앞서 설명한 모듈들은 최종적으로 하나의 objective를 통해 함께 학습됩니다. 기본적인 retrieval을 위한 similarity loss Lsim에 앞서 설명한 textual semantic structure learning loss Ltssl, PVS의 distribution을 학습하기 위한 Lpvs, 그리고 diffusion denoising을 위한 Ldre를 더합니다.
Lsim은 최종적으로 query와 올바른 video가 높은 similarity를 갖도록 만들어주고, Ltssl은 register generation을 supervise할 textual latent space를 구성합니다. 여기에 Lpvs는 PVS가 diffusion에 적합한 probabilistic space를 만들도록 하고, Ldre는 global register를 제대로 denoising할 수 있도록 학습합니다.
2.5 Cross-modal Similarity Computation
마지막으로 이렇게 얻어진 representation으로 실제 retrieval을 수행합니다. 하나의 query에서는 최종 text embedding q를 얻고, video에서는 DreamPRVR block을 거친 frame embedding Vf와 clip embedding Vc를 얻습니다.
먼저 query와 모든 frame 사이의 cosine similarity를 계산하고, 그중 가장 높은 값을 frame-level score로 사용합니다. Clip에서도 동일한 방식으로 가장 높은 similarity를 선택합니다.
결국 frame branch에서는 영상의 frame 중 query와 가장 잘 맞는 순간이 어디인지를 찾고, clip branch에서는 조금 더 긴 temporal context를 기준으로 query와 가장 잘 맞는 clip이 어디인지를 찾는 것입니다.
마지막으로 두 branch의 score를 weighted sum하여 최종 text-video similarity를 구합니다.
결국 DreamPRVR의 전체 방법론을 다시 보면, 먼저 여러 query의 관계를 이용해 잘 구성된 textual semantic space를 만들고, 이를 supervision으로 사용하여 PVS와 truncated diffusion을 통해 video의 global semantics를 담는 register를 만들어냅니다. 이후 이 global register를 frame과 clip token에 다시 전달하여 local representation을 보완하고, 최종 retrieval 자체는 기존 PRVR에서 많이 사용하던 local max matching 방식을 그대로 사용하는 것입니다.
3. Experiments
3.1 Comparison with State-of-the-arts
저자는 DreamPRVR을 기존 12개의 PRVR 모델뿐만 아니라 일반적인 Text-to-Video Retrieval(T2VR), Video Corpus Moment Retrieval(VCMR) 방법론들과도 비교합니다. T2VR에서는 RIVRL, DE++, CLIP4Clip, Cap4Video를 사용하고, VCMR에서는 ReLoCLNet, XML, CONQUER, JSG와 비교합니다.
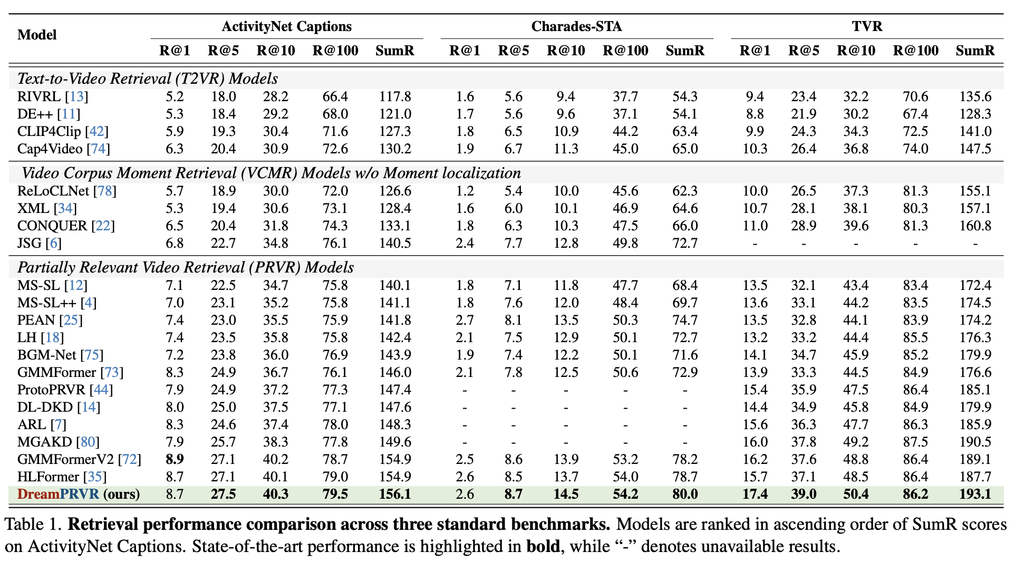
표 1의 결과를 보면 PRVR task에 맞게 설계된 모델들이 일반적인 T2VR이나 VCMR 방법들보다 높은 성능을 보입니다. 그중 DreamPRVR은 global register를 이용해 video의 전체적인 contextual information을 representation에 반영하면서 기존 PRVR 방법보다 높은 retrieval 성능을 달성합니다. 저자는 이러한 결과가 단순히 local similarity만을 사용하는 대신 diffusion을 통해 reliable한 holistic semantics를 생성한 결과라고 설명합니다. 즉 Introduction에서 이야기했던 incomplete global contextual perception 문제를 실제 retrieval 성능 향상으로 해결할 수 있다는 것이죠.
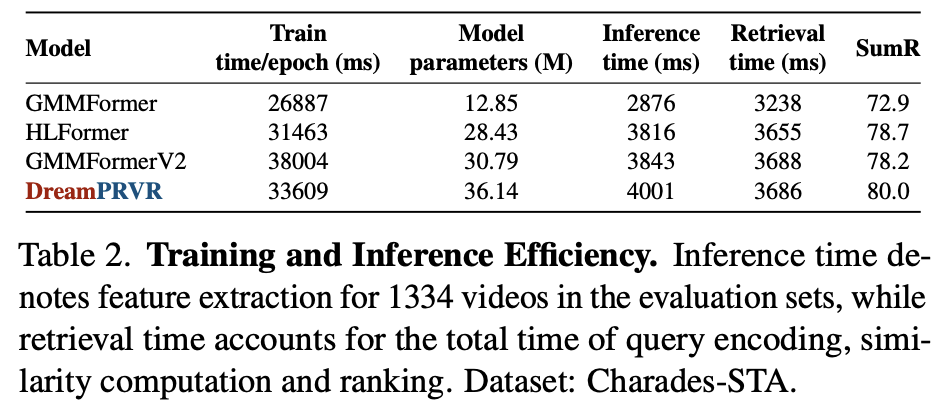
물론 diffusion이라는 단어가 들어가면 연산량이 크게 증가하는 것은 아닌지 먼저 의문이 들 수 있습니다. 그래서 표 2에서는 model parameter, epoch당 training time, video feature extraction time, 전체 retrieval time을 비교합니다. 모든 결과는 동일한 환경에서 10번 실행한 값의 평균입니다. DreamPRVR은 iterative diffusion-based register generation이 추가되기 때문에 기존 모델보다 약간의 overhead가 발생하지만, 전체적으로는 HLFormer와 비슷한 수준의 efficiency를 유지합니다.
특히 실제 retrieval 환경에서는 video feature를 미리 계산해 cache해둘 수 있기 때문에, video branch에서 global register를 생성하는 추가 비용도 retrieval 과정에서는 크지 않다고 설명합니다. 즉 diffusion을 사용한다고 해서 일반적인 generative diffusion model처럼 굉장히 무거운 구조를 생각할 필요는 없고, 적은 수의 register와 timestep만 사용하는 lightweight한 구조라는 것이죠.
3.2 Model Analyses
이제 각각의 module이 실제로 어떤 효과를 가지고 있는지 살펴보겠습니다.
3.2.1 Number of Registers and Diffusion Timesteps
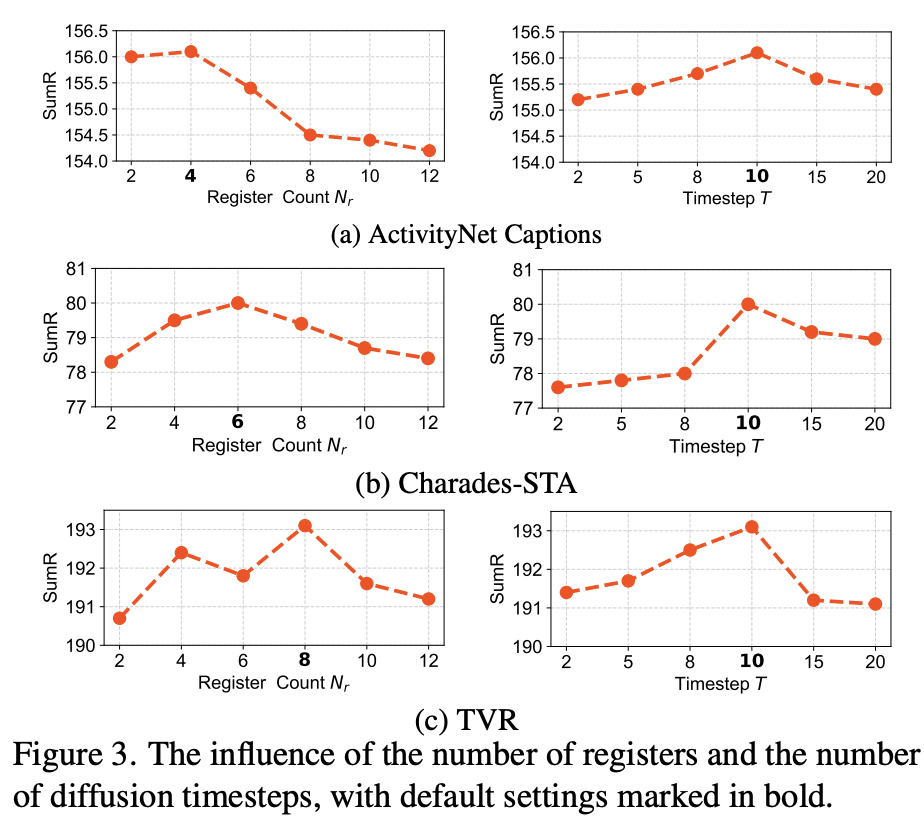
위 그림 3은 global register 개수 Nr과 diffusion timestep T를 바꿔가며 세 dataset에서의 SumR 변화를 보여주고 있습니다. 먼저 register 개수를 보면 너무 적은 register를 사용하는 경우 영상 전체의 다양한 semantic information을 담을 capacity가 부족해 성능이 떨어집니다. 반대로 register가 8개를 넘어 지나치게 많아지면 중복된 정보가 증가하면서 오히려 성능이 감소합니다.
세 dataset 모두 대략 4~8개의 register를 사용하는 구간에서 안정적으로 높은 성능을 보이기 때문에, 실제 모델에서는 ActivityNet Captions는 4개, Charades-STA는 6개, TVR은 8개를 사용합니다. 결국 수십~수백 개의 global token이 필요한 것이 아니라 몇 개의 register만으로도 영상의 global semantics를 충분히 담을 수 있다는 것입니다.
오른쪽의 diffusion timestep 결과도 비슷한 trade-off를 보여줍니다. T가 2에서 10까지 증가할수록 성능이 꾸준히 향상되는데, 이는 iterative denoising 과정이 실제로 global register를 점진적으로 정제하고 있음을 보여줍니다. 하지만 T가 10을 넘어가면 세 dataset에서 모두 성능이 다시 감소합니다. 저자는 이를 지나친 refinement로 인해 text supervision에 overfitting될 수 있기 때문이라고 설명하며, accuracy와 efficiency를 모두 고려해 T=10을 기본값으로 사용합니다. 개인적으로 diffusion이라고 하면 굉장히 많은 timestep을 떠올리기 쉬운데, 여기서는 10 step 정도만으로 충분한 효과를 얻는다는 점이 꽤 중요한 부분인 것 같습니다.
3.2.2 Efficacy of Register Generation Strategy
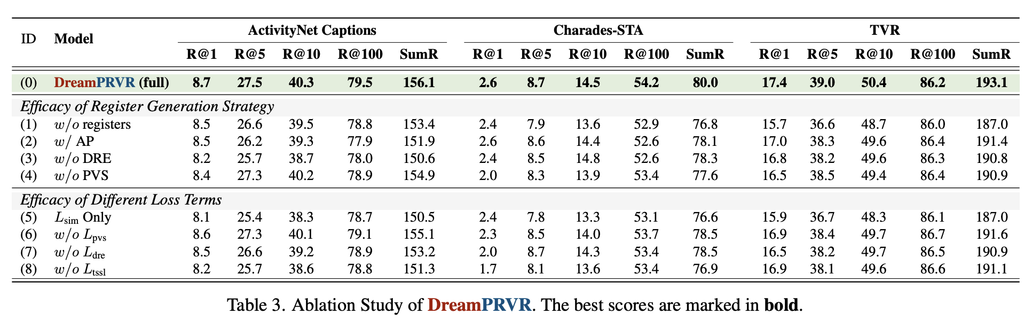
표 3에서는 DreamPRVR에서 global register를 만드는 방식 자체가 정말 필요한지 확인하기 위한 ablation을 수행합니다. 먼저 register를 아예 제거한 w/o registers에서는 세 dataset 모두 full model보다 성능이 감소합니다. 이를 통해 local representation만 사용하는 것보다 global contextual information을 추가하는 것이 실제 retrieval에 도움이 된다는 것을 확인할 수 있습니다.
다음으로 w/ AP에서는 diffusion을 통한 generation 대신 adaptive pooling으로 video feature를 단순하게 aggregation합니다. 하지만 full DreamPRVR보다 낮은 성능을 보이며, untrimmed video에 noise와 irrelevant moment가 많이 섞여 있는 상황에서는 단순 pooling만으로 meaningful한 global semantics를 얻기 어렵다는 것을 보여줍니다.
w/o DRE는 diffusion-based iterative refinement를 제거하고 한 번의 mapping만을 통해 register를 만듭니다. 이 경우 역시 성능이 감소합니다. 즉 PVS에서 initial representation을 잘 만드는 것만으로는 충분하지 않고, 여러 step에 걸쳐 semantic information을 정제하는 과정이 필요하다는 것입니다.
마지막으로 w/o PVS에서는 video-centric initialization 대신 일반적인 random Gaussian noise에서 diffusion을 시작합니다. 이 경우에도 full model보다 성능이 낮습니다. 결국 DreamPRVR에서 PVS와 DRE는 서로 다른 역할을 하고 있는데, PVS가 video semantic을 어느 정도 담은 좋은 starting point를 만들어주고, DRE가 이를 반복적으로 정제해주는 두 과정이 모두 필요하다고 볼 수 있습니다.
3.2.3 Effects of Different Loss Terms
표 3의 아래쪽에서는 앞서 Method에서 소개한 loss들의 효과를 확인합니다. Lsim만 사용한 경우가 전체 ablation 중 가장 낮은 성능을 보이며, 단순 retrieval objective만으로는 DreamPRVR이 의도한 global register를 제대로 학습하기 어렵다는 것을 확인할 수 있습니다.
Lpvs를 제거하면 PVS가 만드는 probabilistic sampling space에 대한 constraint가 사라지면서 성능이 감소하고, Ldre를 제거하면 text supervision을 이용한 diffusion generation이 제대로 이루어지지 않기 때문에 역시 성능이 감소합니다. 특히 Ldre는 text가 가지고 있는 holistic semantics를 register가 따라가도록 만들어주는 loss이기 때문에 DreamPRVR의 diffusion 과정에서 중요한 역할을 합니다.
Ltssl을 제거했을 때도 성능이 감소합니다. 이는 단순히 text feature를 diffusion target으로 사용하는 것이 아니라, 같은 video의 query들이 공유하는 구조를 고려한 textual latent space를 먼저 만들어주는 것이 중요하다는 것을 보여줍니다.
3.2.4 Visualization of Textual Latent Space
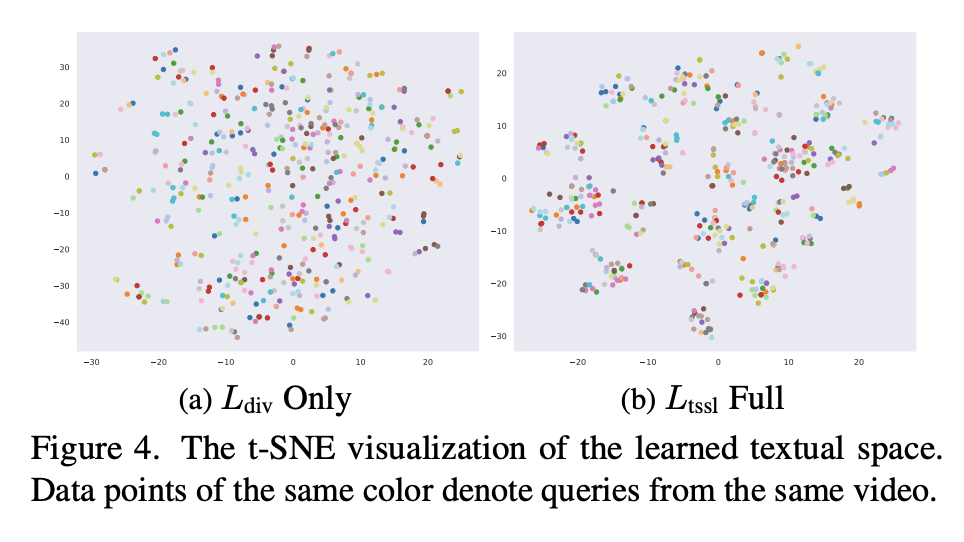
위 그림 4는 Charades-STA에서 일부 video와 query를 sampling한 뒤 textual latent space를 t-SNE로 시각화한 결과입니다. 같은 색깔은 같은 video에서 나온 query를 의미합니다.
그림 4-(a)는 기존 diversity loss Ldiv만을 사용한 결과입니다. Query가 전체적으로 넓게 퍼져 semantic diversity 자체는 확보되지만, 같은 video에서 나온 query들까지 서로 멀리 흩어져 있는 모습을 볼 수 있습니다. 즉 diversity만 강조하면 같은 video가 공유하고 있는 semantic structure까지 함께 깨질 수 있다는 것이죠.
반대로 그림 4-(b)는 QSP까지 포함한 Ltssl 전체를 사용한 결과입니다. 같은 video에서 나온 query들이 하나의 cluster를 이루면서도 다른 video의 query와는 구분되는 모습을 볼 수 있습니다. 결국 QSP는 query를 단순히 모으는 것이 아니라 intra-video semantic coherence를 유지하면서 inter-video discriminability도 확보해주는 역할을 하고, 이렇게 정돈된 textual latent space가 이후 global register generation의 좋은 supervision이 됩니다.
3.2.5 Visualization of Register Generation
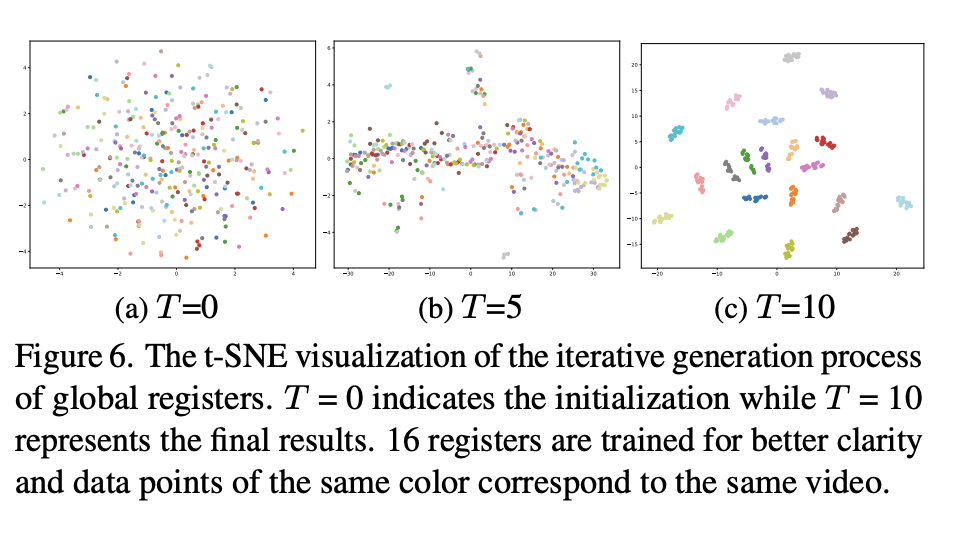
마지막으로 그림 6은 diffusion이 실제로 global register를 어떻게 변화시키는지 보여줍니다. Charades-STA에서 20개의 video를 random sampling한 뒤 register representation을 t-SNE로 시각화하며, 보기 쉽게 이 실험에서는 16개의 register를 사용합니다. 같은 색은 동일한 video에서 만들어진 register를 의미합니다.
그림 6-(a)의 T=0은 PVS에서 막 sampling된 initial register입니다. 아직 서로 다른 video의 register가 많이 섞여 있고 뚜렷한 semantic structure가 보이지 않습니다. 이후 그림 6-(b)의 T=5를 보면 같은 video의 register가 점점 가까워지고 서로 다른 video 사이의 구분도 조금씩 생기기 시작합니다.
마지막 T=10에서는 동일 video의 register끼리 비교적 명확한 cluster를 형성하며, 서로 다른 video 사이의 boundary 역시 훨씬 뚜렷해집니다. 즉 diffusion의 denoising step이 반복될수록 register가 단순한 noisy video-centric feature에서 점점 더 깨끗하고 discriminative한 global semantic representation으로 정제되는 것입니다.
앞선 그림 3에서 timestep을 늘릴수록 T=10까지 성능이 향상됐던 결과와도 연결되는 부분입니다. 단순히 diffusion module을 추가해서 성능이 좋아졌다는 것이 아니라, 실제 visualization을 통해 iterative refinement 과정에서 register의 semantic structure가 점점 명확해지는 것을 보여주고 있습니다.
전체 실험을 보면 DreamPRVR에서 제안한 각 component가 비교적 명확하게 역할을 나눠 가지고 있습니다. QSP와 TPS는 diffusion을 supervise할 textual semantic space를 만들고, PVS는 video 정보를 반영한 initial register를 만들어주며, DRE는 이를 반복적으로 정제합니다. 그리고 이렇게 생성된 global register가 실제 local video representation에 들어가면서 잘못된 local spike를 억제하고 retrieval 성능을 높이게 됩니다. 특히 단순 pooling, random initialization, one-step mapping과의 비교에서 모두 full DreamPRVR이 높은 성능을 보였다는 점에서 저자가 주장하는 “global semantics를 먼저 imagine하고 local representation을 학습한다”는 coarse-to-fine 구조의 필요성을 보여주고 있습니다.