안녕하세요 오늘은 NeurIPS 2025에 게재된 Generalized Contrastive Learning for Universal Multimodal Retrieval 논문을 보겠습니다
간단히 먼저 설명하자면, 기존 image-text pair만 가지고 image, text, image+text를 하나의 embedding space에 잘 정렬해서 다양한 modality 조합의 retrieval을 가능하게 하자! 라는 논문입니다
사실 방법 자체는 꽤 단순한데 universal multimodal retrieval에서는 어떤 문제가 있고 이걸 contrastive learning에서 어떻게 확장해서 해결했는지 위주로 살펴보겠습니
바로 리뷰 시작하겠습니다
INTRO
저자들이 말하는 문제의식은 먼저 “CLIP이 img ↔ txt 검색은 잘하는데 현실의 데이터에는 img나 txt하나만 있는게 아니다~!” 에서 시작합니다!
예를들어 DATABASE(이하 DB)에 아래와 같은 것들이 있다면
- Candidate A = image
- Candidate B = text
- Candidate C = image + text (이하 IT)
사용자가 query를 넣었을때의 정답은 Candidate C가 될수도 있게 되겠죠?!
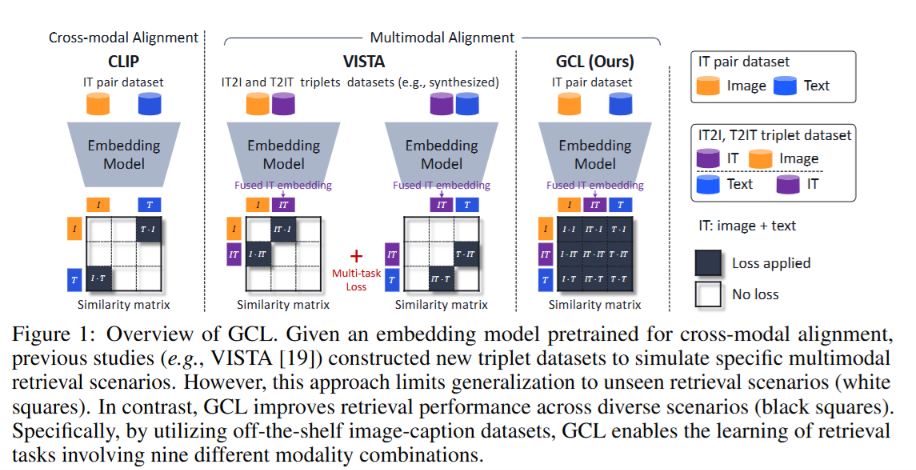
또한 이렇게 되면 query/candidate 조합도 단순히 I→T, T→I만 있는 게 아니라 아래의 그림처럼 (I → I,I → T,I → IT), (T → I, T → T, T → IT), (IT → I, IT → T, IT → IT)이렇게 9가지의 조합이 생기게 됩니다
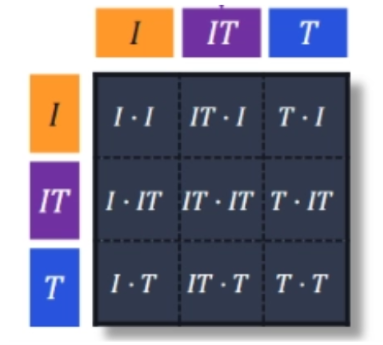
하지만 기존의 cross-modal-retrieval(예를들어 CLIP류)은 주로 img ↔ txt를 잘 맞추도록 학습이 되었기 때문에 이런 데이터가 한 DB에 섞이면 Image ↔ IT, Text ↔ IT, IT↔ IT 와 같은 경우까지 자연스럽게 잘 처리한다고 보장하기는 어렵습니다.
이러한 modality gap으로 인해 생기는 문제라고 하고, 저자들은 이와 같은 부분들에 대해 “fused image-text modality를 retrieval할 때 성능이 떨어진다”라고 말합니다.
기존의 방법들은 그럼 이 문제를 어떻게 해결해왔을까요?
기존의 multimodal retrieval연구들은 아예 원하는 retrieval scenario를 학습데이터로 직접 만들었습니다.
예를 들어 살펴보자면 query가 img일때 positive pair로 IT를 만들어 두고 negative pair로 다른IT를 만들어 두는 것이죠! 이런 triplet dataset을 새로 만들어 학습시켜왔습니다!
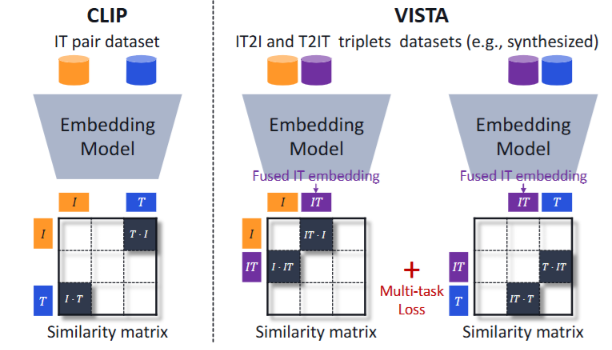
먼저 가장 잘 알려진 CLIP먼저 살펴보자면 클립은 기본적인 Img-caption pair(I ↔ T)를 가지고 contrastive learning을 합니다
위 그림의 왼쪽 similarity matrix에서는 사실상 I-T cross-modal alignment를 학습하는 구조인 것이죠
하지만 UMR(Universal Multimodal Retrieval)에서는 IT도 다뤄야 하는 구조이기 때문에 UMR을 다루는 위 그림 오른쪽의 VISTA같은 이전의 연구들은 IT → I, T → IT 같은 필요한 retrieval scenario를 위한 triplet dataset을 직접 만들어서 추가로 fine-tuning을 해줍니다. 위 그림으로 보자면 3×3칸에서 흰색칸은 안 배운 조합이고 검은색 칸은 학습된 조합입니다
(VISTA라는 방법에 대해서는 간단하게만 짚고 가자면 새로운 IT2I, T2IT dataset을 만들어서 일부 modality 조합을 추가 학습하는 방법입니다.)
즉 기존의 방식은 약간 필요한 retrieval task가 생길 때마다 그 task를 위한 데이터를 따로 만들어서 가르치자! 인 것이죠
이러한 방식의 문제는 아주 직관적인데, 이렇게 하면 당연히 이 만든 scenarios는 잘 배울수 있겠지만 결국 이런식으로 데이터를 새로 만들어야 하고, I→IT만 학습시켜놨다고 해서 IT → T, IT → IT, T → IT같은 경우의 보지 못한 modality조합까지 잘 한다는 보장도 없습니다.(fails to generalize to unseen modality combinations)
따라서 저자들은 굳이 새로운 triplet dataset을 만들지 말고 기존의 img-caption pair에서 Image → I embedding, Caption → T embedding, Image+Text → IT embedding을 만들고 이 3개의 representation을 mini-batch 안에서 전부 contrastive learning하자고 제안합니다!
더 간단하게 말하자면 Task별 데이터를 만들지 말고 representation space자체를 맞춰버리자!입니다.
이게 저자들이 제안하는 방법인 Generalized Contrastive Learning (이하 GCL)을 의미합니다!
따라서 하나의 img-caption pair에서 만들어진 3개의 representation에 대해 같은 sample이면 I ↔ T, I ↔ IT, T ↔ IT이렇게 모두 positive로 잡아 주고 다른 sample이면 전부 negative로 잡는 것이죠!
GCL로 학습이 끝난다면 I / T / IT가 modality별로 따로 노는 게 아니라 하나의 shared embedding space에 이 3종류의 representation이 전부 정렬되어 unified representation space가 만들어지고, 단순히 I ↔ T만 배우는 것이 아니라 I ↔ T, I ↔ IT, T ↔ IT를 다 맞출수 있게 되는 것이죠!
아래 fig1전체 그림의 3번째 열이 GCL에 대한 그림으로, 3×3칸이 다 검은색으로 채워져 있는 것처럼 기존 image-text pair 하나만 가지고 I/T/IT를 만든 후 모든 modality combination을 한꺼번에 고려한다~ 라는것을 볼수 있습니다
저자들의 학습 기법인 GCL을 3개의 임베딩 백본 모델인 VISTA / CLIP / TinyCLIP에 붙였는데도 M-BEIR, MMEB, CoVR같은 벤치마크에서 좋아졌다는 것을 이후 실험에서 보여주면서 추가로 이 GCL이 특정 백본 하나에 종속된 게 아니라 학습 기법 자체로 쓸 수 있다~!!를 주장하게 됩니다!
즉 한마디로 간추리자면! 기존의 CLIP류는 I↔T정렬에서는 강하지만 I,T,IT가 한 DB에 섞이는 universal multimodal retrieval에서는 modality gap에 대한 문제가 생기고,
기존의 VISTA류는 특정 modality조합용 데이터를 새로 만들어서 해결은 했지만 학습하지 않은 조합에서는 일반화가 약하다는 문제가 있습니다.
이에 저자들은 기존 img-caption pair만 사용하면서도 I,T,IT 모든 조합을 동시에 정렬할수 있게 하는 GCL을 제안했습니다!
따라서 논문의 contribution은 3가지로
- I/T/IT를 하나의 unified representation space에 정렬하는 GCL 제안함
- 별도 triplet dataset 없이 기존 image-caption pair만 활용하는 효율적 학습 방식 제안함
- VISTA/CLIP/TinyCLIP(기존 임베백본 모델)과 M-BEIR/MMEB/CoVR에서 GCL의 범용성 및 성능 향상을 검증
METHOD
1. Problem Setup
저자들의 방법을 설명하기에 앞서 기호들을 먼저 정리하고 넘어가죠!
x^i = 원본 image
x^t = 원본 text
x^it = image + text가 함께 있는 원본 sample
e^i = image embedding
e^t = text embedding
e^it = image+text fused embedding
q = query
c = candidate
→ 위 첨자가 modalitiy를 말합니다!
예를들어서 q^t→c^i이면 그냥 image+text query를 가지고 image+text candidate를 검색한다는 뜻 입니다!
모델구조도 정리를 해보자면 논문에서 말하는 retrieval model을 θ로 두고 θ={θ_i,θ_t}로 image encoder + text encoder로 정의합니다. 따라서 기본적으로 아래의 구조가 되는 것이죠!
- Image → Image Encoder → e^i
- Text → Text Encoder → e^t
추가적으로 e^it를 어떻게 만드는지는 백본마다 다릅니다. 간단하게만 말하자면 백본이 VISTA인 경우 원래 VISTA fusion방법으로 만들고, CLIP인 경우 img,txt embedding을 합치는 식 입니다
[Global vs Local setting]
저자들은 retrieval 환경을 두 종류로 나눕니다
먼저 Global setting은 진짜 UMR에 가까운 상황으로 DB하나 안에 Image candidates, text candidates, image+text candidates가 전부 섞여있는 상황을 말합니다.
예를들어 text query가 들어오면 img인지 txt인지 it인지 구분없이 전체 DB에서 관련있는 것을 찾아야 하는 것이죠! 이런 경우 modality gap이 있으면 훨씬 치명적이게 됩니다
다음으로 Local setting은 반대로 특정 task마다 candidate pool을 따로 두는 것으로,
예를 들어 T → I task를 평가한다고 치면 image candidate DB 안에서만 검색하는 식입니다!
따라서 global보다 상대적으로 쉬운 setting으로 저자들이 이 두 세팅을 다 보는 이유는 혼합 DB에서도 잘 되냐??와 각 retrieval task 자체에서도 잘 되냐??를 둘 다 확인하기 위해서라고 보면 됩니다!
위의 fig2로 좀더 살펴봅시다!
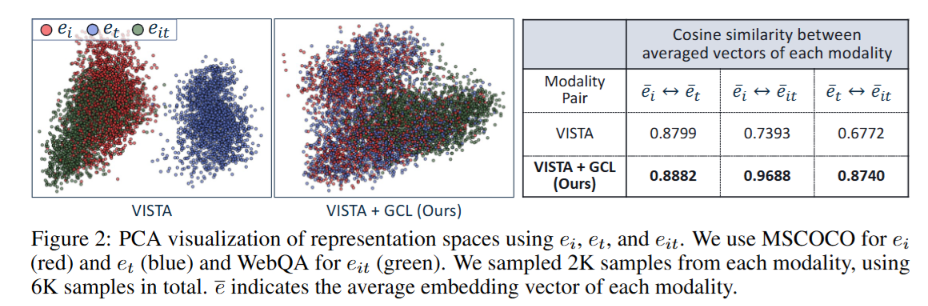
왼쪽의 PCA그림은 두가지 embedding space에 대한 그림으로, 둘 중의 왼쪽의 VISTA는 색깔이 img,txt,IT이렇게 좀 구별되어있는것을 볼수 있습니다. 즉 같은 의미를 가진 데이터라도 어떤 modality인지에 따라 embedding space의 위치가 달라지는 경향이 있다는 말이 되는 것이죠!
반면에 오른쪽의 PCA그림은 VISTA에 GCL의 기법을 적용한 것으로 그림처럼 색깔이 훨씬 많이 섞여있는 것을 볼수 있습니다. 저자들은 이 결과에 대해 modality gap이 감소하고 unified representation space가 만들어졌다는 증거라고 합니다!
오른쪽의 표는 modality 평균 embedding끼리의 cosine similarity를 나타내는 값으로, 각 modality의 embedding들을 평균(e-^i, e-^t, e-^it)내서 이 평균 값들(e-^i, e-^t, e-^it)사이의 similarity를 보는 것 입니다!
제일 마지막 행 처럼 GCL후에는 modality pair들은 similarity가 크게 오르는 것을 볼수 있습니다!
저자들은 이 결과들을 통해 단순히 PCA 그림만 예뻐진 게 아니라 실제 representation 간 cosine similarity도 올라갔다~라고 뒷받침합니다!
하지만 이 cosine similarity가 높아졌다는게 바로 retrieval 정답을 더 잘 찾는는다! 라는 의미는 아니고 modality gap이 줄어들었다 → embedding space가 더 잘 align됐다! 를 보여주는 representation-level 분석정도로 받아 들일수 있을것 같습니다
(실제 retrieval 성능은 뒤의 Recall실험으로 따로 분석합니다! 뒤쪽 experiment에서 실제 recall이 좋아지는지 확인해 보시죠!)
2. Generalized Contrastive Learning (GCL)
앞서 말한것 처럼 저자들은 새 multimodal retrieval dataset을 매번 만들지 않으면서도 다양한 multimodal retrieval scenario에 잘 대응할 수 있는 더 scalable한 방법이 필요하다는 것을 motivation으로 기존 retrieval backbone에 적용할 수 있는 학습 loss인 GCL을 제안했습니다!
먼저 아래의 수식 1을 살펴봅시다! 기존의 image-text contrastive learning loss로 거의 CLIP류에서 많이들 쓰는 InfoNCE 형태입니다
(기호정리)
N:미니배치 안의 sample개수
j:현재 query와 positive pair를 이루는 sample index
k: denominator에서 비교하는 candidate sample index
τ: temperature parameter. similarity score의 분포를 얼마나 날카롭게/부드럽게 만들지 조절
S={(i,t),(t,i)}: 기존 CL에서 학습하는 modality 방향
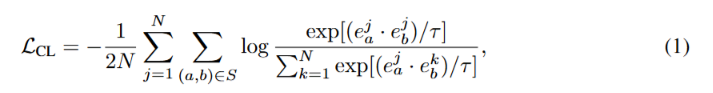
j번째 query와 같은 j번째 sample의 positive embedding similarity는 크게 만들고, batch 안의 모든 k번째 candidate들과 비교했을 때 정답 pair의 similarity가 상대적으로 가장 높아지도록 학습합니다.
즉 I→T, T→I 두 방향에서 같은 sample pair는 가깝게, 다른 sample pair는 멀게 만드는 기존 contrastive learning 방식입니다.
이 논문의 아이디어인 GCL은 이 contrastive learning loss를 baseline으로해서 여기에 IT까지 넣어서 GCL로 확장한것 입니다! 꽤 단순하죠!?
기존에는 I,T 두개만 있었다면 I,T,IT이렇게 3개를 만들고, 그렇게 되면 같은 샘플 안에서 positive 관계가 (I → T,I → IT), (T → I, T → IT), (IT → I, IT → T) 이렇게 총 6개가 됩니다!
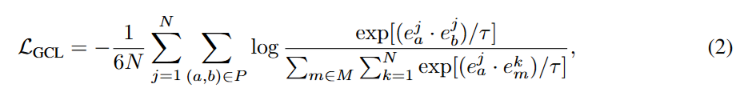
그래서 위의 수식처럼 우항 제일 앞에 1/2N이 아닌 1/6N이 붙는 것입니다. 즉 6 modality directions × N samples의 loss를 평균내는 것이죠!
여기서 한가지 짚고 갈 부분은 IT embedding을 만드는 방법 자체는 이 논문이 새로 제안한 것이 아닙니다.|
사용하는 retrieval backbone이 원래 가지고 있던 방식을 그대로 사용하는데, VISTA의 경우 visual token과 text token을 함께 넣어 fused embedding을 만들고, CLIP계열에서는 UniIR(CLIP에서 image embedding이랑 text embedding 그냥 더해서 IT embedding 만드는 방식)의 방식을 따라 img embedding과 txt embedding을 더해서 IT representation을 만듭니다
즉 이 논문의 핵심 contribution은 IT를 어떻게 만들 것인가가 아니라, 만들어진 I/T/IT를 어떻게 함께 학습할 것인가에 있습니다!!
아래의 fig3을 보면 좀더 직관적으로 살펴보겠습니다
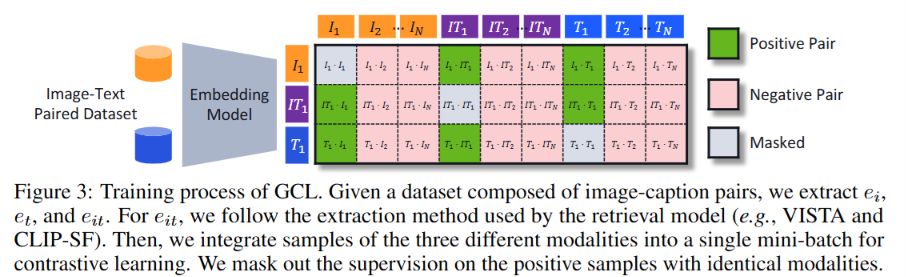
위의 matrix를 보면 batch 안에 (I_1 I_2 I_3), (IT_1 IT_2 IT_3), (T_1 T_2 T_3) 이렇게 한꺼번에 들어가있는걸 볼수 있는데, 기존의 CL처럼 Image batch ↔ Text batch만 비교하는게 아니라 mage / Text / IT 전체를 하나의 커다란 candidate pool처럼 만들어서 비교하는 것 입니다
이때 회색 칸은 mask라고 된걸 볼수 있습니다. 요 부분은 동일 modality일 경우 mask 처리를 해주는 것입니다.
예를 들어 I_1 ↔ T_1, I_1 ↔ IT_1처럼 같은 샘플에서 나온 다른 modality끼리는 positive pair가 되고, I_1 ↔ I_1처럼 자기 자신과 비교하는 경우는 학습할 게 없으니 mask 처리합니다. 반대로 아래 첨자 숫자가 다르면 다른 샘플이므로 negative pair가 됩니다
즉 기존 CL은 I↔T만 비교했다면, GCL은 I/T/IT 전체를 한꺼번에 비교한다! 이게 Generalized의 핵심입니다.
저자들은 이렇게 하면 universal retrieval이 된다고 봅니다! 그 이유도 단순한데,
기존에는 IT→I, T→IT처럼 필요한 task마다 따로 데이터를 만들어서 그 task를 직접 학습했다면, GCL은 그냥 처음부터 I / T / IT를 한 공간에 다 맞춰둡니다.
즉 어떤 modality가 query로 오든, 어떤 modality가 candidate로 오든 서로 비교할 수 있게 embedding space 자체를 만들어버리자! 인 것이죠!
따라서 특정 retrieval task를 하나씩 학습하는 방식이라기보다, 여러 modality 조합에서 공통으로 쓸 수 있는 representation space를 만드는 방식이라고 보면 됩니다.
Experiments
[Experimental Setting]
- Benchmark: M-BEIR / MMEB / CoVR
- Backbone: VISTA / CLIP / TinyCLIP
- Metric: Recall@K
- benchmark train set으로 fine-tuning하지 않는 zero-shot evaluation
- GCL fine-tuning에는 기존 image-caption pair인 LCS-558K 사용
1. Main Result
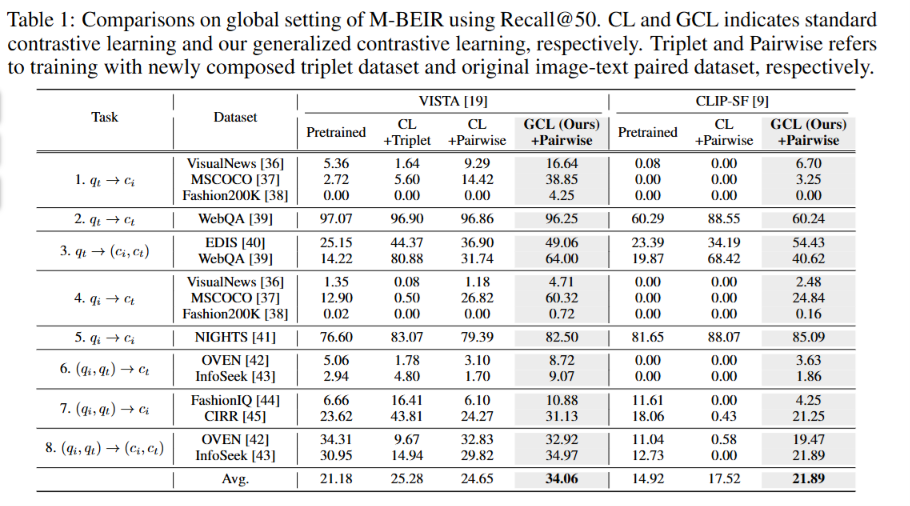
먼저 메인 실험결과로 M-BEIR의 global setting 결과입니다
I/T/IT가 섞인 DB에서 GCL을 적용했을 때 VISTA와 CLIP-SF 모두 평균 성능이 향상되었고, 특히 IT가 query나 candidate로 포함되는 retrieval task에서도 효과를 보였습니다.
반면 특정 scenario용 Triplet 학습은 일부 task에서는 좋아지지만 다른 task에서는 성능이 떨어지는 모습도 보여, 특정 조합에만 맞춰 학습하는 방식의 한계도 확인할 수 있습니다
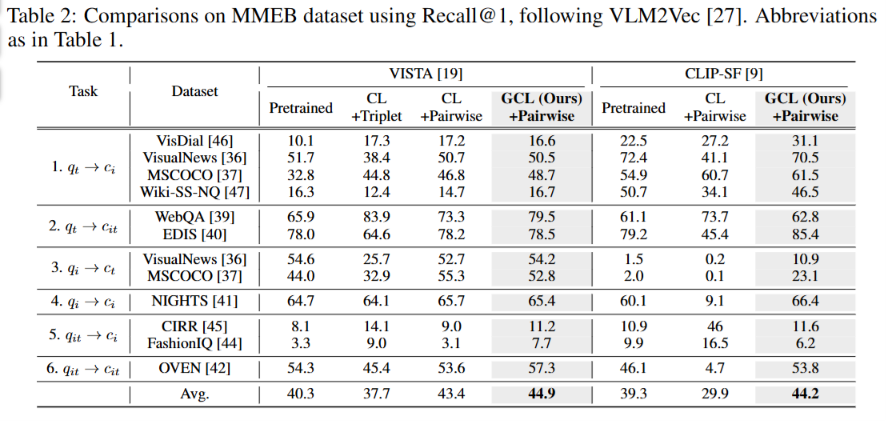
다음으로는 Generalization확인하는 실험으로 MMEB 벤치마크에서 진행된 실험입니다
마찬가지로 MMEB에서도 GCL의 성능 향상이 유지됩니다. 즉 직전 메인실험이였던 M-BEIR에만 맞춘 방법이 아니라, 다른 multimodal retrieval benchmark에서도 VISTA와 CLIP-SF 모두 전반적인 성능 개선을 보여 GCL의 범용성을 확인할 수 있습니다
2. Ablation
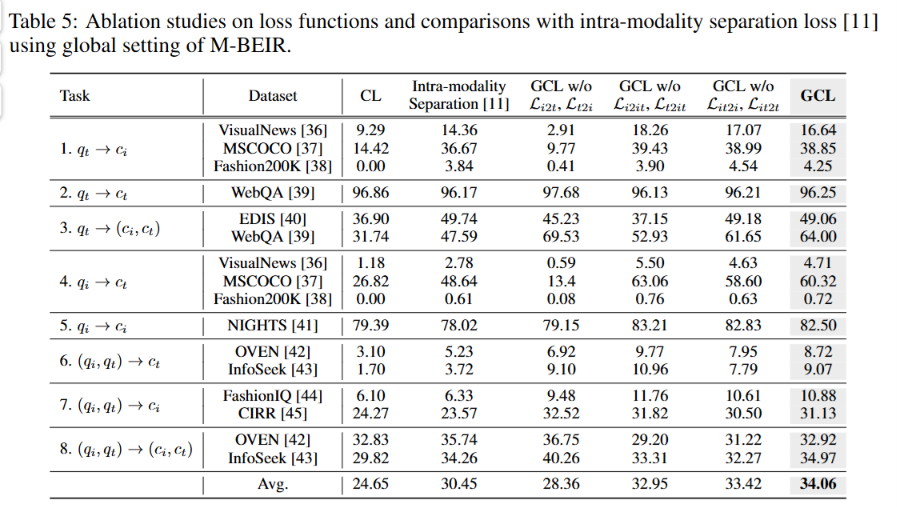
GCL의 각 loss component가 실제로 필요한지 확인한 ablation 결과입니다
I↔T, I/T→IT, IT→I/T 중 하나씩 제거하면 해당 retrieval 조합의 성능이 떨어지고, 모든 modality 관계를 함께 학습한 full GCL이 평균 성능 34.06으로 가장 높게 나타나는 것을 확인할 수 있습니다.
즉 GCL의 성능 향상은 특정 pair 하나 때문이 아니라 I/T/IT 전체를 함께 정렬하는 구조에서 나온다고 볼 수 있습니다!
3. Lightweight Model
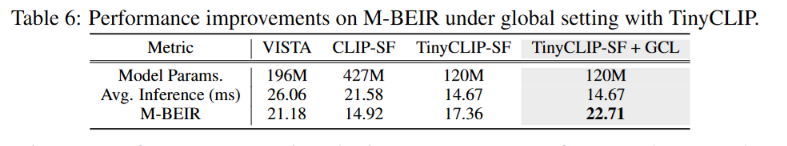
다음은 TinyCLIP처럼 더 작은 lightweight model에서도 GCL이 효과적인지 확인한 실험으로,
TinyCLIP-SF에 GCL을 적용하면 파라미터 수나 inference time은 그대로 유지하면서 M-BEIR 성능이 17.36 → 22.71로 향상됩니다.
즉 GCL은 큰 retrieval backbone뿐 아니라 작고 빠른 모델에서도 그대로 적용 가능한 학습 방법이라는 것을 보여줍니다!
4. Ranks of Ground Truth Candidates
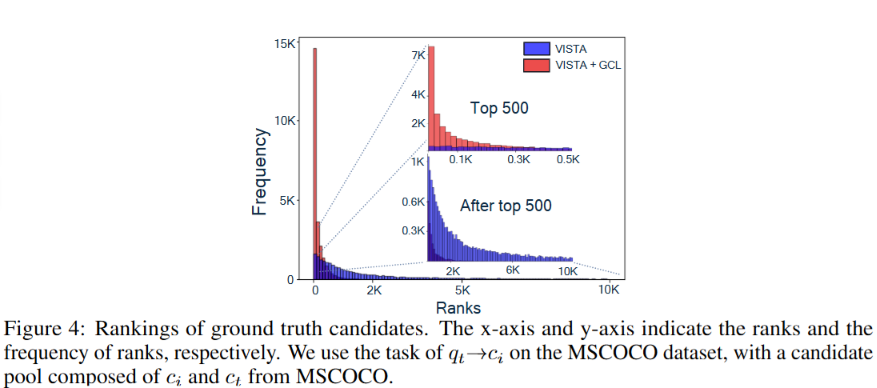
위의 fig4의 그림은 정답 candidate가 retrieval 결과에서 몇 등쯤에 위치하는지를 비교한 것입니다.
x축은 정답의 rank, y축은 해당 rank에 위치한 정답의 개수(frequency)로 GCL을 적용한 VISTA+GCL의 경우 정답들이 Top-500 안쪽에 훨씬 많이 몰려있는 것을 볼 수 있습니다
즉 GCL을 적용하면 단순히 정답을 찾는 것뿐 아니라 정답 candidate 자체를 더 높은 순위로 끌어올린다!는 것을 보여줍니다!
5. Cosine Similarity with Candidates
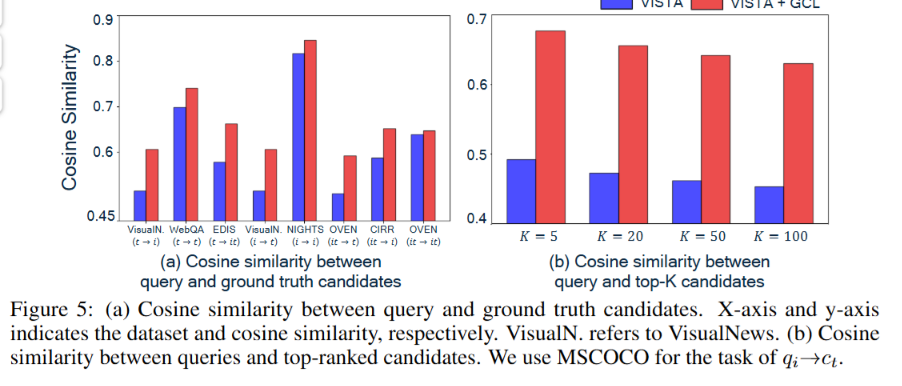
fig.5(a)는 여러 retrieval task에서 query와 실제 정답 candidate 사이의 cosine similarity를 비교한 것입니다! 대부분의 경우 VISTA+GCL의 similarity가 더 높아져tj GCL 학습 후 query와 정답 representation이 embedding space에서 더 가까워진 것을 볼 수있습니다.
fig.5(b)는 정답 하나만 보는 것이 아니라 Top-K로 retrieval된 candidate들과 query의 similarity가 어떻게 유지되는지를 본 결과로 기존 VISTA는 K가 커질수록 similarity가 더 크게 떨어지지만, GCL은 비교적 높게 유지됩니다.
즉 1등만 그럴듯하게 뽑는 것이 아니라 뒤에 따라오는 candidate들도 관련 있는 결과로 잘 가져온다~ 는 것을 보여줍니다!
감사합니다!